Mental-Models:先学会怎样评价对方的处境,再训练说话策略
- Mental-Models for Multi-Agent Systems
作者:Hanan Gani、Lulu Shao、Manmohan Chandraker。
机构:University of California, San Diego(v1 PDF 首页,已核对署名)。
任务背景。 假设你让一个 Agent 代你买一把二手椅子:它知道商品、自己的预算和已经发生的对话,要逐轮提出报价或回应卖家的条件,争取成交,同时避免不必要的让步。卖家说“今天能来取吗”,可能透露了急于腾地方的意图,却没有直接告诉你底价。只把这句话当普通文本继续生成,容易漏掉“对方最在意的可能不是价格”这一点。这个例子用于解释任务;论文实际测试包含社会角色对话、谈判、心智问答和带图片的角色扮演,成功标准依任务分别是交互评分、谈判结果或答案正确性。
这里的困难是:模型看得见对方说了什么,却通常看不全对方知道什么、希望什么,以及对方以为“我”知道什么。论文要改善的不是增加协作角色,而是训练时怎样给候选行为一个更理解互动处境的分数。
核心方案。 先用交互历史推断一个紧凑的潜在表示:第一层表达对方的信念、意图和思考,第二层在第一层基础上表达更高阶的推断,例如对方认为你会怎样回应。它用带不确定性的高斯表示承载这些信息,不要求模型只能押注一个解释。训练材料中的心理状态文字、行为评价及对比坏回答,帮助这个表示既保留有意义的信息,又能参与判断行为好坏。
接着把这个表示与候选回答一起送进奖励模型。仍以买椅子为例,它要区分“继续压价”和“愿意今天取货”的效用,而不是只给一句话的流畅度打分。心理表示与奖励模型联合训练:评价行为的误差反过来塑造表示,心理状态监督则避免表示完全退化成一个没有明确语义的评分捷径。模型表示的不是对真人心理的直接测量,而是训练标注支持的推断。
学好评分器后将它冻结。策略针对同一上下文采样多种回答,由评分器给出分数,GRPO利用组内相对优势更新策略,参考模型约束抑制偏移;不同数据设置还使用SFT预热,多模态设置附有DPO。部署时,策略只根据实际输入直接生成回答,不再调用心理状态编码器或奖励模型做搜索与重排。更新被保存在策略参数中;没有展示让评分器随部署经验继续演化的循环。
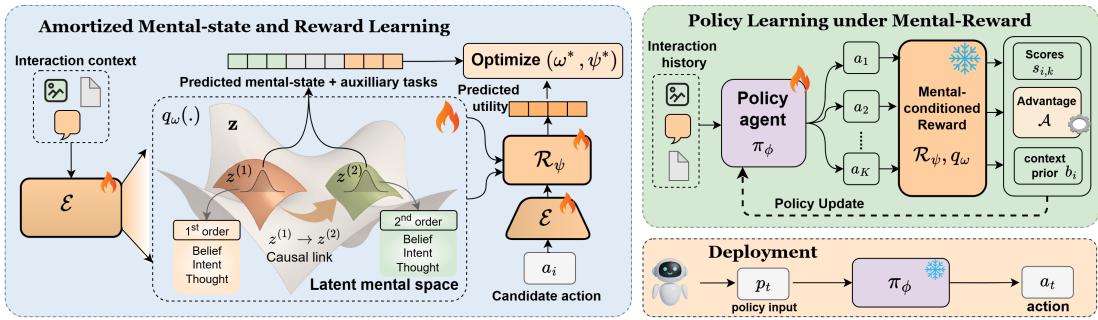
原图:v1 Figure 2,PDF第4页;来源。已核对原PDF与完整抽图。
顺着图看。 从左侧的交互上下文开始:编码器产生第一阶与第二阶潜在表示,右侧候选动作与它一起进入奖励预测,橙色火焰表示此阶段正在学习的组件。上方目标同时约束心理状态与效用,不能把这部分理解成策略已经在环境里自主更新。
再看右上方:策略一次提出多个候选,已经冻结的心理奖励模块逐个评分,虚线返回的是策略更新。右下方是训练完成后的执行路径,只剩输入、策略和动作。图中的context prior是训练辅助项;附录进一步说明,同一prompt中对所有候选都相同的常数在组内中心化时会抵消,不能把它单独当作产生相对优势的奖励。
实际贡献。 这项工作的增量是把带一阶/二阶结构的伙伴状态表示与行为奖励联合学习,并用这个奖励把相关行为偏好教进策略,而不只是把“请考虑对方想法”写进提示词。论文还比较同一增强数据上的SFT、GRPO与完整方法,并做表示打乱、标注覆盖比例和潜在结构诊断;这些支持“结构与监督有作用”,但仍不足以把所有收益归因于某一种心理结构,尤其多模态训练同时包含不同训练步骤。
这不就是……给奖励模型多加一种监督,再用它做RL吗? 大体上是,但关键多加的不是一个标签字段:模型必须形成对方状态的中间表示,再让候选行动的价值依赖它。如果中间表示只会复述标注、不能区分可取与不可取的回应,它对策略训练就没有帮助;联合目标和表示扰动实验正是在检验这件事。反过来,能解释一组标注也不代表获得了真实、普遍可靠的“读心能力”。
证据与局限。 原PDF主表中,Qwen在固定GPT-4o-mini伙伴的SOTOPIA-ALL整体分数由3.290到3.856;这是七个社会维度汇总分,不是成功率。跨任务测试中,SOTOPIA训练的Qwen在100个CraigslistBargain例子上成交率由91%到94%,但成交可能来自让步,不能仅以此证明谈判收益更高。BigToM风格训练的策略在前5,000个FANToM probe上二阶分数由49.7到52.2,属于有限的零样本多人问答迁移,不是完整多人协作训练的证据。
几个缺口直接影响投入判断。心理标注主要来自GPT-4o或Qwen3-235B,人工抽查只覆盖100条;其4.45/5是标注可信度评分,不能改写成89%的独立正确率或标注者一致率。SOTOPIA附录文字称只提供行动者的私人信息,但式(32)同时列出双方目标和秘密,训练评分器、策略输入与测试实际可见性仍需源码核验,这里不擅自断言泄漏或无泄漏。MMRole的74个训练角色加14个测试角色与原始85角色不一致;正文的36,744→15,607 turn与质检段落15,919→15,607也尚未解释为怎样的连续筛选。BigToM合成采用原seed示例,虽然称官方测试留出,语义近重复仍需独立检查。全文未给出足以确立等总训练算力收益的成本对照。
评测数据集与环境。 SOTOPIA、CraigslistBargain、BigToM、ToMi、MMRole、FANToM。以下分别记录本篇实际口径。
- SOTOPIA:官方ALL/HARD及GPT-4o-mini/self伙伴设置作最终测试,七维评分;实际测试episode总数未清晰列出。1,647个增强SOTOPIA-π episode用于训练,不与测试数量混算。
- CraigslistBargain:随机100个negotiation examples作零样本迁移,报告成交/退出/未达成协议比例;具体snapshot、抽样seed与例子清单未锁定。
- BigToM:官方测试按正向信念、正向行动、反向信念与有无初始信念句子报告TB、FB、TB∧FB。本篇另生成5K训练场景、展平为9,964行;不能叫作官方测试规模。
- ToMi:官方划分作OOD问答测试,报告Average、Joint及错误信念分项;本篇题数与snapshot待核。
- MMRole:带图角色扮演八维归一化评分与In/Out划分。本篇增强inter-role训练,附录记录官方294条测试保留291条,但主表究竟使用哪份题单、角色划分怎样对应仍待核。
- FANToM:前5,000个展平probe作最终零样本迁移;本篇报告belief choice、belief distance及一/二阶分项,不等于5,000段独立对话。short/full与一/二阶映射仍需代码确认。