Prior or Feedback:Agent 到底有没有用实验反馈
作者:Julian Chan、Javier Mora Jimenez。机构:University of Surrey;Compare the Market。首次公开日期(本地口径):2026-10-09;本次依据 v1。
假设你有一个预测物理系统变化的模型,现在流体黏度或流动速度变了,原模型不够准。你只获准做20次微调实验,需要决定每次用什么学习率、优化器和损失。论文让一个冻结的语言模型读取任务说明、此前配置与验证误差,提出下一次配置;最后用留出的测试数据判断找到的配置好不好。这里学的是“怎样配置另一个模型的微调”,语言模型自己并没有更新权重。
作者先把搜索任务固定住:每轮都从同一个预训练神经算子重新复制一份,训练数据、训练轮数与可选配置范围不变。实验结果进入历史记录,供下一轮提出配置。然后在已经记录的决策点重放:只把各配置对应的验证分数互换,看下一步提案会不会改变;另设分数数值不变、仅改成科学计数法的对照,以排除格式和重新采样的影响。
这篇的价值是把两个问题拆开:找到更好的最终配置,不等于证明反馈发挥了作用;下一步提案随反馈改变,也不等于证明这种改变带来了收益。论文同时做了冷启动任务描述干预和历史分数置换,分别识别任务相关的初始偏好与反馈敏感性。它提供的是可复用的归因实验设计,而不是新的训练算法。
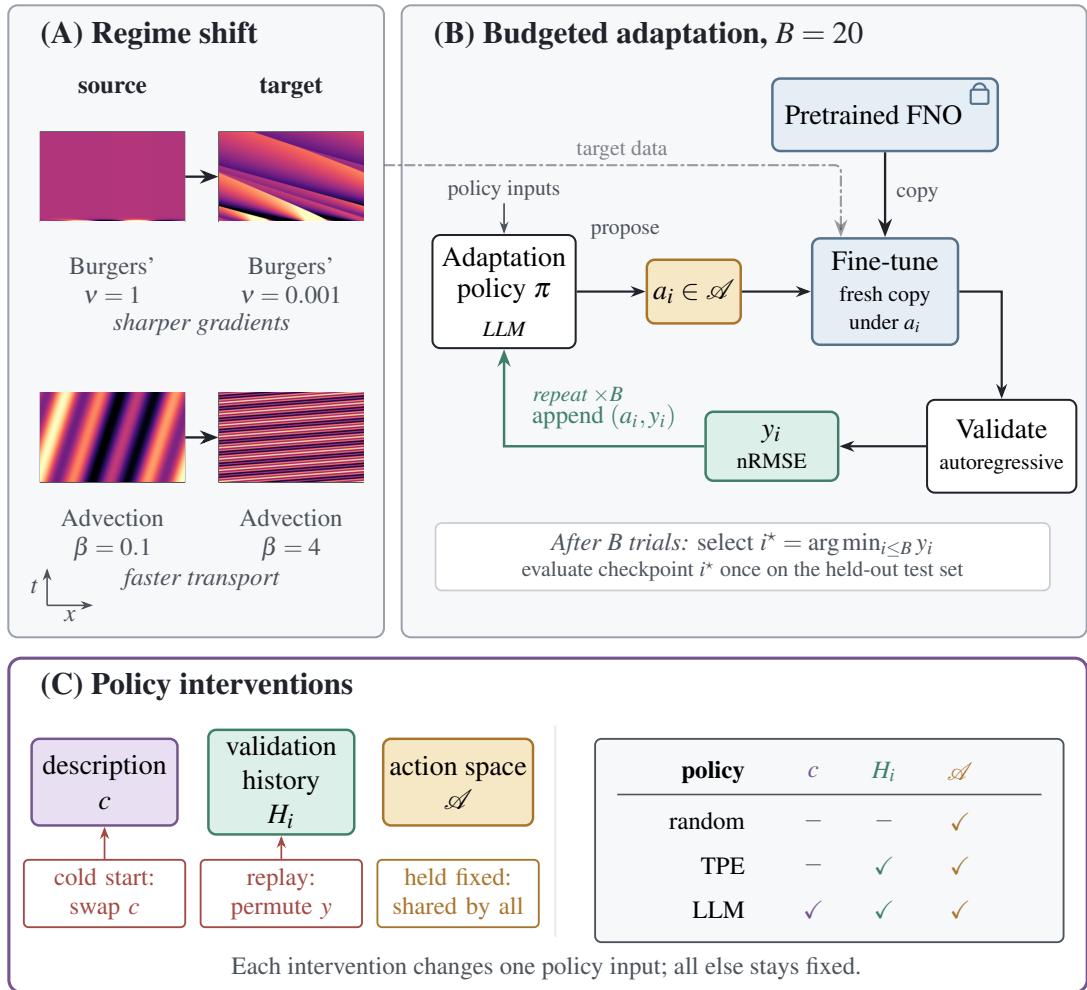 原论文 v1 Figure 1,PDF第3页;原图来源。
从图B左侧的配置选择器出发,沿微调、验证和返回历史的绿色箭头看一轮搜索;上方锁住的是初始模型,每次微调使用它的新副本。再看图C:实验动的是任务描述或历史分数的对应关系,没有改模型权重。图A只是两种分布变化的示意,不能把它当成额外学习模块。
证据与边界。 在12个源模型—目标条件、每个3个随机种子的36组匹配运行中,语言模型的最终测试误差在全部组别优于随机搜索、35组优于TPE。分数置换使下一步配置的标准化距离相对记法对照增加0.085,接近改动一个类别型配置项的量级。更关键的是边界:作者明确没有证明反馈响应是合理的,也没有证明它解释了最终性能优势;语言模型比TPE多获得任务描述与诊断信息,20次实验相同也不代表总计算成本相同。
评测数据集与环境。 已核实来源:本文 v1 的 PDEBench 适配协议。本篇口径:一维平流与Burgers方程,共12个适配条件×3个种子;每轮微调用750条轨迹,350条用于验证,另有固定1000条测试轨迹。验证误差用于配置选择,20轮结束后才在测试集评一次;指标为自回归预测的nRMSE。没有把36次运行当成36种独立物理任务,也不把目标域大数据预训练模型当作等预算基线。
完整中文摘要
科学研究型语言模型Agent究竟只依赖初始任务上下文,还是会根据实验反馈调整决策?我们在神经算子适配任务中研究这一问题:语言模型在有限实验预算下选择微调配置。在同一偏微分方程族内部以及不同方程族之间的迁移中,语言模型在几乎所有匹配比较里都比随机搜索和贝叶斯优化获得更低的留出测试nRMSE。单看最终性能无法区分其中发生了什么,因此我们通过受控干预检查每项归因。在观察任何验证分数之前,语言模型提出的第一个配置就已位于对应随机搜索候选池的前列,显示出有用的初始偏好。补充的冷启动干预表明,所选基础学习率会随方程描述改变。有反馈后,把已评估配置之间的验证分数重新分配,会在全部测试情形中改变下一步提案;保留数值不变的文字重写则没有类似的总体效应。这些干预说明,语言模型的决策行为会响应给定任务和观察到的结果,结合了任务相关的先验与对实验反馈的敏感性。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.12325v1):§2–5;Figure 1(PDF第3页)、Table 2与Figure 2(第6页)、反馈干预结果与局限(第7页)。 - PDF SHA256:3f5042a2f8d08619112302d05b1123bfe3add84ef78ca76803afe24b0e1af2c1。Research World Models:把做过的实验用于选择下一次实验
作者:Zijun Wang、Zewen Liu、Minhua Lin、Zhaotian Weng 等。机构:Amazon;UC Santa Cruz;Emory University;Pennsylvania State University;UC Santa Barbara。首次公开日期(本地口径):2026-10-09;本次依据 v1。
假设研究Agent提出16个训练配方修改,你只能实际跑3个。直接让模型挑“看起来最好”的方案,容易重复依赖常识。本文让语言模型先读取真实实验档案:在哪个环境、改了什么、相对原配方提高或下降多少,然后预测候选修改的收益,再把有限预算给最有希望的方案。输出是实验收益预测,不是虚构一条完整训练轨迹。
每条经验把环境、具体代码或配方改动、观测收益放在一起。预测器同时读当前基线、候选改动和允许使用的历史,估计执行后的收益中位数。实际执行选出的候选后,新结果可以回到档案里。本文保持语言模型权重不变,经验通过上下文起作用;跨环境测试还排除了待预测修改及其近重复组,避免直接从源记录抄到答案。
论文把“能预测”进一步连接到“能帮助决策”:除了误差和排序相关性,还检验从16个方案里选3个会错过多少最佳收益,以及多轮研究最终得到什么。这比仅报告预测相关性更贴近Agent的预算决策。与本文的近邻、岭回归和无经验语言模型对照相比,主要增量是展示结构化实验记录在这些环境中的复用价值;不能据此声称此前没有实验预测器。
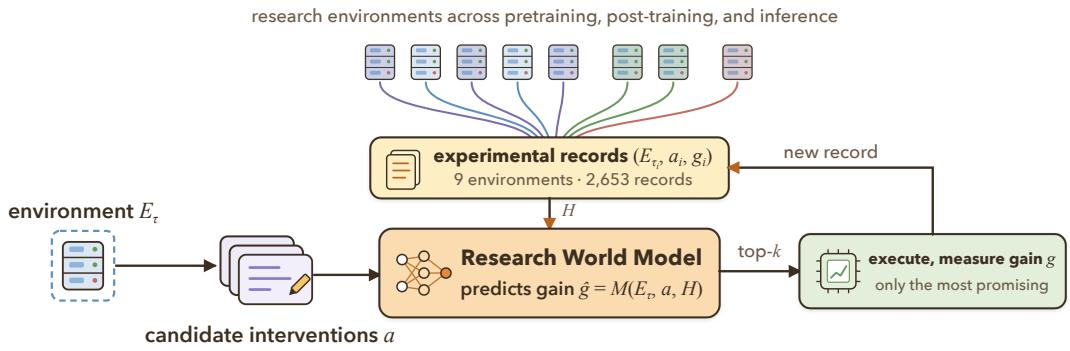 原论文 v1 Figure 1,PDF第2页;原图来源。
从左边的当前环境与候选修改进入中央预测器,上方的实验档案提供历史。右边只执行预测后选中的一小部分,实际测得的收益沿回路成为新记录。图中“新记录返回”表示档案增长,本文实现不沿这个箭头做参数训练。
证据与边界。 作者汇总9个环境的2653条实验记录;同环境预测在5个环境上比较,跨环境迁移集中在5个自回归预训练环境。多轮研究在固定24次实验选择预算下,有同环境或跨环境初始经验的预测器,最终最佳收益分别比无初始经验设置高15.8%和11.6%。但这些档案本身花费约17.2万H100 GPU小时,不能算成免费资源;跨环境证据尚不覆盖一般科研领域,模型API也不保证逐比特复现。这里尚未训练一个持续更新权重的研究世界模型。
评测数据集与环境。 已核实来源:作者 v1 的研究环境与划分。本篇口径:预训练含OLMo3-100M/190M、Marin、Nanochat、Qwen3及Diffusion;后训练含数学蒸馏、代码RL;推理侧为质量约束吞吐优化。2653是实验记录数,不是2653种任务。预测测MAE与Spearman;预算选择从16取3,测Regret@3与NDCG@3;多轮研究固定24次选择。数学蒸馏使用AIME24与AIME25的avg@32,代码RL用LiveCodeBench;LiveCodeBench精确release和各底层任务快照未在本次核对中锁定,不能与其他版本成绩直接横比。
完整中文摘要
AI研究Agent能够自动提出、实现和评估实验,为递归自我改进开辟路径。然而,提出实验的速度已经超过在真实环境中执行实验的能力,使结果预测成为有限实验预算下持续改进的关键能力。我们研究将语言模型用作研究世界模型,使其预测不同研究环境中候选干预的结果。评估使用来自预训练、后训练和推理共9个环境的2600多条实验记录,对应超过17.1万H100 GPU小时。真实实验经验中获得的研究知识改善了同环境下对未见干预的预测,Spearman相关提高0.27,也能跨环境复用。例如,仅使用OLMo3、Marin和Nanochat的预训练经验,就能使Qwen3环境中的选择遗憾较零经验设置减少78%。这些收益延伸到固定选择预算下的多轮Autoresearch:使用同环境和跨环境研究知识,最终最佳收益分别提高15.8%和11.6%。对13种作为研究世界模型的语言模型所做的消融显示,加入研究知识对干预排序的改善,可以超过单纯更换模型或增加推理努力。结果支持将语言模型用作研究世界模型,并推动为未来模型训练积累实验数据。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.12235v1):§2–3.4、Tables 1–5、Figure 1(PDF第2页)、§5局限;Appendices B–E的记录、切分与多轮协议。 - PDF SHA256:fa181b310fa885f3818917c7ef970ab198976581f3632ae1141287933ac47760。TRACE:分数变了,先查行为还是尺子变了
作者:Radhika Gaonkar。机构:Prime Intellect。首次公开日期(本地口径):2026-10-08;本次依据 v1。
一个客服Agent照常调用工具完成退货,你只把工具改了名字,它的评测分却下降了。是Agent真的做错,还是打分程序仍在匹配旧名字?TRACE研究这种诊断:把同一任务在原始和修改条件下成对运行,再沿执行轨迹核对到底发生了什么,而不是把分数差直接解释成能力差。
流程先固定任务、策略和种子做成对运行,比较分数;随后检查动作、观测和最终状态,判断行为是否改变。如果怀疑评分器出错,就保持已有轨迹完全不变,只修正涉嫌有问题的评分规则后重新打分。与此同时,完全相同的重跑估计系统噪声;一个确实会误导Agent的改动作为正对照,确认测试能发现真实影响。
关键区别是“重新运行Agent”和“给同一轨迹重新评分”回答不同问题。前者包含Agent、环境及模拟用户的整体变化,只有后者能把评价器的影响单独隔离出来。本文在已知故障的脚本环境验证这一归因方式,再在真实语言模型交互中加入重复与正对照,避免将偶然差异写成评分器缺陷。
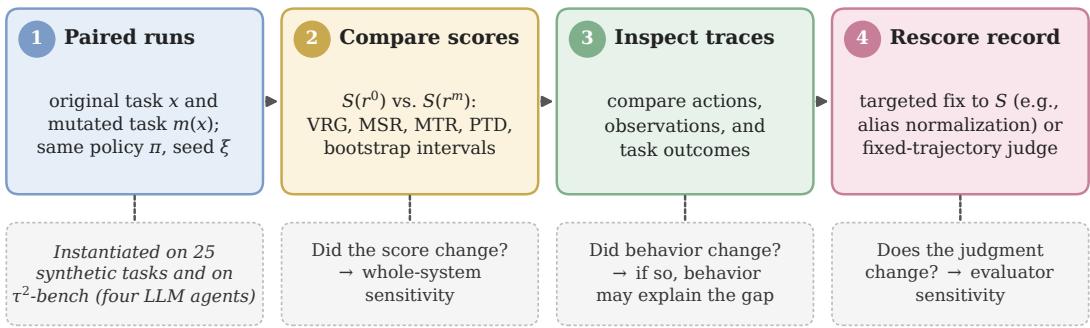 原论文 v1 Figure 1,PDF第2页;原图来源。
从左到右,前两格只告诉你有没有分数变化,第三格开始问行为有没有变化。最后一格固定已有记录、修正评分方式,是定位“尺子”的步骤。下方虚线框标的是每一步能回答的问题,不能从第二格直接跳到“模型能力下降”。
证据与边界。 在25个自建任务中,一个脚本Agent执行完全相同的操作,却因工具改名损失0.250分;评分时还原名字,差距归零。但公共τ²-bench最初30任务中的显著效果没有在后续复现;88个新任务的扩展实验中,8组Agent—改动组合有7组落在预设±0.10等效区间。相同条件重跑本身会翻转约15–36%的任务结果。两个裁判对相同记录有57%分歧,主要涉及“只看结果还是也看程序”;这证明口径不同,不能把原生奖励当成绝对真值来宣布某个裁判准确。
评测数据集与环境。 τ²-bench的retail/airline:初始6个开发、30个评价任务;后续主实验158个可用任务×4个Agent×3条件×3次重复,5688个计划运行中完成5652个,主要新任务检验使用从未评过的88题。另有40题中间复核、telecom探索及正对照,不与88题独立集混算。已核实来源:作者ResearchOpsEnv与协议;本篇口径:自建25任务×3个确定性脚本×7条件×3标签,共1575记录,重复标签不是独立随机证据;固定轨迹裁判审核使用118条记录。
完整中文摘要
验证器分数既是语言模型Agent的基准指标,也越来越多地成为训练奖励,分数改变经常被解释为能力改变,但也可能只是评价发生变化。我们提出TRACE,把分数差从判决变成可检验的诊断:针对评价的一个部分作改动,比较成对运行,检查Agent行为是否变化,再给不变的轨迹重新评分,以检验打分规则是否应负责。在25个合成任务的受控套件里,工具改名使一个脚本Agent得分下降0.250,尽管它执行完全相同的操作;在评分时恢复原名后,差距全部消失。同一改动却在另一个Agent上暴露出真正的行为失败。在公共τ²-bench上,四个语言模型Agent的初始30任务研究出现混合的奖励变化,唯一明确的效果没有复现。随后对88个新任务重复运行,工具改名或输出重排在8个Agent—改动组合中的7个保持在±0.10以内;故意误导的工具名则令所有Agent奖励下降0.20–0.44,说明设置能检测真实影响。相同重跑会翻转15–36%的任务结果,单次比较无法区分呈现影响与运行波动。两个前沿模型裁判对固定轨迹的不同呈现保持一致,却对同样记录有57%的相互分歧,主要因为其中一个评价程序而非仅评价结果。TRACE由此区分分数变化关于Agent本身和关于测量方式各能说明什么。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.11678v1):§2协议与Figure 1(PDF第2页)、§3受控重评分、§4–5公共实验、§7局限;Appendices C/E的任务切分、重复和裁判口径。 - PDF SHA256:07687201eae8f310c181bbba54186b95f59848c84adbf1a15a138f5e69879c22。MASS:先改协作流程,再让同一个模型学进去
作者:Hyunin Lee、Jinglue Xu、Jeffrey Seely、Donghyun Lee、Somayeh Sojoudi、Matei Zaharia、Yujin Tang。机构:UC Berkeley;Sakana AI。首次公开日期(本地口径):2026-10-08;本次依据 v1。
给代码Agent一个开放式研究委托:实现实验、分析结果并交付代码与报告。问题不只是让它多想几次,而是怎样组织多个模型实例,让一个负责规划、另一个完成局部工作,再把必要信息交回来。MASS先优化这套协作说明,再把成功执行时的轨迹用于微调,使下一代模型更擅长完成任务,也有机会更擅长设计下一套流程。
内循环保持权重不变,用文字定义角色、局部指令、返回内容约定和调用顺序;同一个模型分别执行、比较两个交付工作区、依据反馈修改流程,并保留自评更好的版本。外循环让选中的流程多次运行,对工作区做两两比较后筛选轨迹,将调度者与子Agent的对话一起用于监督微调。构造训练数据时去掉显式流程提示,让行为更多进入共享权重;更新后的模型在下一轮重新担任执行者、评价者和流程优化者。
递归点不只是多Agent重复合作,而是下一代权重再次参与生成和评价改进方案。本文还把新模型产生的流程交给旧模型执行:平均64%的比较更偏好新模型设计的流程,为“流程优化者本身有所改善”提供了比整体成绩更具体的证据。与此同时,框架、工具、训练程序与外部最终评价仍由研究者固定,不能写成整个学习系统都能自行重构。
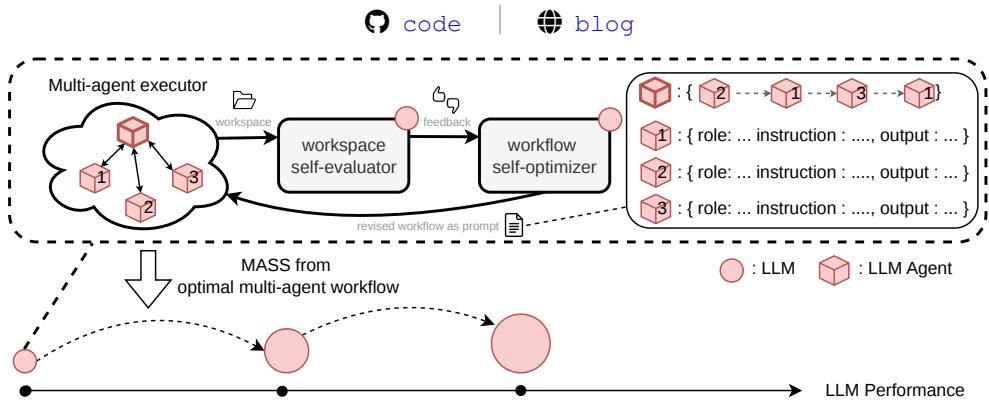 原论文 v1 Figure 1,PDF第1页;原图来源。
先看上方虚线框:执行器产出工作区,评价器给出反馈,优化器返回新的流程提示,权重在这一圈保持不变。再看向下的大箭头,它把多Agent执行轨迹送去微调,产生下一代共享模型。底部变大的圆表示代际更新的示意,不是无限增长的实测曲线。
证据与边界。 实验只完成两轮,使用8个任务产生微调数据,另有3个私有合成任务留出;跨公共研究基准有改善,但不是所有能力普遍上涨。按附录原表,MLR-Bench总体分从1.58到2.40,同时论文交付次数从31/60到50/60;仅对已交付样本求均值却是3.07到2.88,而且两组完成的任务不同,既不能据此断言质量下降,也不能把总体提升全部说成研究质量提高。Terminal-Bench 2.0与SWE-bench Verified均未提升。信息流分析支持行为变化的线索,尚不能证明它是公共基准收益的唯一原因;论文还说明MLR-Bench的180次执行没有调用委派工具。
评测数据集与环境。 已核实来源:MASS v1 附录C.5与Table 7。本篇口径:私有12任务中9个计划训练、实际8个进入SFT,3个留出;公共测试为ScienceAgentBench 102×3、MLR-Bench子集12×5、AstaBench Hard 40×3、DSBench数据建模74×3。Terminal-Bench 2.0计划89×3,三次共同可评分分母为86/88/87;SWE-bench Verified计划500×3,分母499/499/496。乘号后是重复试验,不是新增任务;研究rubric、交付率和程序通过率分别解释。正文个别四舍五入数值与附录有差异,此处按Table 7及其明细。
完整中文摘要
在开放式研究等难以自动验证的任务上,模型递归自我改进面临监督瓶颈:当输出超出人类专家可可靠评价的范围时,被优化的模型自己可能成为最好的优化者与评价者,但单个模型实例难以在这样的同源循环里批评并改进复杂推理。为此,我们提出多Agent自监督MASS,在进化式工作流优化与使用自身生成轨迹的监督微调之间交替进行。受多Agent拓扑在复杂推理上的早期结果启发,MASS让一个基础模型反复提出、执行和自评多Agent工作流。在结构约束下进行进化搜索,为任务寻找更有效的角色与信息路由。使用Qwen3.6-27B进行两轮MASS后,模型在四个开放式公共基准上的单位输出token表现达到原来的1.2–1.6倍。由于改进后的模型随后也能成为更好的优化者和评价者,这种交替框架提供了持续递归自举能力的路径。多Agent轨迹还表现出更高训练效率:用它训练的学生超过了使用约1.4倍训练token的单Agent学生。这些结果表明,联合学习编排与有边界的子Agent执行,可以为递归自我改进提供有效监督。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.12176v1):§3 Algorithms 1–3,§4.1–4.4及Table 1;Appendix B的训练划分,C.5/Table 7(PDF第20–22页)与G的行为审计。摘要中持续自举是作者方向性表述,实测为两轮。 - PDF SHA256:9018fa312c4dac659426fab2b304357593f5f4ad7886d73589f34dd06012f282。GRPODropout:答对的轨迹,也未必都该拿来更新
作者:Hexuan Deng、Zihao Yan、Xuebo Liu、Shuo Nie 等。机构:哈尔滨工业大学(深圳);北京中关村学院;XinzhuAI。首次公开日期(本地口径):2026-10-08;本次依据 v1。
训练数学推理模型时,对同一道题采样8份解答,再按是否答对调整模型。直觉上,所有正确解答都值得强化;但如果某条正确路径本来就特别容易被模型生成,反复强化它可能让模型越来越只会走这条路。本文问的是:采样预算不变,只少用一部分轨迹参与梯度更新,能否保留更多探索空间?
方法先根据每条完整轨迹在旧策略下的概率和组内优势,估计它对策略熵的一阶影响;优先筛掉一小部分高概率、正优势且预计使熵下降的轨迹。删除不是最后一步:剩下的正负信号已失去原来的平衡,因此再用旧策略概率加权计算一个中心,从保留轨迹的优势中减掉它,之后才进入原有GRPO更新。仍需先生成候选,少用于更新不代表少花了相同比例的采样成本。
相对于本文比较的token掩码、奖励调整和熵约束,这篇把操作单位放到完整rollout,并把“删除”和“重新居中”作为组合检验。消融中只删不居中会严重退化,所以不能把结论简化成随机扔掉正确答案就行。理论提供局部更新下的设计动机,作者也明确它并不能完整解释真实神经网络训练。
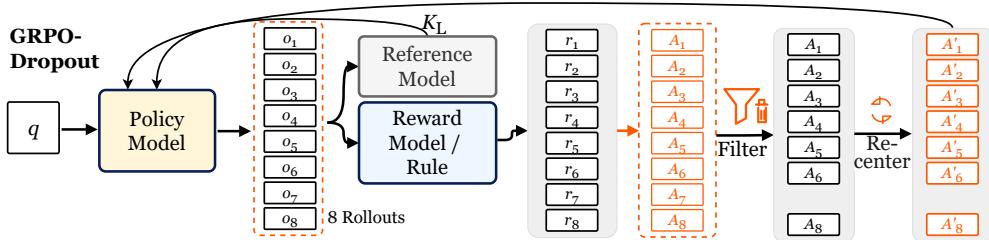 原论文 v1 Figure 1,PDF第4页;原图来源。
从左侧题目进入模型,看它先生成完整的8条轨迹。沿右侧走,奖励变成优势后才筛除一条,再对保留项重新居中,最后回到策略更新。图里的Reference Model表示通用目标组件;正文附录明确本次原始GRPO基线没有额外参考策略KL项,不能见图就假定所有实验都用了它。
证据与边界。 三种Qwen3规模、十项数学与问答测试的平均结果,相对原始GRPO提高1.55个百分点;4B模型训练记录里,在排除全零优势组后,平均每题参与更新的轨迹为7.03条,而基线为8条。效果没有全面胜过更强熵控制基线:4B和8B的十项均分都略低于KL-Cov。实验主要是单轮数学后训练,不能直接外推到长程工具Agent,也不适用于只有一条rollout的训练。
评测数据集与环境。 DAPO-Math-17K用于训练,不计为测试。最终评测为GSM8K、MATH-500、OlympiadBench、AMC23、AIME24、AIME25、HMMT25、ARC-C、MMLU-Pro及SuperGPQA。本篇AMC/AIME/HMMT报告Mean@32,其余Mean@1;Mean@32是32次采样的平均正确率,不是至少命中一次的Pass@32。十项均分等权,最大生成长度8192。
完整中文摘要
GRPO等强化学习方法显著改善大语言模型推理,但常出现策略熵坍缩:采样多样性降低,削弱探索并限制后续提升。已有方法通过奖励修改、熵或KL正则等算法干预,或token级重加权来解决。我们研究一个互补角度:改变哪些已生成轨迹参与策略更新,也能缓解熵坍缩。在相同采样预算下,并非所有轨迹都有正面作用,有选择地排除一些轨迹可以改善学习。为此我们提出GRPODropout:在标准更新前,用简单策略去除少量高概率、正优势轨迹,再对保留优势重新居中。我们提出rollout级理论分析,为方法设计与阈值选择提供动机。该方法只改变轨迹使用方式,增加的计算开销很小。实验中,它使用更少轨迹进行更新,却比原始GRPO获得更高准确率和策略熵,体现了“少即是多”。这项工作提供了关于强化学习轨迹使用的认识:删除部分轨迹可能改善表现。代码已公开。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.11854v1):§3.2–3.4与Algorithm,Table 1/Figure 2(PDF第7页)、Table 2消融、§5局限、Appendix B.1训练和评测协议。 - PDF SHA256:70c89ed7814b9ceee5b33fd3c611a5f6c1df5dce561bb8ae4e42c7af4278e43d。DIAL-OPD:师生分歧很大,不代表那个token值得教
作者:Anhao Zhao、Haoran Xin、Junlong Tong、Yingqi Fan、Xuan Lu、Ping Nie、Wenjie Li、Xiaoyu Shen。机构:宁波东方理工大学EIT-NLP;香港理工大学;香港科技大学(广州);上海交通大学;香港大学;University of Waterloo。首次公开日期(本地口径):2026-10-08;本次依据 v1。
学生模型先生成一道数学题的解答,教师再逐token指出学生应该增加或减少哪些输出的概率,这就是本文研究的在线蒸馏。可是教师觉得某token的概率是学生的10倍,可能是0.8对0.08,也可能是0.001对0.0001:相对差异一样,后者却是两边都几乎不相信的输出。把有限训练能力都花在这些大比例分歧上,未必有用。
DIAL-OPD为每个已采样token计算师生对数概率差的幅度,再乘以一个反映绝对概率大小的权重。权重使用两者概率的对数平均值,参数β控制它的强度;每条回答只选分数最高的一定比例token。训练仍使用原来的、有正负方向的蒸馏信号,筛选分数只决定位置是否参与损失;未选token仍保留在上下文中,并没有提前停止生成。
本文与按分歧大小选token的对照相比,多考虑了“分歧发生在多小的概率尺度”。它还在相同保留比例下,用非低低概率token替换低低概率token,并设置随机替换对照,检验问题是否来自这类信号。论文已承认PowerOPD等前作也处理低低概率区域,所以不能把“发现尾部不可靠”本身当成全新的贡献;这里重点是监督位置的选择规则及其匹配比例证据。
方案图。 原文图主要展示成绩、训练曲线与token选择分析,没有适合说明完整机制的方案原图;这里用上面的连续过程解释,不拿成绩图代替。
证据与边界。 在4组Qwen3师生配对、7项数学测试中,保留40%位置参与损失时,较全token Vanilla OPD的七项均分最大提高5.25个百分点;“最多”不是每组都提高这么多。主要对照匹配更新步数和保留比例,不能据此宣称节省60%的端到端训练计算。基线的一些选择规则被改成统一比例实现,参考模型也有替代设置;结论范围主要是较小Qwen3学生的数学蒸馏,尚未验证长程工具学习与跨模型家族泛化。
评测数据集与环境。 GSM8K、MATH-500、OlympiadBench主比较每题4次采样;Minerva Math每题8次;AMC23、AIME24、AIME25每题16次。Avg是采样平均正确率,Pass是至少成功一次,七项Mean等权平均Avg;例如AIME25 Pass@16不能与另一篇Mean@32直接比较。DeepScaleR只作训练,主训练800步;初始监督密度实验另用MATH-500单次采样,不能混作主表协议。
完整中文摘要
在线蒸馏使用token级教师信号监督学生生成的轨迹;为避免获取完整词表概率的成本,其采样token版本已成为实际常用方式。但我们发现,监督更多token并不总是更好:学生容量有限,对精心选择的子集训练可以显著超过全token蒸馏。因此关键不是提供多少监督,而是哪些token值得监督。已有基于分歧的准则忽略概率尺度:对数比奖励会把教师强烈支持的token和师生都赋予极低概率的token视为同等信息量,使监督集中在阻碍学习的低低概率token上。我们提出DIAL-OPD,用师生概率的对数平均值对奖励幅度加权,连接对数概率与概率空间。参数β控制权重强度,保留最高分token用于训练。在4组师生配对、7项数学基准上与9个基线比较,只保留40%的token时,较Vanilla OPD及其全token变体的平均准确率最多提升5.25个百分点,并使Vanilla OPD的AIME25 Pass@16从13.33%提高到26.67%。在相同保留比例下,它也超过最强token选择基线,平均准确率相对提升最高18%。即使用4B教师,在两种学生规模下也能超过使用8B教师的最强全token基线,说明有效分配监督可能比扩大教师更有价值。进一步分析显示,适中的β能平衡压制低低概率token与保留有用分歧;token级证据显示,它移除了推理价值有限的大额奖励token,同时保留对推理正确性关键的监督。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.11659v1):§3.1–3.3替换对照、§4.1–4.3机制、§5–6主比较;Appendix B的Avg/Pass及基线适配。原文插图主要是成绩、训练曲线和选择分析,没有适合作为完整机制图的原图,因此不拿成绩图冒充方案图。 - PDF SHA256:5dafd47b0c46c87dcc1d978cdd7bd232bf348da183f6b20d34f0ffbe95743bb8。EvoAlloc:连“给谁评测预算”也成为被改进的对象
作者:Yanning Dai、Yuhui Wang、Nanbo Li、Wenyi Wang、Jürgen Schmidhuber。机构:KAUST Center of Excellence for Generative AI;Sakana AI。首次公开日期(本地口径):2026-10-08;本次依据 v1。
假设代码生成器不断改写一个数学解题流程。每生成一个新版本就跑完整测试很贵,但只凭当前直觉丢弃候选,也可能永远错过好方案。EvoAlloc改的是评测预算分配:每次决定完整测、先做便宜的部分测试,还是放弃;随着结果积累,它还会修改自己用来作这些决定的文字策略。
固定的语言模型读取当前策略、经验记录、父程序成绩、相邻候选结果与剩余预算,决定给候选哪一级评测。观察到足够多完整结果后,系统把支持和反驳案例压缩成可修订的经验,再提出新策略。新旧策略在后续产生分歧的候选上共享实际评测结果:先比较谁少漏掉新的最佳候选,再比较谁少花完整及部分评测。只有新策略按这套固定规则胜出,才替换当前版本。
关键补丁是对本来被放弃的候选随机补做完整评测。否则系统只能看到自己肯给预算的方案,容易把错误筛选标准越强化越深。这里的反事实探索把“差点错杀”的结果送回经验与策略修订;相比本文的一次性分配器和固定策略消融,它检验了持续维护分配经验的价值。模型权重、生成器、最终评价器与策略更新规则本身仍固定。
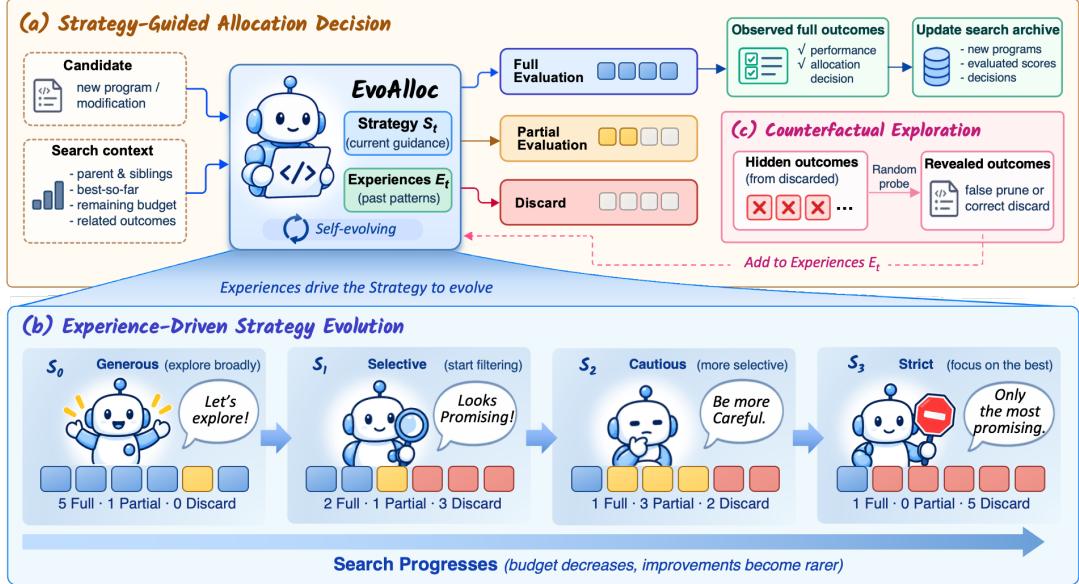 原论文 v1 Figure 1,PDF第1页;原图来源。
从左边候选与搜索上下文进入分配器,蓝、黄、红三条路径分别给出完整评测、部分评测和丢弃。注意右侧粉色框:它从丢弃路径抽样,把本来不可见的结果带回经验。下方从宽松到严格是可能出现的策略演化示意;真正是否替换由正文规定的新旧策略比较决定,不能仅凭模型说新策略更好。
证据与边界。 在两类程序进化任务、各5个种子下,作者报告相对ShinkaEvolve达到同一成绩目标时少用59–82%的完整评测和61–89%的语言模型token,同完整评测预算下最终成绩提高8.7–12.0%。但初始化策略所用50个历史样例的获取成本被排除在搜索成本之外;AIME设置在同一固定30题上搜索和评测,不能把改进直接当作未见题泛化。继承只在单次搜索内验证,跨运行积累仍是后续方向。
评测数据集与环境。 已核实来源:EvoAlloc v1 的ADAS-AIME与Circle Packing协议。本篇口径:ADAS-AIME改写固定Qwen3-8B周围的程序流程;AIME 2024全部30题×3次解题取均值,合计才算一次Full,Partial只用前8题及一次评测种子。Circle Packing是在单位正方形内放26个不重叠圆,最大化半径和,确定性评价,无Partial。每种方法5种子;达到目标的成本取均值曲线首次越过目标的位置,不等于每次运行节省同样比例。
完整中文摘要
基于语言模型的程序进化依赖评测反馈来迭代搜索高性能程序。然而评测通常计算昂贵,因此需要把有限资源分配给最能推动搜索的候选。现有方法往往在整个搜索过程中使用固定分配策略,可能把资源浪费在低价值候选上并漏掉有潜力的方案。我们提出EvoAlloc,一种从搜索经验中学习、修订候选间计算资源分配策略的自进化Agent。它定期把过去的搜索和分配结果整理成可复用经验,并用来支持后续策略修订。它还通过反事实探索机制,偶尔评测被分配器拒绝资源的候选,揭示其结果以丰富未来策略更新的经验。在代码与Agent执行框架优化基准上,达到基线水平所需完整评测减少59–82%,总语言模型token减少61–89%。在相同完整评测预算下,最终表现提高8.7–12.0%。 以上为作者摘要的中文翻译;作者主张与本次核对的证据边界请结合正文阅读。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.12086v1):§3–5,Figure 1(PDF第1页),§6边界;Appendix B.1初始化成本、B.2测试复用,D.3成本统计及D.7策略验收。 - PDF SHA256:59f06200346d3ce349136810c30b2da177ece618dd7f482b0c34cb98fdf739ec。DataSense-Bench:先预测哪些数据有用,再用训练结果验收
作者:Yudi Zhang、Mingyu Cao、Lu Yin、Mykola Pechenizkiy、Shiwei Liu。机构:Eindhoven University of Technology、University of Surrey、ELLIS Institute Tübingen、Max Planck Institute for Intelligent Systems、Tübingen AI Center(据论文首页)。首次公开:2026-10-08 15:50:57 UTC;本次依据 v1。
假设你要把一个小模型训练成能解决终端任务的 Agent,手里有一万条操作轨迹,却只能挑一千条训练。让另一个 Agent 看数据、计算模型损失、检查错误恢复过程,能不能比随机抽取挑得更好?论文进一步要求它挑出五组互不重叠的数据,提前排出预期效果顺序。这样既能检查“第一组选得好不好”,也能检查它是不是真的知道哪些数据更有训练价值。
难点在于,轨迹看起来完整、成功或复杂,都不直接等于它能教会这个学生新东西。数据选择 Agent 可以读取训练配方、写分析脚本,并让冻结的 Qwen3-4B 做前向计算;它不能训练学生,也不能读取下游评测题。四小时结束前,它必须提交数据行号到组别的 CSV 和方法报告,五组成员及预期排序随即固定。随后由外部程序为每组复制一份相同的 Qwen3-4B,按同一配方做全参数 SFT,再用训练后的五个模型执行隐藏任务。更新的是这五份学生参数,选择 Agent 本身不更新,也不会获得成绩后再改选。
本文与等规模随机选集比较,同时把三个判断拆开:第一组的下游分数、第一组是否真是五组中的最佳组、五组整体排序与实际成绩的 Spearman 相关性。第一组胜过随机,并不能证明 Agent 会比较它自己挑出的五组;整体排序较准,也不保证第一名选对。这是本文有用的诊断增量。它没有验证持续改进的数据选择器,更没有把事后验收结果反馈给下一代选择器;不能因为引言谈 RSI 就称为递归自我改进方案。
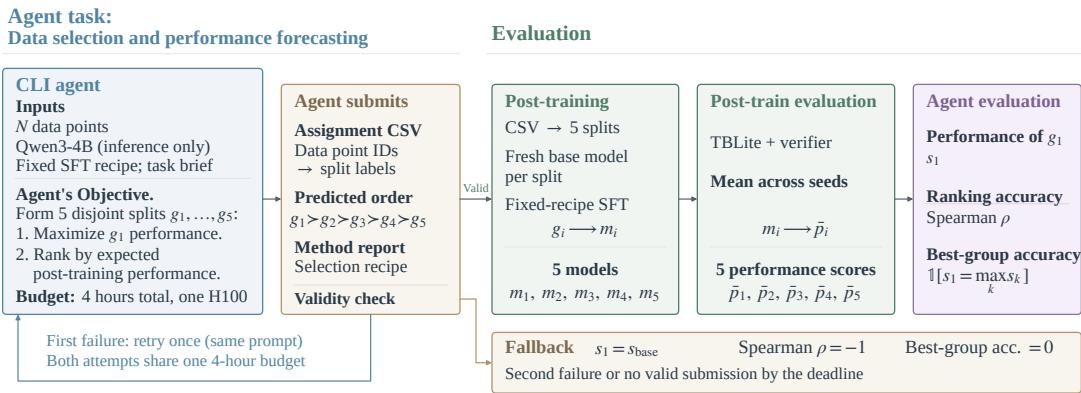 原论文 v1 Figure 2,PDF第3页;原图来源。
从左侧蓝框看起:Agent 只在这一侧分析数据,输出中间的分组 CSV 和预期顺序。跨过“Valid”箭头后才进入绿色的训练与任务执行区域;五组数据分别产生五份模型和五个成绩,最右侧再把实际顺序与原预测比较。下方回箭头只允许提交无效时在原四小时内再试一次,不是根据训练成绩自我修正;第二次仍无效时进入惩罚评分分支。
证据与边界。 BFCL 上六个选择 Agent 的首选组平均准确率均超过随机参考,但提升仅0.35–1.78个百分点;终端任务中十个 Agent 有两个低于随机参考,差值范围为−0.55至+0.99个百分点。论文中的 Astra 在三次 BFCL 选集中都找到了最佳组,在终端任务中却只做到一次,说明这种判断不能直接跨任务推定。尤其要注意:每个任务的随机参考只有一个固定选集,重复评测测的是这组数据对应模型的执行波动,不是随机选集的分布;学生也只用 Qwen3-4B,训练 seed 固定。因此小幅差异不足以证明普遍优于随机。附录还承认,禁用反向传播入口和检查轨迹,并不能完整认证所有访问限制都被执行。
评测数据集与环境。 训练来源是 OpenThoughts-Agent-SFT-10K 和剔除验证轨迹后的 EnvScaler SFT 池,不是测试集。终端任务每次提交5组×1,000条完整轨迹,十个选择 Agent 各运行3次;已核实来源:本文 v1 §4.1、Appendix A 的 OpenThoughts-TBLite 协议,每份学生在100个任务上各尝试3次,共300个等权评分,使用 Harbor/Terminus-2 和 Daytona 新沙箱,指标为平均 reward,允许任务验证器给部分分。工具任务每组50条完整轨迹,六个选择 Agent 各运行3次;复用 BFCL V3 多轮函数调用,本篇测试 base、missing functions、missing parameters、long context 四类各200例,共800例,每份学生按3个评测 seed 跑完整集合,报告准确率。800是本文口径,不覆盖卡中其他论文的1,000例口径。组内训练配方固定;终端/工具分别训练7/2个 epoch,训练 seed 均为42。选择期不能查看评测结果;先对每个学生的评测重复求均值,再算该次选集的排序指标,最后汇总3次选集。
完整中文摘要
随着关于递归自我改进(RSI)与通用人工智能(AGI)的主张不断增多,我们提出一个简单问题:前沿 AI 模型是否具备数据判断力,也就是能否可靠地选择合适的训练数据?我们提出 DataSense-Bench,通过机器学习中的数据选择与性能预测这一基本问题研究这种能力。我们要求 AI Agent 选择并排列可用于微调小型语言模型的候选训练子集。Agent 可以检查数据、编写并执行分析代码、运行模型前向计算,但不能训练模型,也不能访问实际评测任务。随后,我们分别使用每个选定子集微调基础模型,并按标准化协议评估训练后的表现。我们在终端问题求解和工具使用两个场景实例化该基准,分别从 OpenThoughts-Agent 和 EnvScaler 选择轨迹,并在 TBLite 和 BFCL 上评测。我们从两个互补维度评估 Agent:排名第一的子集所带来的训练后表现,反映识别高价值训练数据的能力;以及排序准确性,反映预测所选子集相对表现的能力。实验中,相对随机选择的收益有限;Agent 不能可靠地排列自己选出的数据组,排序能力也不能在不同任务上保持一致:Astra 在三次工具使用实验中都识别出最佳组,却只在三次终端实验中的一次做到。对两个任务执行轨迹的分析显示,Agent 经常使用相似的数据信号,却对它们的训练价值作出不同解释。 以上为作者摘要的完整中文翻译;实验支持范围见正文。来源与阅读依据
[原始论文 v1](https://arxiv.org/pdf/2610.12190v1):§1–3 的问题与协议;Figure 2(PDF第3页);§4.1–4.3、Table 1(PDF第6页);Appendix A.1/A.3/A.4 的训练、随机参考与访问限制。数值已与原PDF文本核对,方案图已对照原PDF页面检查。 - PDF SHA256:8023530641947ecaf4855981b1dfed34f7e53fc95b1fa792dc4ed9ea7a74d66e。RSI-Anything:预测器也会变,但要验收的是整个组合
作者:Taoyong Cui、Pinxian Zeng、Wanghan Xu、Hao Xiao、Shuhan Xue、Qiang Gao、Wanli Ouyang、Pheng Ann Heng、Zhenfei Yin、Yingcheng Wu、Ling Yang。机构:PhAI Labs、香港中文大学、澳门大学、上海交通大学、复旦大学、University of Oxford、Stanford University、北京大学(据 Appendix A 署名,不据机构声誉加分)。首次公开:2026-10-09 17:50:30 UTC,北京时间10月10日;本次依据 v1,PDF首页另标文稿日期2026-10-12。
让代码 Agent 一次提出四个修复方案,但只允许挑一个运行测试。你可以训练另一个小模型预测每个方案的执行结果,再选最有希望的那个。问题随之出现:如果 coder 开始提出不同类型的修改,预测器还能相信吗?如果预测器更新了,它挑出的方案是否反而不适合当前 coder?RSI-Anything 把这两个组件放进同一套更新与保留协议,要求后续运行使用经过验收的组合。
沿着修复例子看,当前 coder 提出候选,世界模型预测各候选在测试中的结果;只有被选中执行的候选,才产生可与预测配对的真实反馈。框架让反馈分别服务两个目的:改进提出或选择动作的策略,以及检验预测器在当前候选分布上是否失准。预测器不是每轮都训练,只有可靠性检查表明有问题、数据足够且预算允许时才尝试适应;没有足够覆盖时应记“证据不足”,而不是判为可靠。历史预测必须归属到产生它的模型版本,不能把旧版本的误差直接混进当前版本的可靠性估计。
接下来先检查新策略和新预测器各自是否合格,再把通过的组件组装起来,与原组合比较。如果组合验收失败,就保留原来的整对组件。下一轮继承的是通过检查的策略参数或工作流,以及预测器版本;任务目标、最终评价、预算、接受和停止规则仍固定。代码实验实际只启用了其中一条更新路径:ReasonFlux-Coder-7B 固定,W1执行结果预测器由 Qwen2.5-Coder-3B-Instruct 适配并用 LoRA 更新。不能把框架允许更新 coder 写成该实验已经训练了 coder。
本文与容量匹配的静态验证器、固定世界模型和自适应世界模型逐层比较,显示“更会选候选”和“从执行反馈更新预测器”可以分别贡献收益。更值得带走的设计问题是:组件单独改进,并不保证组装后的决策更好。不过,组合验收的完整多轮价值还不能从不同领域各自完成的一部分实验拼接出来;它是本文明确提出的协议,不是已经证明持续有效的通用RSI算法。
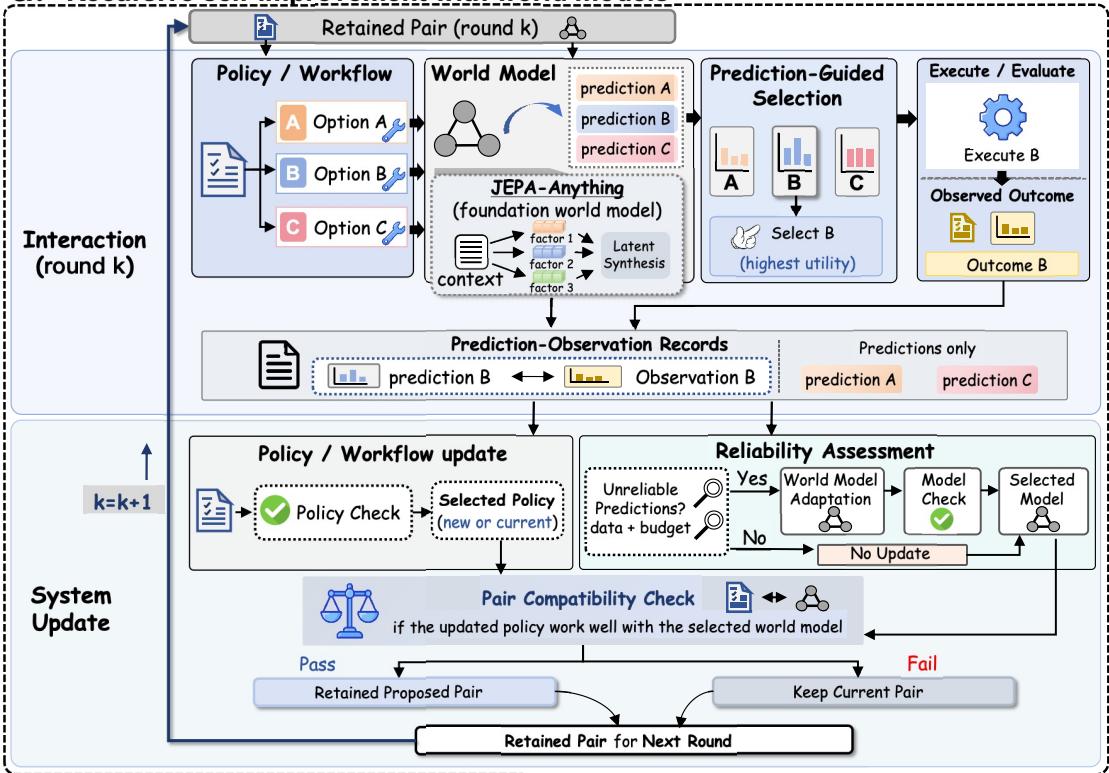 原论文 v1 Figure 2a,PDF第4页,保留完整机制面板;原图来源。
从最上方 Retained Pair 出发,沿右侧走到执行 B:只有 B 的预测和实测组成下方虚线框里的配对记录,A、C仍只是预测。再沿下半部看两条分支:左侧尝试策略修订,右侧先判断是否需要更新预测器。两条路径最后都汇入 Pair Compatibility Check,失败箭头返回旧组合。最左侧的大回箭头表示被接受的版本参与下一轮;图中完整闭环是框架设计,各实验启用的部分要结合 Table 4 阅读。
证据与边界。 在200道 CodeContests 题、3个种子、最多3轮反馈下,隐藏测试全通过率从静态验证器的26.3%变为固定世界模型的29.2%,再到自适应世界模型的31.2%;在线测试调用约为每题3.71–3.72次。固定世界模型相对静态验证器的配对差为2.83个百分点,95%区间为[0.17, 5.50];不能把这一置信区间移给后续2个百分点的适应增益。测试调用相近也不代表训练预测器、生成四候选和验收的总成本相等。
实验室规划的五版策略在同一200题上从21.80%升至46.01%,这是单条开发过程的序列规划分数,不能称为真实设备执行成功率。GUI部分报告双组件更新,但更新细节、验收阈值与完整计算对照披露不足。作者在 Discussion 明确承认:仍需同一任务的联合多轮实验,才能证明策略和世界模型持续互相改进。化学部分是有限实验次数下的搜索;免疫科学部分在下游分析时冻结预测器,提出的治疗假设仍待实验验证,不能把这些结果合并为普遍有效的递归增益。
评测数据集与环境。 CodeContests本篇200题×3种子,600为题目—种子评测数;在线测试供反馈,隐藏测试只用于最终成功。APPS取Introductory 1,000题,LiveCodeBench v6取1,055题,各3种子、每轮4候选、最多3轮,公共测试全过即停止,最终要求完整官方测试全过。MiniWoB++只报告click-checkboxes场景的成功、动作数及重复点击;不将单任务成绩推广至整个基准。已核实来源:本文 v1 §6/Table 4:OSWorld具体版本、任务分母与重复次数待核,因此不套用库内OSWorld-Verified或2.0卡;LabHorizon使用F200的200个Level-2任务,Final Score组合序列相似度和参数准确率,另有Level-1下一动作准确率。本文自建的两套Suzuki–Miyaura反应筛选分别在20和40次实验处比较最佳产率,协议不同、不合并分母;免疫科学评测细节指向引用[13],本轮未独立核查原研究。OSWorld的5.5%为相对RLAnything的相对提升,非5.5个百分点。