RoboRSI:技能修订如何被后续任务继承
作者: Zimo Wen、Yijin Chen、Yuxuan Cao、Wendi Chen、Yanwen Zou、Wenye Yu、Fuhang Kuang、Han Xue、Jun Lv、Chuan Wen、Cewu Lu(按 v1 署名顺序;前三人为共同一作,后两人为通讯作者)。 机构: v1 首页显示 NOEMATRIX 机构标识,但未列逐作者单位对应;不据姓名补其他任职单位。首页依据。
任务背景。 给移动机器人一份收拾房间的清单:找到地面的物品,抓起来,放进各自指定的容器,最后回到停靠点。它能看相机图像和机械臂、夹爪、底盘状态,并调用观察、导航、抓取和放置工具;真正做好是物品确实进入目标容器,而不是工具只返回“动作执行过了”。论文同时在仿真机械臂任务中用环境终态验收。
困难在于,最后没放进去,未必是“放置”本身出错。可能更早就认错了容器,或者观察姿态已经到位却被工具误报失败。直接在最后一步堆重试,既可能修错位置,也可能破坏其他任务共用的抓取或观察代码。作者要解决的是:把一次执行的证据归到负责任的技能,让修复通过检查后才成为以后任务也能调用的能力。
核心方案。 继续用收纳例子:系统先把大目标拆成具有可观察完成条件的小任务,例如“某物已进入指定容器”;完成小任务的技能再调用观察、运动和夹爪等基础技能。每个技能明确自己负责什么、接收什么参数、怎样报告结果。调用者据此使用它,而不是每一层各自猜一次目标是否正确。
机器人执行后,Reviewer 根据新观察和工具轨迹沿调用返回路径找最早不满足完成条件的节点,为其责任分支提出补丁;Manager 审查修改范围和版本,Planner 规划执行,Engineer 调工具和实现技能。修复如果需要改变接口,就先扩大到受影响的调用者。候选在隔离副本中测试:仿真中检查基础技能与完整小任务,至少通过两个声明的开发种子,并经 Manager 批准才能发布;实体机器人则使用保留记录的离线回放与回归测试,不等于把所有旧任务重新实跑。
已发布的代码、技能接口和维护性指导进入下一轮;反复成功的调用序列还会被合并成一个带参数的复合技能。以后 Agent 可以直接调用整段流程,并在失败时返回逐步推理。位置等参数仍从当前感知计算,不把某一次运行的坐标硬写成通用技能。人类提供的目标和纠正也可沉淀成检查或指导,因此经验并非全部自主产生。
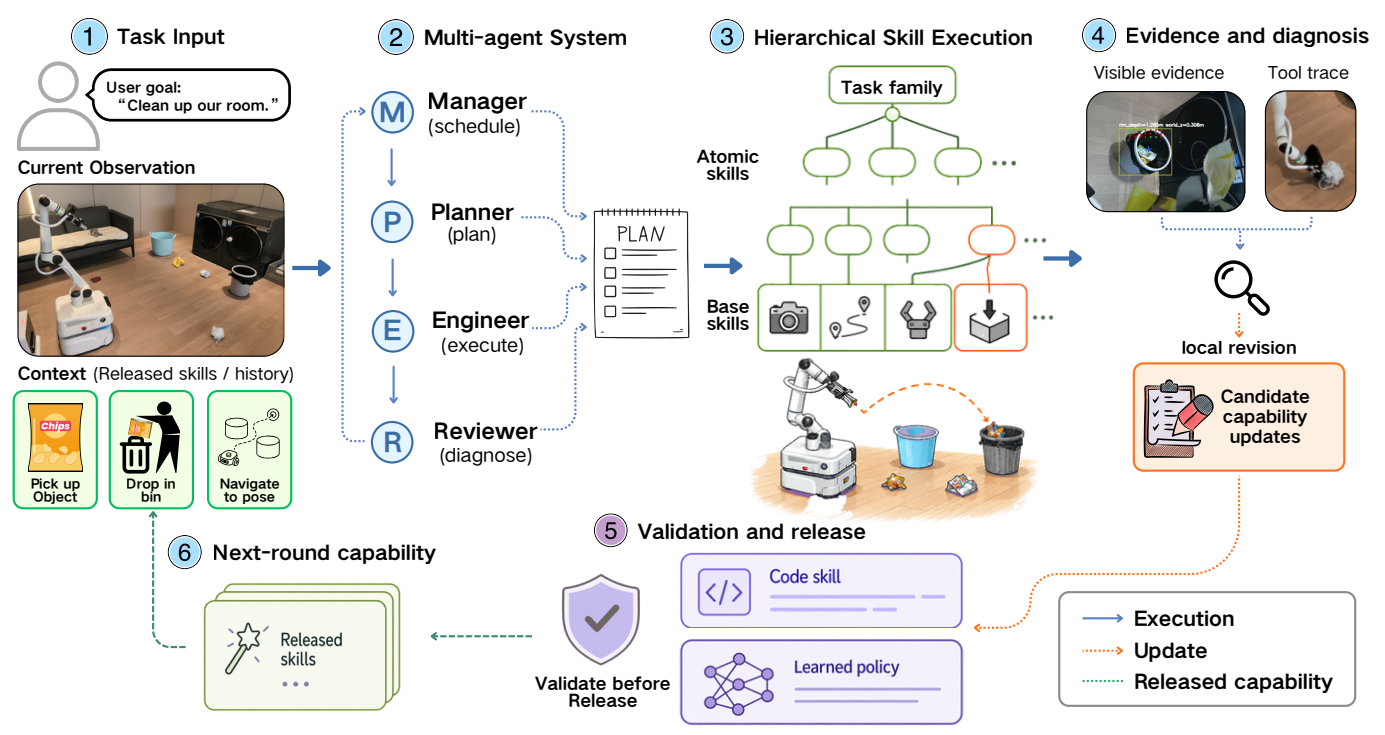
原图:RoboRSI v1 Figure 2,PDF 第 7 页;从原 PDF 裁出,保留全部六阶段与图例。原页。
顺着图读。 从左上用户目标和当前观察开始,左下同时送入已经发布的技能与历史。中间四个角色把目标变成计划,计划沿右侧技能树落到真实操作;工具轨迹和可见结果再送到最右侧诊断。橙色回路代表“提出能力修改”,它必须先到下方验证与发布,才能沿绿色虚线回到下一轮的技能上下文。蓝色箭头主要表示执行,不能把它和跨轮学习混在一起。图中 learned policy 表示训练后的策略也可作为技能接入;正文只提供小规模 ACT 实验,不能据图认定整个语言模型或改进程序都在递归训练。
实际贡献。 相对本文比较的固定代码/工具 Agent,新增的是持续发布技能的能力,而不仅是当轮恢复。其更具体的设计是把可观察的完成条件、责任分支和发布检查连在一起,让共享技能修复进入后续调用。复合技能的成对消融支持“把验证过的多步调用固化”能减少重复决策错误;TSR 与扁平修订的直接比较则只有一个失败任务、两个开发种子,尚不足以证明层次归因普遍更好。
这不就是给机器人维护一套带测试的技能代码库吗? 核心确实接近这个过程。但机器人最棘手的地方是“代码返回成功”与“物理目标完成”会分离,而且一次失败可能起源于更早的观察。本文多做的一步,是沿带完成条件的技能调用关系决定改哪里,再把共享调用者也纳入验证。它仍依赖基础模型、人工知识和预设发布规则;会修技能不等于已经会自行改写修技能的方法。
证据与局限。 主仿真对照固定相同骨干、工具接口和单 episode 交互预算。LIBERO-PRO 为 297/600(49.5%)对 OpenETA 的 231/600(38.5%);但 RoboRSI 在评测流内继续改技能,基线保持固定,所以这是带在线积累的系统收益,不是独立冻结测试。更接近迁移证据的是 LIBERO-Plus:冻结 LIBERO 学到的技能库,354/840(42.1%)对 306/840(36.4%),仍限于相关操作任务的扰动。
另一组独立面板有 600 对匹配 episode,打开复合技能后成功率由 21.5% 到 29.0%,差值 7.5 个百分点;成本另取 118 任务样本。论文的执行 token 小计不含单独测量的规划和审查,完整构建成本还包括生成、诊断、审查、验证,不能把执行 token 下降 29.4%说成整个改进过程同幅省算力。104 次实体运行是变化任务清单下的开发记录,展示的 10 个点经过事后选择,不能当作固定测试分布的单调学习曲线;人工重置、安全监督与部分知识纠正仍存在。RoboTwin 主表也有 154 与 150 episode 的计数差异。
评测数据集与环境。 LIBERO、LIBERO-PRO、LIBERO-Plus、RoboTwin、RoboRSI 自建实体实验。已核对实验正文、表格与附录;具体使用量及用途如下,代码 revision 未披露的地方保留未知:
- LIBERO:主表 30 任务 × 5 初态,150 episodes/方法;在线技能更新与成功率/任务覆盖率。五轮自迭代的 120 任务目录属于另一项累计覆盖实验。
- LIBERO-PRO:120 任务 × 5 初态,共 600 episodes/方法,语言/对象/位置/任务扰动;评测流中更新技能。骨干消融另为 360 episodes/模型。
- LIBERO-Plus:主表冻结技能库,30 基础任务、840 扰动实例;复合技能消融另取 120 任务 × 5 种子,成本样本另为 118 任务,不与主表混算。
- RoboTwin:同一 50 任务面板,基线 150 episodes,RoboRSI 前 154 次在线运行;具体版本待核,不从官方当前 2.0 主分支反推。
- RoboRSI 自建实体实验:104 次收纳开发运行、两场景 5+4 件物品演示;辅助 ACT 实验分别用 10/7 条成功演示训练,铃评 10 个训练布局,闹钟评 7 个训练和 3 个未供训练布局。用于开发与小样本行为克隆验证,不是公共标准测试集。
[!abstract]- Abstract 完整中文翻译 复杂真实环境中的通用机器人不仅应能完成多样化任务,还应通过经验进步,把执行中学到的东西变成后续任务可以复用的能力。以代码行动的机器人 Agent 已能根据执行反馈修复程序,但一项核心挑战仍然存在:怎样围绕赋予经验意义的任务结构组织经验,使每次修复都归属于负责任的能力、有执行证据支持,并在复用前得到验证。我们提出 RoboRSI,一个建立在自顶向下技能细化(TSR)上的机器人自我改进系统。TSR 将任务分解为责任范围明确、具有显式输入输出契约的复合技能、原子技能与基础技能,把每次执行结果归到负责任的分支,并将修订限制在该分支。基于这一结构,Manager、Planner、Engineer 和 Reviewer 协调规划、执行、诊断及经过验证的新技能发布;人类通过目标和纠正引导过程,而稳定的技能序列进一步被整合成可复用的复合技能。在移动机械臂上,RoboRSI 经过 104 轮开发出多物体家庭收纳能力。在仿真中,它在 LIBERO、LIBERO-PRO、LIBERO-Plus 和 RoboTwin 上取得最高成功率,比最强基线高 2.7 至 11.0 个百分点。
[!note]- 来源与阅读依据 身份与时间: arXiv 预印本,2610.12424 v1;OAI arXivRaw 记录首次提交 2026-10-08 17:55:12 UTC,即北京时间 2026-10-09 01:55:12。台账首次发现 2026-10-10 01:10:18 +08:00,本次 2026-10-11 完成正文核验并交付;不称为今天新发论文。
来源: canonical 页面、版本 PDF、论文给出的项目页与代码入口。未克隆或运行代码,项目页内容未作为训练细节的证据。
已读与复核: Abstract、Introduction、§3/Appendix A(机制、作用范围、发布门与成本口径)、§4.1–4.5/Table 1/Table 5/Figure 10、Appendices B/C.2/C.3/D.4–D.5。MinerU 离线解析后对原始 PDF 首页、第 7 页方案图、第 12 页主表及第 24–25 页方法/验收细节直接复核。主方法不报告语言模型参数更新;图中的策略训练分支按辅助实验限定解释。
图片核验: 从 PDF 第 7 页重新裁图,已打开检查六阶段、文字和图例;不使用边缘裁切不全的初次抽图。临时 PDF 和解析产物在收尾时清理,仅保留本页引用图。