SGUID:相关的技能,不一定值得学进参数
作者: Yuhan Liu、Xiyao Ma、Zhongkai Sun、Xu Han、Chengyuan Ma、Benjamin Z. Yao、Chenlei Guo。
机构: New York University;Amazon(v1 PDF 第 1 页)。
任务背景。 给模型一道竞赛数学题,它需要独立推导并交出能与标准答案核对的结果。训练时,可以让同一个模型的教师分支额外看到一条解题提示,再教没有提示的学生怎样生成答案。问题是:检索到的提示看起来相关,是否真的提供了值得学生学习的信号?
核心方案。 当前模型先尝试训练题,把经答案验证的经验整理成技能库。系统先跑一次使用完整技能库的蒸馏:学生自己生成回答,教师额外看到检索到的技能,再对学生的输出提供监督。验证器会判断教师倾向是否与答案正确性一致,门控会滤掉太弱的信号。
接着,系统统计每条技能在训练早期和晚期被检索后,有多少次产生有效的正向监督。只保留早期有贡献、晚期仍有足够贡献且贡献率没有下降过快的技能,再按晚期有效次数排序。这里选的不是“最像题目”的技能,而是当前学生仍然能从中学到东西的技能。
选完后,模型回到这一轮开始时的参数,用精简技能库重新蒸馏。更新后的模型再生成新经验和下一轮技能库,因此参数变化也会改变下一轮可提炼、可学习的技能。技能选择规则、验证器和蒸馏算法本身仍固定。
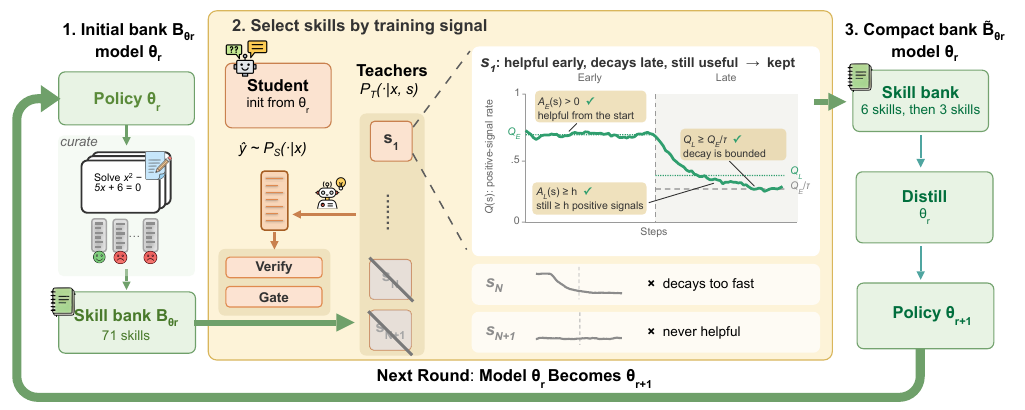
读图。 从左侧当前模型开始,先生成并核验经验,得到候选技能库。中间黄色区域用一轮训练测量技能贡献的持续性:上方曲线代表仍有用的技能,下方代表逐渐失效或从未起作用的技能。右侧只用保留的少量技能训练出下一代模型;底部返回箭头表示下一代重新生产经验。正文补充:右侧训练会重置到本轮初始参数,不是直接沿用中间探测训练的终点。
原图:v1,Figure 1,PDF 第 4 页;图与原始图注。
贡献与证据。 四个模型上,首轮保留 6 条技能在其中三个模型的三项平均准确率达到或超过全库蒸馏;第二轮再选 3 条后,四个模型均达到或超过该基线。Qwen3-8B 的两轮均分从 64.3% 到 66.3%。技能排名消融支持“挑对技能”比仅缩小库更重要,但不是所有模型首轮都胜过全库。
这不就是……先试教一遍,找出哪些解题提示能持续教会学生,再让同一起点的学生重点学习这些提示。新增的一步是按验证器一致的训练信号衡量每条技能,而不是看教师说得多有道理。探测训练本身有成本,技能库缩小最多 11 倍不能解释为总训练成本降低 11 倍。
评测数据集与环境。 AIME 2024、AIME 2025、HMMT25;报告每题 12 次生成的平均准确率 avg@12,而非至少一次成功的 pass@12。DAPO-Math-17K 是训练来源。三项评测的均值同时用于 200 步中的最佳 checkpoint 选择,因此不是与选模完全隔离的最终测试。正文未逐项列实际题数,HMMT25 月份未明确,不套用其他论文的切片。
局限。 只检验两轮共演化,未证明收益能长期累积;选择还需一次完整训练,25 步代理只在部分模型有效。训练时学生关闭 thinking、教师开启,评测开启 thinking;不能忽略这一配置。Figure 2 的“少于 25%”实际统计的是 6,400 次检索事件中通过门控的比例,不是直接证明独立技能中只有四分之一有用。
完整摘要中文翻译与阅读依据
技能是推理时加入的可复用程序性指导,能够显著改善大语言模型的下游表现。以往工作按语义相关性从技能库检索,再将技能用作推理补丁或模型蒸馏材料,但往往忽略单条技能的效用。我们首先发现,在以技能条件策略作为教师的 on-policy 蒸馏中,少于 25% 的检索技能提供有用蒸馏信号。随后提出 SGUID,选择用于蒸馏的紧凑技能子集:只有在训练中持续产生有效学习信号的技能才会保留,再将这些技能蒸馏为更好的模型。结果表明,并非所有技能都值得蒸馏。在 Olmo 和 Qwen 系列的四个模型中,蒸馏 6 条选定技能在三个模型的平均 avg@12 上达到或超过全库蒸馏;第二轮蒸馏 3 条新选技能后,四个模型均达到或超过全库,而完整技能库最多大 11 倍。SGUID 还支持稳定的模型—技能共同演化:每轮蒸馏后,从更新模型的轨迹整理新候选技能库,再选择下一轮内化的技能。第二轮选择 3 条新技能,使 Qwen3-8B 从 64.3% 提高到 66.3%。选择对稳定性至关重要:Qwen3-4B 用未筛选技能直接更新会退化,包括 HMMT25 下降 0.3 个百分点;SGUID 在第一轮和第二轮后分别提高 0.5 和 1.1 个百分点。这些结果将技能选择确定为稳定模型—技能共演化的关键机制。 来源类型:arXiv 预印本,v1;首次提交 2026-10-08 17:27:53 UTC,即北京时间 2026-10-09 01:27:53。日期依据 OAI arXivRaw v1 记录。已核对 Introduction、§2–4、Figure 1–3、Tables 1–4、Appendix A 的训练设置。[原始全文](https://arxiv.org/pdf/2610.12367v1)。上文“少于25%”在解读中按原图的检索事件计数澄清。MetaOPD:让更新后的效果教会模型怎样分配监督
作者: Zipeng Wang、Xinpeng Dong、Yuefan Wang、Pingchen Lu、Xian Wei、Kun Kuang、Fei Wu、Zhongxiang Dai、Min Zhang。
机构: 华东师范大学、浙江大学、香港中文大学(深圳)(v1 PDF 第 1 页)。
任务背景。 学生模型自己尝试一道数学题,教师逐个 token 评价它的回答,学生据此调整参数。不是每个位置都同样值得学:有的分歧关系到推理,有的只是表达差异。如果只按“不确定就多学”这样的固定规则分配权重,很难知道这些权重是否真的让下一次更新更有效。
核心方案。 一个小网络读取师生概率、熵、位置等描述,为每个 token 分配正权重,并让同一回答的平均权重保持为一。系统先用这些权重模拟一次学生的 AdamW 更新,但不写入真实参数和优化器状态。
随后,让虚拟更新后的学生预测参考解答,观察损失。这个损失沿着刚才的虚拟更新反传到权重网络:如果某种监督分配能使更新后的学生更好地预测参考解答,这种分配就获得学习信号。更新权重网络后,丢弃虚拟学生,重新计算权重,再真正更新原学生。每个 minibatch 都重复这一过程;教师、外层损失定义和元更新程序保持固定。
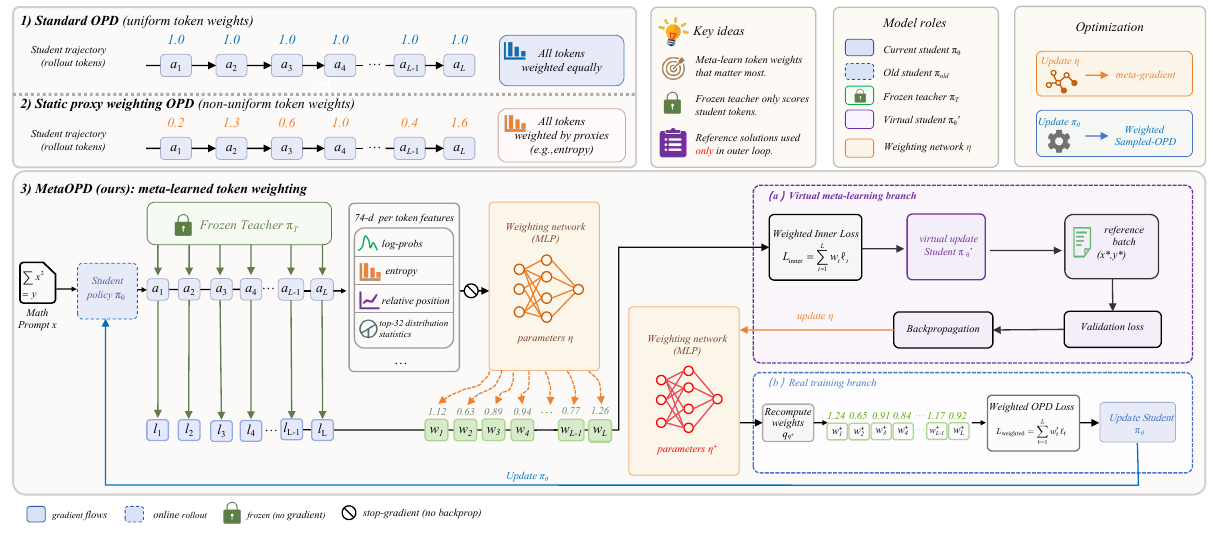
读图。 顶部两行是均匀权重和固定代理规则。下方左侧从学生轨迹与冻结教师得到特征;中间网络输出权重。右上紫框先做虚拟学生更新,再用参考解答损失训练权重网络;右下蓝框才用新的权重执行真实学生更新。两条分支的先后顺序很重要:外层学习的是分配监督的方法,最终保留的学生参数来自真实分支。
原图:v1,Figure 2,PDF 第 4 页;原图与图注。
贡献与证据。 在同一 Qwen3-8B 教师下,0.6B 和 1.7B 学生的六项数学均值相对普通 OPD 分别提高 Avg@8 1.99/2.25 个百分点,Pass@8 5.97/6.41 个百分点。附录比较了直接加入参考答案 SFT 与只通过外层训练权重,说明两种使用参考答案的方法不能等同;部分域外指标仍由其他方法更好。
这不就是……先试着教一步,检查这一步是否帮助学生,再调整下一次“重点教哪些词”。与手写 token mask 的区别在于,分配规则由更新后的效果来训练;它并未让模型自己重写整个训练算法。也不能把元梯度解释为每个词都有独立、稳定的因果贡献,归一化、共享网络和正则会共同改变权重。
评测数据集与环境。 数学评测使用 MATH-500、AMC23、Minerva Math、HMMT 2025、AIME24、AIME25,每题八次采样,分别报告平均正确率和至少一次正确率;本篇未逐项重列所有数学集的题数与 HMMT 月份。域外使用 GPQA-Diamond 198 题、每题八次;MMLU-Pro 12,032 题、五样例提示、单次生成;AlpacaEval 2.0 报告原始与长度控制胜率,本篇实际题数未注明。MATH train 同时提供 rollout 和外层参考解答,两个打乱流允许重叠;以上评测题均不进入学生或权重网络更新。checkpoint 选择的独立性未明确到可声称独立最终测试。
局限。 主要训练使用 seed 42,诊断中的多个采样种子不是多次独立训练。1.7B 的完整训练成本从 OPD 的 45.0 增至 88.5 GPU-hours,约 1.97 倍,包含教师 GPU,但不含评测和诊断;不是等总算力的优胜证明。域外表的总均值把五个不同指标等权混合,不能直接解释为三类任务均匀提升。
完整摘要中文翻译与阅读依据
On-policy 蒸馏使用逐 token 教师监督训练学生自己生成的回答。然而,均匀权重忽略了不同 token 的学习价值差异,现有加权方法则依赖预先设定的、从预测信号到 token 权重的映射。这些映射没有根据实际学生更新的有效性学习,因而难以适应变化中的学习需求。本文提出 MetaOPD,一个联合学习学生模型和轻量 token 加权网络的双层优化框架。内层目标通过加权 OPD 更新学生,外层目标使用一次虚拟学生更新后在参考解答上的验证损失优化加权网络。通过该更新反向求导,将加权决定与更新后的表现连接起来,使预测信号到 token 权重的映射随学生一起演化。在六个数学推理和三个域外数据集、两种学生规模及七个基线上,MetaOPD 显示出有效性:相对 OPD,0.6B 学生的 Avg@8/Pass@8 提高 1.99/5.97 个百分点,1.7B 学生提高 2.25/6.41 个百分点。 v1 预印本,已核对 Introduction、§3–4、Figure 2、Tables 1–2、Appendices B/D/G,特别核对参考解答来自训练集、Table 10 成本及域外指标定义。[原文](https://arxiv.org/pdf/2610.11989v1)。。Agentic-TTT:把何时训练也变成可以学习的决定
作者: Jiahao Lu、Mohan Kankanhalli。
机构: NUS AI Institute,National University of Singapore(v1 PDF 第 1 页)。
任务背景。 一个模型连续收到数学、代码或文档问题。它可以直接回答,也可以先利用题目附带的示例、公开测试或文档做一次小规模训练,再回答;以后遇到相近问题,还能复用先前训练出的能力。这里要解决的不是“怎样把每题都训练得更久”,而是判断哪些问题值得训练、用什么方法,以及何时已有能力就足够。
核心方案。 系统提供四类动作:把材料放进适应池、调用某个训练方法、加载已有技能、生成最终答案。一次适应产生一份可单独挂载的 LoRA,附带能力描述,跨问题保存在技能库;底座权重保持冻结。负责选择动作的策略使用另一份 LoRA,最终回答时关闭策略 LoRA,只挂载所选能力。
训练先用提示辅助收集合乎协议、且经离线评估确有收益的动作轨迹,再删掉提示做 SFT。随后从同一个技能库快照采样多条候选轨迹,用“相比直接回答的收益,减去额外计算与无效动作代价”训练决策策略。候选轨迹评估后回滚,训练流通过标注的动作序列推进;真正评测时才由策略自主积累和调用技能。这一区别限制了对完全自主终身学习的解释。
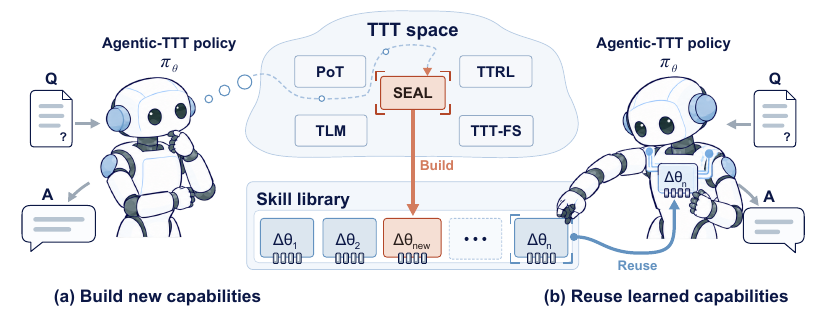
读图。 左侧问题进入策略,策略从中央训练方法集合选择一种方式,把结果保存为下方参数技能。右侧展示另一条路径:新问题到来后不再重新训练,而是从已有技能库加载适用的能力。图示主要强调建立与复用;上文的快照回滚、SFT/RL 和策略 LoRA 关闭来自正文补充。
原图:v1,Figure 1,PDF 第 2 页;原图。
贡献与证据。 Qwen2.5-7B 在 176 个留出查询上的平均二元效用从 0.256 到 0.510;训练后的策略也能随着计算惩罚增加而减少适应,并测试了未参与策略训练的数据域。报告为三个独立训练运行的均值与样本标准差,每个 checkpoint 评估一次。Oracle 使用离线标注,不是可部署策略,也不是严格上界。
这不就是……给模型一个工具箱,其中工具不只查资料、执行代码,还能“训练出一份下次可用的能力”;再用实际收益教它怎样选工具。新增的是学会训练与复用的决策,而不是发明了会自行改写的新优化算法。部署时策略固定,变化的是适应池与参数技能库;没有真实答案时,它仍无法直接确认每次适应是否有益。
评测数据集与环境。 Agentic-TTT 八域精选查询流,来源为 11 个基准家族,训练/开发/测试查询数 229/45/176。实际 SFT 使用 177 条轨迹的 2,072 个 turn,RL 使用 187 个训练输入,不能与来源池大小混用。测试另有 19 个不计任务分数的文档摄入事件,总计 195 个事件;从空技能库开始,按固定顺序执行,自动验证器判定最终回答。方法调用、复用和额外成本均须结合这个协议解释。
局限。 精选套件约 65% 的问题预先观察到适应收益,而完整 MATH-500 中符合本文高收益标准的仅 35/500;这种富集会改变策略选择训练的激励。训练时的标注流推进与自主评测存在差异。文档问答刻意不在最终回答上下文提供原文,以测参数记忆,不能直接与常规带文档 RAG 比较。长期遗忘、可靠验收及真实部署无答案反馈仍未解决。