VERSE:先验证诊断,再让改进器修改自己的工作方法
作者: Zekai Wang、Yingqiang Ge、Zekun Wang、Hai Wang、Yuhui Xu、Joshua Frandsen、Shancong Fu、Ashia C. Wilson、Chandan K. Reddy。
机构: MIT;Amazon(v1 首页)。
来源与日期。 arXiv v1;首次提交 2026-10-02 00:16:30 UTC,即北京时间 10-02 08:16:30。日期依据 arXivRaw 的 v1 记录。
任务背景。 执行 Agent 拿到一个 GitHub 项目的问题描述,在代码环境中查找原因、修改文件,最终提交能通过任务测试的补丁。它周围负责提示、工具调用和执行控制的程序叫作 harness。另一位“改进器”读它的失败轨迹,修改这套程序,希望以后遇到新问题也能做得更好。
困难是,改进器读完失败记录后,可能把超时误判为参数错误,再把错误诊断写成自己的长期经验。只允许它修改更多文件,并不能保证它越来越会改。这篇研究的重点是:怎样先给改进器可验证的证据,再让它改进自己的诊断、编辑和检查方法。
核心方案。 改进器先沿原有流程查看失败,再把长轨迹缩减为仍能重现错误的少数步骤。它可以在提交修改前调用三类检查:让草稿版本重新做目标任务,确认失败是否能重放,以及删去或替换一个可疑步骤后观察结果。这样,“我觉得这里有错”就能接上实际执行证据。目标任务第一次通过还要复跑一次;这些探针只使用训练任务,共享固定的实验额度。
每轮结束后,系统记录哪些故障被修好、哪些重新出现。改进器结合这些记录、工具使用情况和验证集摘要,改写自己的提示、技能文件、工具、自动触发的钩子和笔记。下一轮,它带着这套新工作方法继续修改执行 Agent。因此跨轮保留了两份状态:执行程序,以及修改执行程序的方法。两个底层模型的权重都不变,基础验证工具、轮数和选优规则也保持固定。
最终交付的执行程序由验证集选出,再到未参与修改和选优的测试任务上运行。验证集会返回分数与修复、退化的任务标识摘要,虽然不暴露题目正文和轨迹,它仍然参与搜索,不能把它当作完全独立的最终证明。
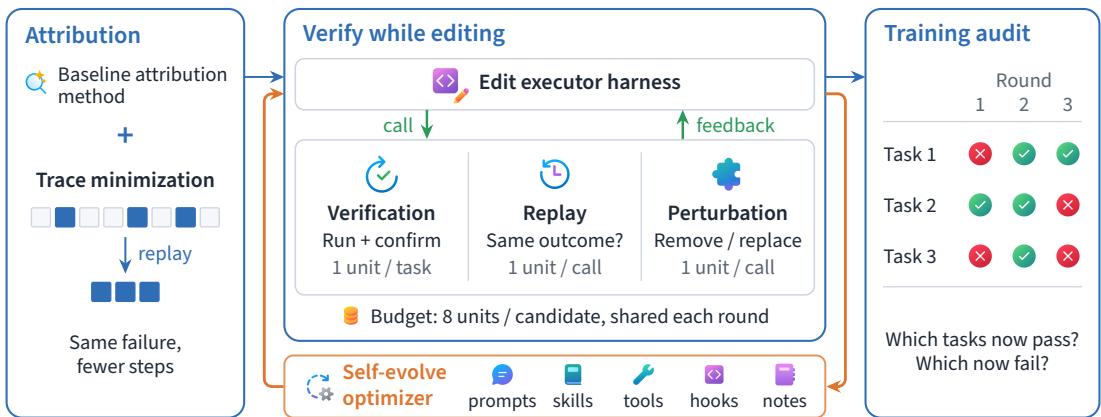
原图 Figure 4,v1 PDF第6页;原文。
读图。 从左侧失败归因开始,长记录被压缩成仍能重现同一错误的短记录,再送进中间的编辑过程。中间向下的绿色箭头表示编辑期间主动调用检查,向上的箭头把执行结果带回编辑器。右侧表格跨轮保留每个任务的通过与失败状态,橙色回路将这些经验送到下方,修改优化器自己的工作文件,再用于下一轮编辑。图中的实验单位不等于实际执行次数:正文说明通过确认和扰动对照可能需要额外重跑。
新增贡献。 这不就是给自动改代码的 Agent 加测试吗?它额外把“怎样找原因、怎样安排测试、怎样记住失败”也变成可继承的修改对象。执行验证为这些修改提供依据,但验证通过不是自动接受:草稿仍需经过共同的候选筛选与验证集选优。这里有改进程序自身变化的结构,也有有限实验支持,不能由此推出持续自加速。
证据与局限。 在最初的受控比较中,仅加入自修改时,验证集最终选回初始版本;简单执行验证与自修改结合后,独立测试均值达到 41.05%。完整 VERSE 在 Meta-Harness 宿主上达到同分布 42.28%、跨时间和语言测试 37.69%,对应宿主基线为 39.20%、28.66%。但对 AHE、Self-Harness 等宿主,部分设置中固定改进器配验证工具反而更好。主表每行只有一条演化链,误差条来自同一产物的三次测试,不能当成三次独立训练。
各方法匹配了候选数和提案轮次,没有匹配总成本:额外验证未从其他执行额度扣除,自修改也增加模型调用,墙钟时间为基线的 1.3–2.5 倍。附录有小模型三条演化链的补充结果,但不能消除主配置的随机性与成本边界。
评测数据集与环境。 本篇使用 SWE-rebench 和 VERSE 的 Terminal-Bench 跨版本划分,依据 v1 §2.2、Appendix D/F。
- SWE-rebench:593 题历史池中选 110 训练、50 验证;2026年3月测试池 110 题中 108 可评分。7月跨时间、五语言测试池 111 题中 107 可评分,含 87 道非 Python 任务。指标为三次执行的平均任务成功率,三次并非三倍独立题目。
- Terminal-Bench:104 道 1.x 任务训练;98 道验证池中每次固定种子取 50;89 道 2.x 任务测试。论文未在此处给出完整 pinned commit,暂不把它静默等同于其他论文使用的 2.0 或 2.1;此项另建论文划分卡保留边界。
完整中文摘要与阅读依据
**中文摘要。** Harness 演化能改善大语言模型 Agent 的提示、工具与工作流,但优化器自身的工具和过程往往保持不变。我们研究:优化器能否通过同时改进自己的失败诊断、编辑开发与效果测试方式,更有效地改进另一个 Agent。两项观察指导了设计。在受控研究中,没有基于执行的验证时,优化器自演化未能改善表现;有验证时,它取得了该研究的最佳结果。在五种执行器上,自演化优化器会为自己构建失败分析、验证、训练审计与工作流控制工具。受此启发,我们提出 VERSE,一种用于 Agent harness 的经验证自演化优化器。它允许优化器在提交前测试草稿编辑、重放失败、扰动可疑步骤,同时跨轮追踪修复与退化。利用这些反馈,优化器既修改执行器 harness,也修改自己的提示、技能、工具、钩子与笔记,而优化器和执行器模型的权重均保持固定。在训练、验证、测试任务互不重叠的共同协议下,VERSE 改善了全部四种被评估的 harness 优化器,在留出的 SWE-rebench 任务以及更新、覆盖五种语言的分布外任务上均有收益。其按验证集选出的最佳 harness 在两类测试上分别达到 42.3% 和 37.7%,最强基线分别为 39.2% 和 29.3%。代码已提供。 **核对位置。** Introduction、§2–4、Figures1/2/4、Tables1/2(PDF1–9页);Appendix D(22–24页,划分和成本)、F(26–29页,重复演化)。[原文 v1](https://arxiv.org/pdf/2610.02616v1);[作者代码](https://github.com/wzekai/VERSE)。摘要的“改善四种优化器”与正文“自修改并非每项都胜过不自修改”同时成立,两者对照不同。GSO:跨任务留下写技能的方法,不把上一题的细节变成通用规则
作者: Xihao Piao、Zifeng Wang、Zheng Chen。
机构: SANKEN, Osaka University;首页为 Xihao Piao、Zheng Chen 标注该单位,Zifeng Wang 未单列单位(v2 首页)。
来源与日期。 本次核对 arXiv v2;真实 v1 提交 2026-09-30 07:14:35 UTC,即北京时间 09-30 15:14:35。
任务背景。 Agent 要根据要求修改电子表格、修复代码项目,或用 R 软件包处理文件。一次任务留下的操作步骤可以写成“技能”,让下一次不用从头摸索。问题在于,某题要求生成的文件、某张表的列名,并不是后续每题都需要遵守的规则。
论文先检查现有技能演化方法:每轮从失败中改写技能,训练题上的进步有多少能留到从未用于修改或选优的测试题?它观察到一种具体失误:把“需要时创建汇总文件”改成“每次都创建”,训练分涨了,新任务却变差了。
核心方案。 GSO 不把上一题的完整操作说明反复改成一份所有任务共用的文件,而是保留一份“怎样为当前任务编写技能”的指南。指南分别说明如何读懂任务、选择工具、写操作步骤、检查结果、定位错误,以及进行一次修复。每个新任务到来后,模型读取当前输入与可用工具,用指南生成本题专用技能;任务结束后丢弃这份技能,具体列名、文件路径和参数便不会直接进入下一题。
训练时若任务失败,模型沿执行记录寻找最早出错的步骤,只修改对应的一部分指南。新旧指南在同一批验证任务上比较:修好的任务数必须超过被破坏任务数的两倍,修改才保留;分级评分任务使用相应分数增减。后继任务继承的是这份经过验收的指南。模型、执行器、编辑流程和验收公式固定,测试时指南冻结,只按当前题目生成一次技能,并可重试一次。
!figure-4.jpg
原论文 Figure 4,v2 PDF 第 5 页;原图出处。
读图。 从左侧的新任务和输入文件开始,上方那份长期指南帮助写出只服务当前任务的技能,再由 Agent 读取它、与右侧环境交互。结果检查失败后,沿底部从右向左追到指南中最先出错的一部分,只改那一部分,再在验证题上比较新旧版;通过验收才沿左侧返回上方。指南留到下一题,本题技能随本题结束丢弃。底部修改回路发生在优化阶段,正式测试时上方指南固定,只有中间的任务技能重新生成。
新增贡献。 这不就是每次重新写提示词吗?不同之处在于,每次写作遵循的指南会从过去的真实成败中被局部修改并跨任务保留;具体任务细节则不保留。它把持久学习与当前任务的适配分开了,但还没有证明指南能跨基准迁移,也没有让验收公式本身递归改进。
证据与局限。 六个基准上,已有方法中有 21 份技能在训练题上提升,只有 5 份在测试题上保留全部增益,13 份保留部分,3 份没有保留;这不是“所有21份都退化”。GSO 在六项测试均最高,比最强已有方法高 4.3–22.5 个百分点,但它多一次生成技能调用及至多一次重试,属于完整系统比较,未隔离这些因素。
另一个 LLM 根据技能内容做事后排名,与测试排序在 108/126 对上相符;这些对并不完全独立,且它对单次编辑效果的预测较弱。不能把 85.7% 的事后排序一致率当成可靠的在线验收器。测试集仅 17–40 题或任务,底层模型只有一种;这里主要是同一任务类型的新实例泛化。
评测数据集与环境。 本篇使用 SpreadsheetBench、SWE-bench Verified、RBioBench Clinical/Omics、SciVisAgentBench、HealthBench Professional 检索版本(v2 Appendix A.2、Table5、A.6)。
- SpreadsheetBench 与 SWE-bench Verified 各 40/20/40 题,依次为训练/验证/测试;后者测试仓库与前两划分不同。
- RBioBench 原始 405 题,本篇两轨道共用 40训练、20验证,测试分别17 Clinical、23 Omics;按输出文件检查成功,软件包族可以跨划分重现。
- SciVisAgentBench 为66/21/20任务,84个合格数据家族不跨划分;HealthBench为40/20/40对话,医疗专科不跨划分。这两项是家族均衡的分级评分,不是简单二元成功率。
完整中文摘要与阅读依据
**中文摘要。** AI Agent 可以把从过去任务中学到的内容外部化为可复用的技能,例如操作程序、检查清单、代码或其他可执行产物,并在解决新任务时检索和复用。自演化技能方法在每轮训练任务练习后持续重写技能,再把技能用于同类新任务。我们提出一个问题:技能在训练任务上的进步,能否迁移到新的测试任务?我们在六个基准上测试五种自演化方法和一种一次性技能,各方法使用相同模型、相同 Agent 和相同训练/测试划分。在训练任务上提升的21份技能中,5份在测试任务上保留全部进步,13份保留部分,3份完全没有保留。没有一种已有方法在所有场景都最好。阅读技能内容后,我们发现迁移较差的技能经常固定本应依任务变化的细节,例如列名和输出文件,或把某次失败的修复变成每个任务都要遵守的规则。阅读技能内容的LLM评判者往往能发现这一点:其对完成后的技能的两两排序,在86%的比较中与测试结果一致。但它对单次编辑效果的预测较差,因此仍然必须通过实际执行来测试编辑。根据这些发现,我们提出通用技能优化GSO:只保留一份编写技能的指南,为每个任务重新编写技能;它在全部六个基准上得分最高。 **核对位置。** Introduction、§3–5、Figures1/3/4(PDF1–9页);Appendix A.1–A.3与Tables2–5(15–17页),A.6(20页)。v2首页第三作者为Zheng Chen,采用本次PDF署名;元数据写Zhen Chen,存在拼写差异。 [原文 v2](https://arxiv.org/pdf/2609.39148v2)。ImproveAnyTask:把错误诊断接到下一轮真正可执行的后训练
作者: Xingbo Yao、Xiaoman Wang、Zhengwu Lei、Tinghui Luo、YiLin Zhang、Yuefeng Wu、Yijie Xu、Tianfu Wang、Qingyuan Zhan、Ye Guo、Daoxin Zhang、Zhe Xu、Jian Liu、Hui Xiong。
机构: HKUST (GZ)、HKUST、Xiaohongshu Inc.、ECNU、ZJU、NTU(按首页机构署名汇总)(v1 首页)。
来源与日期。 本次核对 arXiv v1;真实 v1 提交 2026-10-05 13:48:39 UTC,即北京时间 10-05 21:48:39。
任务背景。 假设你有一个通用小模型,希望它在某类题上变好,比如严格遵守输出格式。你可以给自动研究 Agent 目标任务、可用模型和有限算力,让它检查失败样例、查找可能有效的方法、整理数据并启动训练,最后交回经过测试的模型。真正困难的是:第一轮改正了格式问题,第二轮的主要错误可能已经变了;照着上一轮配方重复训练,未必还有收益。
核心方案。 每轮先对当前模型做目标任务评估,既看总指标,也看具体失败,收敛到一个优先解决的问题。Agent 随后查找多个有研究依据的策略,比较它们是否适用于当前错误、报告过什么收益,以及数据和实现能否在预算内取得。这个比较把“看起来先进的方法”变成针对当前模型、当前任务的训练选择。
选定策略后,Agent 将它落实为数据、配置和脚本:先用小规模数据检查格式与模板,再做短训练排除执行问题,最后开展完整监督微调。新模型回到同一验证流程;没有改善的候选不会接替本轮父模型,失败试验本身仍进入历史,已经验证可用的数据处理和训练脚本也留下来,供下一轮调整方向。持久变化包括模型参数、试验记录和可复用资产,研究 Agent 的外层规则并不随轮次重写。
实际增量。 “这不就是……让代码 Agent 自动跑微调吗?”新增机制在于把每一轮的错误归因、方案比较和执行前检查组织成固定闭环,让后一次训练有前次成败可依据。这里的“更新方向”借用了梯度优化的类比,并没有通过研究流程计算元梯度。
!figure-2.jpg
原论文 Figure 2,v1 PDF 第 4 页:从错误归因到可执行模型更新的流程。
读图。 从右半图最上方开始,输入是当前模型、历史试验和已经留下的资产。沿三排向下,第一排找出要改的错误,第二排把错误转成值得试的研究方向,第三排将方向变成可运行的数据与训练配置;底部输出下一轮的模型和记录,再沿右侧箭头返回。左侧的梯度图是解释这三个环节如何对应“误差、方向、更新”的类比。图中的回路表示流程允许再试,并不表示每次尝试都能带来正收益。
证据与局限。 11 个任务分别从初始检查点独立启动,每项预算为 24 小时、相当于 8 张 H20,主结果为两次独立运行;并非一个模型按顺序学完 11 项能力。Base 和 Instruct 的平均提升分别为 18.29、11.97 个百分点,但 SuperGPQA 的 Instruct 结果从 49.78 降至 47.77。最终候选选择排除了初始模型,因此“失败时保留父模型”的循环规则不能保证最终交付优于原始模型。论文也没有证明目标任务变好后其他能力不退化。
延长至 100 小时的 IFEval 轨迹产生 8 个候选,其中 C7 为 85.18,C8 回落到 83.00;这不是连续接受了 8 次改进。预算包含研究、数据处理、失败尝试和训练,优于只比较训练时长,但不同 Agent 后端的对照仍属于系统整体比较。检索的题目精确匹配审计也不等于彻底排除数据污染。
评测数据集与环境。 MMLU-Pro、SuperGPQA、GPQA-Diamond、MATH-500、AIME 2025、IFEval、IFBench、LiveCodeBench v6、Terminal-Bench 2.0、τ²-bench、BFCL v4。以下均为本篇重新划分的验证/最终测试口径,依据 v1 Table 3 与附录 A;验证用于诊断和选模型,不能与最终测试合并。SFT 使用的数据另行检索和构造,表内数量不是训练数据量。
| 评测 | 本篇实际数量与指标 |
|---|---|
| MMLU-Pro | 1,805/10,227,准确率 |
| SuperGPQA | 3,980/22,549,准确率 |
| GPQA-Diamond | 30/168,准确率 |
| MATH-500 | 75/425,准确率 |
| AIME 2025 | 5/25,准确率 |
| IFEval | 82/459,严格 prompt 准确率 |
| IFBench | 45/255,指令遵循准确率 |
| LiveCodeBench v6 | 159/896,pass@1 |
| Terminal-Bench 2.0 | 14/75,任务成功率 |
| τ²-bench | 验证 airline 8+telecom 18;测试 42+96,两个领域成功率的均值 |
| BFCL v4 | 690/3,890 道独立测试题;实际执行 4,152 次,采用论文的分类加权分数 |
AIME 每题一次 greedy 作答,单次测试错对一道即相差 4 个百分点。BFCL 的 131 道 memory 问题在三个后端运行,故独立题数与执行次数不同;13 道 Live Relevance 诊断题不计分,Web Search 不纳入,权重重新归一,不能直接当作完整官方榜单分数。Terminal-Bench 2.0 与本文使用的具体训练材料分开登记。
完整中文摘要与阅读依据
**中文摘要。** 将通用大语言模型适配到具体任务,需要人工投入大量精力设计数据与训练策略。持续改进尤其困难,因为模型更新会改变错误分布,策略也必须随之不断调整。我们提出 ImproveAnyTask,一种在有限计算预算内提升任务表现的自主后训练运行框架。受基于梯度的参数优化启发,该框架将适配组织为错误归因、更新方向选择和可执行模型更新。它结合指标与案例层面的分析确定一个重点问题,随后调查有研究支持的策略,并比较其已报告收益与复现难度。选定策略被转化为训练数据和训练配置,完整后训练之前先做小规模执行检查。后续评估指导模型选择和进一步适配,已验证的策略与脚本则保留下来复用。在相当于 8 张 H20 GPU、24 小时的预算下,ImproveAnyTask 在 11 个任务上对 Base 和 Instruct 模型分别取得平均 18.29 和 11.97 个百分点的提升,最大提升为 41.96 个百分点。 **核对位置。** Introduction;方法与 Figure 2;Table 1、Table 3;长预算实验及附录 A 的划分、执行计数与候选选择。IFEval 延长预算结果以本次 PDF 的 85.18 为准,项目页写 85.21,二者存在差异。 [原文 v1](https://arxiv.org/pdf/2610.06347v1)。Winner’s Curse:循环里的进步,有多少只是挑中了高估的候选
作者: Litao Hu、Yutong Tang。
机构: Meta、Microsoft(v1 首页)。
来源与日期。 本次核对 arXiv v1;真实 v1 提交 2026-10-07 00:05:23 UTC,即北京时间 10-07 08:05:23。
任务背景。 一个模型先用当前指令给客户消息分类,再看自己分错的样例,提出四个新指令。系统在一小批题上打分,留下最高分且优于旧版的指令,继续下一轮。模型权重始终不变,被继承的是获胜指令;成功应当体现为它在没有参与选优的新题上也更准确。
困难在于,小样本成绩含有噪声。每轮专门挑最高分的候选,容易顺便挑中被高估的那个;如果后面反复使用同一批题,这种高估又可能随已接受的指令留下来。于是“日志中的分数越来越高”与“真实能力越来越强”就可能分开。
核心方案。 研究先把一次选优拆成候选的真实收益与评估噪声,并考虑候选共用旧版和测试题所带来的误差相关性。这个模型解释为什么“这一轮最好的候选”通常比它自己的观测成绩差;但单轮模型并不能自动解释反复复用同一选择集的全部长期行为。
为此,作者在实际指令改写循环旁边加了一条只观察、不参与选择的评估通道:候选照常在小选择集上竞争,研究者另用 600 道保留题检查真实进展。后续确认实验把失败反馈池与选择集分离,改变选择集大小和接受规则,观察更谨慎的验收能否改善整条演化链。最后,再用从未参与选择的 64 道题比较初始版与当前版,检查这样的小型独立审计能修正多少报告偏差。
实际增量。 这不就是多次调参把验证集调过拟合了吗?它进一步区分了“最终分数被高估”与“相对起点的增益被夸大”,把候选之间的相关噪声纳入单轮分析,并直接检验验收门槛在完整循环里是否有效。它是一篇审计与机制分析论文,并没有提出已解决自我改进可靠性的通用算法。
核心方案图。 原文的主要图是噪声分析与实验结果图,没有适合独立带读的流程型方案图;本条不把成绩图当成方案图。可以沿上面两条通道理解实验:小选择集决定“下一轮继承谁”,独立保留集只回答“它实际上进步多少”,其结果不返回修改器。
证据与局限。 预注册实验中,16 道选择题得到的最终成绩比保留集高 13–20 个百分点;扩至 256 题后仍高 1–5 个百分点。扩大选择集让 TREC 的真实收益提高,却没有在 GSM8K 上显示同样规律;更大的评估也占用搜索预算。测试过的贝叶斯门槛、统计检验及先选后确认规则没有在完整循环中胜过简单的“更好就保留”,不能直接把加严验收当作修复结论。
从未参与选择的 64 道审计题,把报告增益的均方根误差从 15.5 降到 5.7 个百分点,平均偏差消失,但单次估计仍可能错约 6 点;几百分点的增益仍需更多独立题和不确定性区间。GEPA/MIPROv2 的分析针对本实验中的验证分数,不是推翻那些方法原论文的独立测试收益。确认实验按 ID 分离数据,但 TREC 存在 12 条跨池同文本问题;删除后 588 题的敏感性分析保留主要结论。
评测数据集与环境。 TREC 50 类问题分类、Banking77 银行意图分类、GSM8K 数学问答。本篇合并公开原始 train/test 后重划,探索与确认各有不重叠的 600 道 gold,确认实验还有 256 道失败反馈题以及 16/64/256 道选择题;gold 只用于报告和离线分析。主循环通常 20 代、每代 4 候选,确认实验每臂 8 次运行,不能算作新增独立题。TREC/Banking77 以标签匹配计分,GSM8K 提取最终数字答案。GEPA/MIPROv2 另有 256 道训练池及相同选择集规模;64 题审计需为初始版和当前版各执行一次,共 128 次评估。依据 v1 附录 B、Figure 3 与讨论;具体数据提交哈希待核实。
完整中文摘要与阅读依据
**中文摘要。** 自我改进的大语言模型系统会提出对自身的修改,并保留在小型评估集上得分更高的修改。我们把这一“更好就保留”步骤视为带测量噪声的选择问题,建模单次决策中候选之间相关的误差,并实证研究重复使用评估集会发生什么。在 Qwen 模型重写自身指令、同时用 600 道保留题评估每个候选的运行中,首轮之后大多数提案有害,而模型能够描述每代最佳候选的赢家诅咒大小。使用独立预实验提供的先验后,它能匹配原生循环中首代接受修改的平均夸大幅度,但不能逐个设置准确匹配。在预注册研究中,使用 16 道选择题的贪心循环,其最终选择集成绩比保留集准确率高 13–20 点;使用 256 道题时高 1–5 点。TREC 的保留集增益随选择集扩大而增加,GSM8K 则没有;测试的接受规则在完整运行中没有胜过贪心接受。当当前模型改进一条已有较强能力的指令时,以及在 GEPA 和 MIPROv2 的验证分数中,选择集上的增益同样超过保留集增益。在 64 道从未用于选择的题上同时评估起始和当前指令,可以去除循环报告增益的平均偏差,但单次估计仍会偏差约 6 点。自我改进研究应当报告保留集增益及其不确定性。 **核对位置。** Introduction;单轮噪声模型与预注册实验;§5 的当前模型及 GEPA/MIPROv2 审计;§6 的 64 题独立审计及局限(PDF10–11页);Appendix B 的数据池、重复文本审计与运行协议(17–20页)。 [原文 v1](https://arxiv.org/pdf/2610.09239v1)。CoTrace:训练经验要与下一轮真正使用的执行框架相配
作者: Jixuan Chen、Jiaxin Zhang、Qinyuan Ye、Yada Pruksachatkun、Haoxiang Zhang、Jingming Zhuo、Yifan Zhang、Yutong Dai、Juntao Tan、Xiangyu Peng、Silvio Savarese、Zeyuan Chen、Lianhui Qin、Chien-Sheng Wu。
机构: UC San Diego、Salesforce AI Research、University of Washington(v1 首页)。
来源与日期。 本次核对 arXiv v1;真实 v1 提交 2026-10-07 17:06:59 UTC,即北京时间 10-08 01:06:59。
任务背景。 一个终端 Agent 在容器里接到任务,通过命令查看文件、改代码或配置,最终让环境测试通过。底层模型之外,还有一套程序决定提示怎样写、工具怎样绑定、错误怎样恢复,这就是执行框架 harness。若框架和模型都在更新,上轮成功的操作记录未必仍适合作为下一轮模型的训练示范:它可能依赖已经被替换的工具或提示约定。
核心方案。 每轮先固定模型,让改进 Agent 从执行失败里寻找框架问题,生成和测试候选框架。选出新框架后再固定它,更新模型。两类修改分别在同一组固定晋升题上验收,避免把框架和模型一起换掉后无法判断收益来自哪里;没有改善的候选可被拒绝,平分候选也只有在评估完整且无基础设施异常时才允许接受。
关键在于中间如何使用轨迹。监督训练只收通过任务验证、且生成时的提示模板、工具绑定和处理器与已采用框架相匹配的记录,再用新框架补跑新轨迹,并限制历史比例和单题贡献。强化学习版本则直接在当前框架下采样新交互,用环境奖励训练策略。任务已经学会后,按相应规则退出当前练习集合,用尚未解决的任务补上,因此下一轮会遇到新的困难。
跨轮留下的是模型参数、已采用框架及带来源记录的经验库;搜索方法、训练算法和验收流程本身仍然固定。失败记录帮助改框架,经过核验且适配运行环境的经验才进入训练,这种分工比把所有搜索轨迹直接混成一个回放池更明确。
实际增量。 这不就是先优化 prompt,再用成功轨迹微调吗?新增之处是把“这条轨迹是在什么运行约定下产生的”作为数据入口条件,并把框架验收、模型验收和题目更新分开。不过它比较的是包含来源匹配、补采样、任务上限等因素的完整配方,不能把全部收益单独归因于来源标签。
!figure-1.jpg
原论文 Figure 1,v1 PDF 第 2 页。
读图。 从下方中间的任务 Agent 看起:任务与工作目录进入执行器,模型和已采用框架一起产生交互轨迹。历史沿左侧送到框架改进器,产生新的候选框架;沿上方则进入训练数据选择。上方绿色区域先按当前框架过滤历史,再补新轨迹做监督训练;橙色区域直接执行当前未掌握的任务,用奖励做 RL。两条路线都回到右下角的模型更新,再由底部蓝色箭头把新模型送回下一轮框架搜索。它们是两种训练方案,不表示每轮必须同时做 SFT 和 RL。
证据与局限。 9B 配置在 102 道反复使用的晋升题上,SFT 从 78 解到 88,RL 解到 90;完成的一组交叉评估中,模型与框架各增加 4 题,交互项为零,支持两个组件都贡献,却不是收益互相放大的证据。4B 设置中,SFT 的收益全部来自框架,RL 的收益全部来自模型,说明不同规模的有效更新通道会变化。
“数据更少、更便宜”也需分口径:匹配配方每轮只有 30–50 条轨迹,而混合兄弟框架为 149–308 条,但转换后的训练样本对数量相近;SFT 每轮约 47 GPU 小时低于 54,整条链却约 235 高于 162,因为迭代更多。外部 TB2.1 在固定基线框架下,SFT 与原模型基本持平,RL 平均约多解一题,落在运行波动内。在 SWE-bench Lite,同一个 SFT 模型换回适配框架后从 24.7% 回到 35.0%,仍低于原模型与其框架组合的 37.3%;RL 组合为 41.0%。因此“晋升题显著增长”不能直接写成脱离框架后也普遍泛化。
评测数据集与环境。 Tmax terminal tasks、Terminal-Bench 2.1、SWE-bench Lite。Tmax 原始约 2,200 条,本篇滚动训练/搜索集合每轮 50 题,RL 最多 100 题,102 题用于反复晋升;这些角色按 ID 分离。RL 的 2,304 episodes 是交互次数。外部 TB2.1 为 89 题,各 checkpoint 执行 3 次,报告 pass@1 与 pass@3;SWE-bench Lite 为 300 题,报告 resolved 及未生成 patch 数,并比较不同运行框架。依据 Table 4、§4.3、Appendix C/E;Tmax 的具体数据 revision 未核实。
完整中文摘要与阅读依据
**中文摘要。** 终端 Agent 的能力同时依赖模型权重和负责格式化提示、绑定工具及错误恢复的运行框架。现有框架与模型共同演化方法改进两者,却经常把框架搜索产生的轨迹当作不加区分的回放缓冲区。这忽略了轨迹用于模型训练的价值取决于它生成时所处的框架。为系统分析这一接口,我们建立交替共同演化框架,通过逐组件的晋升决策解耦框架搜索与策略训练。在此基础上,我们提出 CoTrace,一套感知框架的数据配方,显式管理轨迹分流、来源匹配与课程刷新。反复出现的执行失败指导框架合成,策略训练则严格使用与已采用运行框架相匹配的已验证轨迹进行监督微调,或使用新的在线交互进行强化学习。在 Tmax 晋升划分上,CoTrace 将 Qwen3.5-9B 的解出任务数从 78 提高到 88,在线强化学习版本达到 90。具体而言,与汇集多个兄弟框架轨迹的更大语料相比,紧凑且匹配框架的语料以显著更低的计算产生稳定模型收益。此外,Terminal-Bench 2.1 和 SWE-bench Lite 的评估表明,分布外迁移强烈依赖框架相容性:保持训练与评估运行环境一致,可以避免在其他脚手架下观察到的程序性执行故障。 **核对位置。** Introduction、§2 方法、Tables 1–3、§4.3 外部迁移;Appendix C/Table 4 的数据角色与晋升规则。摘要中较低计算的表述应结合正文每轮成本与整链成本的区分阅读。 [原文 v1](https://arxiv.org/pdf/2610.10426v1)。UniSkill:在当前执行者不变时,判断新技能究竟帮了什么
作者: Yifei Lu、Cheng Liu、Dianzhi Yu、Hui Xiang、Ji Zhang、Yuanchu Xiao、Rong Liang。
机构: Qiantang Credit、Ant Group、The Chinese University of Hong Kong(v1 首页)。
来源与日期。 本次核对 arXiv v1;真实 v1 提交 2026-10-07 14:41:51 UTC,即北京时间 10-07 22:41:51。
任务背景。 想象一个 Agent 要在文字环境里找到杯子、清洗后放到指定位置。它可以先检索过去总结的操作技能,再根据环境反馈行动,最后由任务环境判定是否完成。几轮训练后,它既更会行动,也会改写技能;此时某条新技能复用后成功了,究竟是技能更好,还是执行者本身已经变强?
核心方案。 同一策略承担执行与技能提案两个角色。它先带着检索到的技能完成多条交互,再比较同题的一条成功与一条失败轨迹,提出新增技能、修改旧技能或保持不动。为了避免评价只是复述给提案器看过的样例,系统另取同题、同策略产生的成功和失败记录作为参照;不满足这类参照条件的轨迹不用于该提案学习。
评价时先不更新执行者,也不重新运行环境,而是在已经记录的动作上分别计算“给旧技能”和“给新技能”时的动作概率。如果替换技能后,成功轨迹相对失败轨迹的对数概率差增大,就给提案一个正向的行为对齐信号。另一位固定评判者检查编辑操作是否合适、内容是否有轨迹依据且可复用。执行者通过环境奖励学习,提案角色通过这些反馈学习,两项损失共同更新共享策略。
通过评判的新技能还要同时满足“成功动作平均对数概率提高”与“成功相对失败的差距提高”,才写入技能库;下一批任务检索的是更新后的库,执行的是更新后的模型。为避免一次内容写坏就连带压掉“修改技能”这个操作,训练另给编辑操作保留最低探索空间,但不要求三类操作等概率。固定的检索器、评判者和接收规则仍在循环外。
实际增量。 这不就是把成功经验记进技能库吗?它不仅写经验,还训练“如何提出适合当前执行者的经验修改”,并在执行者更新之前评估提案,减少后来模型进步对技能贡献的混淆。不过它测的是固定轨迹上的概率变化,仍然只是实际任务收益的代理。
!figure-2.jpg
原论文 Figure 2,v1 PDF 第 4 页。
读图。 从左上角技能库和任务进入执行者开始,上方交互产生成功、失败两组轨迹。轨迹向下进入技能提案器,同时向右进入比较框;右上锁的含义是比较时固定同一执行者与已有轨迹,只替换技能条件。右侧提案损失与底部环境奖励的执行损失共同更新策略,左下才把符合条件的编辑写入技能库,再返回左上。实际测试阶段冻结模型和技能库,不在测试任务上继续编辑。
证据与局限。 三次独立训练的主结果是 ALFWorld valid seen 成功率 98.4±0.8%,WebShop 成功率 84.7±0.5%、任务分数 90.5±1.4;ALFWorld valid unseen 为带检索 98.2%、不检索 96.6%。这支持参数和外部技能都留下了部分收益,但不能证明它们已经学会无限期自我改进。
两个训练检查点各检查 100 个提案,代理分数与真实替换技能收益的 Spearman 相关只有 0.312、0.367;正分提案中仍有 24.5%、15.6% 导致实际收益为负。每步计时比需要额外 rollout 的 Evolving-RL 更低,但计时只覆盖报告的阶段,部分基线成绩来自旧研究,不能把整张表当成此次同预算重跑。ALFWorld 的主结果使用 valid seen,泛化判断应同时看单独的 unseen 测试。
评测数据集与环境。 ALFWorld、WebShop。ALFWorld 是文字导航与物体操作,主评估为官方 valid seen,额外评估为 valid unseen,指标为各任务类型及全部 episode 成功率;WebShop 是检索、查看并购买满足要求的商品,分别报告归一化任务分数与成功率。两项训练均为 250 步、每步 16 个任务各 8 条轨迹,重复采样不是新的独立任务。主表为 3 次独立训练,评估冻结模型/技能库,温度 0.4。依据 §4、Appendix B/Table 3、D.1/Table 5;本篇实际评估 episode 数、WebShop 测试划分规模及环境提交版本未明确核实,不能用原始库总量补齐。
完整中文摘要与阅读依据
**中文摘要。** 大语言模型 Agent 可以保留从既往交互中提炼的可复用技能,从而在跨任务使用中进步。近期工作联合优化任务执行和技能提取,使策略与技能库共同演化。然而,执行者持续学习时,通过后续训练步骤中的复用来奖励技能提案,可能混淆技能收益与执行者自身进步;直接测试每条新技能又需要昂贵的额外执行轨迹。本文提出 UniSkill,使用共享策略与环境交互,并根据所得轨迹提出新增、更新或不编辑技能库的操作。执行者从环境奖励学习,技能提案则由对比动作反馈指导。这个反馈衡量:将检索到的技能换成新提案后,当前执行者在同题既有成功与失败轨迹上的动作对数概率差如何变化,从而避免为每个提案新增执行轨迹。由于提案层面的反馈可能在技能内容得分不佳时压制本来合适的编辑操作,我们进一步使用技能编辑支持正则化保留探索。实证上,UniSkill 在 ALFWorld 达到 98.4% 成功率、WebShop 达到 84.7%,并保持稳定联合训练。进一步的 ALFWorld 实验表明,共享策略采用更小模型时,该方法仍然有效。实现见 https://github.com/LimOkii/UniSKill。 **核对位置。** Introduction、§3、Figure 2(PDF4页);Tables1/2与§5的提案相关性分析;Appendix B 的训练/评估配置、D.1 的 unseen 测试。 [原文 v1](https://arxiv.org/pdf/2610.10164v1)。AnchorLoop:用历史执行者补充反馈,但一致不等于正确
作者: Wenjie Liao、Liangjie Zhao、Zehong Cao。
机构: Waseda University、Adelaide University(v1 首页)。
来源与日期。 本次核对 arXiv v1;真实 v1 提交 2026-10-07 11:13:35 UTC,即北京时间 10-07 19:13:35。
任务背景。 系统里有一个负责出数学题的模型,以及一个可以调用 Python 解题的执行模型。出题者生成任务,执行者给同题生成多份解答;没有外部标准答案时,系统用多数答案的一致性构造反馈,再训练两者。最终要检查它们在外部推理题上的表现,不能只看自出题、自打分的成绩。
困难是,意见不一致不一定意味着题目值得学,全体答成同一个答案也不一定正确。作者引入上一轮执行者的冻结副本作为参照,希望为只看当前答案的反馈增加一个比较对象。
核心方案。 每个外轮开始,先保存上一轮执行者的参数,作为这一轮不再更新的参照。接着训练出题者:当前执行者和参照各独立生成一组解答,比较两组内部的多数一致率,把正向差额与原有的不确定性、工具使用和去重复奖励一起用于出题学习。此时执行者还没有开始新一轮训练,因此两者权重完全相同;差额来自两次采样,是出题奖励的代理量,并非“新版会做、旧版不会”的学习进度。
之后才训练执行者。当前策略在这些题上不断产生新解答,冻结参照的同题解答则缓存复用。每条当前解答分别与当前多数答案、历史多数答案比较;系统将两种匹配关系的差构成历史优势,再与原有组内优势混合,训练当前策略。轮末保留出题者和执行者的参数,下轮更新参照;本轮题目与参照轨迹缓存会丢弃,不跨外轮回放。训练流程和奖励公式本身不被模型重写。
实际增量。 这不就是拿旧模型当老师吗?旧模型没有提供已知正确的答案,也不要求新模型模仿它;它为当前回答的相对排序提供另一个参照。这个参照有明确失效边界:若当前所有回答完全一致,减去组均值后两项优势仍然都是零,即使历史多数答案不同也不能救活这个全共识组。
!figure-1.jpg
原论文 Figure 1,v1 PDF 第 4 页。
读图。 先看右上,上一轮执行者被复制并冻结,形成整轮共用的参照。实际训练先走下方出题分支,再走中间执行分支,图的上下位置不是时间顺序。中间两组解答各自产生多数答案,但最后打分的是当前执行者的回答:它们匹配当前多数答案还是历史多数答案,由右侧两种优势进入策略更新。下方的箭头把两组采样一致率送回出题者;“处于学习前沿”的示意是一种设计动机,不能从一致率差直接判定题目可学或答案正确。
证据与局限。 两个 backbone、默认三个外轮,Agent0 与 AnchorLoop 各五次独立训练。数学七项等权均值提高 2.5 个百分点,一般推理六项分别提高 2.8、2.7 点。加入参照后,后期仍有收益,且观测到更高的有效优势方差;但方差与收益同时上升,不足以证明因果。
相同外轮数并不等于相同计算预算:8 张 A100 80GB 上每轮从 20.5 小时增加到 24.1 小时,约多 17.6%,还多一份冻结检查点。所有格式正确的生成题都会进入当轮任务池,未按参照奖励筛题;出题者写出的 Answer 字段只用于格式检查,不作为执行训练标签。“无外部答案”描述的是自演化训练环节,最终评估仍依赖外部基准答案和测试。作者还观察迭代与超参下的基准分数,不能把全部结果当作完全未参与开发选择的单次盲测。
评测数据集与环境。 AMC23、MATH-500、GSM8K、Minerva / OCWCourses、OlympiadBench、AIME 2024、AIME 2025、SuperGPQA、MMLU-Pro、BBEH、GPQA-Diamond、HumanEval、AGIEval。训练为 VeRL/VeRL-Tool 的沙箱 Python 交互,数学题完全由课程模型产生,每批 64 题,执行者每题每内步采 8 条,历史模型每题每批采 8 条后缓存;不是这些评测题的有监督训练。依据 §4、Appendix A、C.2/Table 5、D.2/Table 7:
| 评测对象 | 本篇版本、实际数量与指标 |
|---|---|
| AMC23 | 2023 年竞赛题,实际题数未明确列出;mean@32 |
| MATH-500 | 500 题;greedy pass@1 |
| GSM8K | 实际测试题数与划分 revision 待核;greedy pass@1 |
| Minerva / OCWCourses | 272 道 MIT OCW 大学 STEM 题;greedy pass@1 |
| OlympiadBench | 数学子集,题数、语言及模态子集未明确;greedy pass@1 |
| AIME 2024 | 30 题,每题 32 次采样,mean@32 |
| AIME 2025 | 30 题,每题 32 次采样,mean@32 |
| SuperGPQA | 实际题数待核;greedy pass@1 |
| MMLU-Pro | 实际题数待核;greedy pass@1 |
| BBEH | 23 类任务,实际题数待核;greedy pass@1 |
| GPQA-Diamond | Diamond 子集,实际题数待核;greedy pass@1 |
| HumanEval | Python 生成及单元测试,实际题数待核;greedy pass@1 |
| AGIEval | 实际考试子集、语言和题数待核;greedy pass@1 |
mean@32 是每题 32 次回答的平均正确率再对题目平均,不是“32 次中只要一次答对”的 pass@32。七项数学、六项一般推理各自等权平均;5 次独立训练不增加独立题目数。未列出实际题数或固定数据版本的对象继续保留缺口。