VeriFine:策略变强以后,也要重新教评判者怎样看出错误
作者: Zewei Zhou、Rachel Luo、Yulong Cao、Chaowei Xiao、Chensheng Peng、Boyi Li、Thomas Tian、Zheng Lian、Yan Wang、Jiaqi Ma、Boris Ivanovic、Marco Pavone、Wenhao Ding。
机构: NVIDIA;UCLA;UC Berkeley;Stanford University(v1 首页)。
来源与日期。 arXiv v1,首次提交2026-10-06 17:50:29 UTC,即北京时间10-07 01:50:29;PDF页眉另有10月7日,日期按真实v1提交记录区分。
任务背景。 驾驶模型看多视角视频、自车状态和驾驶要求,既生成“为什么应该这样做”的解释,也预测动作轨迹。好的解释要能在画面中找到依据,把相关场景与行动连起来,而不能只是听起来谨慎。导航实验则给当前位置、历史画面和目的地,让模型判断下一步该往哪探索、接近目标还是停止。
若用一个固定模型为这些解释打分,再把分数当训练奖励,策略逐渐变强后可能暴露出评判者从前没有分清的新错误。继续训练不一定缺少数据,可能是评判者已经无法提供有用的区分。这篇研究怎样让这种瓶颈进入下一轮改进。
核心方案。 系统先用一套明确的评分规则检查策略输出,把反复出现的问题归到视觉依据、因果推理或行动要求等方面。根据这些失败,它从大数据池挑选更值得练习的场景,同时筛掉不可靠的示范答案。驾驶任务把评判分数用作GRPO奖励,导航任务则用评判结果选择SFT示范。训练一段后,再由固定的参考型评判者检查真实进展,避免单凭不断变化的奖励分数判断自己变好了。
如果进步停滞,或奖励增长与固定监测结果明显脱节,系统开始改进评判者。它选择当前策略暴露出的疑难样例,交给人类和Agent共同核对画面、解释分歧。Agent据此修改细化评分规则和示例,用保留下来的旧校准案例一起检验,防止只学会新错误又忘记旧规则。评分的大维度保持固定;人的校准评分可以在讨论后修正,独立测试标签则冻结。
这些规则首先作用于较强的视觉语言老师,再蒸馏到较小的评判模型,以便大规模训练使用。更新后的评判者决定下一轮选什么数据、提供什么奖励。实际对照中,每轮策略从同一个基础模型重新训练,继承的是评判规则、校准案例和数据选择方式;这让实验更直接地比较“这一轮监督是否比上一轮更有用”。
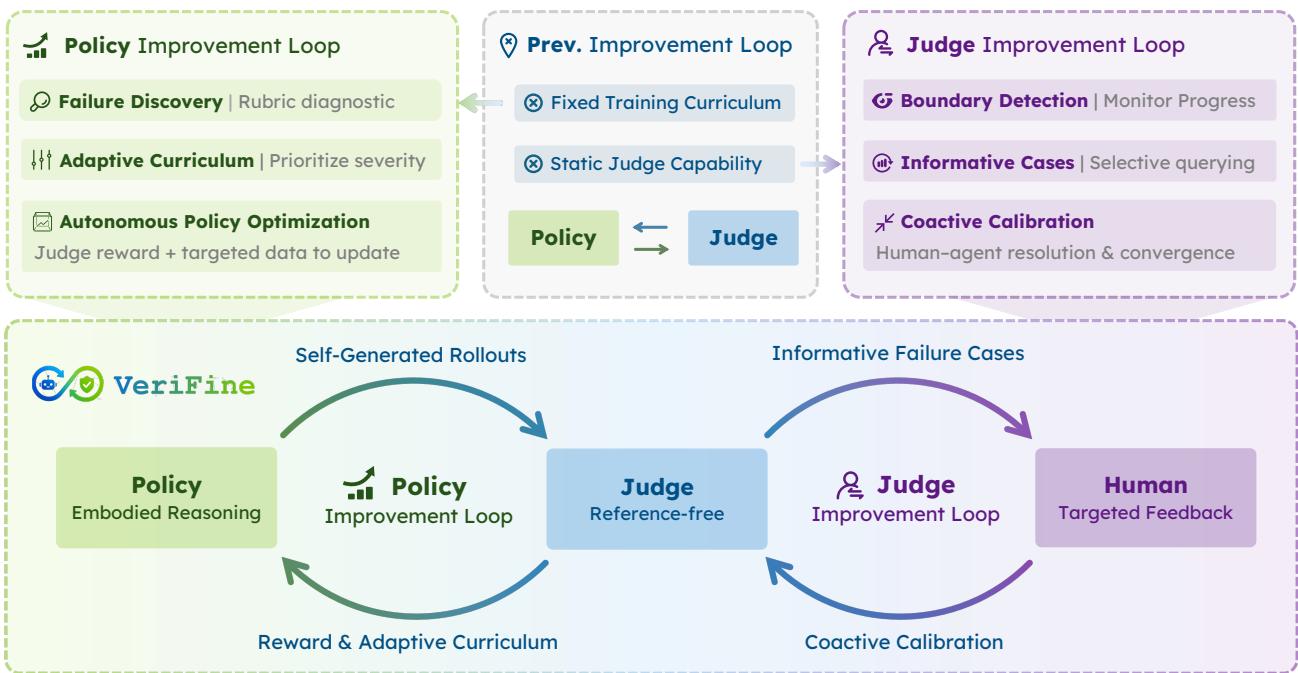
原图 Figure 2,v1 PDF第4页;原文。
读图。 从下方左侧Policy出发,执行产生的输出沿上方箭头送给中间Judge;左环的返回箭头把奖励与新课程送回策略训练。右环并非每次行动都找人:遇到值得校准的错误后,才把案例交给Human,再将讨论结果带回Judge。上方两侧分别展开这两种循环。图中Policy的循环形状容易让人想到参数逐代续训,但正文的受控实验明确每轮重置策略;跨轮保留监督状态的时序要结合正文理解。
新增贡献。 这不就是人类反馈训练加一个LLM裁判吗?具体新增在于,策略的新失败会反过来决定哪些评判规则需要修改,而新规则又改变下一轮课程和奖励。它构成了改进评价器、再改善学习的有限闭环,但人的知识和固定监测依据仍在系统边界之外,没有实现完全自主且无外部锚点的递归改进。
证据与局限。 驾驶任务中,固定参考型评判者给出的推理分数由60.56依次到67.30、70.59、71.61;最终比初始高11.05分,即18.2%的相对提升。较小评判模型与独立人工测试评分的相关性最终达到0.82。更有说明力的是困难子集:第一轮评判者相关性只有0.07,校准后第二轮达到0.74,说明新策略确实暴露了旧评判者的盲区。可是主要数据来自内部驾驶集,策略推理评分仍依赖一个固定模型,不是道路闭环安全证明;三轮结果也不能推出长期不会互相迎合。匹配的是单轮策略训练预算,还应另计人类校准、教师调用和评判者蒸馏成本。
评测数据集与环境。 本篇涉及VeriFine 内部驾驶推理评测、VeriFine 导航推理评测。具体使用口径依据v1 §4.1、Table1、Appendix A.3/A.4:
- VeriFine 内部驾驶推理评测:200万clip/25国是原池;40万候选中每轮选2.5万训练。2134策略监测、2772独立策略测试;judge校准433普通+179困难场景,judge测试514+218=732,角色不能混算。指标为推理分、ADE/minADE6和judge对人工的Pearson/MAE;内部访问受限。
- VeriFine 导航推理评测:基于VLNVerse构造1.9万决策样本,每轮选1.3万训练;策略监测182/测试220,来自46个episode、28个scene。两轮judge累计校准212/测试281;决策样本不等于完整导航任务数,新增标注的公开版本未核。
完整中文摘要与阅读依据
**中文摘要。** 自我改进的策略不断暴露新的失败模式,也不断改变评判者需要具备的验证能力。然而,当前固定的评判者限制了优化反馈及有用训练样例的发现,从而限制进一步自我改进。在具身推理中,这一挑战更为突出,因为可靠评估必须考虑空间依据、因果推理和安全意识。我们提出VeriFine,一种Agent Harness框架,通过策略、训练课程和评判者的共同演化扩展验证能力。策略改进循环使用基于评分规则的评判者诊断反复出现的失败,构建自适应课程并优化策略。当进展停滞且验证成为瓶颈时,评判者改进循环选择有信息量的失败案例查询人类指导,并通过协作校准改进评判者;在这个过程中,人类与Agent解决分歧,逐渐趋向物理推理的客观评分规则。改进后的评判者再指导下一阶段的数据选择和策略优化。在驾驶与机器人导航任务上的实验表明,策略和评判者的能力能够在强化微调和监督微调中持续改进。这些结果展示了,随着策略失败模式变化,扩展验证能力如何支持持续自我改进。 **核对位置。** §3 / Figure2(PDF4–7页);§4 / Table1 / Figure3(7–10页);Appendix A.3(23–25页)、A.4.3(26页)、A.5(27页)。有限轮次实证与摘要的“持续”表述分开理解。[原文 v1](https://arxiv.org/pdf/2610.08761v1)。SO-RSI:反复修不好时,先验证自己对故障的解释
作者: Yuxuan Jiang、Aditya Vempaty、Ashish Jagmohan。
机构: University of Maryland, Baltimore County;Emergence AI(v1 首页)。
来源与日期。 arXiv v1,首次提交 2026-10-05 02:25:16 UTC,即北京时间 10-05 10:25:16;
任务背景。 证明 Agent 拿到一个固定定理,需要找到可用引理、生成证明,再根据 Lean 编译器报错修复。外层 Agent 改的是这套办事流程:例如一次取多少引理、如何排序和裁剪上下文、失败后怎样重试。只有最后证明在指定环境里通过,才算把题做对。
困难在于,同一个表面错误可能被不同“补丁”轮流遮住。论文用检索举例:缺引理时增加检索数量,上下文太吵时又减少数量,随后关键引理再次丢失。如果真正的问题是排序差,反复调数量就会来回折腾,无法形成可复用的改进。
核心方案。 SO-RSI 先让原有优化流程继续运行,同时检查历史里是否反复出现同类失败、互相抵消的修改,或预测收益与实际结果不一致。出现这些信号后,系统不立即再打一个补丁,而是列出可能的原因,先查看已有证据,再做范围较小的诊断实验。比如在检索场景里,要区分“相关引理根本没找到”和“已经找到、只是排得太后”,才能决定改召回数量还是改排序。
每次调查都保存问题、假设、已执行的检查、观察结果和仍未解决的疑点。下一轮可以接着查,避免一次上下文结束后重新猜同一件事。证据足够时才把结论转成工作流修改,再交回普通 RSI 的开发集验收;被接受的工作流供后续使用,调查记忆也继续保留。因此它改变的是产生修改建议之前的诊断过程,没有训练一个新的底层证明模型,也没有让测试集参与选补丁。
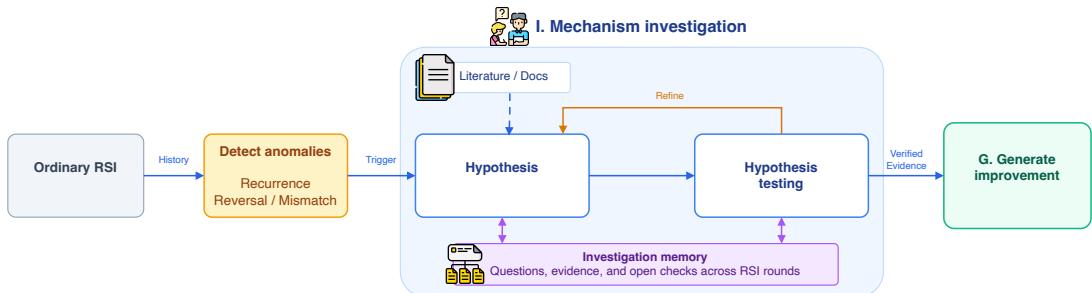
原图 Figure 2,v1 PDF 第 5 页;原文。
读图。 从左边 Ordinary RSI 的历史开始看,黄色区域先判断是否出现重复、反向修改或预期落空。触发后才进入蓝色调查区:提出假设,向右做检查,再沿上方 Refine 箭头修正解释。下方紫色记忆同时连到假设与检查两端,表示两者的中间结果都会跨轮保存。最右侧绿色块接收经过核对的证据,生成修改。正文还规定修改要返回原有验收流程;图本身未画出完整返回路径,不能只看最右侧就当作修改已经有效。
新增贡献。 这不就是给失败多写一点反思吗?新增之处是把解释变成可检查的假设,让小规模探针提供新证据,并把未完成调查留给下一轮。它支持“有机制依据的工作流修改”这一方向,但局部诊断证据不能等同于普遍因果证明。
证据与局限。 在同为24小时的外层搜索下,Lean 留出题通过率从普通 RSI 的 49.4%±2.8% 提高到 71.2%±1.9%,Verus 从33.4%±5.2%到59.2%±3.7%,均为三次独立运行。去掉探针或持久记忆后收益明显变小,尤其 Verus,支持两个组件确实参与改进。不过总 token 用量未报告,不能称为等 token 比较。摘要说“消除”无进展循环,正文 Table 5 实际仍有残余:每100次编辑由18.7降到7.2、由21.4降到8.6;这里应理解为明显减少,而非归零。
评测数据集与环境。 本篇涉及SO-RSI Lean 复合评测、VeriContest — hard。具体使用口径依据v1 §5.1、Tables 3–5、Appendix C.4:
- SO-RSI Lean 复合评测:RSI-Exam 加 VeriSoftBench,共92训练/开发题、48留出测试题;各项目匹配自己的 Lean/库版本。编译通过率,开发反馈参与工作流搜索,最终测试不参与选修改。
- VeriContest — hard:113训练/开发题、46测试题;Verus验证通过率。两环境每题最多3次模型调用、12000 tokens、4次检查和180秒;三次搜索重复不是三倍独立题数。原始基准总规模与各代码commit未核实。
完整中文摘要与阅读依据
**中文摘要。** 递归自我改进使 Agent 能够根据执行反馈迭代优化工作流。然而,标准 RSI 通常像一个一阶优化器:它根据眼前失败的症状反复修补表层参数,容易陷入试错式折腾,却没有解决底层机制。为解决这一局限,我们提出 SO-RSI,将工作流优化提升为二阶诊断式调查,即在实施结构性干预之前先研究失败为何发生。SO-RSI 被动监测执行轨迹中的三种结构异常——重复出现、相反修改和预期不符——以触发针对机制的调查。通过执行轻量诊断探针,并在 RSI 轮次之间维持持久调查记忆,SO-RSI 积累因果证据,用来指导系统性的工作流修改,而非参数补丁。在 Lean 4 证明生成与基于 Verus 的可验证代码生成中,在匹配的24小时搜索预算下,SO-RSI 相比普通 RSI 将最终留出集通过率分别提高21.8和25.8个百分点。行为分析进一步确认,SO-RSI 显著抑制失败重现,并消除无效的零进展优化循环。 上段为原摘要完整翻译;其中“消除”的强表述与正文残余循环数不一致,具体判断以上方证据与局限为准。 **核对位置。** Introduction / Figure 1(PDF 1–2页);§4 / Figure 2(4–5页);§5 / Tables 3–5(6–9页);Appendix C.4(16–17页)。[原文 v1](https://arxiv.org/pdf/2610.05701v1)。停止演化:何时值得停下来,以及该留下哪一版
作者: Enoch Yin、Bin Liu、Zhengling Qi。
机构: The George Washington University(Department of Statistics;Department of Decision Sciences, School of Business);Fudan University(Department of Statistics and Data Science, School of Management;v1 首页)。
来源与日期。 arXiv v1,首次提交2026-10-03 20:47:53 UTC,即北京时间10-04 04:47:53;
任务背景。 一个自我改进系统不断修改自己的提示或技能文档。每改一版,就让新旧两版回答同一组验证题;新版本更好才替换当前版本,之后继续修改。任务可以是检索问答、数学解题或操作电子表格,成功条件由对应题目的验收器给出。
如果几轮以后已经没有实质进展,仍坚持跑完40轮,不仅浪费调用,也可能逐渐迎合验证集的漏洞。这里有两个不同问题:什么时候应停止花钱继续搜索,以及停止时该保留最新版本还是较早的版本。论文把它们放在同一个流程里处理。
核心方案。 系统不只观察当前版本的总分是否上涨,而是保存每一轮候选与当前版本在同一道题上的差别:由错变对、保持原样,还是由对变错。这样,即使候选被拒绝、当前总分看起来没有变化,仍能知道“这次提出的修改到底有多差”。用户预先给定一个值得继续投入的最低预期增益,程序把连续低于这个标准的证据逐轮累积。
为了不让早期大幅进步掩盖后期停滞,每一轮都会新开一条证据累计轨迹,同时继续更新旧轨迹。某条轨迹的证据足够强时发出停止信号;随后利用最强轨迹的起点估计停滞从何时开始,返回那个起点之前保留的版本。因此“第几轮停止”和“交付第几轮版本”可以不同。底层怎样提案、修改提示或技能不变,新增模块只读取评测结果、决定何时终止及返回什么。
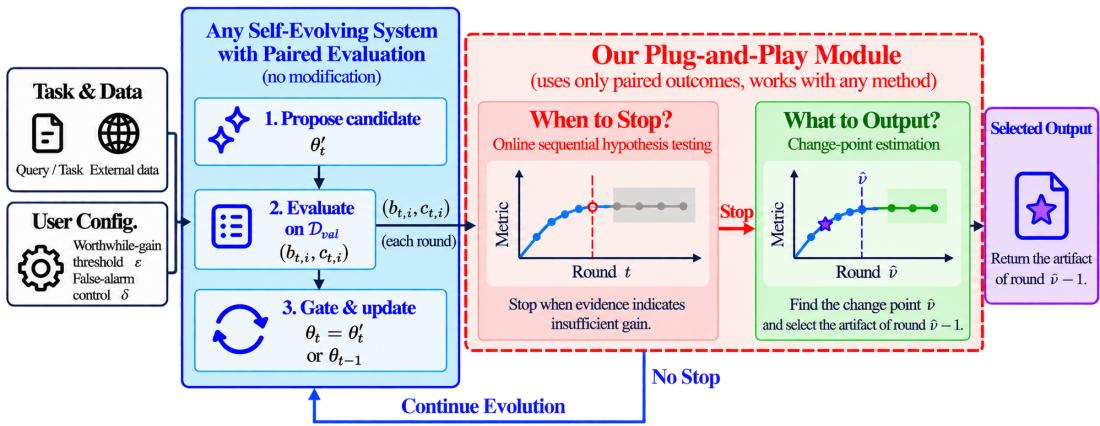
原图 Figure 2,v1 PDF第4页;原文。
读图。 先看左侧蓝色框:提出候选,成对评测,再决定是否接受。每轮评测结果向右送到红色停止模块;证据还不足时,沿底部 No Stop 箭头返回蓝框继续演化。证据达到门槛后进入绿色回选模块,它回看停滞大致从哪轮开始,再把更早的版本送到最右侧。绿色折线是选择依据的示意,不能理解为它能提前知道所有未来版本的真实表现。
新增贡献。 这不就是训练时的 early stopping 吗?相似之处是避免无效计算;具体新增的是利用被接受和被拒绝候选的逐题配对结果,构造可持续监测的证据过程,并把报警时刻与最终版本选择分开。它是固定的改进控制组件,没有修改产生候选的算法,也不直接识别奖励投机。
证据与局限。 SearchQA上,SkillOpt配合DeepSeek V4 Flash在第4轮停止、返回第1轮版本,相比跑满40轮节省91.6% token;相同1400道未见题的准确率为82.43%与82.00%。但差值95%区间为−1.10到1.96个百分点,不能据此宣称早停严格更好;另两项主测试的差值略负,区间同样覆盖零。LiveMath案例中,停止发生在后续“总答A”投机版本出现之前,但这是提前停滞触发的结果,不是算法学会检测作弊。
理论依赖每轮题目结果的条件独立等假设,变点定位还要求进入低收益阶段后保持该状态。对不断变化的真实任务流,这些条件不自动成立。尤其要分清:对所有重启过程一起监测时,文中给的是误报警平均等待轮数下界;δ=0.05不能直接读成“整个运行误停概率不超过5%”。理论也不保证所回选版本在未知分布上始终最优,GEPA的token成本还是由调用数估计的。
评测数据集与环境。 本篇涉及SearchQA、GSM8K、OfficeQA、LiveMath(SkillOpt数学环境)、SpreadsheetBench。具体使用口径依据v1 §4、Tables 1–4、Appendix D–F,版本均为本篇SkillOpt/GEPA实现,固定数据release未核实:
- SearchQA:200题验证/1400题最终未见测试,另缩至100验证题作敏感性分析;准确率、停止轮次和token。验证题反复用于提案比较与停止,不能当最终测试。
- GSM8K:200验证/500未见测试,同有100题验证消融;主实验40轮预算。这里是论文子集,不是原始总规模。
- OfficeQA:24验证/172未见测试,16轮预算;准确率及配对差值区间,文档检索调用也计成本。
- LiveMath(SkillOpt数学环境):本篇图示18题验证,用于停滞后出现投机版本的案例;本文该案例的独立最终测试题数未核实,不套用其他论文划分。
- SpreadsheetBench:16轮持续改善的负对照,期间没有报警;本篇实际子集题数及是否采用Verified版未核实,暂以原对象链接登记版本缺口,不按旧卡的其他论文数字补齐。
完整中文摘要与阅读依据
**中文摘要。** 自我演化的大语言模型系统不断提出、评估并纳入对提示、技能或其他持久产物的更新。尽管这些系统越来越有效,它们通常仍按预定迭代次数或计算预算运行,缺少有原则的标准来判断继续演化何时不再值得。这会带来两个不理想的后果:性能饱和后仍进行不必要的计算,以及最终返回过拟合或利用评测信号的晚期更新。这些问题促使我们研究两个基本问题:自我演化系统何时应该停止,以及停止后应该输出什么?对于前一个问题,我们将其表述为在线序贯检验,并利用自我演化系统已经生成的逐题配对评测结果,构造任意时刻有效的重启检测器。对于后一个问题,我们将其表述为变点估计,利用估计的转折点选择较早的产物输出。所得程序即插即用,不需要修改底层自我演化算法。在两个自我演化框架、三个大模型家族和五个基准上,我们的方法大幅降低计算成本,同时保持相近的未见测试表现。例如,在SearchQA上使用SkillOpt和DeepSeek V4 Flash时,方法在第4轮而非40轮完整预算处停止,减少91.6%的token用量,未见测试准确率为82.43%,完整预算运行则为82.00%。 **核对位置。** §3 / Figure2 / Proposition1–2(PDF3–6页);§4 / Table1(6–8页);Appendix C配对区间、D成本估算、F验证规模。理论陈述按正文条件理解;本次未独立形式化复核其证明。[原文 v1](https://arxiv.org/pdf/2610.04756v1)。ASCENT:把刚刚做成功的任务,变成下一次行动时的参数经验
作者: Haodong Lu、Dong Gong。
机构: University of New South Wales(UNSW Sydney;v1 首页)。
来源与日期。 arXiv v1,首次提交2026-10-04 15:27:20 UTC,即北京时间10-04 23:27:20;
任务背景。 想象一个文本家居环境要求 Agent“把冷却后的鸡蛋放进微波炉”。它先观察房间,再找物体、移动、使用冰箱、完成摆放;环境在任务结束后判断是否达成要求。论文用这个场景说明:上一道题中学会的“先冷却再放置”,能否帮助下一道换了物体和位置的任务,而不是每次都从头摸索?
这里每道题只给一次计分尝试,当前任务的成绩在更新参数前确定。成功经验只能帮助之后的题,不能通过在同一道题上反复练习,把重试成绩冒充首次完成能力。
核心方案。 执行 Agent 完成一次任务后,先等待环境验收。失败就保持参数不变;通过验收,才把成功轨迹交给一份冻结的初始模型。这份模型并不更大,也没有外部标准答案,它的优势是已经知道后续怎样走到了成功,所以能带着事后信息,重新判断早先每一步“接下来适合说什么、做什么”。
执行模型仍站在当时那个尚不知道结局的位置,学习这份老师给出的下一 token 概率分布,而不是把实际生成过的每个 token 都强化为唯一正确答案。更新只写入小规模 LoRA 参数,并随优化器状态保留到下一项任务;底座和老师保持不变。这样,经验不必在下次先检索成一段文字,便能直接影响行动倾向。
作者还从给老师看的成功经验中移除没有实际执行的无效动作,减少噪声。但学生训练的位置仍包括原轨迹中的无效动作位置:它要在那里学会更好的选择,而不是简单跳过这些 token 的梯度。这一区别决定了方法究竟在“清理教师信息”,还是仅仅“挑成功动作模仿”。
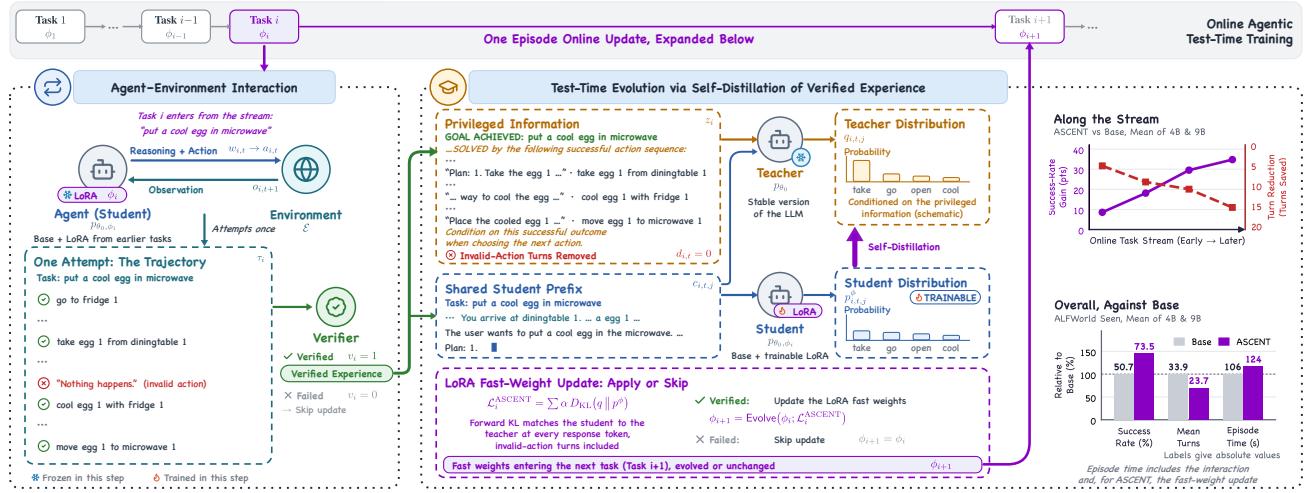
原图 Figure 2,v1 PDF第5页;原文。
读图。 沿顶部任务序列进入当前 Task i,再向下看左侧 Agent 与环境交互。一次尝试结束后到 Verifier:失败分支直接跳过更新,成功分支才把整理过的经验送进中间金色框。老师拿到成功结局,学生只拿到当时的前缀;两者分布的差异通过底部紫色更新框进入 LoRA,再沿向上的紫色箭头带到 Task i+1。右侧图表是这套流程的结果摘要,不是训练信号,也不参与验收。
新增贡献。 这不就是把自己做对的题再做一次监督微调吗?区别在于监督目标来自固定老师的事后判断,而非原样复制成功轨迹。成功轨迹可能有绕路和错误动作,软分布允许老师在这些位置降低原动作、提高替代动作的概率;但没有逐步因果反馈,它仍无法证明哪一个动作真正造成成功。
证据与局限。 Qwen3.5-4B 在 ALFWorld seen 流上的成功率由46.4%升到69.5%±5.6%,在WebShop严格成功率由17.8%到41.9%±0.3%。ALFWorld未见房间另区分冻结迁移和继续适配:4B分别为62.7%和78.6%,应优先用前者判断已有参数经验的迁移。AppWorld挑战集的任务完成改善没有转化为场景整体完成领先,说明局部能力增长不保证整组变体都可靠。论文中的直接模仿和策略梯度退化,是单条在线轨迹、特定配置下的观察,不能推成一般性的“RL不如蒸馏”;WebShop用于更新的验收门槛为分数≥0.9,严格测试成功则要求1,两个口径也不同。
评测数据集与环境。 本篇涉及ALFWorld、WebShop、AppWorld。具体使用口径依据v1 §4、Tables 1–2/4–6、Appendix B:
- ALFWorld:seen 140任务作为在线学习与计分流;unseen134任务用于冻结迁移或继续适配,两协议分开。每题一次尝试、50轮上限,成功率与平均交互轮数;三次独立运行,不把重复数当题数。
- WebShop:500任务在线流,一题一次、50轮上限;严格成功率、平均分与轮数,≥0.9才更新。未把这一流称为全程不参与适配的独立测试集;release/commit本次未核。
- AppWorld:正常168任务/56场景,挑战417任务/139场景;每任务一次、30次交互上限,先计分后更新。报告任务完成TGC与整场景完成SGC,三次运行;不是把所有变体合成一个题数。
完整中文摘要与阅读依据
**中文摘要。** 大语言模型 Agent 通过多轮推理与行动解决长程任务,并在结束时获得一个验证信号。部署后的 Agent 面对相关任务流,因此自身轨迹是自然的改进资源。上下文适配型 Agent 把反思、记忆或技能作为文字存放在 Harness 层,所以复用依赖检索到正确经验,以及冻结策略能够执行这些经验。我们研究在线 Agent 测试时训练,在部署过程中用 Agent 自己的执行轨迹训练大模型权重。Agent 对任务流只遍历一次,每个任务只执行一次;执行轨迹及其验证结果是唯一且即时的学习信号,权重更新跨任务保留。直接模仿或强化这次尝试中生成的 token 会使策略不稳定。我们提出 ASCENT,即面向测试时跨任务演化的 Agent 自蒸馏,转而从经过验证的经验进行蒸馏。一份稳定的大模型——冻结的初始副本——将验证器接受的轨迹作为特权信息,带着这种事后信息预测轨迹上的下一 token 分布。把这些分布蒸馏进持久 LoRA 快速权重,可以在没有外部参考解或更强老师的情况下,为后续任务更新 Agent。进一步从轨迹中移除无效动作轮次,可以形成更好的特权经验,使执行更有效、更高效。我们刻画这种蒸馏的总体目标及稀疏结果筛选的局限。在不同模型规模的 ALFWorld、WebShop 和 AppWorld 上,ASCENT 随经验积累提高任务成功率和交互效率,优于所比较的在线适配方法,并迁移到留出场景,说明部署后的 Agent 可以把自身经过验证的经验巩固到策略中,而无需单独训练阶段或推理时记忆检索。 **核对位置。** §3.3 / Figure2(PDF5–7页,前向KL、老师输入与学生位置);§4(7–11页);Appendix B.3–B.5(19–21页,LoRA rank16、两次AdamW更新及具体协议);Appendix C.1(21–22页,老师是否跟随学生)。[原文 v1](https://arxiv.org/pdf/2610.05303v1)。DAEDALUS:先自己出题练习,再把经得住重试的经验留下来
作者: Antoine Edy、Max Conti、Victor Xing、Marc-Antoine Allard、Nawfal Benhamdane、Gautier Viaud。
机构: Illuin Technology(v1 首页署名;致谢另说明 LIAGORA 合作背景,不把致谢单位当成作者单位)。
来源与日期。 arXiv v1,首次提交 2026-10-06 09:46:32 UTC,即北京时间 10-06 17:46:32;以下依据 v1 正文。
任务背景。 一个 Agent 刚接触一套应用 API,要按用户要求完成跨应用事务。它能够阅读接口并执行操作,却不一定知道哪些操作顺序容易出错、哪些返回结果需要特别检查。等真实请求来了才反复摸索,代价可能很高;但新环境又没有现成训练题和自动验收程序可供练习。
DAEDALUS 让 Agent 在正式使用前自己练习。例如,可以假设它在一个办公环境里探索如何找到记录、检查条件并修改状态;这只是帮助理解的例子。论文实际研究的是应用操作、零售客服和企业操作环境,最终仍由各基准的任务完成规则评测。
核心方案。 系统先浏览环境,把值得覆盖的功能整理成标签。负责出题的 Agent 再实际操作环境,提出自己能够完成、又可能难倒执行 Agent 的任务,并写出成功条件。执行 Agent 从干净状态尝试;一旦失败,另一个组件根据任务和失败轨迹写出一条操作经验,让它带着这条经验重新尝试。经验只有在至少经历过一次失败、随后连续成功三次之后,才进入记忆库;一直失败的题和从未失败的简单题,都不能按这条规则贡献经验。
出题也会收到反馈:太简单就加难,过难就调整。任务怎样修改才有效,会另外存进“出题指南”,供下一次练习使用。因此跨轮留下来的有两类东西:帮助执行的经验,以及帮助继续产生合适练习的指南。最后把执行经验整理、去重,作为一份固定记忆放进测试 Agent 的初始上下文。这里的成功判断来自 LLM 对任务成功条件和轨迹的检查,不能把“不需要 oracle verifier”理解成“没有验收”。
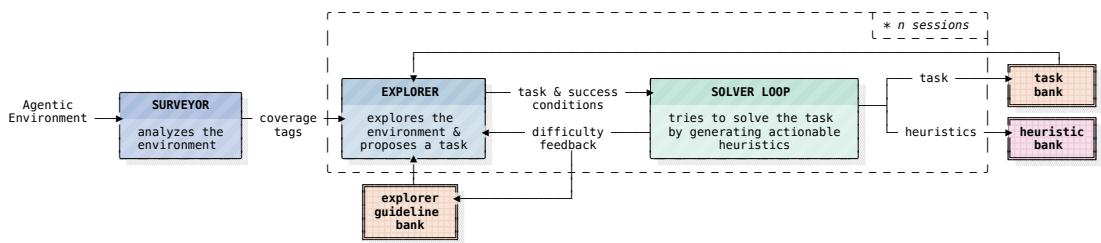
原图 Figure 2,v1 PDF 第 3 页;原文。
读图。 从最左侧环境开始,Surveyor 先把覆盖标签交给 Explorer。沿主箭头向右,Explorer 交付任务和成功条件,Solver loop 才开始尝试、提炼经验和重试。返回 Explorer 的箭头表示难度反馈;下方单独的指南库把这次出题经验保存给后续 session。右侧则分开存任务和已通过验收的操作经验。图中虚线圈住的是部署前反复练习,正式测试时使用的是整理后的经验库;连续三次成功的具体门槛来自正文,不是图上每条箭头都代表一次训练。
新增贡献。 这不就是先做几道模拟题、把错题经验记下来吗?关键多了两道约束:题目由可执行探索产生,经验必须先对应一次真实失败,再在重复尝试中得到支持;执行结果还会反过来改善后续出题。模型参数和验收流程保持固定,递归体现在持久经验与出题指南进入下一轮,而非改进算法自行改写。
证据与局限。 AppWorld 的平均成功率从 44.3% 提高到 60.2%,五次全部成功的比例从 14.9% 到 32.1%;另两个环境也有收益。只从自由探索中提取经验的消融反而低于无记忆基线,支持“执行失败和重复验收很重要”,但不能仅据累加式消融精确分摊各模块贡献。AppWorld 完整方案的一次记忆构建花费约 109.7 美元,表中的测试推理成本约 3.2 美元不含这笔费用。每种方法、每个环境只构建一份记忆库,再做五次测试,误差范围不包含重新构建记忆的方差。LLM judge 与官方验收器有较高一致性,仍会误判;探索超过 90 个 session 后 AppWorld 表现下降,也说明经验并非越多越好。
评测数据集与环境。 本篇涉及AppWorld、τ²-bench、AutomationBench — Operations。具体使用口径依据v1 §4、Tables 1/3/4、Appendix E:
- AppWorld:90 个生成 session 对齐训练规模;test_normal 168 个任务作最终测试。测试 MSR、pass^5,每题五次;另在这 168 个任务各取一条轨迹、每条 judge 调用五次,检查与官方验证器的一致性,不能计为 840 道独立题。
- τ²-bench:仅 Retail,74 个生成 session,40 个测试任务;同样报告 MSR、pass^5。未采用整个三域评测,具体代码 commit 未核实。
- AutomationBench — Operations:100 个公开任务自划 30/70;30 个生成 session、70 个最终测试任务。使用同样成功与重复可靠性指标;30 道人工任务供有训练数据的基线使用,DAEDALUS 不读取它们。
完整中文摘要与阅读依据
**中文摘要。** 大语言模型 Agent 往往缺少关于所处环境的操作知识,导致更多任务失败和更长的执行轨迹。为解决这个问题,Agent 系统通常依赖人工编写的指南,或从训练任务与 oracle 验证器构建过程性记忆,而这两者都需要环境的先验知识。我们提出 DAEDALUS:在没有现成任务或 oracle 验证器的情况下,从自生成练习中构建可复用的 Agent 记忆。DAEDALUS 配对使用两个 Agent:探索者与环境交互,生成有挑战但可解的任务;执行者尝试这些任务。每次执行失败都会导出一条启发式经验,只有执行者在上下文中带着这条经验重复成功后才予以接受。这些结果也为探索者提供反馈,以调整后续任务的难度。已接受的经验随后整理为测试时使用的记忆库。在 AppWorld、τ²-bench 和 AutomationBench 上,相比无记忆基线,DAEDALUS 将平均成功率最多提高 15.9 个百分点,将五次全部成功的比例最多提高到 2.2 倍;它与使用训练任务的方法具有竞争力,推理成本低于其中多数方法。我们表明,较小探索预算就能带来收益,所学经验也能帮助其他模型家族的 Agent。消融进一步发现,执行轨迹提供了形成有效经验的关键信息,而将早期发现整理为可复用部分能够提高探索的成本效率。除了记忆构建,我们还发现 DAEDALUS 生成的任务可在按表现给模型排序时充当基准任务的替代。我们公开代码和产物,包括生成及推理轨迹。 **核对位置。** Introduction;§3 / Figures 2–3(PDF 3–4 页);§4 / Table 1(5–6 页);§5.1 / Tables 3–4(7–8 页);Conclusion(9 页);Appendix E。成本、误差与 judge 一致性来自不同实验,未混合成同一因果结论。原始来源:[论文 v1](https://arxiv.org/pdf/2610.08048v1)、[作者代码入口](https://github.com/illuin-tech/daedalus)。ScienceClaw:修好一次科学计算后,怎样证明这项本事值得保存
作者: Mingda Zhang、Wenjin Liu、Tiesunlong Shen、Zikai Xiao、Zhenghong Lin、Qing Xu、Erik Cambria、Xiaoying Tang、Haoran Luo。
机构: The Chinese University of Hong Kong, Shenzhen;Nanyang Technological University;Centre for Biomedical Data Science, Duke-NUS Medical School;Zhejiang University;Jurisprudence Research Association, China Law Society(v1 首页)。
来源与日期。 arXiv v1,首次提交2026-10-06 17:08:03 UTC,即北京时间10-07 01:08:03;
任务背景。 科学计算Agent会接到数据、目标和可用工具,交出预测、分割结果、统计估计或其他结构化输出。论文覆盖的一个实际方向是时间序列预测:程序不仅要输出数值,还要使用允许的数据,符合任务的误差指标和约束,不能偷看未来答案。不同学科的输出和验收标准各不相同。
执行中修好一个报错,只说明这次任务能继续。若要让修复成为下一次可用的能力,还要问:从干净环境重跑能否成功,其他任务是否受益,先前会做的任务会不会被新改动破坏?ScienceClaw把这些问题加入持久更新的门槛。
核心方案。 Agent先把任务组织成可执行的计算流程,执行后根据错误和数值诊断逐步修复。即使当前状态下跑通,也必须在清空临时状态后重新执行,确认成功不是依赖残留结果。系统再比较相邻的失败与成功轨迹,把真正参与修复的修改分成两部分:指导如何组织和恢复流程的技能,以及能够直接执行、带输入输出和适用条件的程序组件。
这两部分作为关联候选一起检查。可执行组件要用记录的边界输入重放;整套Agent又要在原任务上重新使用这些新版本,重现修复效果。通过之后仍不立即入库,而是到独立验证任务上比较整体表现、科学约束和资源消耗。只有满足门槛才替换持久程序,供下一轮任务检索与使用;否则保留旧版。底层模型参数、评测器和接纳程序都固定。
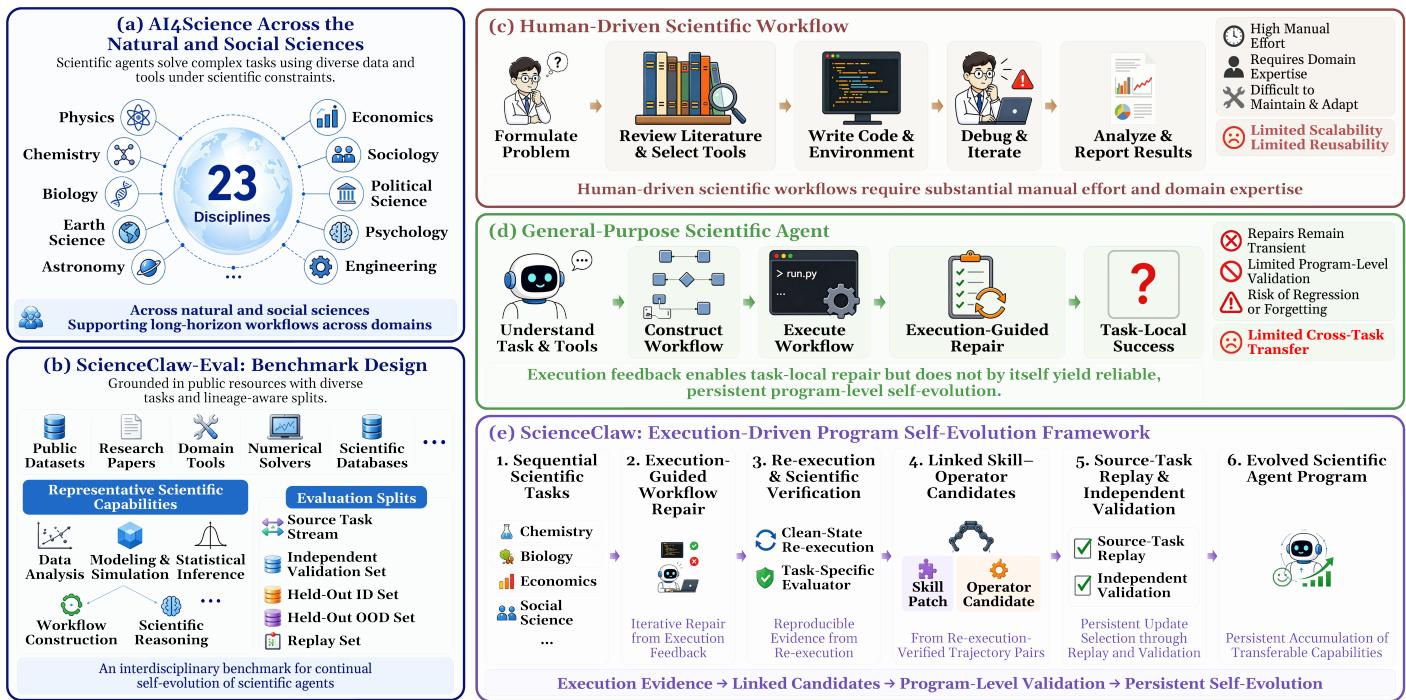
原图 Figure 2,v1 PDF第2页;原文。
读图。 主方法从右下紫色区域的第1步开始:任务进入执行与修复,再到第3步的干净状态重放。第4步才把证据变成相连的Skill与Operator候选,第5步同时检查原题复现和独立验证,通过后得到第6步的持久Agent程序。左下的基准区域解释这些检查分别用哪一类划分;上方人工流程和普通Agent流程是比较背景。后继程序在下一轮被复用来自正文协议,图上的单向流程并不单独证明每一轮都会继续涨分。
新增贡献。 这不就是把调通的代码封装成工具吗?新增的是连同“何时调用、怎样衔接”的策略一起保存,并把当前任务复现和独立任务改善都设为接纳条件。能封装、能重放、能迁移是三层证据,不能互相替代;这里是固定参数的程序自我改进,不是模型学会改写整个演化算法。
证据与局限。 七轮中,跨数据集宏成功分数从77.72到91.30,第三轮有轻微回落,并非单调上升;161个候选中70个获接纳。跨学科族迁移20个方向中18个为正,但平均增益1.58个百分点,明显小于同族14.69个百分点,表明大部分积累仍与领域有关。去掉原题重放、科学约束或独立验收都会损失收益。不过广泛学科覆盖不等于独立复现,作者明确指出需要更多重复运行与学科级区间;自动科学验收也可能漏掉领域错误。正文理想化的严格改善门与附录实际使用的margin、噪声守卫和成本限制应一起理解。
评测数据集与环境。 ScienceClaw-Eval 是论文自建复合协议,依据v1 §4/6、Appendix B.8、C、Tables4/8–12。23学科分别有4个ID和4个OOD episode,每episode16items,即每侧每学科64items、合计1472items;不是23道题。每学科2个验证episode用于选修改;源流七轮共161次episode,少量源池可能复用,回放集来自已见源题。测试冻结各轮程序并清空临时状态,报学科宏成功率、原生指标、迁移、遗忘与成本。OOD主要是同学科换来源;这些适配后的协议不能冒充原始各数据集全量标准成绩,原数据规模与许可分别追溯。