Designer-RSI:技能通过局部回放后,为什么仍会在新请求上退步
作者:Hongyang Du、Lan Yan、Christian Flores、Asim Kadav。
机构:Adobe;Brown University(v1 第 1 页)。
任务背景。 例如,用户要把花朵融入一个标志,交付物还要能继续编辑。Agent 拿到设计要求后,要检索素材、抠出主体、建立蒙版、安排文字和图层,再把文档渲染出来检查。这里的“做好”既包含文字、颜色和位置等明确要求,也包含整体构图;很难像程序单元测试一样给出完全可靠的对错判断。
同一个冻结模型可能已经会用每种工具,却仍不知道应该按什么顺序组合它们。论文尝试让过去的执行经验变成可复用的操作说明:下次遇到相似任务,就不用从头试错。
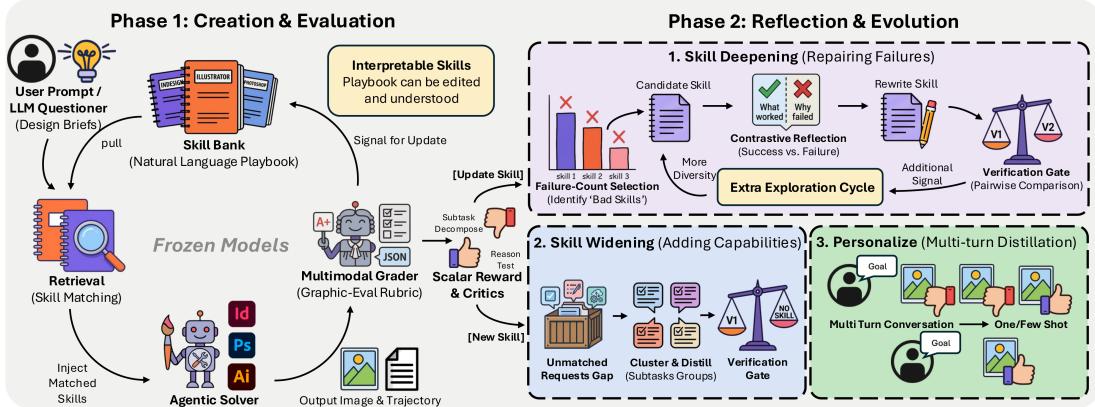
核心方案。 每次任务结束后,系统保留操作轨迹、使用过的技能,以及评审指出的未满足要求。反复出现但没有合适技能覆盖的子任务,会累积到一个缺口池;同类缺口出现至少三次,才尝试总结新技能。已有技能如果屡次伴随失败,则让反思模型对照该技能过去成功与失败的用法,先做局部修订,必要时重写。新技能增加覆盖面,修订则把“有这条经验”进一步变成“在实际请求中能可靠用好”。
但提出修改不等于发布修改。系统把候选与旧技能放在相同素材、相同上游状态下重新执行,再让评审比较输出;旧技能的成功案例也参加回放。只有未观察到退步、且至少一例改善,候选才进入技能库。被拒绝的新技能不会发布,但相应缺口记录继续保留,等待更多经验。后续请求读取的是更新后的 SKILL.md;模型参数、工具、评审和外层改进规则都不变。
实际增量。 五轮把 76 项文档提炼技能扩充到 139 项。200 条未见请求上,单独扩充或单独修订相对无技能的胜率分别为 49.4% 和 48.6%,组合后为 58.5%。这说明在该设置中,两种操作需要配合,不能只用技能库变大来代表学习有效。
这不就是……把失败经验写成操作手册吗? 是,但新增机制在于区分“缺少哪项操作”与“已有操作哪里不可靠”,并用保持成功案例的配对回放控制发布。手册会被下一轮继续使用和修订,因而存在持久改进闭环;负责写手册和验收的程序仍固定。
 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从图左侧的设计请求开始:先取出相关技能,再沿工具调用链改变文档,最后把渲染图交给评审。右侧才是任务结束后的更新过程:历史记录汇入技能统计,分成修订旧技能和提炼新技能两条路径,通过回放验收后返回技能库。返回箭头表示后续请求会继承修改,不表示当前任务每走一步就更新模型;具体回放门的条件来自正文与附录。右下绿色个性化分支只在附录讨论,不属于主实验的公共技能演化。
证据与局限。 Sonnet-4 在 GenEval 2 的执行成功率由 72.7% 升至 99.3%,成功输出上的质量分提高 11.99 点;这两个指标的分母不同。更值得留意的是:第四轮在完整性 ≥0.3 的保留请求比例上低于无技能基线(90% 对 94%),第五轮才恢复。局部回放没有覆盖新技能所有可能被检索到的场景,所以无法保证总体单调增长。内部演化与进度报告还复用了同一个冻结评审,缺少独立人工真值;推理时开销的比较也不能替代整个技能演化过程的总成本。
评测数据集与环境。 内部用户请求与 Graphic-Eval 区分 1,406 条演化请求、1,869 条轨迹、局部回放门,以及 200 条保留请求。外部评测均为 v1 所用子集:GenEval 2、DPG-Bench、OneIG-Bench 中 GenEval 2、DPG 各 300 条,OneIG 中英文各 300 条,分别用 Soft-TIFA 几何均值、算术均值和 VQAScore;质量仅计成功输出。OpenCOLE released evaluation set、GraphicBench、CreatiDesign benchmark、BannerRequest400 各抽 300 条,GPT-5.4 双顺序盲评带技能/无技能胜率。三种冻结骨干、900 秒请求上限;具体数据 revision 与抽样 ID 未披露。依据 v1 §4–5、Tables 1–3、Appendix D/F/H。
[!abstract]- Abstract 完整中文翻译 专业平面设计是一项长程 Agent 任务:结构化、可编辑的作品需要经过许多相互依赖的操作才能形成,结果却没有可靠的程序化判定器。我们提出一种持续适应框架:冻结的前沿模型通过 230 余种工具操作专业设计软件,同时由自然语言技能构成的外部程序性记忆,从经验中不断积累和修订可复用设计流程。记忆通过获取反复出现而尚未覆盖的子任务流程来扩展,通过对照既有流程自身成功和失败的执行来深化;配对回放门只允许能够修复失败、且不损害已观察成功案例的修改进入系统。五轮实验覆盖 1,406 条设计要求和 1,869 条自动评分轨迹,无需更新权重或人工标签,技能库从 76 项文档提炼技能增加到 139 项。在 Claude-Sonnet-4 上,GenEval 2 执行成功率从 72.7% 升至 99.3%,生成质量提高 11.99 点;在四个专门设计基准上,相对无技能 Agent,Claude-Sonnet-4 与 Claude-Opus-4.6 的胜率分别为 61.8% 和 67.6%。我们进一步表明两种机制配合时才有效:在用户流量基准的 200 条保留请求上,仅扩展或仅深化的胜率分别为 49.4% 和 48.6%,组合后达到 58.5%(p=0.025)。程序性记忆为噪声大、难以验证的反馈条件下实现 Agent 持续适应提供了一条可行路径。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.22086 v1;首次提交 2026-09-18 17:59:56 UTC,即北京时间 2026-09-19 01:59:56。PDF 标题为 Evolving Procedural Memory from User Traffic for Agentic Graphic Design,arXiv 元数据增加 Designer-RSI 前缀;按同一 ID 去重。§3、Figure 1(第 2 页)、§4–6、Tables 1–3、Appendix D–F。 原论文 v1。
GraphSkillEvo:把操作手册变成可交叉组合的流程图
作者:Rui Sun、Zhi Zheng、Zhenkun Wang、Zhichao Lu。
机构:City University of Hong Kong;National University of Singapore;Southern University of Science and Technology(v1 第 1 页)。
任务背景。 例如,Agent 被要求把房间里的杯子清洗后放到桌上。它拿到文字目标与环境观察,逐步选择环境允许的动作,直到目标完成或达到步数限制。简单的注意事项可能提醒它“先找物体”“检查结果”,却没有交代何时应该转去找水槽,以及清洗后如何回到放置流程。
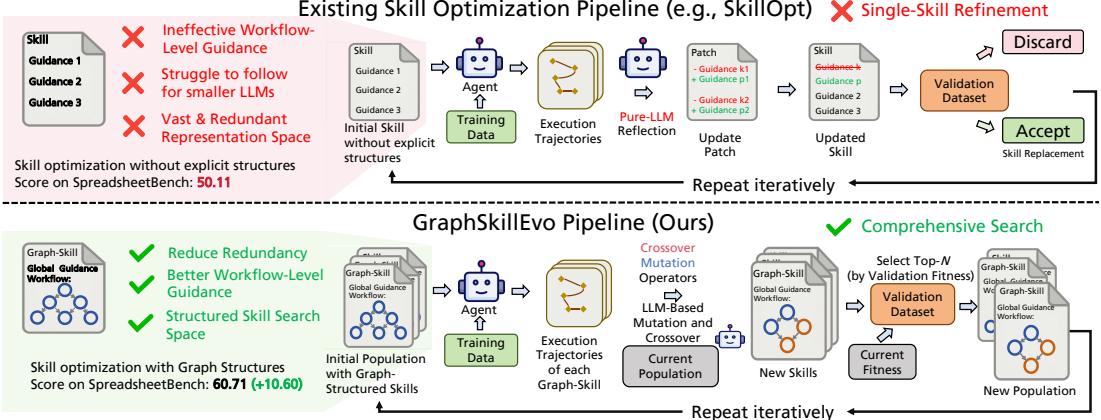
核心方案。 先把操作说明拆成两层:一层是各类任务通用的原则,另一层是具体步骤以及适用条件下的执行路径。例如,“找到物体”可以被多个流程复用,“清洗后放置”和“直接放置”则走不同路径。模型仍以自然语言理解和执行这些说明,图结构提供显式顺序,不是一个强制执行的程序状态机。
优化时同时保留四份候选技能,让它们在同一批训练任务上执行。失败轨迹用于修改单个候选的通用原则或步骤图;另一类操作把两份候选中有用的原则或子图组合起来。新候选先检查结构是否合法,再在独立验证集上评分,从新旧候选中保留表现最好的四份,继续下一代。五代结束后输出验证表现最好的技能,测试时直接使用;基础模型和选择规则不更新。
实际增量。 与逐轮修改一份自由文本技能相比,它既限制了修改的对象,也保留多条搜索路线。五项任务上,GPT-5.4-nano 相对 SkillOpt 的平均成功率从 56.89% 到 60.90%,提高 4.01 个百分点;流程性更强的电子表格任务增益较大。
这不就是……用遗传算法改 prompt 吗? 搜索外壳确实是进化算法。值得保留的部分是:交叉和变异分别作用于全局原则与共享步骤图,让可继承内容对应实际工作流程,而非只是不同措辞。外层算子轮转和验证规则固定,不能据此说搜索器已经学会如何自我改进。
 原论文 v1,Figure 1,PDF 第 1 页。
读图。 重点沿下半部分从左向右看:多份技能进入 Agent,在训练任务上留下各自轨迹;中间的变异或交叉操作生成新技能;右侧用验证集把新旧候选一起排序,选出的新种群沿底部箭头返回下一轮。上半部分是只保留单一技能的比较流程。最终测试集没有画进循环,它不应参与右侧候选选择。
证据与局限。 主表按三次优化运行取平均;另做的五次运行检验中,电子表格和 ALFWorld 的优势较明确,SearchQA 和 DocVQA 的 p 值处于 0.05–0.10,不能把每项都说成显著领先。总优化 token 少于 SkillOpt,但 ALFWorld 单项消耗反而更高;两种方法也并非逐项严格等预算。nano 在 LiveMath 上落后 0.80 个百分点,显式流程不必然帮助所有推理题。
评测数据集与环境。 以下均为 v1 的独立训练/验证/测试划分(seed=42),训练只采失败轨迹,验证选技能,测试只报最终结果:SearchQA 400 / 200 / 1,400,答案精确匹配;SpreadsheetBench 80 / 40 / 280,所有指定位置、所有测试工作簿均匹配才算成功;DocVQA 107 / 53 / 374,本篇答案精确匹配,不自动视为原基准默认 ANLS;LiveMathematicianBench 35 / 18 / 124,选择题精确匹配;ALFWorld 39 / 18 / 134,50 步内环境成功率;主实验 GPT-5.4 / nano;Codex harness 只测试前四项,未运行 ALFWorld 适配器。每代训练批次 15 题不等于全部训练集;四候选五代、每候选最多五条失败反馈。
[!abstract]- Abstract 完整中文翻译 技能通过提供面向任务的操作指导,可以提升大语言模型 Agent 的表现;技能优化则通过迭代修订进一步提高效果。然而,现有方法通常把技能表示为无结构自然语言指令,带来两项困难:无结构技能往往缺少明确的工作流指导,并含有大量冗余,难以让模型执行;不受约束的自然语言技能搜索空间巨大,也使优化低效。为此,我们提出以图结构自然语言材料表示技能。每个节点代表一个执行步骤及其操作指导,有向边表示步骤间依赖情境的转换。相比无结构技能,这种表示能提供清楚的工作流指导,也有助于优化。在此基础上,我们提出 GraphSkillEvo:针对图结构技能、包含变异和交叉算子的种群进化优化框架。它保留多个技能候选,并组合有效组件,因此比完全依赖模型的迭代自我修订,更充分地探索结构化技能空间。五个 Agent 基准上的实验表明,GraphSkillEvo 持续优于较强的技能优化基线 SkillOpt,在 GPT-5.4-nano 和 GPT-5.4 上分别把平均准确率提高 4.01 和 1.76 个百分点。代码已公开:https://github.com/ruisun7/GraphSkillEvo。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21749 v1;首次提交 2026-09-18 13:24:33 UTC,即北京时间 2026-09-18 21:24:33。§3–4、Figures 1–2、Tables 1–3、Appendix B.1–B.4、C.1、D.1。 原论文 v1。
ArenaFlow:一次比较,怎样同时训练策略和筛选可复用技能
作者:Qiang Zhang、Ruixue Ding、Fanrui Zhang、Xi Chen、Boli Chen、Shihang Wang、Yinfeng Huang、Yi Zheng、Pengjun Xie、Kaipeng Zhang、Jiawei Liu、Zheng-Jun Zha。
机构:Alibaba Token Hub, Alibaba Group;Amap, Alibaba Group(按首页署名单位汇总;未给末两位作者推断额外机构)(v1 第 1 页)。
任务背景。 例如,Agent 要为一位用户安排预算受限的三日行程。它可以搜索景点、交通和住宿,逐步组合出满足要求的计划。合理方案不止一个,最终打一个绝对分很容易受评审偏好影响;即使知道两份方案哪份更好,也还不知道值得学习的是哪个步骤。
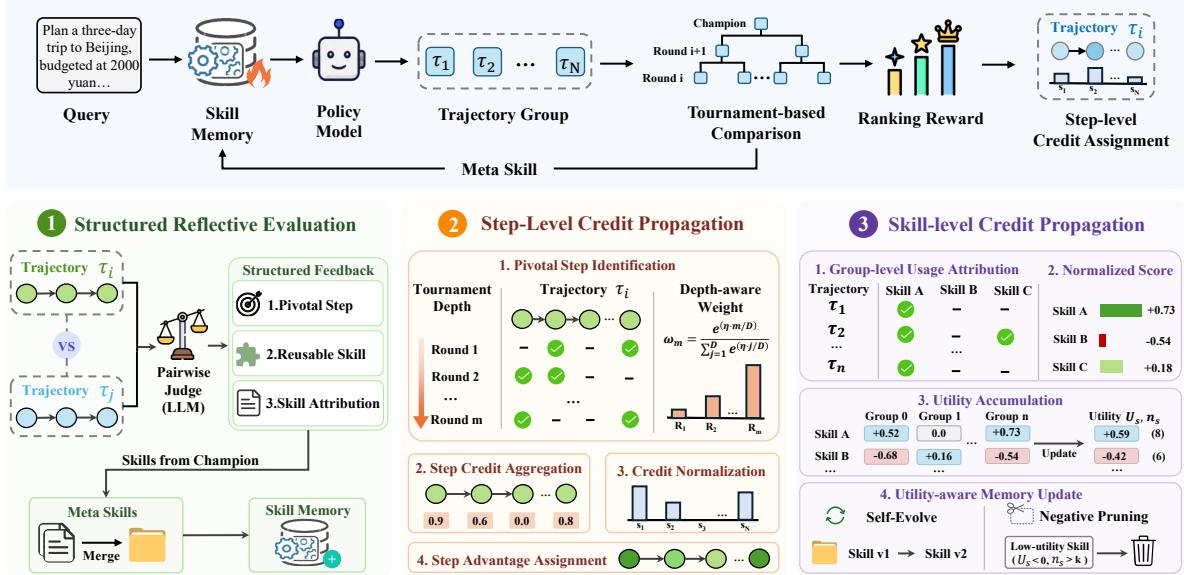
核心方案。 同一请求先检索历史技能,再由当前策略生成一组执行轨迹。系统像淘汰赛一样比较候选,但评审不只给出胜负,还指出赢家的关键步骤、可以提炼的操作经验,以及哪些检索技能实际参与了这些步骤。排名产生整条轨迹的相对优势;在正优势轨迹中,被后续轮次反复认定为关键的步骤会得到额外强化。负优势不会因为局部标签而翻成正优势。
另一条路径处理长期经验。冠军比较中提炼出的经验合并成新技能,或替换语义相近的旧版本;旧技能是否保留,则依据它在多组比较中的实际使用归因积累相对效用,观察足够多后仍为负的技能退出活跃库。下一批请求先按语义召回,再结合效用挑选技能;更新后的模型参数和技能库共同影响新的探索。比赛规则、评审模型、效用公式和更新算法本身固定。
实际增量。 相比只用比赛名次训练,评审理由还决定“重点强化哪里”和“下次带上什么经验”。Open-Travel 均分从 ArenaRL 的 35.9 提高到 55.4;去掉步骤归因降到 48.6,去掉技能效用更新降到 50.7,去掉整个技能库降到 41.2。
这不就是……先让评审写反思,再放进记忆吗? 多了一条参数更新路径,也多了对历史技能的使用记录与淘汰机制。仅被检索出来不算有用,必须被评审认定用于获胜关键步骤;不过这仍是可出错的归因标签,不是严格的因果识别。
 原论文 v1,Figure 2,PDF 第 4 页。
读图。 从顶端左侧的行程请求进入技能库和策略模型,沿多条轨迹走到比赛和排名。接着看下方绿色区域:一场比较同时产生关键步骤、可复用经验和技能归因。橙色区域把这些判断换成各步骤的优势,供模型训练;紫色区域累计技能效用,更新或剔除技能,再沿顶端回线影响后续请求。一次任务的推理、训练后的权重更新、跨请求的技能继承是三个时间层次。
证据与局限。 外部 DeepResearch Bench 分数 43.2,高于 ArenaRL 的 37.6,支持有限迁移。200 次人工复核中,关键步骤和技能归因 F1 为 79.5、76.1,说明有参考价值但仍有误差。Open-DeepResearch 质量只在有效输出上评分;训练步数相同不等于总成本相同,论文报告每步 token 从 ArenaRL 的 1.52M 增至 1.97M。检索过多技能也会退步,不能把记忆库增长理解为收益必然增加。
评测数据集与环境。 Open-Travel 与 Open-DeepResearch 用于训练和同域评测,v1 未披露独立题目总数及分割,已保留缺口;双 judge、排除平局的参考轨迹胜率与有效生成率分别记录。DeepResearch Bench 为 100 题、22 领域的迁移评测,用 Gemini-2.5-Pro / RACE。200 次人工反馈核验 检查归因 F1,不能当作任务测试。依据 §4、Tables 1–6、Appendix A.1。
[!abstract]- Abstract 完整中文翻译 强化学习已经显著提升大语言模型 Agent 在可验证领域的能力,但在解法多样、难以获得可靠标量奖励的开放式任务中,应用仍然困难。近期成对评测方法用相对偏好替代逐项绝对评分,缓解了奖励区分能力塌缩,却仍把丰富的比较反馈压缩成一个轨迹级奖励,使关键中间步骤难以辨认,也无法把成功行为沉淀为可复用技能。我们提出 ArenaFlow,一种面向开放式 Agent 强化学习的分层信用传播框架。ArenaFlow 通过基于比赛的相对排序产生轨迹级奖励,并为每次比较加入结构化反思评测,获得三类监督:关键成功步骤、可复用策略技能、检索技能的使用归因。在步骤层面,它依据比赛存活深度,把轨迹优势传给高置信度关键步骤,更有针对性地优化局部推理。在技能层面,它从组级使用归因估计技能效用,通过效用感知的更新、剪枝和检索维护全局技能记忆;高效用技能继续作为未来探索的策略先验。广泛实验验证了 ArenaFlow 在开放式 Agent 任务上的效果。代码:https://github.com/Alibaba-NLP/qqr。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21378 v1;首次提交 2026-09-18 06:44:44 UTC,即北京时间 2026-09-18 14:44:44。§3、Figure 2(第 4 页)、§4、Tables 1–6、Appendix A.1。 原论文 v1。
MACE:记住什么,要和怎样把记忆交给 Agent 一起学习
作者:Kairui Yang、Minghao An、Xunkai Li、Ziheng Yi、Zekai Chen、Guangyuan He、Rong-Hua Li。
机构:原文未署机构(v1 第 1 页)。
任务背景。 例如,一组 Agent 要回答财报里“利润为什么变化”的问题:有的定位数字,有的计算,有的检查结论。历史记录里一句“先核对单位”不一定够用;下一个 Agent 还需要知道核对什么、适用什么条件、核对后的值要交给谁。即使这些内容都找到了,写成长说明和写成操作检查表,也可能产生不同效果。
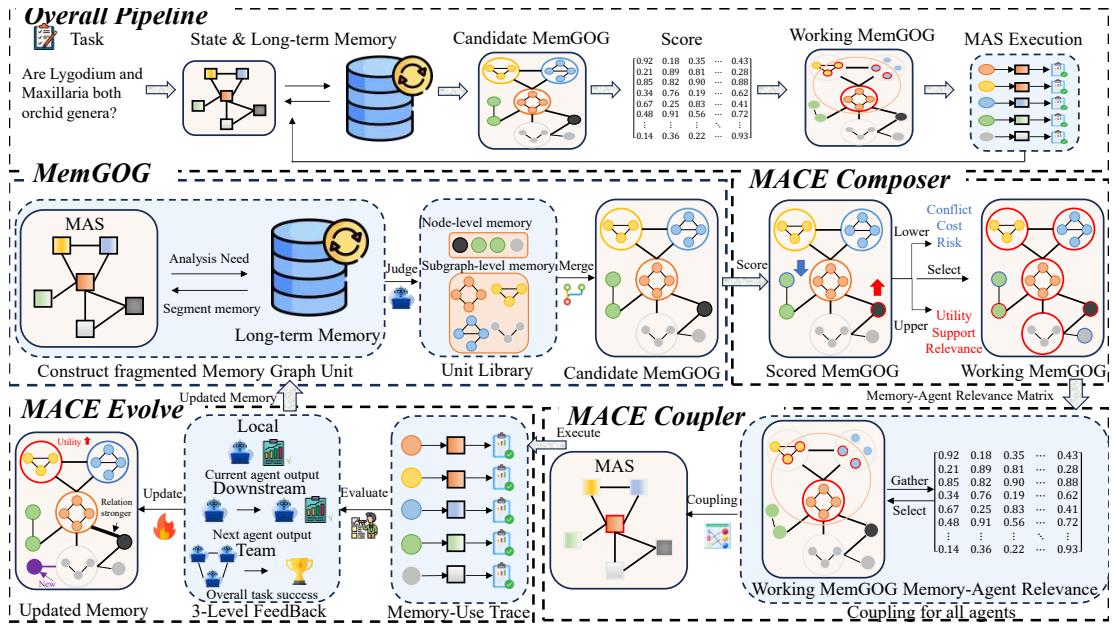
核心方案。 系统先把协作轨迹整理成有功能边界的记忆单元,把一个操作所需的条件、动作和交付结果放在一起。单元之间再记录支持、冲突和修复关系。当某个 Agent 进入一个步骤时,先描述当前角色、阶段和信息需求,挑选相关且有支持关系的单元,同时排除冲突或风险过高的建议,并控制注入预算。
接下来,系统不把相同文本原样发给每个角色,而是为当前操作组织成指南、检查表或约束等适合的形式。执行结束后,记录“用了哪些单元、以什么形式提供、当前和后续 Agent 做出了什么、任务结果如何”。这些配对记录用于更新使用过的单元效用、支持/冲突关系,以及下次的呈现选择。所谓共同演化主要发生在外部记忆和使用记录中,不是多 Agent 基础模型一起做梯度训练。
实际增量。 受控诊断固定底层内容后发现,某组记忆在指南形式下更好,换成检查表后优势可能反转。按“组合+格式”整体累计反馈,比独立给两者打分更有效。这个结果提醒我们:好记忆的定义离不开它被怎样使用。
这不就是……图记忆加 prompt 模板选择吗? 两种组件都有,但关键是保留它们配对后的反馈,不把一次收益分别归给某条记忆或某个模板。主方法的效用仍是对执行回报的平滑累计,不是已经解决协作贡献的因果归因。
 原论文 v1,Figure 2,PDF 第 4 页。
读图。 从顶部任务进入长期记忆,先在中间构造并评分候选单元,再筛成右侧的工作图。向下看右侧,相关性矩阵把不同单元分给不同角色,并转成其实际接收的提示。左下部分收集当前输出、后续输出和团队结果,把记录送回记忆。图中写着 Agent–Memory Coupler 的位置负责提供上下文,不代表训练了一个新的基础模型。
证据与局限。 八项主表无权平均 81.11%,对比 SAGE 的 78.97%,是 2.14 个百分点;关闭反馈更新后为 79.70%。不过 LiveCodeBench 单项的若干消融反而高于完整方法,收益不均匀。部分 G-MAS 成绩来自外部附件,MMLU 甚至不是相同子集;服务骨干以接口角色描述,完整可复现配置仍不足。不能把整张表看成十个基线都经过同样严格的本地复跑,也不能用平均分证明长期多轮递归增益。
评测数据集与环境。 MMLU validation 原序前 153/1,531 条,准确率;MMLU-Pro test 随机无放回 500 条,Python seed=42,准确率;GSM8K 1,319 条,解析准确率;HumanEval 164 题,执行 pass@1;LiveCodeBench v6 175 题,执行 pass@1;AQuA-RAT 254 题准确率;TabFact 500 题准确率;TAT-QA 1,663 题本地 exact match。合计 4,728 条主评测查询,八项平均不按题数加权。TAT-QA/TabFact 的组织与呈现诊断另有源文档隔离的历史、开发、校准和测试集合,未披露各自数量;不能与主表规模合并。依据 §4/6.1、Appendix A/B、Table 4。
[!abstract]- Abstract 完整中文翻译 基于大语言模型的多 Agent 系统会生成协作轨迹,记录 Agent 如何规划任务、验证中间结果和修复失败。要复用这些流程,就需要保留动作的前提条件,以及后续 Agent 所需的输出。我们的经验研究表明,把这些依赖组织成有功能边界的记忆单元,能更好地保留依赖;连接单元则提高了对任务共同所需单元及关系的检索覆盖。即使每组内容在不同形式之间保持不变,最优单元组合也会随指南或检查表的呈现形式改变。根据每个“组合与形式”配对的结果更新选择,优于分别对组合和形式评分。这些发现促成 MACE:一个利用执行反馈,同时调整记忆组织与 Agent 记忆使用方式的共同演化框架。其 MemGoG 把包含相关条件、动作和输出的功能单元表示为子图,并通过支持、冲突和修复关系连接。MACE Loop 在记忆预算内选择相关单元和关系,为每个 Agent 当前操作提供指南或检查表;它记录单元、呈现形式、Agent 输出和任务结果,以更新检索所用的效用与关系,并指导后续呈现选择。在八项基准上,MACE 优于十个基线,平均分为 81.11%,最强基线 SAGE 为 78.97%。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21533 v1;首次提交 2026-09-18 09:25:06 UTC,即北京时间 2026-09-18 17:25:06。§4–6、Figure 2(第 4 页)、Tables 1–4、Appendix A/B/D;首页未列单位,不按作者姓名补推。 原论文 v1。
CoVer:让自产测试学会区分程序,而不是学会放水
作者:Ana Nunez、Peyman Najafirad。
机构:Secure AI and Autonomy Lab, University of Texas at San Antonio(v1 第 1 页)。
任务背景。 例如,模型要写一个找出列表中第二大不同元素的函数。训练时,同一个模型既生成程序,也生成输入和预期输出组成的测试。如果只奖励“好程序都通过了测试”,写测试的一方很容易选择过于简单、几乎谁都能通过的例子;看似配合得很好,实际没学会发现错误。
核心方案。 对每道训练题,共享模型以两个角色生成 16 份程序和 32 个测试。先用固定真值测试检查程序,得到每份程序通过了多少比例的测试,而不是只分全对和全错。再让这些程序执行自产测试,观察每个测试让哪些程序通过、哪些失败。一个有价值的测试应该与程序真实质量有关,而且方向正确:较好的程序更容易通过,较差的更容易失败。
因此,测试奖励由这种区分信息决定,并用正协方差条件挡住“专门接受坏程序”的反向区分。系统还去掉无效、输入重复以及在当前程序组上表现完全相同的测试,保留更不重复的一组。代码角色按固定真值的通过比例更新;测试角色按区分信息更新,两者的梯度进入同一份模型参数。下一轮由更新后的模型继续生成程序和测试,最终可以直接写代码,也可以用于候选程序重排。
实际增量。 关键不是自产测试数量更多,而是奖励它们提供与真值同向、彼此不冗余的区分信号。7B 模型的五项平均 pass@1 为 35.94%,高于仅训练代码角色的 33.51%;把测试奖励换成通过率判据,降至 33.91%。
这不就是……让模型自己出测试,再拿测试训练自己吗? 有一个决定性区别:代码奖励仍直接来自真值测试,自产测试主要通过验证角色训练共享参数。没有移除外部正确性锚点,也没有证明模型可以独立生成下一轮的全部可信验收标准。
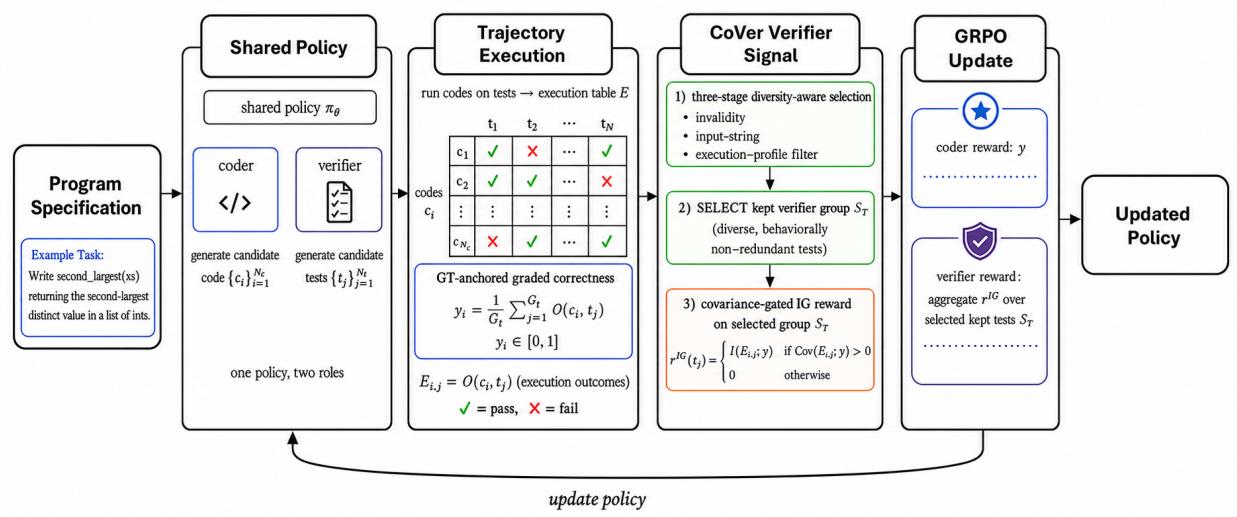 原论文 v1,Figure 2,PDF 第 3 页。
读图。 从左侧题目进入同一策略的两个角色,再看中间执行表:行是程序、列是自产测试;下方的真值分数是另一路固定测试得到的。右侧先筛选列,再计算测试的信息奖励。两个奖励在 GRPO 更新框汇合,底部箭头把新参数送回下一轮。不要把“自产测试列”与下方真值测试混成同一个来源。
证据与局限。 14B 相对原始 Instruct 的宏平均提高约 7.1 个百分点;这些主评测是单次生成,CodeT 的 8 候选结果另算。多样性消融实际双方都执行 16×32 个程序测试对,再决定哪些列参与奖励,不能说裁成 16 列就把执行量减半。仅代码训练约 46 GPU 小时,完整方法约 72,最终分更高也付出了额外训练成本。信息量估计只基于当前有限候选程序,对新程序的测试质量仍需验证。
评测数据集与环境。 v1 §4.1、Appendix B/Table 7:CodeContests 难度≤2 的 4,500 题训练、239 题测试;LiveBench Coding 128 题、MBPP 221 题、LiveCodeBench v2 511 题、Open-R1 Codeforces 467 题均只评测,合计 1,566 题(本卡按 Table 7 五项逐一相加;原表 Total 写 1,527,存在不一致)。greedy pass@1,四随机种子不扩充独立题数;stdio 转换题目映射与快照仍待核。
[!abstract]- Abstract 完整中文翻译 把单个语言模型同时训练为代码作者和测试作者的自博弈方法,有望让代码生成强化学习超越固定测试集,但它们面临两种耦合问题:宽松性塌缩,即简单、没有区分力的测试最大化通过率奖励;以及集中偏差,即独立同分布采样的测试集中在高概率输入上,放大估计方差。我们提出 CoVer(共同训练的代码作者与验证器),一个同时处理这两类失败的单策略 GRPO 框架。首先,信息增益奖励计算每个自产测试在多个候选程序上的通过/失败向量,与取值为 [0,1] 的分级真值锚定正确性信号之间的互信息;再以协方差符号作门控,只奖励正向区分测试。其次,三阶段多样性选择通过无效性、输入字符串及执行表现过滤,把候选池裁成行为不冗余的测试集,在固定执行预算下提高信息增益估计的有效样本量。在 LiveBench、MBPP、LiveCodeBench、CodeContests、CodeForces 五个基准上,CoVer 相对 Qwen2.5-Instruct 骨干把 7B、14B 的单次 pass@1 分别提高约 5.8 和 7.1 个百分点,在两种规模上均取得所比较方法中最高的宏平均。作为 CodeT 排序流程的直接替换骨干,CoVer-7B 再提高 3.5 个百分点,体现共同训练对生成与选择两方面的帮助。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21208 v1;首次提交 2026-09-18 01:46:28 UTC,即北京时间 2026-09-18 09:46:28。§3–4、Figure 2(第 3 页)、Tables 2–8、Appendix B.1–B.5;Table 7 总数与分项和不一致,保留原始分项。 原论文 v1。
DENSE:没有最终对错标签,怎样从旧轨迹整理出可用反馈
作者:Siyuan Liu、Fan Yu、Dongyu Ru、Yizhu Liu、Yifan Yang、Xuezhi Cao、Xunliang Cai、Yixin Cao。
机构:Fudan University;Meituan Longcat Team(v1 第 1 页)。
任务背景。 论文用一个教学例子说明困难:Agent 读销售 CSV,要生成一个汇总 JSON 和一张图。它先发现缺少某个库,后来用标准库成功写出了 JSON,但绘图一直失败。如果只总结“尝试了几个库,最后有成功输出”,下一次可能误以为整个任务已完成;如果把所有错误原样塞回去,又会重复提醒已经修好的问题。
核心方案。 系统先把动作与观察按实际子目标分组,再一层层汇成嵌套任务树。在同一子目标内,多次失败尝试可以压成一条简短经验,但必须保留走得通的操作、失败原因和支持它们的观察。这样,“标准库能完成 JSON”与“仍然没有生成图”不会被揉成一句含糊的总评。
随后父节点重新检查孩子节点留下的问题:只有找到后续恢复的具体证据,才能关闭旧问题;某个子任务恢复,不代表它的父任务已经完成。交给下次执行的反馈因此有不同详略:已经完成的分支保留重建进展所需的关键动作,未解决分支展开问题和证据。下次从空环境开始,必须重新创建所需文件;保留的是做法,不是旧环境的状态。模型参数没有更新。
实际增量。 它把“已解决什么、凭什么认为解决、仍欠什么”绑定到子任务层级,并用相同原始轨迹比较不同反馈提取方法。四个接收模型的严格通过率相对初次运行提高 7.12–15.64 个百分点。
这不就是……把轨迹压缩成反思再试一次吗? 是同题再次尝试,但压缩不能丢掉证据范围,关闭问题也需要可追溯的恢复证据。这项区别对长任务很有用;论文没有展示一个技能库在未见任务上持续演化。
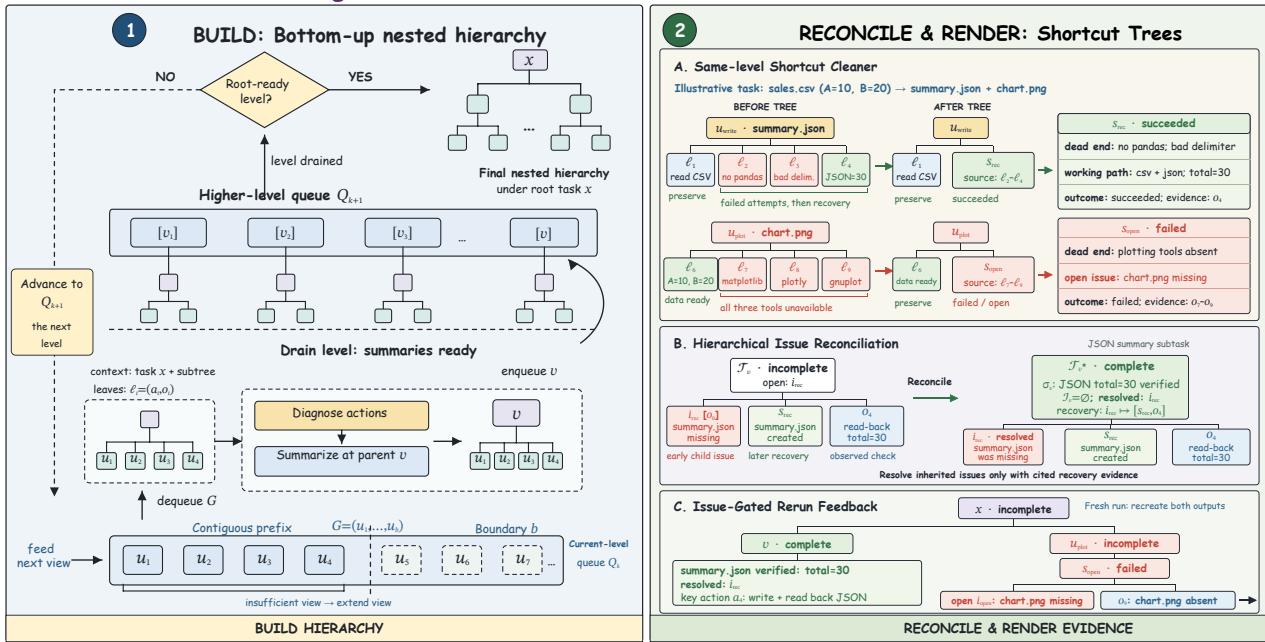 原论文 v1,Figure 2,PDF 第 3 页。
读图。 从左下的动作观察队列向上看,连续片段被概括成子任务,再进入更高层。右上把一串重复尝试压成有证据的捷径;右中用“后来写出并读回 JSON”的证据关闭早先缺失问题;右下只把完成的 JSON 分支缩短,仍展开未完成的绘图分支。图中绿色完成标记描述旧轨迹的局部结果,不是在承诺新环境已具备同样状态。
证据与局限。 GPT-5.5 完整方法为 75.66%,去掉捷径与问题协调为 72.28%,去掉层级为 72.66%。对照受控,但全部来自同一个终端基准;不同反馈法可见的动作后果也不完全相同。论文的 19.0–43.6% token 减少是重跑接收模型的观测用量,不能直接等同于包括初次运行和反馈分析的总成本下降。
评测数据集与环境。 Terminal-Bench 2.1:MiniMax、GPT、Kimi 各 89 题,DeepSeek 文本端点用 81 题,每题三次重复;按题平均,隐藏 verifier reward 必须恰为 1。REFIT 固定初始轨迹并重置环境/上下文;仅反馈跨次传递,Gemini 3 Flash Preview 统一生成非特权反馈。三次重复不能算作三倍独立任务。依据 §3–4、Tables 1–4、Appendix A/B。
[!abstract]- Abstract 完整中文翻译 在线 Agent 部署会积累大量执行轨迹,而面向任务的验证和专家标注难以低成本扩展。我们研究如何在没有事后结果标签时,利用轨迹中局部进展、恢复和未完成要求的证据,把这些轨迹提炼成可复用反馈。我们提出 DENSE(从嵌套子任务执行中提炼证据),将这些证据组织成有依据的嵌套捷径树。DENSE 压缩冗余尝试,使用恢复证据协调不同层级的问题,并概括完成分支、展开未解决分支,把可复用进展与剩余要求连接起来。我们提出 REFIT,一种使用共同初始轨迹、在事后结果不可见条件下比较反馈的配对协议;重置环境和模型上下文后,对同一任务重新尝试。在 Terminal-Bench 2.1 上,DENSE 在四个接收模型中均取得所测试非特权反馈方法中最高的严格通过率。相对初次执行,通过率提高 7.12–15.64 个百分点,重跑时观察到的接收模型 token 减少 19.0–43.6%。GPT-5.5 消融支持把嵌套子任务分析与捷径构造、问题协调结合。这些结果表明,通过有证据依据的轨迹复用,有望减少 Agent 自我修订对外部监督的依赖。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21423 v1;首次提交 2026-09-18 07:36:21 UTC,即北京时间 2026-09-18 15:36:21。§2–4、Figure 2(第 3 页)、REFIT Figure 3、Tables 2–4、Appendix A/B。 原论文 v1。
Better Turns:每一步答得更像标准答案,为什么流程仍然完不成
作者:Md Tahmid Rahman Laskar、Xue-Yong Fu、Gundeep Singh、Karol Chang、Kevin Sanders、Shi Zong、Tania Habib、Julien Bouvier Tremblay、Shayna Gardiner、Harsh Saini、Matthias Lee、Elena Khasanova、Quinten McNamara、Shashi Bhushan TN。
机构:Dialpad Inc.(v1 第 1 页)。
任务背景。 例如,客服 Agent 要先获取用户的信息,再查询记录并完成一个业务请求。它拿到政策和工具定义,下一步怎么做取决于之前收集到了什么、工具返回了什么。若评测每一步时都重新给它一段正确历史,它就永远不会看到自己上一轮造成的错误状态。
核心方案。 论文对四个模型做同样的监督微调,再用同一批保留对话从几个层次检查效果。先给每个待评决策正确历史,分别看回复与参考文字是否相似、评审是否认为该动作合理,以及工具名和参数是否严格匹配。这样可以识别“文字更像了”与“工具真的调对了”的差别。
然后撤掉每轮自动恢复正确历史的帮助,让模型沿着自己的回复继续执行。工具调用错误会返回错误并允许有限重试,错误状态能影响后续决策。最后还要检查是否真正完成用户目标、遵守政策和正确使用工具结果:走到流程末尾只是一个较弱的完成标准。这是评测协议诊断,不是一套新的自我改进算法。
实际增量。 同一组 SFT 模型在正确历史条件下的综合单轮分都提高了,但需工具流程的确定性完成率最高只有 8/77,即 10.4%;更严格的整体目标与政策评审为 0/77。这两个数字对应不同成功条件,不矛盾。
这不就是……多步任务会累积错误吗? 更具体的问题是:训练收益首先落在了哪类决策上,以及当前评测有没有替模型修复历史。文本轮次占比大时,它们的进步可以抬高总分,掩盖工具执行几乎没有改善的事实。
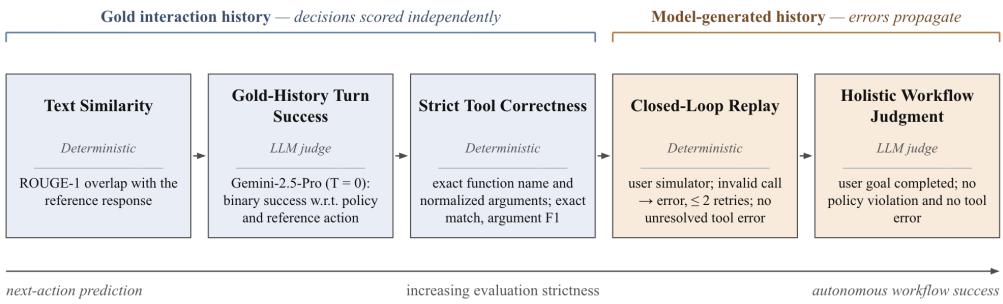 原论文 v1,Figure 1,PDF 第 3 页。
读图。 从左侧三个蓝色框读起:它们都在正确历史下,依次看文本相似、单轮合理性和严格工具匹配。跨到右侧橙色框后,模型开始使用自己生成的历史,错误能传播;最后一个框再检查整段任务与政策。横向箭头是验收层次的展开,不是把左边的预测结果逐个输入右边,也不是训练迭代。
证据与局限。 四模型平均文本轮次成功率从 33.2% 升至 58.4%,工具轮次仅从 17.8% 到 23.7%;Gemma-3-4B 的严格调用准确率甚至从 3.0% 降至 0。另一方面,闭环脚本要求参考函数和参数精确匹配,可能低估有效替代路径;确定性用户回放也不能代表所有真实对话。它支持分层验收的必要性,不支持“SFT 普遍无效”。
评测数据集与环境。 Dialpad 自建客服流程:训练/验证为 5,834/664 次决策,测试为独立保留的 84 条对话、542 次决策;工具完成与整体成功的主表分母是其中 77 条需工具对话。不是 542 个独立工作流,也不是 τ-bench。Qwen3 4B/14B、Gemma3 4B/12B,统一五轮 SFT;完整原始数据未公开,附录给脱敏模板。依据 §3–4、Figure 1、Table 1、Limitations。
[!abstract]- Abstract 完整中文翻译 Agent 模型经常逐个决策接受评测:根据正确交互历史预测下一动作,再与参考答案比较。我们研究,这种协议下的提高是否能预测自主工作流执行能力的提高。我们在多轮客服流程上比较 SFT 前后的 Qwen3 4B/14B 和 Gemma3 4B/12B 模型。结果显示,SFT 始终提高文本轮次成功率,在正确历史评测下,每个模型的整体下一轮成功率也都上升。但这些改善没有转化为自主工作流执行能力,工具相关收益还因指标和模型而异。四个 SFT 模型均未在整体工作流评测中成功;严格轨迹完成率最高仅为 10.4%。我们的结果表明,下一轮评测不是工作流成功的可靠替代,应分别报告文本质量、局部动作正确性、工具执行和端到端任务完成情况。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21187 v1;首次提交 2026-09-18 01:11:55 UTC,即北京时间 2026-09-18 09:11:55。§3–4、Figure 1(第 3 页)、Table 1、Limitations;77 条工具流程与 84 条总对话分开。 原论文 v1。
GVPO++:把奖励拟合和蒸馏放进同一个组内误差目标
作者:Kaichen Zhang、Yuzhong Hong、Junwei Bao、Hongfei Jiang、Yang Song、Dingqian Hong、Hui Xiong。
机构:原文未署机构(v1 第 1 页)。
任务背景。 对一道数学题,模型能给出多种解法,训练系统可以检查每种解法的最终答案。我们希望提高正确解法的概率,同时避免模型一下子偏离原来的分布。困难在于,训练会复用旧模型生成的回答;新旧策略差距大时,用概率比补偿这种差距可能让更新不稳定。
核心方案。 先把“模型偏爱一个回答到什么程度”写成相对参考模型的对数概率变化,并视作模型隐含给出的奖励。对同一道题的一组回答,分别减去真实奖励和隐含奖励的组内均值,再让两者的差尽量小。这样,模型要学的是各个回答相对同组其他回答好多少;对整组都相同、难以计算的归一化项会被抵消。误差决定每个回答的更新方向和力度,最终修改保存在模型参数里。
这一写法允许用旧模型、其他模型或混合来源的回答训练,而不必再乘重要性采样概率比,但采样分布仍需满足论文的覆盖条件。扩展到蒸馏时,系统让教师与学生分别给同一段回答文本打分,用组内相对差异构造目标;它比较的是整段文本的概率,因而不要求两个模型的 token 词表逐项对齐。论文还给回答加入长度相关权重,改变蒸馏目标对长短回答的偏好,而不是任由回答在训练中持续缩短。
实际增量。 这版新增了蒸馏的推导、扩展目标及实验。跨词表教师设置中,五项数学评测平均为 35.99,高于所比较策略梯度方法的 24.75;相同词表设置为 35.35,对照为 27.80。一般后训练部分的 52.02 对 GRPO 46.69 是另一组实验,不能混作蒸馏增益。
这不就是……把强化学习改成一个回归问题吗? 关键是回归对象来自带 KL 约束奖励最大化的解析关系,而且先做组内中心化。普通地回归一个任意分数,并不自动得到同样的目标或采样性质;理论中的唯一性指最优策略分布,也不是神经网络参数只有一个解。
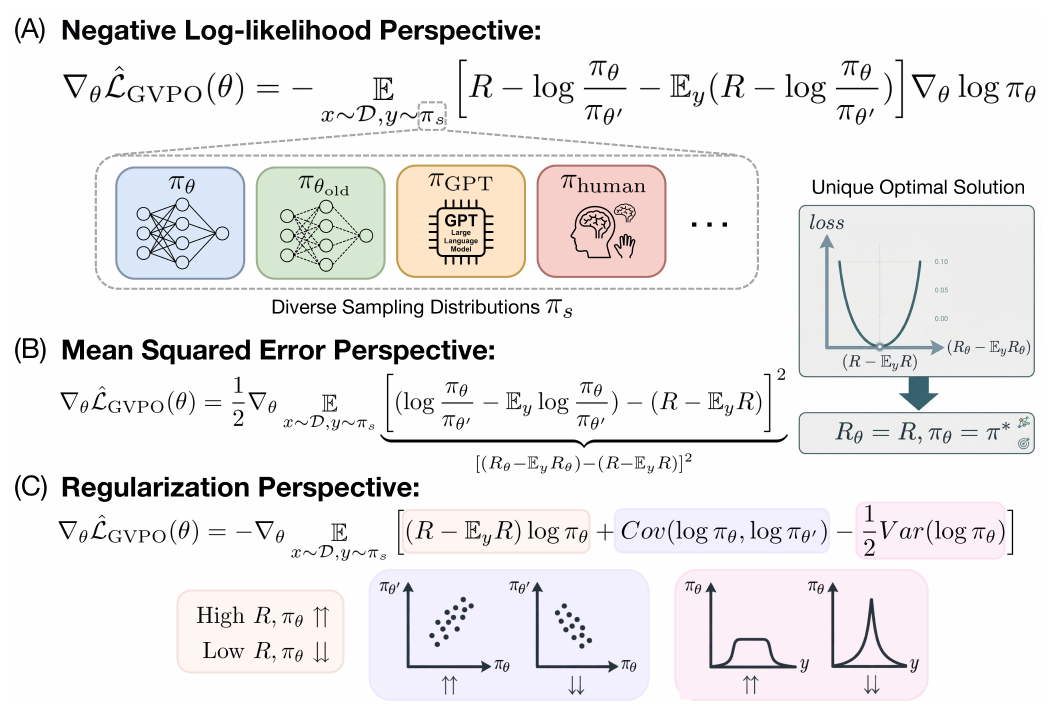 原论文 v1,Figure 1,PDF 第 2 页。
读图。 可以先看中间 B:真实奖励和隐含奖励都减去组内均值,然后比较平方误差。右侧小图表达这个理想目标的最优点。再回到上方 A,同一个更新被写成加权对数似然,因此左侧能列出不同回答来源。下方 C 又把它拆成奖励推动与约束分布变化的项。A、B、C 是同一目标的三种解释,不是先后执行的三个模块;蒸馏扩展在正文中另行推导。
证据与局限。 实验包含不同采样混合比例、正则项消融、十个随机种子的小模型检查,以及摘要和程序化推理任务。但“允许不同采样分布”有覆盖前提,不表示一小份任意离线数据就足够,也不保证 SGD 不会失败。蒸馏采用特定数学模型与长度权重,尚不能据此证明在长程 Agent 交互中同样稳定;学习率搜索未明确独立选模集。
评测数据集与环境。 Competition MATH 训练,实际使用题数未披露;AIME 2024 30 题按 avg@32,AMC、MATH-500、Minerva、OlympiadBench 按 pass@1,后四项实际子集和部分版本口径未完整披露。Reasoning Gym 为 104 类、26,000 训练/1,040 测试实例;Reddit TL;DR 另测奖励、偏好与摘要质量,人工对比 100 样本、每样本三位标注者。依据 v1 §VI–VII、Tables I/VI、Appendix D/E;重复采样和标注人数均不计作新增独立题数。
[!abstract]- Abstract 完整中文翻译 后训练在提高大语言模型的推理能力和任务专长方面发挥着重要作用。尽管组相对策略优化(GRPO)等后训练方法已有进展,依赖重要性采样所带来的训练不稳定,仍阻碍着实际应用。我们提出组方差策略优化(GVPO),把带 KL 约束的奖励最大化问题的解析解融入梯度权重设计。这一形式提供了直观解释:GVPO 的梯度对应隐含奖励与真实奖励各自中心化之后的均方误差。GVPO 有两个主要优点:第一,保证唯一的最优解,并且恰好对应带 KL 约束的奖励最大化目标;第二,无需重要性采样即可使用灵活的采样分布。在一般后训练之外,我们证明 GVPO 能自然延伸到在策略蒸馏(OPD)。此外,GVPO 能优化一大类扩展的 OPD 目标,为多样化目标设计提供有原则的基础。通过结合理论保证与实际适应性,作者将 GVPO 定位为可靠、灵活的语言模型后训练及在策略蒸馏的一种新范式。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21432 v1;首次提交 2026-09-18 07:44:54 UTC,即北京时间 2026-09-18 15:44:54。§II 明确为早期 GVPO(引用 [31])的扩展;§IV Theorem IV.2、§V、§VI–VII、Appendix D/E。首页 JOURNAL OF LATEX CLASS FILES / AUGUST 2021 是模板页眉,不能当作发表信息;Figure 1(第 2 页)来自原 PDF 直接裁取,保留完整 A/B/C。 原论文 v1。
吸引与排斥教师:怎样学到正确性,而不把教师的表达习惯一起学走
作者:Anton Baumann、Akmal Ashirmatov、Leo Schmidt-Traub、Frederike Lübeck、Jonas Hübotter、Thomas Kleine Buening、Andreas Krause。
机构:ETH Zurich;Max Planck Institute for Intelligent Systems(v1 第 1 页)。
任务背景。 让模型先自己解一道数学题,再把参考解答偷偷给同一初始模型作为“教师”看,教师就能逐 token 判断学生刚才写下的推理。这样得到的信号比最终对错更细,但教师看过完整解答后,也可能变得更简短、更自信,不再表现出学生原本需要的试探和检查。
核心方案。 学生先生成一组解答。训练系统为其中的错误回答准备两个上下文:一个放正确解法,一个放同组另一条错误解法,再让同一份冻结教师分别沿着学生已经生成的文本打分。两个教师使用相同的提示模板,因此都可能带来“看过一份解法之后更简洁、更确定”的共同倾向,但它们关于答案正确性的提示方向不同。
更新学生时,一半信号拉近正确上下文教师,另一半信号推离错误上下文教师。作者希望两边共有的表达偏好相互抵消,留下更偏向正确性的局部差别。实际实现采用 sampled-token 广义 JSD 目标;论文用反向 KL 推导展示抵消关系,但不把这一理想关系当成所有实现都精确消除了风格偏差。更新保存在学生参数里,教师不随学生刷新,也没有额外混入 GRPO 奖励项。
实际增量。 单独排斥教师,在 Qwen3-4B 的非思考模式下可以唤起潜在的长推理行为,但长度继续膨胀后会发生截断和准确率崩溃;换成没有同样思考模式的 instruct 模型,收益不再成立。结合正反两路后,三种模型设置的推理表现更好、响应长度更稳定,这比只报最终分数更能解释收益来源。
这不就是……正确的多学一点,错误的少学一点吗? 区别在于,它不直接模仿正确回答、惩罚错误回答,而是让两个有不同上下文的教师给同一条学生轨迹逐 token 打分。抵消是否有效取决于两路信号共享什么偏差;正确和错误上下文也要实际可得,不是无外部条件地产生监督。
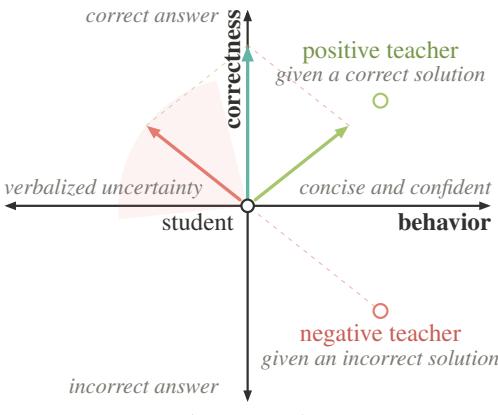 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从坐标中心的学生出发,向右上靠近绿色教师,会同时增加正确性和简洁自信倾向;远离右下的红色教师,则朝左上走,增加另一种探索性表达。两股力叠加,图中的竖直方向表示期望保留下来的正确性信号。这里的轴和箭头是机制示意,不是实测的二维表示,也不是教师随训练递归更新的流程图。
证据与局限。 三个设置分别是数学上的 non-thinking、instruct-only,以及字母异位词分组上的 thinking 模型。将 token 信号打乱或扩大聚合窗口会削弱效果,支持局部信号有作用;但模型与任务范围仍有限。训练只使用有正反上下文的错误响应,因此存在筛选条件;数学正例来自专家参考,不能把收益归因于完全自产经验。教师冻结且外部验收固定,本篇不构成改进机制自身的递归演化。
评测数据集与环境。 DeepMath-103K 选取难度至少 8 的 10,000 题训练。数学测试为 MATH-500 前 128 题、AIME 2024 / 2025 / 2026 各 30 题、AMC 2023 40 题、HMMT February 2025 30 题,共 288 题。Group Anagrams 为 2,200 训练题、400 测试题。两类测试均每题四响应、报告 mean@4,不是“四次有一次做对”的 pass@4;依据 v1 Appendix B、Tables 1–4。
[!abstract]- Abstract 完整中文翻译 在策略自蒸馏通过让模型看到特权信息,再把由此得到的教师分布蒸馏回模型,为训练提供密集的 token 级监督。但特权信息改变的不只是教师知道什么,也会改变教师如何表达,从而把与正确性相关的学习信号和无意引入的行为变化混在一起。我们在推理任务中比较吸引式自蒸馏与排斥式自蒸馏:前者让模型靠近特权教师,后者让模型远离特权教师。两种目标都可能引起显著而相反的行为变化:吸引会抑制探索性推理,促使回答更短、更自信;排斥会增加回答长度,可能无意触发模型潜在的思考模式切换,并最终变得不稳定。基于这些观察,我们研究对比式自蒸馏,把靠近正确解答条件下的教师与远离错误解答条件下的教师相结合。与此前把这些蒸馏信号和 GRPO 目标混合的研究不同,我们单独研究自蒸馏目标本身。我们发现,两位教师共有的行为变化大体抵消,留下了更直接反映正确性的 token 级信号。在非思考、纯指令以及已经采用思考模式的模型上,这种对比目标改善了推理表现,同时保持稳定的响应长度。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21561 v1;首次提交 2026-09-18 09:51:36 UTC,即北京时间 2026-09-18 17:51:36。§2–4、Figure 1(第 2 页)、Appendix A 的退化与 token 信号消融、Appendix B 数据/冻结教师/超参数和评测口径;Table 2 的 EMA rate=0。 原论文 v1。
Cal-OPD:先量出教师自己会摇摆多少,再决定学生该学多少
作者:Qiangqiang He、Jin Li、MingCai Chen。
机构:State Key Laboratory for Novel Software Technology, Nanjing University;College of Software Engineering, Southeast University;Nanjing University of Posts and Telecommunications(v1 第 1 页)。
任务背景。 学生自己写下一段数学推理后,更强的教师会逐 token 给它打分。常见蒸馏方法据此判断学生与教师还差多少。但如果只是给教师换一种提示语,它对同一段推理的概率就会改变;这部分差异未必代表学生缺少数学能力。
核心方案。 固定题目和学生已经生成的回答,先记录教师在普通上下文中的 token 概率,再用一正一反两种提示重复评分。主实验给同一解答分别附上“已被判为正确”和“已被判为错误”的评价,观察概率向上、向下能移动多少。这两句是实验者主动施加、彼此相反的探测提示,不是环境真的对同一回答给出了两种真值。
以普通评分为中心,把两次探测得到的最大上下波动扩成一个区间。如果学生的对数概率已经落在区间内,该 token 不再提供更新信号;若落在外面,只学习到最近边界的那一段差距。系统因此不强求学生追到教师某一个精确点,而是先扣除教师自己对上下文敏感的部分。校准后的信号用于更新学生参数;教师固定,下一轮重新在学生的新轨迹上测量。
实际增量。 这不是统一把学习率调小,也不是直接删除所有波动大的 token,而是按方向和距离保留区间外残差。1.7B 学生的六项平均由标准 OPD 的 50.8 提高到 53.1;4B 学生由 65.9 到 69.0。论文同时比较统一缩放、随机屏蔽和按波动阈值过滤,支持收益不只来自减小总体更新量。
这不就是……对不可信的教师信号降权吗? 直觉接近,但它把不可信部分写成围绕当前教师评分的不对称区间:有些 token 完全不更新,有些仍沿原方向更新,只缩短要追赶的距离。区间取决于干预提示与放大系数;如果放得太宽,真正有用的差异也会被删掉。
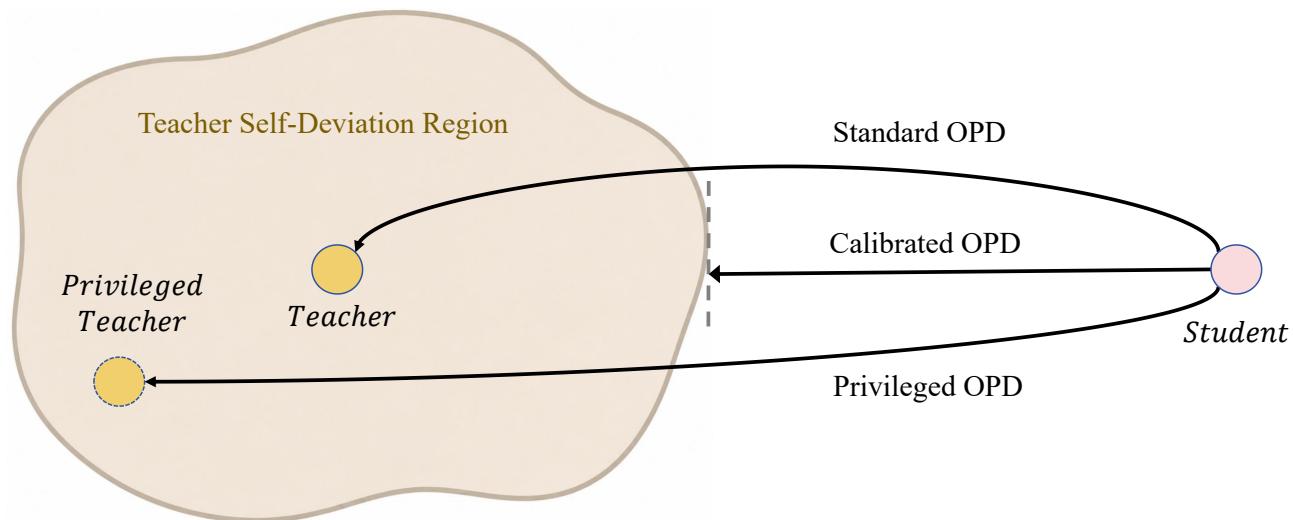 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从右侧粉色学生点出发,最上方箭头直接追向普通教师点,下方箭头追向看过额外信息的教师点;中间箭头只到浅棕区域的边缘。棕色区域表示教师在不同提示下可能波动的范围。图是概念示意,实际算法为每个已生成 token 建一个对数概率区间,并不是在模型参数空间画这样一块区域。
证据与局限。 主设置保留约 52–65% 的原始差异信号,不能读成只训练 52–65% 的 token。额外两次教师评分也有成本:小教师设置每步 14.90 分钟,低于 OPD 的 18.80,受更短 rollout 帮助;30B 教师设置则为 48.76 对 31.26 分钟。它并非普遍更省算力。实验集中在数学推理,波动与无用信息只是近似关系;教师、校准规则和任务分布均未自主演化。
评测数据集与环境。 DAPO-17K 原 17,255 题,核验参考解后 15,560 题用于训练;6,528 条、约 60M tokens 是单独的诊断轨迹。测试 AMC23、AIME24、AIME25、AIME26、HMMT26、MATH500,统一 Avg@16;论文称完整基准,但未逐项列实际题数,HMMT26 的具体月份/revision 也未明确。两组主教师为 Qwen3-4B-Thinking-2507、Qwen3-30B-A3B-Thinking-2507;依据 §4、Tables 3–4、Appendix A.1/B/C,独立选模集仍有缺口。
[!abstract]- Abstract 完整中文翻译 在策略蒸馏(OPD)通过学习更强教师与在策略学生之间的 token 级差异,改善推理模型。但这种差异并不纯粹反映教师与学生的能力差距:它也包含教师自身引起的偏移,而这些偏移被混入观察到的师生差异,并被标准 OPD 在训练中不加区分地学习。特权 OPD 会进一步加剧这一问题,因为额外特权信息引起更大的教师侧似然变化,促使学生学到更多教师自身的偏移。我们提出校准在策略蒸馏(Cal-OPD),通过正向与负向特权干预估计教师的自偏移区域,并只保留原始师生差异中超出该区域的部分作为校准信号。数学推理基准上的实验表明,尽管只保留约 52–65% 的原始师生差异作为优化信号,Cal-OPD 在不同模型规模上仍持续优于标准 OPD 及其变体。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.21619 v1;首次提交 2026-09-18 11:00:44 UTC,即北京时间 2026-09-18 19:00:44。§2 Table 1 干预模板、§3 公式 13–14、§4 Tables 3–4、Appendix A.1/B/C 的数据/成本/控制实验;Figure 1(第 2 页)为概念图。 原论文 v1。
CodeMidas:把已有功能改造成能可信判分的编程训练环境
作者:Bowen Ye、Lei Li、Shicheng Li、Zihao Yue、Linghao Zhang、Hanglong Lv、Yuanxin Liu、Wenhan Ma、Hao Tian、Rang Li、Jinhao Dong、Yikai Zhao、Xiangwei Deng、Hailin Zhang、Liang Zhao、Qi Liu、Lingpeng Kong、Tong Yang、Fuli Luo。
机构:LLM Core, Xiaomi;Peking University;University of Hong Kong;Renmin University of China(v1 第 1 页)。
任务背景。 一个代码库已经能完成某项功能,例如把结构化数据序列化成规定格式。若把核心实现拿掉,只留下接口、依赖和行为要求,就能得到一道真实项目里的编程题。Agent 需要读代码、修改文件并运行检查,最后交出满足要求的实现。困难不只是“怎么出题”,还在于测试会不会误判、答案有没有藏在编译产物或缓存里,以及题目是否真的适合学习。
核心方案。 构造 Agent 先检查代码的公开接口和可观察行为,写清功能要求,再移除对应实现并调整剩余项目,使求解者得到可开发的起点。另一侧用保留的原始代码执行输入,得到测试应期待的结果;测试约束的是需求中的行为,不应强迫新代码复刻原实现的内部写法。参考实现和最终隐藏测试不放进求解者环境,以免任务退化成找答案。
接着先在干净环境检查:初始代码应当失败,恢复参考实现应当成功。通过这一关后,系统还让 Agent 实际尝试解题,专门寻找编译文件、源码缓存等泄漏;审查者结合任务、参考代码、提交代码和验证结果,排查假阳性与假阴性。最后去掉所有尝试都成功或都失败的候选,留下更有训练区分度的任务。筛出的环境固定下来,再用隐藏执行奖励做 GRPO;学习成果保存在求解模型参数,而不是不断变化的出题规则里。
实际增量。 源代码同时提供可删去的功能、可执行的参考行为和真实项目上下文,使环境构建不再依赖现成 issue/commit。22,575 个初始候选最终留下 5,545 个任务。高质量 3,000 题在三项消融评测上优于未清洗的 8,000 题,说明更多原始环境不必然带来更好的训练。
这不就是……把函数挖空,拿原实现当标准答案吗? 挖空只解决题目入口。真正决定奖励是否可靠的是:任务描述能否充分界定行为、隐藏测试是否接受等价实现、环境有没有泄漏,以及实际求解后出现的误判能否被审查出来。这些环节缺一项,就可能把找捷径或迎合错误测试训练进策略。
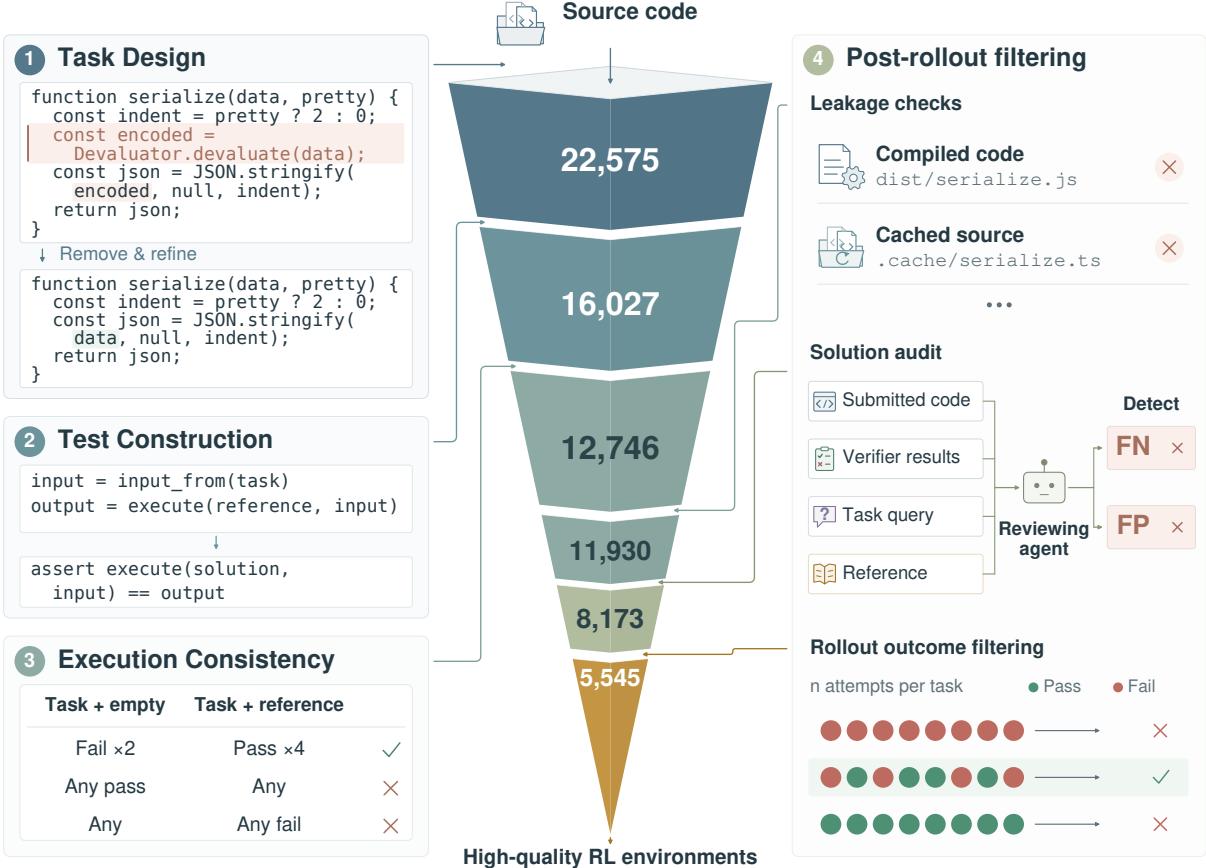 原论文 v1,Figure 1,PDF 第 4 页。
读图。 从顶端源代码向左进入任务设计,红色实现被删去;再往下看测试构造,原始程序的执行输出成为检查依据。左下用“空实现失败、参考实现通过”筛掉不一致环境。随后沿右侧向下,实际 rollout 依次暴露答案泄漏、测试误判,以及过易或全败任务。中间漏斗是候选数量不断减少,底部才是供 RL 训练的环境;这张图本身没有画出 RL 更新后返回出题器的递归箭头。
证据与局限。 五个外部基准均有提高,其中 DeepSWE v1.1 为 10.0%→21.7%,Terminal-Bench 2.1 为 63.7%→72.2%。ProgramBench 的 4.5%→21.5% 是“至少通过 95% 测试”的任务比例,不能写成完整解决率。轨迹中更丰富的探索和自检与成功相关,但未单独证明它们是收益的因果来源。过滤全败题也可能移除困难但有效的任务;论文未充分拆分出题、审查与训练的总成本,长程交互预算同样要考虑。
评测数据集与环境。 CodeMidas 训练 5,545 题、独立任务验证集 200 题,每题三尝试用于监测和消融;不能将其称为完全未参与选择的最终测试。外部测试为 SWE-bench Pro、DeepSWE v1.1、ProgramBench、RepoZero C2Rust、Terminal-Bench 2.1。论文称采用官方任务集,但未逐项列实际运行题数、重复次数和 release;ProgramBench 用 Almost Solved,其余为 pass rate。依据 v1 §3–4、Figure 7、Appendix A;原任务池是否完整开放仍待核。
[!abstract]- Abstract 完整中文翻译 通过强化学习训练有能力的编程 Agent,需要多样任务和可靠验证器。开源代码库是丰富的任务来源,但现有方法通常依赖 issue、commit 等开发产物,限制了可提取任务的范围。为更好地扩展强化学习环境,我们提出 CodeMidas:一个以源代码为唯一任务特定输入、把现有代码库已实现功能转化为可执行强化学习环境的 Agent 流程。CodeMidas 在环境构建的每个阶段投入 Agent 计算:探索已实现功能并形成行为规范,依据原代码执行结果构造测试,再通过执行检查和重复求解 rollout 验证、筛选候选任务。所得数据集包含来自 3,185 个开源代码库的 5,545 个训练任务,跨越 23 种编程语言和 15 个技术领域。使用 GRPO 在这些任务上训练 MiMo-V2.5,改善了五个不同基准上的表现,覆盖 issue 修复(DeepSWE 增加 11.7 个百分点)、整程序构建(ProgramBench 增加 17 个百分点)以及终端工作(Terminal-Bench v2.1 增加 8.5 个百分点)。消融表明,增加高质量训练任务的数量能够提高性能。轨迹分析显示,RL 后的 Agent 展现出更多代码库探索和更多样的自我验证等更好的行为。这些结果支持把源代码作为一种可扩展基础,用来构造能够跨多种软件任务改善编程 Agent 的强化学习环境。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.22068 v1;首次提交 2026-09-18 17:55:17 UTC,即北京时间 2026-09-19 01:55:17。§3 环境构建、Figure 1(第 4 页)、§4.1 的任务隔离与指标定义、Figures 7–8、Table 1/Appendix A。评测对象另核对 ProgramBench 2605.03546、RepoZero 2605.07122 和 DeepSWE 官方 changelog。 原论文 v1。