EconSkills:技能本身能迁移,不代表从技能库检索就会受益
作者:Yinzhu Quan;Zefang Liu。
机构:Georgia Institute of Technology;Capital One(v1 第 1 页)。
任务背景。 假设你让浏览器 Agent 去官方统计网站查某国某年的进口额。它要找到正确表格,选对国家、时间和单位,再交出数值与来源网址。同一个网站的操作路径往往可以复用,但相邻数据序列的名称很像:上次成功的步骤,这次也可能把它带到错误口径。
核心方案。 作者先保留 50 条通过答案与来源检查的成功轨迹,让另一个模型把它们改写成可复用的操作说明。原来的国家、年份和目标值换成占位符,留下进入网站、定位数据、核对口径和失败后恢复的步骤。因此下一题继承的是“怎样找到并检查答案”,而不是上一次的答案或点击录像。
接下来分两步验证。先给每个技能配两个新任务,直接把正确技能交给 Agent,比较没有技能、原始成功轨迹和抽象技能的效果。再把全部 50 个技能放进库,让系统只根据名称和用途选择五个,观察正确匹配不再预先给定时,收益还能剩多少。模型、浏览器观察和操作步数上限保持一致;变化的是送进上下文的经验内容。
结果说明,技能能用与技能选得对是两个问题。直接给定匹配技能时,Agent 更容易成功;库级检索在覆盖到的任务上有收益,却会在没有对应技能的任务上被近似匹配误导。论文因此把后续改进目标指向“判断当前任务是否适用某项技能”,但尚未实现并验证一个可靠的拒用机制。
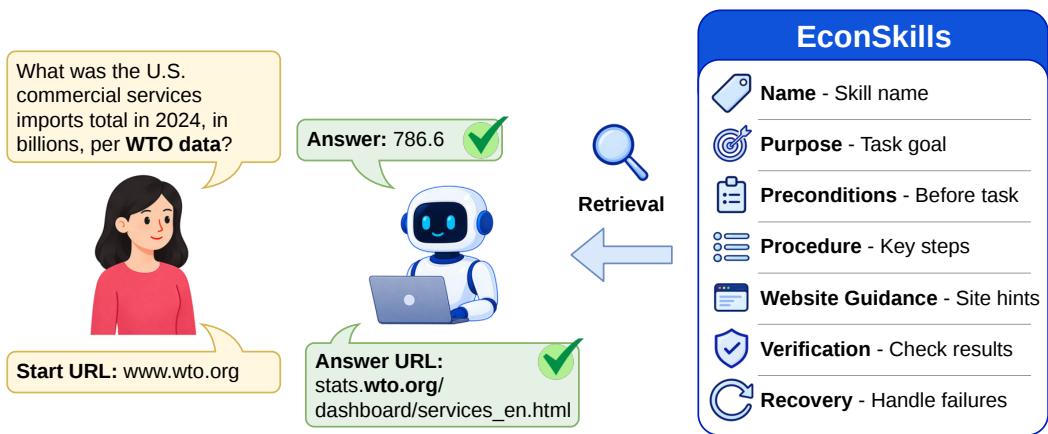 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从左侧用户的问题和起始网站开始,看右侧技能库经检索箭头把操作说明送给中间 Agent。Agent 返回两项结果:上方数值与下方来源网址。右侧列表提醒读者,技能除了操作步骤,还包含适用前提、核验和恢复规则。图只概括使用阶段;成功轨迹如何抽象成技能、怎样划分受控迁移与库级评测,是正文补充的实验流程。
实际增量与“这不就是……”。 这不就是把成功经验写成操作手册,再按需检索吗?关键增量在于把“手册本身有没有用”与“自动选手册有没有用”分别测量。原始轨迹即使来自同类成功任务,也可能把旧实例细节带进新题;而一份有用的手册被放到不适用的问题前,同样可能造成退步。
证据与局限。 在 100 个未见变体、每条件三次运行中,匹配技能的成功率为 49.3%,无技能为 41.0%,原始轨迹仅 7.0%。库级部署则是检索五项 28.3%、无技能 28.1%,总体成功率几乎不变;把全部技能塞入上下文降至 11.4%。双方都成功的 102 次配对中,技能平均少用 2.37 步,不能把失败后的提前结束算成效率提升。证据限于一个模型、实时经济网站和一次库级部署;后者还包含生成技能的种子任务,不能整体称为未见泛化。
评测数据集与环境。 EconWebArena:50 种子生成技能,100 个未见变体做迁移;三个条件各三次运行,共 900 episodes。库级每条件运行 360 个任务一次,直接覆盖 150 个、未覆盖 210 个。统一 30 步,成功要求 gold 数值和权威域名同时满足;四个网站变化导致的答案更新使用不参考条件结果的固定更正表。
[!abstract]- Abstract 完整中文翻译 Web Agent 经常反复访问相同网站,但多数评测会丢弃它们在此前成功交互中学到的操作流程。我们提出 EconSkills:一个技能库与评测框架,将经过验证的 EconWebArena 轨迹提炼成参数化的标准操作流程,用于获取实时经济数据。每项技能记录适用范围、导航步骤、网站专用指导、核验方法与恢复步骤,并把原始实例值替换成占位符。 EconSkills 区分两个问题:已知相关的操作流程能否迁移到留出的任务,以及 Agent 自己从技能库选择时能否保留这种收益。在受控迁移中,匹配技能比无技能提示获得更高成功率,在双方均成功的配对中使用更少步骤;抽象技能也明显优于原始轨迹重放。在库级评测中,检索的总体表现与无技能基线相当,并在直接覆盖的任务上最好;按覆盖情况分组后可见,未覆盖任务上的近似匹配抵消了这些收益。 浏览器轨迹进一步揭示,操作指导何时能缩短特定门户的导航过程,以及何时仍需要语义核验。结果表明,可复用的经济网站操作流程能够跨任务实例迁移,并为具有覆盖意识的技能选择与上下文提供方式提出了具体设计目标。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.19523 v1。首次提交 2026-09-17 00:29:46 UTC,即北京时间 2026-09-17 08:29:46;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对 §1、§3–5、Figure 1、Tables 3–5、Limitations 与 Appendix A/C;检索五项的总体结果不能代替直接匹配条件的收益。 原论文 v1。
Bias-only TTRL:不给标准答案,只调整少量偏置,模型能学到什么
作者:Naveen Vakada;Mingyuan Li;Shaoxiong Ji。
机构:University of Turku;ELLIS Institute Finland(v1 第 1 页)。
任务背景。 给模型一批数学题,却不提供标准答案。模型可以对同一道题尝试多种解法,但怎样判断哪次值得学习?这篇采用一个有风险的替代信号:把多次生成中出现最多的答案当作临时目标,让模型倾向于产生与它一致的回答。
核心方案。 对每道题,当前模型先生成 32–64 次回答,抽取最终答案并投票。与多数答案一致的回答得正奖励,其余得负奖励,再按同题内的相对表现形成更新信号。这里没有正确答案进入奖励,因此“大家一起答错”仍可能得到正向强化;方法能否有效,首先取决于多数票是否足够可靠。
论文把另一个限制放在参数上:保留语言模型原有权重,只在每层前馈模块的输出处加入一个可训练偏置向量。以主要 7B 配置为例,28 层合计只有 100,352 个可训练参数。这些向量会改变下一轮生成,新的回答又产生新的投票反馈。训练固定进行 200 步,之后冻结向量,随原模型一起用于回答,不需要推理时再做投票训练。
这不是“参数少就一定更好”。作者还用相同参数量的 LoRA 和其他表示干预作对照,观察哪些可更新方向真正承接了有用的学习信号。关于多数票的理论保证也有前提:正确答案原本必须比任一错误答案更可能出现;如果模型稳定地偏向错误答案,增加采样不能自动修正这种偏差。
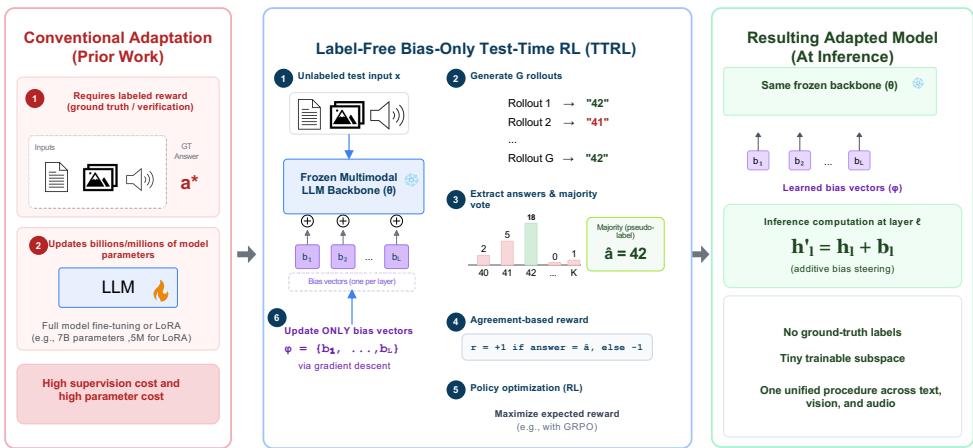 原论文 v1,Figure 2,PDF 第 5 页。
读图。 从中间第 1 步的无标签输入开始,向右看多次回答汇成临时多数答案,再向下转成一致性奖励。底部更新箭头只回到紫色偏置向量,蓝色主体始终冻结。右侧表示训练结束后的使用方式:保留学到的向量直接回答。图中的“冻结主体”不表示整个系统的输出分布不变,偏置已经参与每次生成;左侧的大参数对照也不能用来推断计算量减少了同样倍数。
实际增量与“这不就是……”。 这不就是把多数票自训练限制在很小的参数空间吗?值得理解的是两个限制同时存在时仍能学到多少,以及相同参数预算为何对应不同结果。它还把在适应题集上的提分与冻结后迁移分开,并审计多模态成绩是否来自格式或题型捷径。
证据与局限。 Qwen2.5-7B 与 Math-7B 在参与适应的 MATH-500 上分别达到 76.67% 和 79.50%,这不是独立测试集成绩。冻结后,在 4,500 道已核实不重叠的 MATH 题上,论文报告 46.3%→70.9% 与 52.5%→75.4%,提供了较直接的迁移证据。主表部分基线的上下文和解码口径不同,不能把每一行都当成等预算比较;76,000 倍指可训练参数量。MMAU 的约三分之二净增益集中在一个音素计数模板,排除后的小幅变化尚不足以证明其余题型改善;AI2D 也有格式提取改善的贡献。
评测数据集与环境。 MATH-500 的 500 题同时用于无标签适应和评测;MATH 另有 4,500 道不重叠题用于冻结后迁移。多模态使用 MathVista testmini 1,000 题、AI2D-TEST 3,088 题、LogicVista 448 题、MMAU-mini 1,000 题。作者自跑结果默认 greedy pass@1、200 步最后 checkpoint,主结果三训练种子;采样 32–64 次不是新增独立题目。
[!abstract]- Abstract 完整中文翻译 测试时强化学习(TTRL)使模型能够在不依赖带标签训练数据的情况下改善推理,但现有方法通常优化模型参数中的很大一部分。这引出了一个自然问题:当奖励信号与优化空间都受到严格限制时,仍能实现有效的测试时适应吗?我们通过无标签、仅更新偏置的 TTRL 回答这一问题:使用多数票伪标签作为奖励,冻结预训练主体,只优化约十万个偏置参数。 在 MATH-500 上,该方法达到 76.67% 准确率,略高于我们复现的有标签偏置引导,同时可训练参数量约为全参数 TTRL 的 1/76,000。同样的训练过程还改善了视觉语言和音频推理任务表现,包括 MathVista、AI2D、LogicVista 与 MMAU。我们进一步表明,学到的引导向量能够迁移到 4,500 道留出的 MATH 题,说明适应并不局限于测试时优化所用的问题。 最后,我们分析这种受严格限制的适应为何能够奏效:多数票伪标签的可靠性随生成结果的一致程度提高,而可获得梯度能量更大的偏置子空间表现出更强的后续可训练性。结果表明,完全使用无标签奖励、只优化极小的偏置子空间,也可能实现显著的测试时适应。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.18587 v1。首次提交 2026-09-16 12:45:25 UTC,即北京时间 2026-09-16 20:45:25;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对 §3–6、Figure 2、Tables 1–5、Appendix A/C/D。主文聚合成绩与附录题型审计、上下文差异分别保留;理论多数票结论依赖正答案概率优势。 原论文 v1。
DRPG:从过去的成败中写出下一题的行动建议
作者:Ting-Wei Chang;Po-Chun Chen;Hen-Hsen Huang;Hsin-Hsi Chen。
机构:National Taiwan University(Department of Computer Science and Information Engineering;AI Research Center);Academia Sinica(Institute of Information Science)(v1 第 1 页)。
任务背景。 例如,让模型接连回答不同数据库上的统计问题。它每次拿到问题和表结构,写出 SQL,再由环境比较执行结果与标准答案,告诉它这次答对还是答错。前面的失败很可能对后面的题有用,但直接找一条相似的成功答案,只能告诉模型“这题曾经怎么做”,未必能解释“这种错误为什么反复出现”。
核心方案。 新问题到来时,系统先检索相关历史记录,并把其中答对的案例放进执行模型的上下文。与此同时,另一次模型调用会同时查看相关的成功与失败案例,把可借鉴的规律写成最多五条行动建议。比如面对多表统计,建议可以提醒执行模型检查连接条件是否重复计数;这只是帮助理解的例子,具体建议由当前检索结果决定。
执行模型把问题、正确示例和这些建议一起用于作答。等当前答案已经提交,环境才返回二元正误反馈,系统随后把问题、答案和反馈保存为新的记忆。下一题就能检索到更丰富的历史,因此形成跨题积累;它不会用当前题的正确性标签提前指导当前作答。
这里的“策略”是一段文字建议。默认设置下,它每次依据检索记录重新生成,并不要求把上一轮策略传给下一轮。持续保存的是经验库;检索器、建议生成程序和模型参数保持固定。因此,论文研究的是借助记忆生成指导的持续适应,而不是已经验证了“改进机制继续改进自身”的完整 RSI。
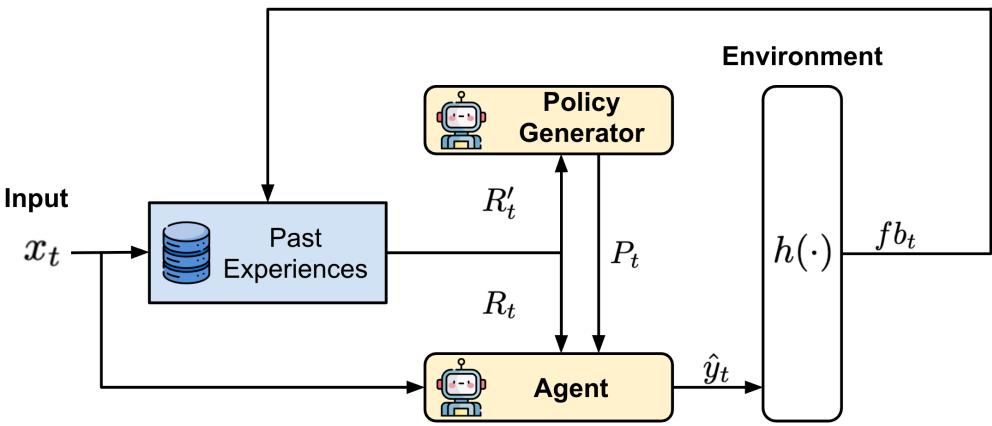 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从左边当前问题开始。中间的历史经验分成两路:下路把正确案例直接交给 Agent,上路把包含成败的案例交给建议生成器,再把生成的文字送回 Agent。最右边的环境只在 Agent 交出答案后返回反馈;上方绕回经验库的长箭头,才是连接这道题与以后题目的持久化步骤。图里的循环不表示模型权重更新,也不保证每轮成绩都会上升。
实际增量与“这不就是……”。 这不就是检索几个例子,再让模型反思吗?新增的一步是把过去的成败转成针对当前题的可操作规则,并与只检索成功示例的基线分开比较。它把反思从“刚才这一题再答一次”,移到了“下一题该怎么避免相似错误”。
证据与局限。 主实验覆盖七个模型和六个数据集,42 个模型—数据集组合中,29 个优于 Self-StreamICL。收益并不稳定:例如 Llama-4-Maverick 在 HotpotQA 上从 62.73 降到 50.60。通用程度不足或过度具体的建议也会误导。代表性 Spider 成本比较中,每题输入/输出 token 从 585/17 增加到 1,676/143,已经计入额外建议生成调用;不是等成本的胜出。实验默认有干净、即时的正误反馈,且使用单个固定任务顺序,不能外推到反馈稀疏、有噪声的长期部署。
评测数据集与环境。 Spider 1.0、CoSQL、BIRD 使用 SQL 执行准确率;HotpotQA 为 distractor 多跳问答,指标 exact match;DDXPlus 在 49 个候选诊断中选答案,指标 accuracy;DS-1000 以测试用例计算 pass@1。Spider 的代表性成本配置明确 2,147 题,DS-1000 原始规模为 1,000 题;其余本篇实际子集数量及快照未逐一披露,不能补成原始全量。各数据流在当前题作答后供给正误反馈并继续适应,没有另报统一的冻结策略留出测试;依据实验设置与成本附录。
[!abstract]- Abstract 完整中文翻译 大语言模型在多个领域取得了显著进展,但持续适应不断变化的任务与环境仍是一项关键挑战。现有记忆增强方法将过去的单个例子检索出来作为直接参考,却没有显式地从中综合出可执行的策略,使同类错误反复发生。 我们提出动态检索式策略生成(DRPG):将基于记忆的检索与动态策略生成器结合,利用历史数据和环境反馈,为任务生成专门的策略,以支持大语言模型持续改进。我们在涵盖自然语言转 SQL、问答、医学诊断与 Python 编程的六个基准上,使用七个来自闭源与开放权重系列的大语言模型评估 DRPG。它在多数数据集与模型上超过了较强基线。 进一步分析表明,DRPG 的策略生成对检索策略变化具有稳健性,无须保持此前策略的连续性也能有效运行,并能使用较小模型或其他模型系列作为更节省成本的策略生成器。我们还发现,策略层面指导的收益取决于任务特征,为这一机制何时、在什么条件下最有效提供了实践认识。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16800 v1。首次提交 2026-09-15 08:06:17 UTC,即北京时间 2026-09-15 16:06:17;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。PDF 标明 Published as a conference paper at COLM 2026;这里记录的是其 arXiv v1 提交日期,不将会议录用日期当作首次公开日期。核对 §3–5、Figure 1、Table 1、§5.4、Limitations 与附录 C–H;附录检索消融主要改变正确/错误案例的组成,不等于已经验证任意检索器或检索数量。 原论文 v1。
Harness 的价值:先把任务做对,与最后拒绝放行,要分开衡量
- How Do Agent Harnesses Create Value? Planning Information and Release Control in Stateful LLM Agents
作者:Yukun Zhang;Kemu Xu;Yishen Chen。
机构:The Chinese University of Hong Kong;University of Edinburgh;The Chinese University of Hong Kong, Shenzhen(v1 第 1 页)。
任务背景。 设想客服 Agent 帮用户修改订单或机票。它要通过对话确认需求,再调用工具改变数据库中的真实状态。任务结束时有两件事需要区分:订单究竟改对了没有,以及系统是否把这次执行当成已完成而放行。多加一个检查器,可能减少“做错却宣布完成”,却未必能把已经做错的订单修好。
核心方案。 作者先隔离执行前的帮助。一个条件给 Agent 人工预写、针对当前任务的计划;另一个条件放入打乱顺序的政策词语,尽量匹配字数和提示包装。两个条件用相同任务和模型配对,比较最终数据库状态是否正确,从而估计有用指导内容的贡献。
接着,作者在执行已经结束、标准检查器已经评过最终状态之后,增加一个只读的终端检查器。它使用执行模型本身,但只能查看最近最多八条用户/助手消息、每条截取最多 300 字符,不能读数据库,也看不到标准答案评分。它认为未完成,就拒绝放行;不会修改数据库、重试工具或撤销此前动作。
这样可以分别统计“做对而放行”“做错而放行”与“其实做对却被拦下”。最后再由假设的成功价值、错误放行损失和新增调用成本计算不同风险场景下的收益。这里的经济价值随设定变化,并不是实测的现实损失节省。
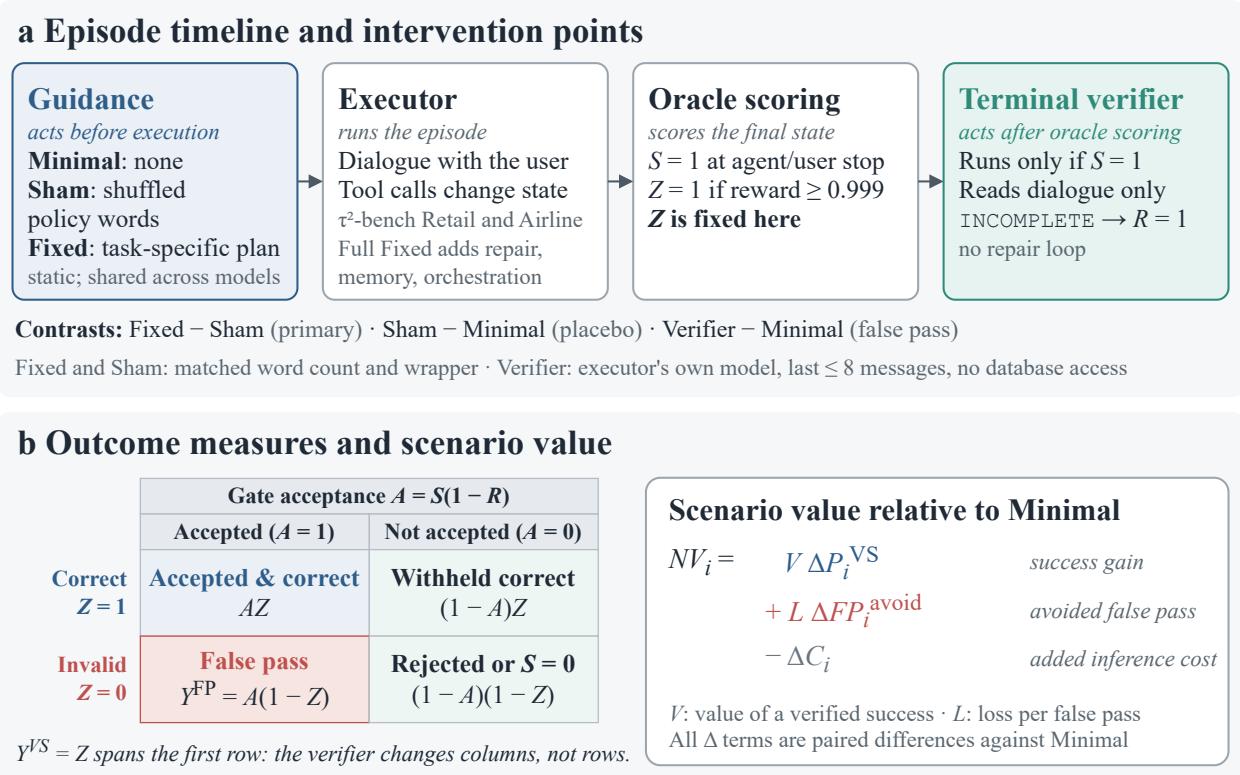 原论文 v1,Figure 1,PDF 第 6 页。
读图。 先沿上半部分从左向右看:指导进入执行模型,工具操作改变状态,标准检查器固定正确性标签,最后才运行只读检查器。这个先后顺序解释了为什么末端检查不能提高同一条已执行轨迹的真实正确率。再看下半部分的二乘二表:检查器让样本在“放行/不放行”两列间移动,不能把错误一行搬到正确一行。右下角的价值式,则是在这些不同结果上赋予不同代价。
实际增量与“这不就是……”。 这不就是加计划和验收吗?值得保留的增量是归因方式:计划是否帮助执行,和验收是否减少错误放行,用不同对照回答。把两者混成一个成功率,容易把拒绝更多任务误读成 Agent 更会做事。
证据与局限。 主规划对照的 265 个匹配单元中,预写计划比打乱文本提高成功率 7.17 个百分点,90% 按任务聚类的 bootstrap 区间为 1.15–13.36;这些单元不是 265 个独立任务。Retail 的终端检查在 229 条轨迹中拒绝了 137 条错误轨迹里的 83 条,同时拦下 92 条正确轨迹里的 16 条,即约 61% 与 17%。它减少的是错误放行,不能声称已经阻止执行中发生的不当操作。
预写计划的人工成本未计入,作者也未完整记录写计划时能访问哪些任务信息;打乱词序的对照只匹配词数,不匹配可读性与 token 数。业务样本较小且存在未完成的实验单元,模型间收益不同。经济分析还未纳入集成、维护和人工复查成本,因此不足以直接决定部署方案。
评测数据集与环境。 τ²-bench:共享 Retail 16 任务、6 模型、7 配置,实际 1,547 条轨迹;独立规划 Retail 24 任务、5 模型、4 条件,实际 1,227 条,主分析在预定筛选后保留 23 任务、4 模型的 265 个 Fixed–Sham 匹配单元;Airline 为 6 任务、5 模型、4 条件、计划两次重复,实得 233/240 条。成功由最终状态 oracle 决定,放行是另一个变量;若干后续分析复用同批轨迹,不能相加。论文自建能力探针与标量测量另有 486 个基础探针回答、198 次压力测试尝试,以及每模型 72 行标量测量;依据正文实验协议与附录覆盖审计,完整标量题源仍待核。
[!abstract]- Abstract 完整中文翻译 Agent 的配套运行系统会提供规划指导、组织执行并检查任务完成情况。我们在 τ²-bench 的两组零售实验和一组航空试验中,研究这些组件如何影响成功率、错误接受和成本。主要对照将预先写好的任务专用计划(Fixed),与词数匹配但顺序打乱的政策文本(Sham)配对,以隔离指导内容的贡献。 在 265 个匹配单元中,Fixed 使由标准检查器验证的成功率提高了 7.17 个百分点,90% 按任务聚类的 bootstrap 区间为 1.15–13.36 个百分点,收益主要集中在更复杂的任务。只读的终端检查器拒绝了零售实验中 61% 被标准检查器判为错误的执行,同时拦下了 17% 的正确执行,每次执行增加的成本不到一美分。 哪种组件更重要,取决于如何给错误接受赋予损失:责任损失较低时,规划带来的收益占主导;责任损失较高时,检查器避免错误放行的收益占主导。单独使用检查器,就能以完整规划加检查系统的一小部分成本获得几乎全部减少错误放行的收益。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20474 v1。首次提交 2026-09-17 14:30:14 UTC,即北京时间 2026-09-17 22:30:14;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对 §3–8、Figure 1、主规划效应与终端拒绝计数,以及 Appendix A/G/J/L/N/O。90% 区间、任务聚类、未观测单元和条件性成本核算均保留。 原论文 v1。
TIAO:一整段摘要得到奖励后,哪些词应该承担学习信号
作者:Qixiu Li;Chenlong Bao;Xiang Zhu;Xiaoyong Li;Ruixin Cao;Shukai Chen;Zhenxiong Zhou。
机构:National University of Defense Technology(v1 第 1 页)。
任务背景。 例如,原新闻写某公司把预算从 300 万提高到 500 万。模型要交出更短、流畅且不改错数字关系的摘要。整段摘要得到高分之后,如果每个词都接收同样的更新信号,真正决定事实的数字与连接词,便和可有可无的套话混在一起。
核心方案。 模型先为同一篇新闻采样多份摘要,按照连贯性、事实一致性、流畅性和相关性获得组内相对优势。随后,系统把源文章中的一部分 token 随机遮掉,保持已经生成的摘要和前缀不变,用采样时的旧策略重新计算这些词的概率。一个词在完整文章和遮挡文章下的概率变化越明显,就被视为越依赖输入信息。
这份依赖分数接着用于两个尺度。先把一条摘要内的分数求平均,调整整条摘要优势的强度;高质量而且依赖原文的摘要会得到更强的正向更新,低质量但依赖原文的摘要则可能受到更强惩罚。然后在每条摘要里只保留依赖分数最高的 40% 有效 token,让这些位置参与策略梯度。分数和选择门不参与反向传播,更新写进模型参数,下一批再重新采样和估计。
这里没有把“依赖原文”直接当成“答对”。依赖分数衡量的是遮挡后的概率敏感性,连原文里不重要的信息也可能引起变化,随机遮挡还会改变输入分布。最终方向仍由摘要质量奖励决定;而梯度只经过部分词,却仍除以完整摘要长度,意味着整体更新强度也随之改变。
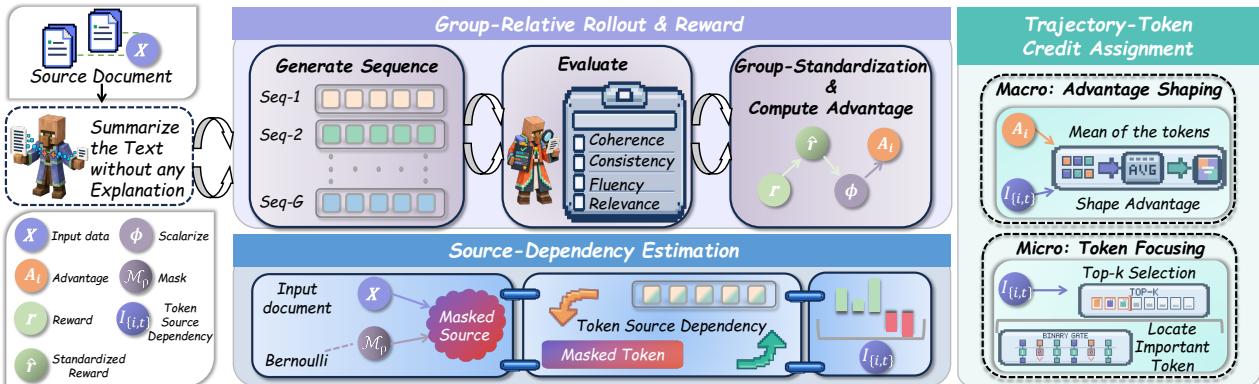 原论文 v1,Figure 2,PDF 第 2 页。
读图。 从左上方源文章开始,先看上面紫色通路:采样摘要、逐维打分、归一化,得到每条摘要的优势。下面蓝色通路则从同一篇文章出发,经遮挡比较获得每个输出词的依赖分数。两路在右侧汇合:上框改变整条摘要更新的强弱,下框筛出真正参与更新的词。图展示训练时的信息流;实际生成摘要时不需要再做遮挡比较。
实际增量与“这不就是……”。 这不就是挑重要 token 做 RL 吗?具体新增的是用“删掉输入证据之后,同一输出词的概率如何改变”来定义重要性,再同时作用于轨迹权重和 token 选择。它不同于只看生成不确定性,但这仍然是一个可检验的代理信号,不是事实依据的直接证明。
证据与局限。 主表报告 TIAO 的 UniEval 综合分为 0.960,同起点 GRPO 为 0.922、HVO 为 0.943;默认遮挡 50%,另比较 20% 和 80%。这些结果支持在该自动指标上的提升,但奖励和最终评分都使用 UniEval,缺少独立的人评或事实验证。表中的 STD 指四个维度之间的差异,不代表多次训练更稳定;部分数值与表内四项得分也对不上,需回查。消融主要改变遮挡比例,尚未充分隔离轨迹重加权、token 筛选和整体梯度缩放各自的贡献。
评测数据集与环境。 CNN/DailyMail:文章到摘要,Qwen2.5-7B-Instruct 起点、每篇采样八份、训练四个 epoch,输入/输出上限 2,048/512 token;UniEval 四维平均用于报告。论文未明确实际训练与测试数量、数据版本及独立重复次数,保留缺口,不把公开全量数据规模填进来。依据实验设置、Table 1 与遮挡比例消融。
[!abstract]- Abstract 完整中文翻译 文本摘要要求模型压缩内容,同时保留一致性和连贯性等关键质量。大语言模型已在这项任务上表现出较强能力,并可以通过强化学习进一步改进。然而,现有多数方法直接把奖励信号施加到没有区分的 token 序列上,忽略了不同 token 对摘要在词语和句子层面质量的重要程度并不相同。 本文提出 token 重要性感知策略优化(TIAO),一种显式利用 token 重要性意识的强化学习策略。具体来说,TIAO 根据 token 的依赖关系识别核心 token,并按照一条轨迹的整体依赖程度重新加权其优势。真实世界数据集上的实验表明,TIAO 取得了很有竞争力的结果,经 TIAO 增强的 7B 基础模型表现可与 GPT-4 和 GPT-5-nano 相比。代码见 https://github.com/TechCloud-x/TIAO。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16748 v1。首次提交 2026-09-15 07:23:07 UTC,即北京时间 2026-09-15 15:23:07;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对全文 §1–3、Figure 2、公式 6–14 与 Table 1。正文将 STD 定义为维度间标准差,不能据此声称随机种子间训练方差降低。 原论文 v1。
Stellar Colosseum:长证明出错后,怎样保留有用进展并换一条路线
作者:Honghao Lin;David P. Woodruff;Yuan Deng;Jieming Mao;Song Zuo;Vahab Mirrokni。
机构:Google Research;Carnegie Mellon University(v1 第 1 页)。
任务背景。 模型拿到一个研究级数学问题,需要交出能够从假设推到结论的完整证明。困难往往不是某一步写不出来,而是最初路线就不可行,或前面一个引理的条件被后文悄悄改掉。等几十页写完才发现问题,重新生成整篇又会丢掉此前有价值的部分。
核心方案。 系统先探索不同证明路线,并让批评者主动找反例或漏洞。只有一条路线被判断为足够成熟,才把它拆成相互依赖的证明章节;能独立处理的章节并行推进,依赖前面结论的章节则接着已有结果继续。拼成完整证明后,再做全局检查:局部错误返回受影响的章节,路线错误则回到最初探索。
为了避免多数候选重复同一种错误,每个阶段不仅产生多个候选,还保留针对它们的批评。合并时,每个节点抽取一组候选及其批评进行综合;不同组可以重叠,使同一个有用想法有多次被保留的机会。它并非对答案投票,而是在逐层缩减候选的同时继续修正论证。最终候选仍需再次接受检查。
跨研究轮次保存两类内容:上一轮完整草稿连同失败反馈,以及一个持续维护的知识目录。目录记录已经得到的引理、失败路线、参考资料和观察,并保留适用条件与来源。下一轮因此可以沿着已有证据换路线,而不是从原问题重新开始。不过,组织这些步骤的程序和基础模型仍固定;研究过程有记忆,不等于改进程序已经学会更有效地改进自身。
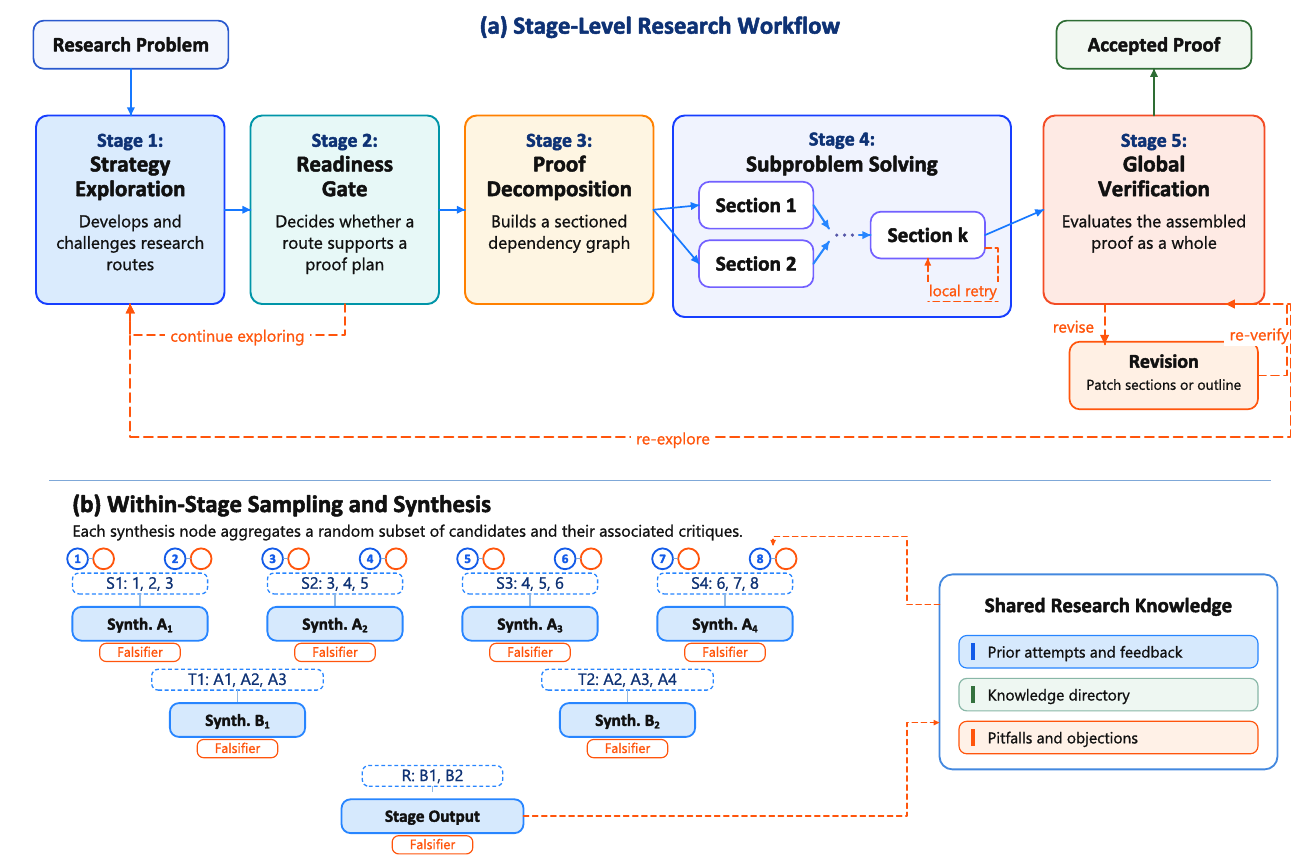 原论文 v1,Figure 1,PDF 第 2 页。
读图。 先沿上半图的蓝色箭头,从路线探索看到整体验证。橙色返回线区分了三种反馈:局部重试、修补证明、整条路线重新探索;应先判断错误影响到哪里,再选择返回点。下半图展开任意一个阶段:圆圈表示带批评的候选,虚线小组有交叠,逐层综合成一个输出。右侧知识目录把此前尝试与异议送回后续阶段,解释了为什么被淘汰的候选也可能继续贡献信息。这里的返回路径是固定流程中的研究迭代。
实际增量与“这不就是……”。 这不就是多 Agent 写证明、互相检查吗?额外机制在于显式控制何时拆分、按依赖定位修订,并在合并候选时连同批评一起保留。它针对的是“局部正确的段落拼不成全局正确证明”和“失败后丢掉所有进展”这两种长期任务问题。
证据与局限。 在 300 个 TCS-Bench 任务上,单独使用 Gemini 3.1 Pro/3.7 Flash 的流程分别为 54%/55%;再用批评信号从两份证明中选择,达到 71%,即 213/300。最终 grader 只判分、不参与候选选择,但它是参考答案辅助的模型检查,不是形式证明器。跨模型方法增加了推理成本,不能与直接调用的结果作等预算因果比较。Codeforces 带执行探针配置通过 218/222 题,无探针为 213/222;两者修订预算也不同,不能把五题差异全部归给探针。
评测数据集与环境。 TCS-Bench:300 个完整证明任务,自动 grader 在另 100 份专家标注证明上调校;“两次至少一次正确”的 77.3% 是 oracle 上界,不是实际选择器成绩。Colosseum 的 Codeforces 222 题协议使用 2025 年 4–10 月、52 场比赛的题目,公开样例与生成测试用于过程反馈,完整隐藏测试只做最终验收。开放研究案例包含五项结果与两个案例,属于选择性展示,完整证明与总尝试数量尚未独立核实。依据推理配置、研究案例、主评测和编程实验。
[!abstract]- Abstract 完整中文翻译 语言模型能够生成看似合理的短证明,但在长程研究问题上仍可能不可靠,因为进展依赖一系列不确定且相互关联的决策。我们提出 Stellar Colosseum,一个不依赖特定模型的配套运行系统,用于在数学与理论计算机科学研究中分配推理计算。 Colosseum 在构造证明前探索不同策略,利用就绪检查判断某条路线是否已经成熟到可以拆分,将证明计划表示为相互依赖的章节级子问题,并把检查器发现的问题送回论证中受影响的部分。在这些阶段中,它并行生成候选,用有针对性的证伪攻击候选,再通过允许样本重叠的随机抽样树形聚合,把候选与其批评综合成单份研究产物。该流程已作为 Long Proof 模式集成进 Google Antigravity 的 Teamwork 框架。 我们通过开放研究,以及定理证明和竞赛编程基准评估展示 Colosseum 的能力。使用 Gemini 3.1 Pro 时,我们获得了几项新结果,解决了来自 FOCS、JMLR 等顶级会议与期刊论文的开放问题。在 TCS-Bench——一个取自 FOCS、STOC、SODA 论文的研究级定理证明基准——上,Colosseum 使用 Gemini 3.1 Pro 和 Gemini 3.7 Flash 达到 71.0% 准确率。在另一项使用 Gemini 3.1 Pro 的 Codeforces 评测中,带执行反馈的证明导向流程解决了 222 题中的 218 题。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15983 v1。首次提交 2026-09-14 17:58:55 UTC,即北京时间 2026-09-15 01:58:55;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对 §3–7、Figure 1、Tables 1–3 与附录提示。图为原 PDF 第 2 页的完整 Figure 1 区域,补足 MinerU 分块抽取时裁掉的返回箭头。开放研究的成果归属与完整证明仍以各被引原研究为准。 原论文 v1。
OdoBot:把网页操作经验变成可执行路径,节省每一步的模型判断
作者:Alexandru Ianta;Eleni Stroulia。
机构:University of Alberta(Department of Computing Science)(v1 第 1 页)。
任务背景。 比如,让网页 Agent 在指定课程的群组里发布公告。它拿到课程名、群组名和公告内容,需要找到入口、填写表单并触发真实提交。同一个应用的登录和导航步骤会反复出现;如果每一步都把整个页面交给模型重新判断,就会为熟悉的操作重复付出推理成本。
核心方案。 系统先观察成功的人类示范,把点击、输入、页面跳转、界面变化和后台请求整理成事件图。同类事件会被合并,不同示范因此共享路径;具体课程名或输入文本被保留为运行时再填的参数。图中的目标也不只是某个按钮,而可以是代表任务完成的 API 请求或 GraphQL 修改事件。
新任务到来后,模型先去掉实例参数,把它改写成一般任务,再检索十五条相似轨迹并选择合适的一条。系统由此确定目标事件,以当前浏览器位置作为起点,在图中搜索执行路径;如果有多条路径,再结合自然语言说明和与示范的重合程度选择。执行时通过实际事件是否匹配预期来推进光标;发现跳到了别处,就重新定位并规划。
模型主要处理仍有歧义的选择,例如一组外观相似的课程卡片里哪张符合任务参数。此时只把相关元素交给模型,而不是发送整个页面。被保存并复用的是事件图、路径与语义标注,模型权重没有改变;当前论文也没有展示新失败自动修图并改善下一批任务的循环。
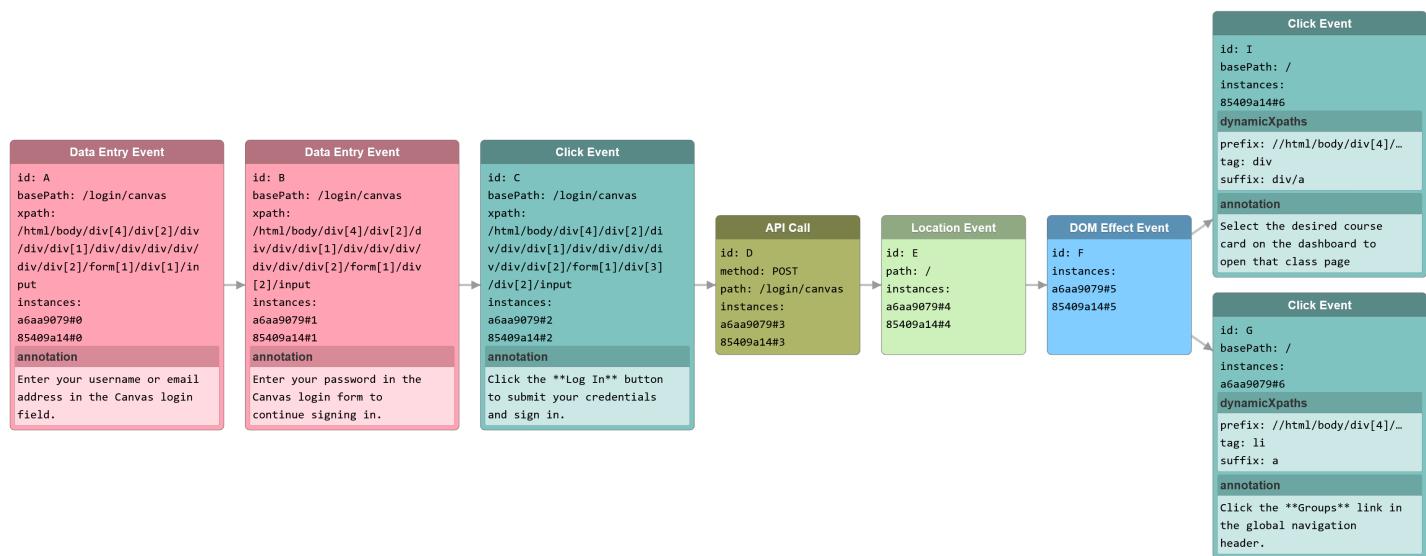 原论文 v1,Figure 1,PDF 第 6 页。
读图。 从左侧两次输入开始,沿灰色箭头经过登录点击、后台请求、地址变化和页面加载。前面这些节点由两条示范共用,到右侧才分成“打开课程”和“打开群组”两条路线。节点里的实例记录保留了事件来自哪条示范;语义注释解释步骤用途,动态 XPath 则为运行时选择具体对象留出位置。这是一张示例行为图,完整任务选择与路径搜索过程由正文说明。
实际增量与“这不就是……”。 这不就是把网页操作录下来重放吗?区别在于它先把多条示范合成图,区分固定操作与可变参数,再从当前位置寻找可组合路径;遇到具体对象选择时仍调用模型。因此它比固定点击录像灵活,但也依赖示范是否覆盖了足够的应用行为。
证据与局限。 在 45 个任务实例、五次运行中,OdoBot 成功率为 76.4%,Agent-E 为 85.3%,1080p 的 WebVoyager 为 72.9%。每轮 45 任务的在线 token 分别约 90 万、160 万和 460 万,因此 OdoBot 节省了调用,但没有同时超过两个对手的成功率。构建应用模型另花约 1,030 万 token,只有反复复用才可能摊薄。测试换了实例参数,但工作流仍来自同一批任务模板;动态控件、缺失行为和失效 XPath 仍会导致失败。
评测数据集与环境。 OdoBot 的 Canvas LMS 环境:45 模板、10 门模拟课程,环境容量 450 实例;建模使用 45 条示范,评测另选 45 实例,每配置重复五次。在线模型统一,按任务相关网络事件核验,报告成功率与 token,每整轮后重置数据库。建模开销与在线开销分列;依据环境构建、比较协议和 Table IV。
[!abstract]- Abstract 完整中文翻译 AI Agent 在多种任务上的强劲表现正推动对 Agent 基础设施的空前投入,但处理 token 的成本也在快速增长。Web Agent 通过分析网页应用的用户界面并与其交互,自动完成以自然语言描述的网页任务。 本研究提出 OdoBot,一种新的 Web Agent 架构,与常规 Web Agent 相比,完成任务只需其一小部分成本。它通过分析成功任务执行示范,建立底层应用的行为模型,并利用这一模型实现这种效率提升。 我们在 Canvas 学习管理系统的 45 项任务上进行实验,表明 OdoBot 比两个先进竞争方案 Agent-E 和 WebVoyager 分别少使用 44% 和 80% 的 token,同时在任务成功率上超过 WebVoyager。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.13491 v1。首次提交 2026-09-11 19:57:22 UTC,即北京时间 2026-09-12 03:57:22;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对 §III–VII、Figures 1–2、Table IV。首页机构、正文的建模模型与执行模型分开核对;未将 450 个可生成实例写成实际测试规模。 原论文 v1。
Chronicle:固定失败时的输入,再验证修改后的工具是否真的修好了
作者:Tisha Chawla;Susheem Koul(两位作者等贡献)。
机构:Microsoft(v1 第 1 页)。
任务背景。 假设 Agent 把“卖出约 1,000 美元”误解成“卖出 1,000 股”,工具又没有检查数量。开发者给工具补上保护条件之后,要验证的是:同一个错误请求再次到来,修改后的代码会不会挡住它。直接重跑 Agent,模型可能这次就不犯错,于是测试通过,却没有真正碰到需要修复的分支。
核心方案。 Chronicle 在模型调用、工具调用和路由等可能产生不确定结果的边界记录输入、输出与版本信息。每次经过边界都按名称和出现次数编号,比如第一次模型调用、第一次下单工具调用、第二次模型调用。把全部边界都替换成记录值,可以复现当时的返回序列,但也会跳过修改后的工具代码。
所以它允许只固定一部分边界。本例中,先从记录里读出第一次模型调用,确保送进工具的仍是那组错误参数;工具边界则实际运行新代码,后续需要检查的步骤也照常执行。测试用结构化断言确认不当动作是否被阻止。这样,同一条故障可以反复比较原代码与修复代码,而不是等待模型再次犯同样的错。
以后修改代码时,记录和断言一起留作回归测试。如果被固定的边界调用次数改变,就报错要求检查记录是否还适用。这种检查只约束已标记的接口,并不会保存全部数据库副作用、内部状态或并发时序;被实际执行的部分仍需合适的测试环境。
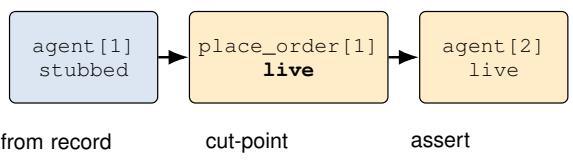 原论文 v1,Figure 2,PDF 第 3 页。
读图。 从左侧蓝框开始,第一次模型结果由故障记录提供,所以错误工具参数被固定。中间黄色框是切换点,下单工具运行当前代码;右侧后续模型步骤也实际运行,然后检查最终行为。图里的 live 指函数真的执行,主实验中的模型函数仍是模拟边界,不能据此说它验证了真实在线模型的确定性。
实际增量与“这不就是……”。 这不就是录制和重放吗?关键在于让选中的新代码真实运行,同时用原始记录固定它上游的条件。如果把工具也完整替换成旧输出,无论代码怎样修改,测试看到的都会是过去的结果,便无法判断修复是否有效。
证据与局限。 六个故障上,切点测试都能让原代码失败、修复及无关改写通过;完整替换全部边界的对照无法区分这些版本。192 个代码变异中检出 51 个,110 个对录制输入没有影响,另 31 个仍挡住危险动作、只改变断言忽略的字段。因此“挡住所有会放行本次危险动作的变异”不等于检测到全部代码缺陷。20 次完整回放无差异,但模型边界为模拟函数;单条记录也只覆盖一次输入。论文没有评估自带语言模型 judge 的可靠性。
评测数据集与环境。 Chronicle 六项故障协议:6 个案例、18 处显式边界、30 个无关改写、192 个变异,结构化断言为最终标准。录制每边界中位开销 23 微秒;0.008% 使用的是假设 300 毫秒模型延迟。另在本地 Qwen3.5 4B 上每条件运行 50 次,开/关录制的均值差为 91 毫秒,95% 区间 −59 至 241 毫秒,未检出显著延迟差异。依据方法、套件、Table 2 与局限;不把模拟边界的零调用成本外推到所有切点方案。
[!abstract]- Abstract 完整中文翻译 大语言模型的回答具有非确定性,因此 Agent 故障很难复现:故障依赖无法逐比特重现的推理、读取变化状态的工具,以及重新运行时很少完整重复的多步轨迹。录制与回放能够让一次运行可复现,但现有 Agent 工具记录运行,主要是为了追踪或评分,而不是用它来测试代码改动。 我们提出 Chronicle,在 Agent 的非确定性边界用不可变记录封装一次运行,并按记录回放。它的核心操作是切点回放:选中的一部分边界使用记录值,互补的另一部分边界则用新代码实际执行,从而把一次已记录故障变成可以在持续集成中运行的回归测试。 在包含六项已记录故障、模型边界为模拟函数的基准上,录制每经过一个边界增加 23 微秒开销,相当于假设的 300 毫秒模型调用的 0.008%;完整回放不发起模型调用,并在 20 次重复中保持逐比特稳定;对全部六项故障,切点测试在错误代码上失败,在带保护条件和无害改动的版本上通过。在对受保护工具的代码变异研究中,切点测试发现了所有会放行录制中那次不当动作的变异,而把每个边界都替换为记录值、使用相同断言的基线一个也没有发现。Chronicle 与基准已公开:https://github.com/theagentplane/chronicle。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20625 v1。首次提交 2026-09-17 16:09:57 UTC,即北京时间 2026-09-18 00:09:57;本轮元数据发现/核对快照:2026-09-21 01:08:59 +08:00,正文核对日同日。核对全文、Figure 2、Table 2 与 Limitations;作者机构按 v1 首页署名记录,不依据邮箱推断。区分完整回放、切点回放和真实模型延迟对照。 原论文 v1。