CDA:记住规则有帮助,但旧规则失效后能否放下
作者:Shambhavi Mishra;David Vazquez;Perouz Taslakian;Marco Pedersoli;Jose Dolz;Issam H. Laradji。 机构:ServiceNow Research;LIVIA/ILLS/ÉTS Montréal;University of British Columbia;Université Polytechnique Montréal;Mila–Quebec AI Institute;McGill University(v1 第 1 页)。
任务背景。 假设 Agent 帮公司处理服务申请。它把一条审批记录改成“拒绝”,系统可能自动改另一字段,甚至创建关联记录。要预判后果,Agent 需要知道公司的业务规则;而这些规则会随着政策变化。真正的问题不只是学会新规则,还包括发现“以前成立的关系,现在已经不成立”。
核心方案。 CDA 先操作业务系统,观察哪些字段发生了连带变化,再把推断写成可读的“触发条件—后果”规则。例如,修改商品数量后总价也变了,就尝试记录两者关系。它可以继续实验、修正规则,也可以删除规则。需要特别注意:论文主实验还让它读取当前规则定义,因此结果来自配置证据与交互观察的结合,不能解释成完全盲目的规律发现。
进入下一个世界时,系统把这份规则模型交给 Agent,但不带入之前的发现轨迹。大部分规则仍然有效,旧模型能节省重新探索的成本;发生变化的部分则需要修订。发现阶段结束后,Agent 用模型预测新动作的连带结果,此时不再查询在线系统。保留下来的是规则知识,而不是一次对话的全部历史,也没有更新语言模型参数。
实验把变化拆成三步:先修改一条规则,再增加一条,最后删除一条。前两步会出现新的、容易注意到的结果;最后一步却是“本该发生的变化没有发生”。现有循环没有明确要求把预期后果与实际观察逐项对照,于是即使 Agent 重新试过原触发条件、也看过不再包含旧规则的列表,仍可能保留那条过时知识。这是作者根据发现日志给出的解释,不是已经验证有效的修复方法。
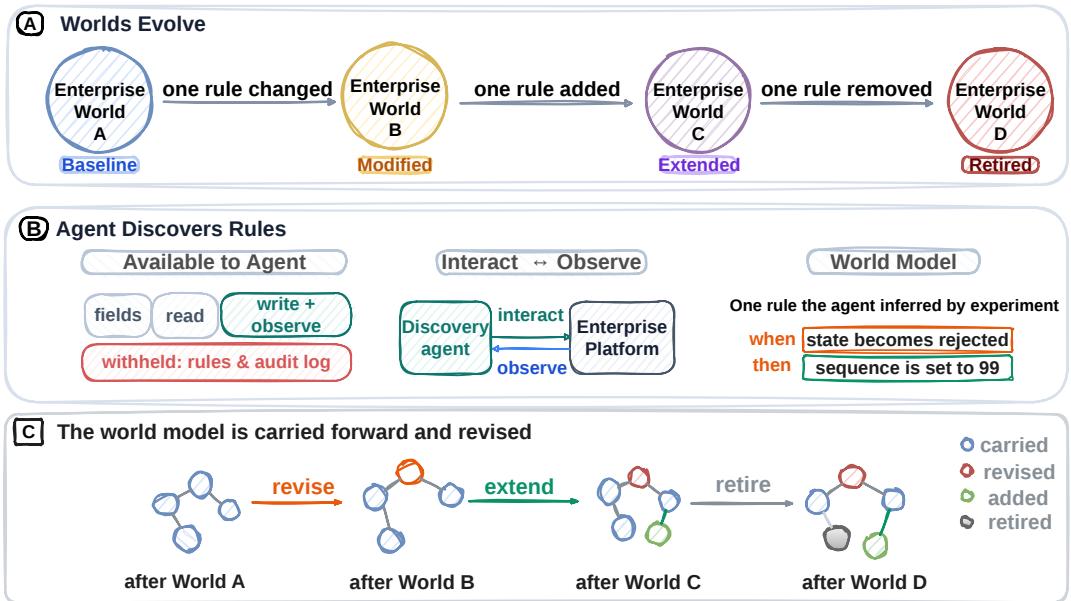 原论文 v1,Figure 1,PDF 第 2 页。
读图。 先看最上方 A 到 D:表和记录保持不变,箭头只改变一条业务规则。中间一行从左侧的读写能力出发,经中央“操作—观察”的往返箭头,到右侧形成规则模型;底部再展示它怎样被下一世界继承。这里有两处必须对照正文:图中写着规则定义不可见,但主实验实际上开放了规则读取;右下灰色节点表示期望支持的规则淘汰,不代表实验已做到,三个模型都没有成功删除失效规则。
实际增量与“这不就是……”。 这不就是把操作经验记成规则,下次接着用吗?值得关注的是它把“记得更多”拆成修订、增加和淘汰,单独检验每一种变化。平均分提高并不意味着每种适应都成功:继承在新增规则时有利,在删除规则时反而会拖后腿。
证据与局限。 主表中,CDA 相比每题重新查询系统的 DA,在三个模型上提高 6.99–8.98 个 IoU 点。与每个世界从头重建的对照相比,持续模型在 B–D 的平均表现更好,却在删除规则的 D 世界全部落后,差距为 2.84–10.23 点;三个模型均未删除失效规则。Gemma 的三次运行中,CDA 与 DA 的均值差为 4.83 点,小于主表单次差距,因此不宜只记最好的结果。证据限于一个平台、单条规则变化和可读取规则的设置;CDA 的语言模型还会补足规则表示表达不了的连锁关系,不能把预测成绩完全当成规则表本身的质量。
评测数据集与环境。 EnterpriseWorldShift:9 表、252 初始记录、基线 25 条规则,四个世界各 150 个测试动作,共 600 个。发现过程不接触这些题;每题恢复原状态,按连带变化集合计算 precision、recall、IoU,剔除动作自己直接写入的字段。规则恢复和“能否淘汰旧规则”另行评分;多次种子运行不是新增独立题目。参考实现与真实平台逐题一致用于验证真值,不能再当成一次独立泛化实验。
[!abstract]- Abstract 完整中文翻译 在企业系统中,更新一个字段可能设置另一个字段、创建记录或启动审批。这些效果来自各组织自行编写并持续修订的业务规则,而不是平台内置规则。不知道这些规则,Agent 就无法预判自身动作的结果。我们研究持续企业世界模型发现:Agent 起初不了解业务规则,通过操作记录、观察结果来发现它们,并据此构建世界模型,在规则变化后继续修订。 为评估这一能力,我们提出 EnterpriseWorldShift。它基于真实 ServiceNow 环境,包含九张表、25 条隐藏规则和 600 个评测动作,提供同一企业世界的四个版本:表与记录固定,依次修改、增加、删除一条规则,分别测试发现、修订、扩充和淘汰。我们的持续发现 Agent(CDA)构建这种模型,并把它从一个世界带到下一个世界。与先前工作每遇到一个问题就重新查询规则的做法相比,它预测隐藏规则效果的 IoU 最多提高 8.98 点,并能直接依据自身模型作答,无需查询运行中的系统。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.19551 v1。首次提交 2026-09-17 01:23:43 UTC,即北京时间 2026-09-17 09:23:43;核对 Introduction、§3–6、Figure 1、Tables 2–6、Appendix B/C。图示与主实验的规则访问权限不同,已在正文说明;摘要按作者原意翻译,不能用摘要替代实验条件。 原论文 v1。
EMR:把团队答题的成败整理成下一次可用的经验
作者:Dongsheng Shi;Yue Li;Xin Yi;Linlin Wang。 机构:华东师范大学;香港城市大学(v1 第 1 页)。
任务背景。 这里的 Agent 做的是医学选择题:读题干和候选答案,从不同专业角度分析,再选出一个答案。多个角色可以提供不同看法,但如果每道题都从零开始,上一题已经出现过的误判仍会重复。EMR 想让团队把“为什么做对、为什么做错”留下来,帮助后面的题目。
核心方案。 每道题先由规划角色判断涉及哪些专业,再让相应角色分析,最后由汇总角色综合答案。系统记录完整过程,并在经验挖掘阶段用标准答案判定最终对错。评论角色据此从成功轨迹提炼可复用做法,从失败轨迹提炼需要避开的误导线索。因此,团队并不是仅凭“大家同意”判断这次经验是否可靠。
新经验不会直接堆进历史对话。系统把它整理成原则、常见推理模式和具体案例三层,先检索相似条目:差异较大时新增,相似时再由模型决定合并还是丢弃。下一题到来后,检索器从原则逐步找到模式与案例,把相关经验交给规划、专业分析和汇总角色。这样,影响下一次推理的是经过整理的经验库,底层模型参数保持不变。
论文实验将经验挖掘题与评测题分开,挖掘过程运行五轮,然后检查这份记忆能否用于其他题目、其他数据集或另一种模型。这个安排比在同一道题里反复反思更接近持续学习,但仍依赖带标签的经验来源,也没有让系统自己发明经验更新规则。
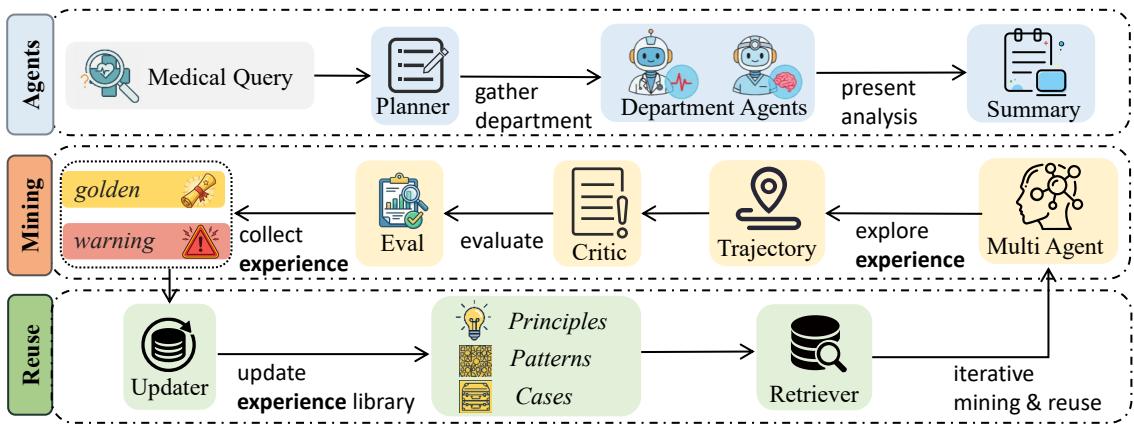 原论文 v1,Figure 2,PDF 第 3 页。
读图。 从最上排左侧题目出发,沿箭头经过规划、专业角色和汇总,得到一次答题轨迹。中间一排的箭头反向走:右侧轨迹经过评论和评估,左侧分出成功经验与失败警示;标准答案参与这里的判定,是正文明确的监督条件。再向下进入更新器,把经验写入三层库;右下检索器回到多 Agent 的箭头表示后续任务复用,不是当场把测试答案回灌给当前题目。
实际增量与“这不就是……”。 这不就是给团队共用一本经过整理的错题本吗?具体增加的是把成功和失败都转成不同抽象层次的经验,再共同影响分工、分析和最终汇总。值得比较的是经验怎样被压缩和迁移,而不是把更多角色本身当作学习。
证据与局限。 主表中,Qwen3-8B 的九项平均准确率从 MDAgents 的 77.8 提高到 81.1,GPT-4o 从 92.4 提高到 93.9,分别是 3.3 和 1.5 个百分点。去掉经验后,Qwen 的 MedQA 从 81.0 降到 74.3,支持经验模块的作用;跨数据集、跨模型实验也观察到收益。但论文正文“持续优于所有基线”的表述需要收窄:GPT-4o 的 MedMCQA 上,EMR 89.2 低于 MDAgents 90.5。样本选择、额外挖掘成本和角色数量都会影响比较;五轮离线问答不能证明真实临床适应或无限轮持续改善。
评测数据集与环境。 MedQA 与 MedMCQA 按论文划分各一半挖掘、一半评测,但实际纳入总题数和与官方划分的对应未核实;PubMedQA 为 500/500。MMLU 使用 anatomy、clinical knowledge、college medicine、medical genetics 四类,各对半划分;MMLU-Pro 使用 health、biology,附录称每类 200 个实例并对半划分。不能把标准完整测试集规模填进这些自定义子集。指标是 accuracy,三次独立运行均值;五轮挖掘使用标签,测试题不用于经验生成。
[!abstract]- Abstract 完整中文翻译 由大语言模型驱动的多 Agent 系统在复杂临床推理中展现出潜力,但现有方法依赖静态策略,缺少持久临床记忆,无法从以往诊断成功和失败中自我演化。我们提出通过经验挖掘与复用实现自我演化的医学多 Agent 系统 EMR。它把积累的知识组织成临床原则、诊断模式和代表性案例三个层次。推理时,规划 Agent 协调不同专业的科室 Agent 进行分析,再由汇总 Agent 综合为最终决定。 关键在于,EMR 自动从多 Agent 推理轨迹中提取正确的诊断认识与失败警示,逐步更新经验库,为后续案例提供指导。医学推理基准上的实验表明,EMR 持续优于先进的医学多 Agent 基线。进一步分析显示,分层经验可以跨专业泛化,也能在不同大语言模型之间迁移,为持续演化的智能医学推理提供了一条可扩展、可解释的路径。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15161 v1。首次提交 2026-09-14 07:41:56 UTC,即北京时间 2026-09-14 15:41:56;核对 §1、§3–6、Figure 2/4、Tables 1–5、Appendix A/B/I。摘要保留作者主张;主表中的例外、数据划分和监督来源已在正文注明。 原论文 v1。
特权信息与自蒸馏:老师看到答案,究竟多教会了什么
作者:XiuYu Zhang;Wei Chow;Junfeng Fang;Zhenkai Liang;Tat-Seng Chua。 机构:National University of Singapore(v1 第 1 页)。
任务背景。 假设学生模型正在解一道数学题,老师能看到标准答案或完整解法,但学生只能看到题目。老师不替学生写答案,而是读学生已经写出的每一步,给出下一步更应该选哪些词的监督。训练后学生得分上升,究竟是老师手里的解法起了作用,还是蒸馏本身已经带来了大部分改善?这篇研究要把两者分开。
核心方案。 研究者为同一道题准备六种参考材料,保留相同最终答案,只改变解释形式和长度。学生先独立生成回答,冻结的教师再在同一段学生前缀上评分。学生通过分布匹配更新参数;参考材料只交给教师,既不直接拼进学生输入,也不在测试时提供。
关键对照是完全不给教师参考材料,但保留其思考模式。主设置中,学生训练时直接作答,教师却处于思考模式,因此即便两者最初权重相同,监督分布也不相同。训练改变两种推理模式共享的参数,可能让学生在之后开启思考时表现更好。由此,必须先扣除无参考蒸馏已有的收益,才能判断额外解法贡献了多少。
论文进一步把学生训练轨迹改成长思考轨迹,并固定题目、参考材料和评测方式。此时原来的正收益会转为负收益,说明同一份参考是否有用,也取决于它在指导什么样的学生尝试。这里同时改变了轨迹长度和监督窗口覆盖比例,不能把差异全部归因于“思考模式”一个因素。
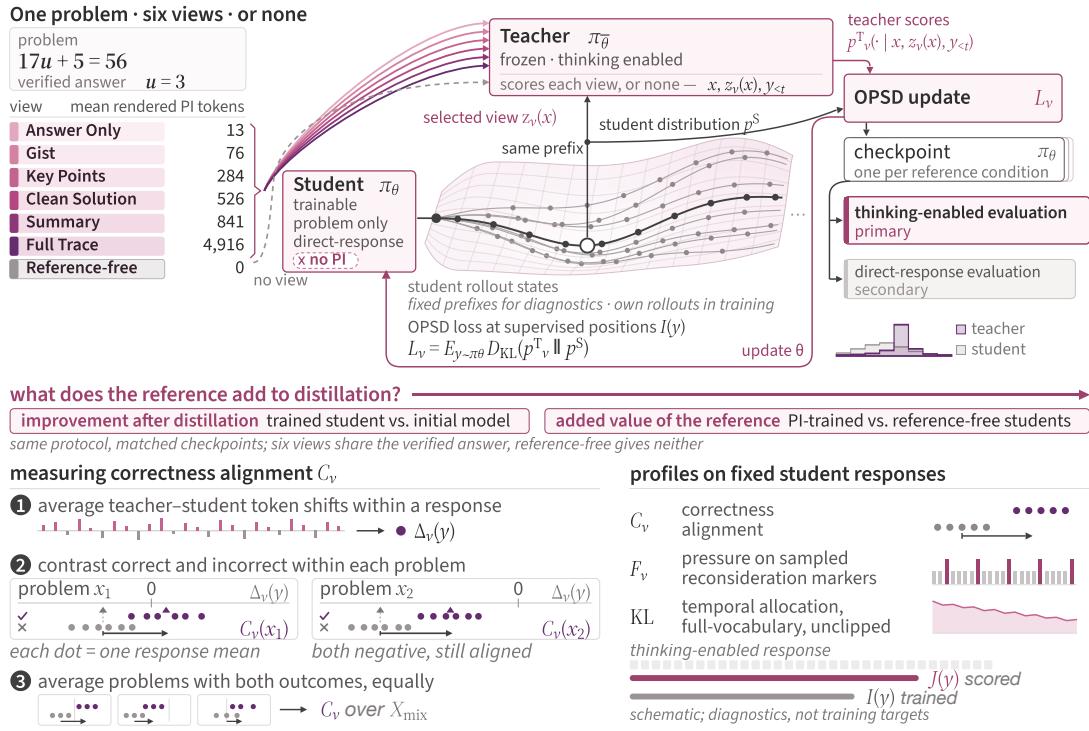 原论文 v1,Figure 1,PDF 第 2 页。
读图。 从左上角同一道题开始,六条彩色路径把不同参考送给上方教师,灰色路径是无参考对照;左下学生只收到题目。学生生成的前缀向上送给教师评分,师生分布再共同进入右侧更新,更新箭头只返回学生。之后的 checkpoint 分别进入思考与直接作答两条评测支路。图下方是在同一批回答上分析监督形状,用来提出解释,并不是把这些诊断量直接当成训练目标。
实际增量与“这不就是……”。 这不就是给老师不同版本的参考答案,再看学生能学到多少吗?真正关键的是增加“老师也没有参考答案”的匹配对照,并区分学生训练时怎样回答、测试时怎样回答。否则,原本来自模式差异的蒸馏收益,很容易被算在更丰富的参考材料头上。
证据与局限。 Qwen3-1.7B 在第 100 步的域内结果中,无参考相对初始模型提高 1.80 个百分点,整理后的解法提高 3.10 点,两者相差 1.30 点;这项额外收益未经多重比较校正时区间不含零,Holm 校正后不再显著。SmolLM3-3B 的完整轨迹在第 50 步比无参考高 2.0 点,但到第 100 步几个主要配置都低于初始模型。因而证据支持的是依赖模型、轨迹与训练时长的小幅增量,不能概括为“参考越完整越好”,也不能据此断言特权信息普遍无用。
评测数据集与环境。 AMPLE-Math 共 5,319 题、六种答案一致的视图;主训练/开发/测试为 1,536/192/384 题,域内测试 Avg@4。外部测试使用 AIME 2024、AIME 2025 与 HMMT 2025 年 2 月,各 30 题、每题 12 次思考采样,报告 Avg@12;十二次尝试不会增加独立题目数。主要对照在相同的第 50/100 步,不能拿不同 checkpoint 的最好成绩直接比较。
[!abstract]- Abstract 完整中文翻译 On-policy 自蒸馏让语言模型向自身的一份冻结副本学习,而副本可以看到答案或完整解法。额外信息似乎让教师有更多内容可教,但相对于蒸馏本身,它究竟增加了多少?为隔离这一贡献,我们构建 AMPLE-Math:一个包含 5,319 道数学题的可复用集合,每题有六种共享同一答案的推理视图,并把每种视图与匹配的无参考蒸馏进行比较。 当开启思考的教师监督直接作答轨迹时,无参考蒸馏已经解释了 Qwen3-1.7B 在开启思考评测中的大部分提升,域内与外部基准上都是如此。在 Qwen 中,参考材料额外收益的证据较弱,整理后的解法最明显;在 SmolLM3-3B 中,完整轨迹在第 50 步增加两个百分点。收益取决于正在训练的学生:在相同 checkpoint,题目、参考与评测不变,仅把短直接回答换成长思考轨迹,两种模型的收益就都会变为损失。 Qwen 的教师监督画像和匹配损失干预还表明,改变 token 级监督,学生行为可能仍几乎不变。综合来看,这些发现提示,自蒸馏可能通过直接作答与思考推理共享的参数,改善对已有推理能力的调用。特权参考的价值在于它为这种跨模式迁移增加了什么,而不在于暴露了多少解法。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20612 v1。首次提交 2026-09-17 15:57:10 UTC,即北京时间 2026-09-17 23:57:10;核对 Introduction、§2–5、Figure 1–3、Table 1、Appendices A/B。完整摘要来自 v1;额外收益、置信区间与多重比较结论均按原文区分。 原论文 v1。
Score Centering:采样与训练的微小偏差,为什么会越练越大
作者:Martin Marek;Max Ryabinin。 机构:Together AI(v1 第 1 页)。
任务背景。 训练数学解题模型时,通常用一个推理引擎快速生成答案,再用训练引擎算梯度。为了省资源,前者可能使用更低精度,或者暂时落后几个模型版本。两边看起来是“同一个模型”,给同一个词的概率却略有不同。这些差异为什么可能在强化学习中不断放大,而不是只造成一点随机噪声?
核心方案。 先想一个极端例子:不管生成什么都给相同奖励,理想情况下就没有“哪种行为更好”的信息,平均更新应当为零。然而答案来自采样器,梯度却由另一套概率算出时,这个抵消关系会被打破。训练器会额外向带偏差的采样器靠近,更新后的参数又同步回采样器,下一轮继续沿同一方向偏移。这部分更新没有区分成功与失败,论文称它为漂移。
修正方法是在每个已经到达的生成前缀上,先估计“按采样器的词概率计算,训练器的对数概率梯度平均指向哪里”,再从本次采到词的梯度中减掉这个平均方向。这里居中的是 score,也就是对数概率的梯度,不是把奖励重新减一次均值。它去掉那股共同推力,保留奖励与具体词选择之间的关联;实现时可记录采样器的少量高概率词,再近似补齐尾部。
这并不把所有分布差异都消掉:剩下的学习信号仍然按采样器分布取平均。模型版本相差较大时,还可以结合重要性采样来修正分布,再由 score centering 去除剩余漂移。论文的陈旧版本实验也显示,两者组合优于只做居中;没有理由把它理解成“从此不必关心 rollout 的版本”。
方案图。 原文用公式和实现代码说明修正,Figures 1–5 均为实验曲线;本篇未附独立方法原图。
读图。 本篇不拿成绩曲线充当流程图。理解方法时可以对照原文公式 3–5:先把平均更新拆成共同漂移与奖励关联,再在每个前缀上减去共同方向。返回下一轮的是更新后的模型参数;实验曲线只用于检验这个修正是否阻止训练退化,并不展示额外的学习闭环。
实际增量与“这不就是……”。 这不就是先减掉更新里大家共有的偏移吗?是,但减的是由采样分布与训练分布不一致造成的梯度偏移,而不是传统奖励 baseline。它以加法修正替代单纯依赖概率比相乘,也能与后者组合;代价是需要采样器的分布信息,而且没有自动恢复完整的 on-policy 更新。
证据与局限。 在人为权重偏移和强量化下,居中或与重要性修正的组合最稳定;在每 64 步才同步一次采样器的强陈旧条件下,组合效果更好。作者明确说,轻微失配下几种强方法在短训练中难分胜负,因此刻意放大失配作为压力测试。30B 主图报告的是训练准确率;不同方法的重复种子数也不一致。比较统一使用同一 REINFORCE 主体目标,只替换修正规则,因此不能把图中方法名理解成完整训练配方的优劣排名。
评测数据集与环境。 Countdown 用于 0.6B/1.7B 机制诊断,Figures 2/3 是保留题目的测试准确率,Figure 4 是训练平均奖励,独立题池规模未核实。INTELLECT-2 数学子集 用于 Qwen3-30B-A3B-Base 训练,Figure 1 的训练曲线不能称为泛化测试。0.6B 每批 64 题×8 条生成、30B 为 16 题×8 条生成;样本数与轨迹数分开。训练侧 bf16,采样侧量化或延迟同步;通常三种子的小模型实验与部分单种子的 30B 实验分开解释。
[!abstract]- Abstract 完整中文翻译 大语言模型的强化学习对训练引擎与推理引擎之间的细小差异十分敏感,这通常称为训练—推理失配。彻底消除失配并不现实,因为会显著损害 rollout 效率。本文表明,失配下强化学习不稳定的主要原因是漂移:训练与推理引擎之间持续存在的偏差,会随每个训练步骤累积。 我们推导出一个加性的 score centering 修正项,通过抵消漂移稳定训练。在 0.6B 到 30B 参数模型上,单独使用该方法,在量化条件下即可达到或超过基于重要性采样的方法,而且失配越严重,差距越明显。由于修正是加性的,它还能与重要性采样组合;在模型版本陈旧实验中,组合方法优于单独的重要性采样基线。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20807 v1。首次提交 2026-09-17 17:58:17 UTC,即北京时间 2026-09-18 01:58:17;核对 §2–5、Equations 3–7、Figures 1–5、Appendices A/B。方法无独立流程图;公式的精确抵消结论与 top-k 实现近似、训练与测试指标已分别说明。 原论文 v1。
LION:让不同偏好的更新少争用同一片参数
作者:Xinyu Lin;Zhuosong Jiang;Zixiao Suo;Siqin Wang;Hanqing Zeng;Hanchao Yu;Yinglong Xia;Jiang Zhang;Aashu Singh;Fei Liu;Wenjie Wang;Fuli Feng;Yang Song;Qifan Wang;Tat-Seng Chua。 机构:National University of Singapore;Meta AI(v1 第 1 页)。
任务背景。 推荐模型读过用户之前买过或浏览过的商品,接着生成下一件可能感兴趣的商品编号。新交互不断到来,模型也要不断更新。但活跃用户的常见行为出现得更多,少数人的兴趣变化可能在共同更新中被淹没。LION 要解决的是:怎样让不同偏好的学习少互相干扰。
核心方案。 LION 在 Transformer 中间插入一组可训练的键值记忆。输入历史先形成查询,只激活少量匹配的记忆槽,再把取出的向量加回隐藏表示。不同偏好若使用不同槽,其新增记忆参数的更新就较少直接相撞。这些槽是模型里的参数,不是存放文字案例的外部数据库;共享主干仍然会更新,所以隔离也不是绝对的。
训练除了在最终商品预测上计算误差,还在刚加入记忆的表示处增加一份预测监督,让记忆层更直接接收到学习信号。新一期交互到来后,主干与记忆参数一起微调,保存的新参数用于预测下一期。方案还结合较长历史形成记忆查询,让主要计算使用较短的近期窗口,试图兼顾历史信息与开销。
于是,循环中的变化是“新数据改变参数,参数影响下一期推荐”;路由形式、Top-K 选择和损失设计依然由研究者预先规定。稀疏激活给减少干扰提供了结构条件,是否真的学会分开不同模式,仍要看实际路由和群体表现,而不能只数可组合的槽位数量。
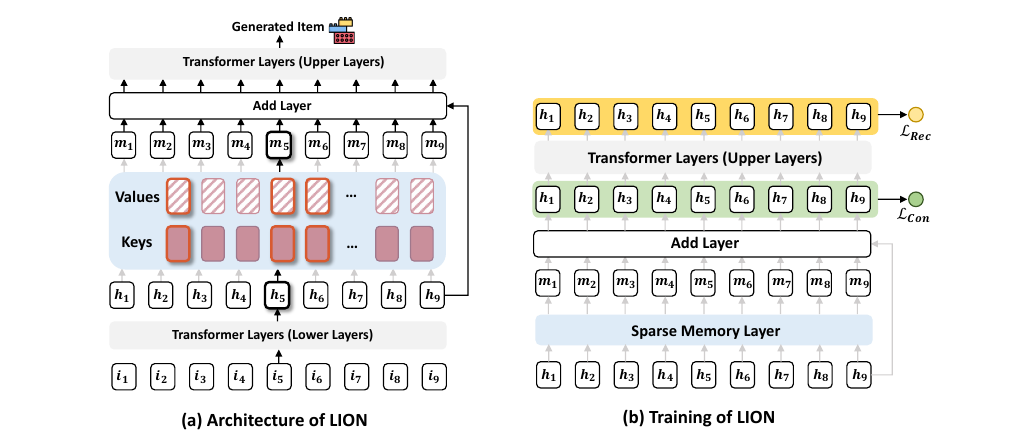 原论文 v1,Figure 3,PDF 第 5 页。
读图。 先从左图底部的商品序列向上看:下层 Transformer 产生表示,查询中间的 keys,只取被激活的 values;这些向量经 Add Layer 加回,再由上层生成商品。右图沿相同方向画训练:较低处的 consolidation loss 直接监督记忆增强后的表示,顶端 recommendation loss 监督最终输出。这两条是训练损失支路,不是两个 Agent,也不是两个先后执行的推荐过程。跨期继承由正文补充,图中没有画出完整时间循环。
实际增量与“这不就是……”。 这不就是给不同兴趣分配部分专用参数,再给中间层加监督吗?具体取舍是让用户共享一池可组合的稀疏槽,而不为每个人单独维护一套模型。它的价值要由少数偏好是否获益、成本是否可控来判断,不能仅凭“记忆”这个名称推断具备持续推理能力。
证据与局限。 Games 的 Recall@10 从 TIGER 的 0.0558 提高到 0.0724,绝对提高 1.66 个百分点,论文所写 29.8% 是相对增幅。LION 在主表多数指标上最好,但 Games 的 NDCG@10/20 低于 RecICL,不能概括成全面领先。实验只使用 T5/TIGER,默认更新全部参数,采用固定随机种子 42;对更大语言模型的外推、训练随机性和验证划分都还需要进一步证据。理论部分不能替代真实路由会自动完全分离的验证。
评测数据集与环境。 论文处理后的 Amazon Games 有 252,015 条交互、CDs 185,855、Toys 140,943,均按时间分五期;模型逐期更新后评估 P1–P4 的下一期推荐。每期再分五个活跃度组,主表按样本加权汇总,指标为 Recall/NDCG@10/20,生成 beam size 20。验证 loss 用于早停与超参选择;精确验证划分、数据处理 revision 未核实,不把这些交互数当成相互独立的用户数。
[!abstract]- Abstract 完整中文翻译 生成式推荐已成为一种有前景的端到端个性化推荐范式。然而,现实中的用户偏好会持续变化,使自我演化成为生成式推荐系统的重要能力。现有持续重训和蒸馏适应策略直接用流式交互更新共享模型参数,但将它们用于生成式推荐,会出现我们称为“演化冲突”的问题:不同用户异质的偏好变化,在完全共享的自回归参数空间中一起优化,主导行为模式逐渐占据更新过程,而代表不足的模式越来越容易被忽视。 为解决这一问题,我们提出生成式推荐的自演化记忆范式,希望有效适应不同的行为模式,并概括出隔离记忆、强化演化和可扩展应用三项原则。据此,我们设计了以稀疏键值记忆层为核心的 LION。稀疏记忆激活隔离不同模式的演化,巩固损失则加强持续适应中对少数偏好变化的学习。多种真实数据集上的大量实验,在逐期评测、用户与商品分组评测、演化收敛分析等设置中验证了 LION 的有效性。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15598 v1。首次提交 2026-09-14 14:00:38 UTC,即北京时间 2026-09-14 22:00:38;核对 §1–5/7、Figure 3、Tables 1/2/6、Appendix A。Figure 3 从原 PDF 同页裁出两部分;日期以已核实 v1 提交时间为准,不用封面 Date 字段覆盖。 原论文 v1。
EOS 失配:老师和学生都想结束,却使用了不同的结束符
作者:Yuxiao Yang;Tianrun Yu;Shangzhe Li;Kaixiang Zhao;Xuchao Zhang;Chetan Bansal;Huaxiu Yao;Taylor W. Killian;Weitong Zhang。 机构:University of North Carolina at Chapel Hill;Brigham Young University;Microsoft(v1 第 1 页)。
任务背景。 假设学生模型已经算出数学题答案,接下来本应结束,却不断重复答案,最后把生成预算耗尽。这里研究的训练方式是:学生自己生成,冻结教师对学生采到的每个词给出概率,学生再根据师生概率差更新。问题可能不在数学推理,而在两者怎样表达“现在停止”。
核心方案。 共享词表不代表共享停止偏好。学生可能习惯用一种结束符,经过后训练的教师则把停止概率集中在另一种上。当学生采到自己熟悉的结束符,教师给它低概率,蒸馏就会压低这个停止动作;教师偏好的那个符号又几乎不被学生采到,难以获得足够直接更新。结果是旧出口被抑制,新出口还没学会。
单纯把两个符号都加入解码器的停止列表,只能规定“如果生成它就结束”,不能改变训练给它的信号。论文提出的语义修正把当前生成协议下作用等价的结束符归成同一个停止动作:分别加总教师与学生对这组符号的概率,在采到结束符时用总停止概率比较和更新;普通词的处理不变。这样,监督的是要不要结束,而不是强迫学生先换用某个表面符号。
论文还比较把教师停止概率映射到学生熟悉符号,以及把采样与训练都统一成单一结束动作的变体。共同要点是让解码行为与优化对象一致。等价范围必须以具体模型对和生成协议为准,不能随意把原本表示不同交互边界的特殊符号全部合并。
方案图。 原文主要提供长度曲线、结束概率曲线和生成案例,未给出独立方案流程图,故不以成绩图替代。
读图。 若核对原文的结束概率曲线,要区分“某个结束符的概率”“所有等价结束符的概率和”与“最终自然结束的比例”。前两者是在学生到达的前缀上评分,第三个量还取决于整条生成过程;教师自己生成回答的长度又是另一种观察。它们不能互相替代,修正作用于训练信号,而不是在回答末尾另加一次后处理。
实际增量与“这不就是……”。 这不就是把两种“结束”当作同一个动作来教吗?难点是让采样、教师评分和梯度计算都尊重这个含义;只改停止列表做不到。论文同时展示,学会老师的结束符之后仍可能再次出现长度膨胀,因此该修正解决的是一个明确机制,而非所有蒸馏退化。
证据与局限。 Qwen3、Llama 3.2 和 Gemma 3 的实验都支持语义结束修正缓解失配引起的长度膨胀;Gemma 的师生原本就声明相同停止集合,仍有概率偏好差异。K2-Horizon 的阶段对照中,预训练学生能逐渐学到教师偏好的符号,却在训练后期再次膨胀,说明还存在其他机制。实验限于 sampled-token OPD,未实际比较完整词表版本;提示模板、评分器和输出预算也会改变准确率,不能只看长度变短就宣称推理更好。
评测数据集与环境。 训练使用 DAPO-Math-17K,主设置 200 步、每步 16 道提示×4 次生成;这些是训练规模口径。独立 checkpoint 评测使用 AMC 2023 40 题、AIME 2024 30 题、AIME 2025 30 题,各题采样 16 次,先求题目平均正确率,再对三个基准等权平均,属于 Avg@16。主训练回答上限 7,168 token,独立评测上限 8,192;还记录撞预算比例与末端停止概率。评测固定采样种子 0,不等于多种训练种子验证。
[!abstract]- Abstract 完整中文翻译 我们研究 on-policy 蒸馏中的长度膨胀:学生回答可能变得过长,甚至耗尽生成预算。我们发现,基础学生模型与后训练教师模型之间的终止 token 失配,是这一现象的重要来源。在 Qwen3、Llama 和 Gemma 中,即便两者声明的停止集合相同,它们也可能把停止概率放在不同的 EOS token 上。这种失配会压低学生偏好的终止动作,却无法可靠地传递教师偏好的替代动作。 我们表明,仅对齐解码停止集合并不足够;把功能等价的 EOS token 当作一个共同的语义停止动作,能在三个模型家族中明显缓解失配造成的长度膨胀。为进一步理解终止行为如何随训练变化,我们还考察 K2-Horizon 不同训练阶段的 OPD。阶段分析表明,停止偏好在训练中可能显著变化,也揭示了一种训练后期仍会出现、不能由终止对齐消除的长度膨胀。这些结果将终止失配识别为 OPD 长度变化的重要但不完备的解释。我们发布包含所提终止处理修正的实现。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20511 v1。首次提交 2026-09-17 14:53:39 UTC,即北京时间 2026-09-17 22:53:39;核对 §1–4、Table 1、Figures 1–7、Appendices A/B。机制依据 §3.2 的语义 EOS 类与其他三种处理对照;没有把实验曲线作为方法图。 原论文 v1。
BATON:先分配一条轨迹内的学习权重,再决定整条轨迹占多少
作者:Yingxuan Zhuang;Binhe Yu;Jingxiao Yang;Ruopei Sun;Ziting li;Cheng Tan;Xuhong Zhang;Jianwei Yin;Jintao Chen。 机构:Zhejiang University;University of Science and Technology of China;University of New South Wales;首页另列 Shanghai Artificial Intelligence Laboratory,但未见对应作者标号(v1 第 1 页)。
任务背景。 假设 Agent 要在文字环境里找到物品、清洗后放到指定位置。它连续执行多个动作,环境不断返回新观察,最后才知道任务是否完成。训练时有两个不同问题:同一次尝试里,哪些动作更值得学习;一批尝试里,哪条轨迹占的训练分量更大。如果直接把所有生成词混在一起取平均,绕了很多弯的长轨迹会自然占更多份额。
核心方案。 对已经执行的一步,BATON 另外采一个候选动作,但不真的放进环境执行。随后用旧策略分别判断:如果刚才采取原动作或候选动作,实际观察到的这段环境反馈各有多大可能出现。原动作越能解释这段反馈,就获得越高的相对权重。这个比较只在模型里评分,因此没有额外环境交互,也不能当作真实反事实实验。
得到权重后,系统先按反馈长度校准,再在每条轨迹内部归一化,把既定训练分量重新分给不同动作。原有 GRPO 或 GiGPO 仍决定该鼓励还是抑制;BATON 的正权重只调节力度,不另造一个正负奖励。接着,系统先求每条完整轨迹的加权平均损失,再对轨迹等权平均,避免长轨迹只因词多而占更大标量份额。
这两步因此可以拆开检查:一步改轨迹内部的分配,一步改轨迹之间的占比。训练保存更新后的策略,用它采下一批尝试;反馈评分、归一化和基础优化方法并不会自行演化。它是改进学习过程的固定算法,不是让 Agent 自己改写训练器。
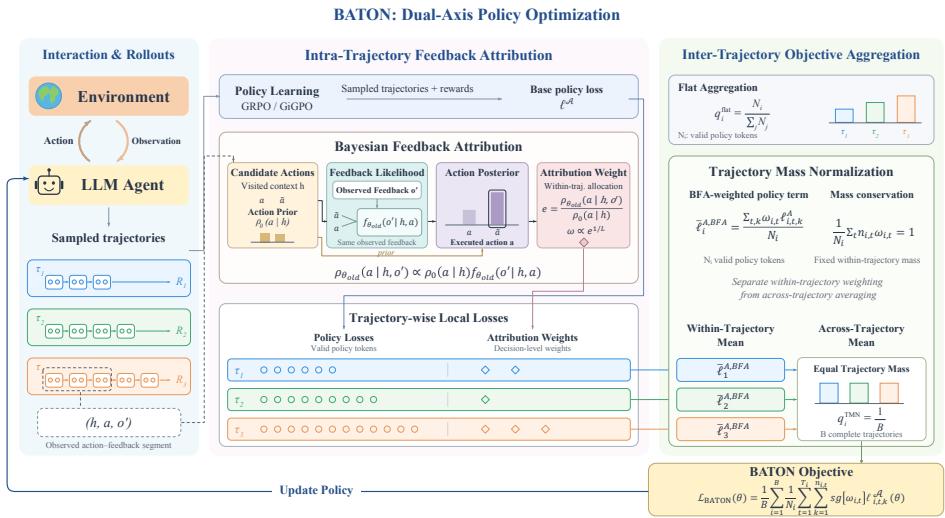 原论文 v1,Figure 2,PDF 第 4 页。
读图。 从最左侧 Agent 与环境的往返开始,下面得到几条长短不同的轨迹。中间的分支把已执行动作和另一个候选放到同一段真实反馈前评分,产生轨迹内部权重;上方基础学习器保留原来的奖励与更新方向。沿下方彩色轨迹向右,先在各自内部取平均,再在轨迹之间等权聚合。最底部返回 Agent 的箭头表示参数更新;候选动作没有返回环境的箭头,正好提醒这里比较的是模型相容性。
实际增量与“这不就是……”。 这不就是先决定一条经验里重点学哪几步,再避免长经验压过短经验吗?值得保留的是两个层级被明确分开,并通过归一化让前者不偷偷改变后者。所谓等权指目标函数的标量份额,实际梯度仍受动作内容、优势和模型敏感度影响。
证据与局限。 在 Qwen2.5-1.5B 的 ALFWorld 上,GRPO 从 72.9% 提高到 85.6%;只加反馈归因为 84.1%,只做轨迹等权为 82.4%,两者组合最好。对应训练墙钟时间从 18.05 增至 21.07 小时,约 1.17 倍;GiGPO 的组合约为 1.10 倍,不能因为没有新增环境交互就说没有额外成本。较短的评测轨迹伴随更高成功率,但不证明所有长轨迹都无用。检索 QA 的平均收益较小,且各域不完全同向;实际子集与复现设置披露不足,不能把均值当成跨环境普遍规律。
评测数据集与环境。 ALFWorld 报告六类任务及总体成功率;WebShop 区分任务得分与成功率。检索 QA 实际包括 Natural Questions、TriviaQA、PopQA、HotpotQA、2WikiMultihopQA、MuSiQue、Bamboogle,按 exact match 再求七域等权平均;摘要的 SearchQA 在这里是检索问答设置,不能额外算成一个同名标准数据集。论文未给出足够清楚的实际评测题数、release、检索配置与训练/测试划分,本日报保留缺口。表格为均值与标准差,不能自行补出种子数。
[!abstract]- Abstract 完整中文翻译 面向大语言模型 Agent 的强化学习包含两个不同优化维度:怎样在一条轨迹内部利用环境反馈,以及怎样在一个 batch 中聚合完整轨迹。我们将它们分别表述为轨迹内反馈归因和轨迹间目标聚合,并提出双轴策略优化框架 BATON。第一个维度使用贝叶斯反馈归因,为采样动作构造以反馈为条件的后验;第二个维度使用轨迹训练分量归一化,让完整轨迹拥有相同的优化份额。在 ALFWorld、WebShop 和检索问答上的 GRPO、GiGPO 实验表明,两个维度各自都能带来改善,组合后在不同模型规模上持续取得最强的整体表现。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.19830 v1。首次提交 2026-09-17 07:35:02 UTC,即北京时间 2026-09-17 15:35:02;核对 Introduction、§2–4、Figure 2、Tables 1–5、Appendices A–C。封面日期与 v1 提交日期分别处理;BFA 的模型相容性不写成真实反事实因果贡献。 原论文 v1。
EPIG-Tree:把额外尝试花在最能澄清学习方向的地方
作者:Nikita Khomich;Leopold Hermansson;Ido Hakimi。 机构:原文未署机构(v1 第 1 页)。
任务背景。 假设 Agent 正在猜词,某一步有几个候选单词。训练预算只够再试几次:应该换一个猜法,还是保持这次猜法不变,多观察几次后续会怎样?只在模型最犹豫的位置分叉,未必划算——它可能只是在几个对最终奖励没有区别的表达之间犹豫。
核心方案。 系统先按当前策略跑少量完整轨迹,保存中间状态或生成前缀,再找可分叉的位置。熵可以帮助提出候选,但最终排序还看:不同动作可能导致多大收益差异,这些差异会怎样影响参数更新,以及再试一次要花多少计算。额外预算优先给最能降低学习方向不确定性的位置,而不是仅给可选词最多的位置。
如果已经选定一个动作,后续结果仍很不稳定,就从该动作之后多跑几条接续轨迹,区分偶然成败与稳定效果。于是树有两种扩展:横向增加动作选择,纵向重复接续。得到更多叶子结果后,系统估计局部价值差,把相应优势用于造成分支的动作 token,再更新策略。下一批继续用新策略采样;分配规则本身没有被模型重新发明。
这套方法要求先导样本能看出有意义的收益差。如果奖励太稀疏,几次尝试全都一样失败,就难以据此判断该往哪里投入;动作空间很小时,均匀尝试也可能已经足够。即使分支选得好,优势若错误地施加在无关 token 上,训练仍然会失败。
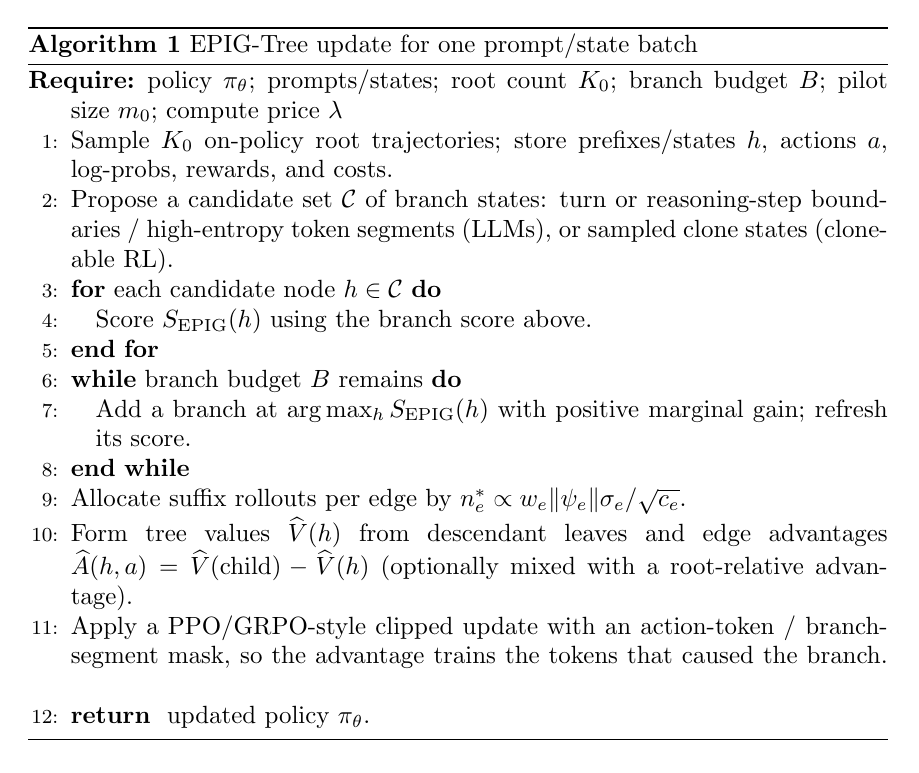 原论文 v1,Algorithm 1,PDF 第 8 页。
读图。 原文没有独立流程示意图,这里附的是第 8 页的原算法块。按行号读即可:1–2 行保存根轨迹并提出候选,3–8 行为候选评分、在剩余预算内逐次分叉;第 9 行才给已选动作分配重复接续。第 10 行从叶子结果形成局部优势,第 11 行把优势作用到对应动作或分支片段,最后返回更新后的策略。这里的 while 是一次采样预算内的循环,不是改进程序的跨代自我修改。
实际增量与“这不就是……”。 这不就是把模拟次数花在更能判断“该怎么学”的分叉上吗?新增之处是把动作差异和后续噪声拆开,并同时考虑梯度影响与成本。它优化的是估计训练方向所需的实验分配,不等同于推理时寻找一条最好答案的普通搜索树。
证据与局限。 十三个可克隆控制环境中,九个密集连续控制环境的梯度估计误差更低;小动作空间和稀疏奖励构成例外。在冻结 GSM8K 诊断中,EPIG 比熵分支更对齐参考梯度,但 flat GRPO 对其同类参考的对齐反而最好,不能说树方法全面胜出。Wordle 在线实验最终胜率为 0.850,对照 flat GRPO 为 0.790、熵分支为 0.825,只有两个种子。单轮数学的分支位置差异落在单种子噪声内;修正 loss mask 的影响更大。作者建议的更严格等预算、至少三种子复现尚不能当作已经完成的证据。
评测数据集与环境。 可克隆控制协议:13 环境、预算 8 个接续,与每动作 32 个接续的参考比梯度 MSE/余弦;独立状态数待核。GSM8K 冻结校准用 64 题、三种子、64 叶子参考,不是在线训练成绩。GSM8K-hard/MATH-small 单轮设置 的实际子集与题数不明确,保留论文限定身份。Wordle 协议 分冻结价值校准与在线 300 次更新;四方法×两种子,词集规模与独立测试划分待核,不把更新次数当成任务数。
[!abstract]- Abstract 完整中文翻译 以 GRPO 为代表的基于奖励的语言模型强化学习,把一整条随机轨迹压缩成一个标量奖励。这样做简单、可扩展,却不能高效探索和分配信用:一条轨迹可能包含多个关键决策、纠错尝试和环境随机事件,但每个 token 或动作继承的都是同一个轨迹级优势。 我们把树状 rollout 的构造视为策略梯度估计中的计算分配问题。核心主张是:分支不应仅放在策略犹豫的位置,而应放在综合计算成本后,额外分支最能减少策略梯度不确定性的位置。通过局部策略梯度随机变量的全方差分解,我们推导两条分配规律:新分支降低决策不确定性,重复接续降低后续结果不确定性。EPIG-Tree 利用已经计算的 rollout 分配分支,估计由到达权重和梯度 score 加权的价值不确定性;每条边的接续数量与其权重、对数策略梯度范数及后续标准差的乘积成正比,与成本平方根成反比。 实验中,EPIG 在可克隆状态控制的梯度 MSE 上取得改善,在十三环境扫描中的九个密集连续控制环境全部胜出,几乎完全恢复参考梯度方向,也比简单熵分支更好地校准冻结语言模型梯度。在线单轮数学中,树内局部信用优于平坦 GRPO,但分支位置不如 token 级信用分配重要。在线多轮 Wordle 中,EPIG 最终胜率最高,为 0.850,超过早早饱和于 0.790 的 flat GRPO,并随训练推进超过熵分支,表明梯度估计优势可以迁移到有状态、大动作空间设置。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20004 v1。首次提交 2026-09-17 10:08:48 UTC,即北京时间 2026-09-17 18:08:48;核对 §1、§3–10、Algorithm 1、Figures 1–8 与附录 Experiment details/Recommended replication protocol。算法块为原 PDF 截取;没有将建议复现实验写成已完成实验。 原论文 v1。
MATCH:工具选错就不奖励参数,同时让练习难度跟着模型变化
作者:Shihao Liu;Hao Yin;Lijun Liu;Zhengzong Chen;Yuanyuan Zhao;Fei Huang。 机构:University of the Chinese Academy of Sciences(含 School of Cyber Security);Honor Device Co., Ltd(v1 第 1 页)。
任务背景。 例如,用户要查巴黎明天的天气,模型拿到一组工具名称、说明和参数格式,需要选对工具,并填对地点与日期。训练既要决定练哪些题,也要判断调用错在什么地方。如果选错了工具,却因为碰巧写对两个参数拿到奖励,模型就会收到误导;如果练习难度一直按初始能力划分,模型进步后也可能反复做已经太简单的题。
核心方案。 MATCH 先让初始模型尝试训练题,用工具调用与参考答案的完全匹配率估计初始难度。每轮从当前平均难度附近选一批题,再加入一部分更难的题。模型做完后,根据实际奖励刷新这批题的难度,供下一轮重新选样;没有被选中的题暂时保留旧估计,因此并不是每轮都重新测完全部题目。
评分时,它先检查工具名,再检查参数键,最后检查参数值。只有前面的条件成立,后面的正确性才加分。例如工具选错,工具正确性部分就不因参数碰巧相同而给分;格式仍有单独的小权重辅助奖励。多调用输出按参考调用匹配,未匹配的额外调用没有正分,也没有额外惩罚,所以这一规则还不能保证调用最少或执行安全。
同一批奖励一方面用于标准 GRPO 更新模型参数,另一方面用于更新样本难度。新的模型能力与新的难度估计共同决定下一轮练习,形成闭环。这里的主要监督来自与参考工具调用的结构化比较,不能把它一概理解成真实工具执行后获得的任务成功反馈;训练还把多步轨迹拆成带历史上下文的单步实例。
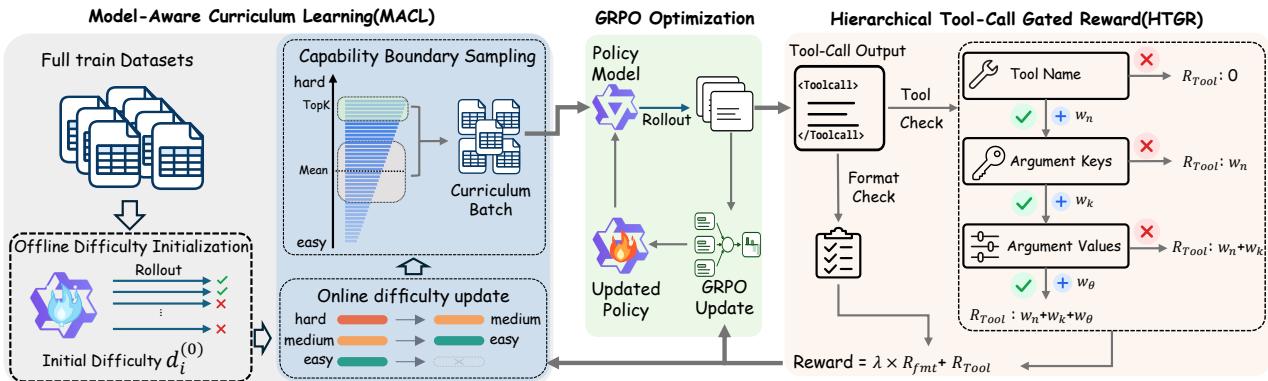 原论文 v1,Figure 3,PDF 第 4 页。
读图。 从左侧题库向下做一次初始难度评估,再向右上方选择课程 batch,送入中央模型生成调用。最右侧从工具名往下逐级检查,红叉表示停止继续累计工具分,旁边另有格式检查支路。底部奖励箭头分成两路:一路进入中央 GRPO 更新参数,另一路回到左侧刷新难度。下一轮使用更新后的模型和难度,但图中的评分门槛与选样规则保持固定。
实际增量与“这不就是……”。 这不就是练习题随水平调整,判分又要求先选对工具再谈参数吗?实际改进在于两件事使用同一份反馈协调起来,并用前提条件约束部分得分,减少奖励与任务语义脱节。不过奖励设计仍需要外部参考,也可能留下额外调用不受罚等边界。
证据与局限。 Qwen2.5-7B 的 API-Bank 总准确率为 72.19%,比 ToolSample 高 7.20 个百分点;BFCL V3 为 62.87%,高 2.62 点。API-Bank 去掉课程调度降到 66.67%,改用二元奖励降到 64.82%,支持两个组件都有贡献。但有些子项只是持平,跨模型增幅也不同;训练/验证版本、重复种子及实际测试题数未充分核实。按模型表现更新的难度不等于客观任务难度,未选题的旧估计也可能造成后续采样盲点。
评测数据集与环境。 API-Bank 分 L1/L2/L3 和总体;BFCL V3 分 Non-Live AST、Live、多轮、相关/无关检测,均报告 accuracy。论文训练集是 4,000 条:ToolACE 2,000、Hammer 1,000、xLAM 1,000;多步材料拆成带历史的单步实例,不能把 4,000 当作测试题数。主训练 15 epochs、每题 4 次生成,实际评测 release、样本数量和独立验证划分待核;不得套用 BFCL V4 或其他版本的规模。
[!abstract]- Abstract 完整中文翻译 工具学习让大语言模型能够通过外部工具完成超出参数知识的任务。强化学习可以利用反馈优化工具调用,但现有方法仍有两个问题:固定阈值的课程可能偏离不断变化的能力边界,而相加式奖励会在工具选错时仍泄漏参数层面的信用。 为此,我们提出结合模型感知课程调度与分层门控奖励的闭环框架 MATCH。模型感知课程学习维护由奖励估计、随策略共同变化的样本难度,每轮选择当前能力边界附近的样本,以及一组更难的 top-k 样本。分层工具调用门控奖励按工具名、参数键、参数值逐级评分,只有先决条件满足才授予下一层信用。同一份奖励同时驱动 GRPO 更新和难度刷新,从而连接策略优化与样本调度。 在 API-Bank 与 BFCL V3 上,MATCH 的总体准确率达到 72.19% 和 62.87%,优于主要监督学习与强化学习基线。跨骨干实验还在两个模型家族的四个骨干上展示了持续改善。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.20082 v1。首次提交 2026-09-17 11:40:26 UTC,即北京时间 2026-09-17 19:40:26;核对 Introduction、Method、Experiments、Figure 3、Tables 1–5。明确初始完全匹配难度与后续分级奖励难度的区别,保留未选题不刷新、额外调用无附加惩罚等实现边界。 原论文 v1。