SelfOp:先分清失败来自哪里,再决定怎样修改技能
作者:Saad Ullah、Yigitcan Kaya、Christopher Kruegel、Giovanni Vigna、Gianluca Stringhini。
机构:Boston University(ECE Department);University of California, Santa Barbara(CS Department)(v1 第 1 页)。
任务背景。 一个代码 Agent 拿到已公开漏洞的描述和未修复代码,要在给定环境里交出能触发指定故障的测试输入。执行器会判定有没有真正复现目标漏洞;找到相似测试、输出看似合理的文件,都不等于成功。这里关心的学习问题是:一批任务做完以后,怎样修改下一批任务会读取的技能说明,减少重复犯错?
失败有时来自指导缺失,有时来自已有正确指导没有被遵守。若优化器只看“这题失败了”,就可能不断补写新规则,甚至改掉原本有效的做法。
核心方案。 SelfOp 先冻结模型和运行框架,只允许修改技能说明及其参考文档。每个任务结束后,它先根据执行判据拆开失败结果,再结合轨迹和漏洞元数据分析行为哪里不对。分析行为的这一层暂时看不到当前技能,目的在于先形成独立判断;最后才对照技能文件,找出哪些指令缺失、含糊或被错误执行。论文把这条分层诊断称作“文本梯度”,它是自然语言反馈,不能按可微计算中的真实梯度理解。
单题诊断还不能直接变成全局规则。系统把一批任务中相近的建议合并,同时保留成功轨迹揭示的有效做法,再根据支持数量和结果关联筛选修改方向。对于确实没有覆盖的问题,可以新增内容;对于已经写明却执行不好的要求,则优先强化或改写原句。通过格式检查的文件成为下一批任务的上下文,修订历史也会保留。
当连续几步剩下的“新问题”已经接近噪声,系统停止修改。这里要区分两个阶段:正式优化运行时不再执行留出验证来选停点,但噪声阈值是在此前十次带验证评分的运行中估计的,窗口长度也经过经验选择。因此,它减少的是每轮验证成本,并未证明可以完全取消方法开发阶段的验证依据。
实际增量。 把反馈生成、跨实例聚合、修改幅度和停机放进同一个流程,并明确区分“技能缺知识”和“Agent 没遵守已有知识”。改进保存在文本技能里;生成反馈、筛选和停机的外层算法保持固定。
这不就是……让 Agent 复盘后重写提示词吗? 起点确实相似,新增机制在于不直接从失败跳到改写:先隔离技能影响诊断行为,再用跨任务证据保护已有优点,并为“新增”与“强化”分配不同改动方式。
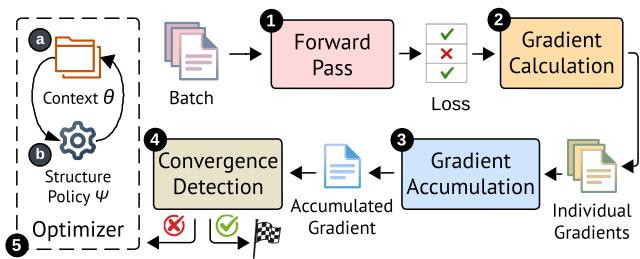 原论文 v1,Figure 2,PDF 第 6 页。
读图。 从上方粉色 Forward Pass 开始:当前技能带着一批任务运行,产生右侧的成败反馈。反馈进入黄色诊断块,得到多份单题建议,再沿右下箭头汇入蓝色聚合块。聚合报告向左进入停机判断;还值得修改时,左侧优化器按固定的结构约束更新 Context,再回到下一批执行。左边的结构约束不是新学出的模型参数,图中的循环也不表示收益会一直增长。
证据与局限。 主结果中 GPT-5.4-mini 的测试成功率由 38% 到 55%,GPT-5.4 由 49% 到 67.5%;技能互换也能产生收益。细看 80 题测试,停机规则选中的第 8 步为 55%,验证集选出的第 11 步约 51%,事后用测试集挑出的峰值 56.2% 只是不可用于选模的上界。论文报告同一 checkpoint 三次评估可波动 2–3 个百分点;batch 从 16 增到 32 后表现反而下降,说明聚合会受任务异质性影响。它没有验证改进器自行改写自身算法,也没有证明在未知领域持续多轮增长。
评测数据集与环境。 CyberGym:原规模 1,507 个实例,本篇训练池 224、验证 40、最终测试 80;主要选中点只消费了 128 个训练实例。指标为限时 30 分钟的 pass@1。验证集、阈值校准和最终测试的角色不同,三次重复运行不能计作 240 个独立测试任务(v1 §3.1、§3.4、§4)。
[!abstract]- Abstract 完整中文翻译 LLM Agent 正越来越多地用于漏洞发现、漏洞复现和补丁生成等安全任务。近期工作通过增强底层模型、运行框架或输入的任务上下文来改善它们。然而,模型层面的提升通常需要大量有监督数据,例如专家示范或教师 Agent 轨迹,或者具有可计算强化学习奖励的多样化环境。安全任务中这些资源很稀缺:成功轨迹获取昂贵,失败难以诊断,奖励也常常稀疏、延迟或无法计算。因此,许多工作转而优化运行框架或上下文。人工优化需要专门领域知识,难以扩展;自动方法又常依赖稀缺真值、更强的优化模型,或缺乏方向的“提出—评估”循环,使优化沦为不可靠且昂贵的试错。 我们提出 SelfOp,一种自动优化冻结安全 Agent 的任务上下文的算法,可修改指令、技能和参考文档,而不改动运行框架与模型权重。SelfOp 将上下文优化组织为受链式法则启发的文本梯度下降。从单个任务的结果信号出发,错误信息依次经过评估器、Agent 轨迹和影响其行为的上下文文件向后传播,形成每个实例的文本梯度。随后,SelfOp 通过聚类、排序和过滤跨实例累积这些梯度,只在得到跨实例共识时提交更新。收敛检测器监测梯度信号本身,当上下文已经吸收训练数据中可泛化的信息时停止优化,无需留出验证数据。我们在真实漏洞复现基准 CyberGym 上评估 SelfOp。使用不到 200 个训练样例,它让采用 Codex 的 GPT-5.4-mini 自我提升 17 个百分点,比前沿 GPT-5.4 基线高 6 个百分点;GPT-5.4 本身也提升 18.5 个百分点。所得技能还能跨模型迁移,说明优化出的技能学到了可泛化的任务知识,而非模型特定模式。总体上,SelfOp 使 Agent 能通过上下文优化系统地改善自身,并优于已有上下文优化基线。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.22792 v1;首次提交 2026-09-19 05:51:27 UTC,即北京时间 2026-09-19 13:51:27。本文翻译采用 PDF 首页摘要;摘要“不需要留出验证”的说法须结合正文阈值校准口径理解。方法 §3、Figure 2–3;实验 §3.1–3.4,局限 §4。 原论文 v1。
EvoPathBench:把生成好改进与选中好改进分开评测
作者:Hongqiang Lin、Chao Liu、Xiaofan Bai、Xuan Jin、Yuhong Li、Nenggan Zheng、Xipeng Cao。
机构:Zhejiang University;Alibaba Group(v1 第 1 页)。
任务背景。 Agent 在一个可控市场中读取行情与自身状态,决定提交什么订单,也可以不交易;环境按统一规则执行并给出结果。每次任务结束,它可以修改下一次会读取的记忆或技能。作者刻意安排不同顺序的经历:先连续学习同一种规律,或学会以后插入无关任务,或让此前有效的规律发生反转。
这些安排要解决一个普通排行榜看不到的问题:最后总分上涨,可能只是新任务进步盖住了旧能力退化;写出了更好的技能,也可能因为验收错误而没有真正保存下来。
核心方案。 EvoPathBench 在每次更新前后保存技能或记忆的快照,复制一份到独立测试中,始终追踪同一项能力。测试时既不更新副本,也不把测试结果交给学习流程。这样,某项能力从无到有、被无关学习破坏、或在规则变化后迟迟不修正,都能沿时间顺序看出来。
仅比较前后分数仍可能把执行随机性算成学习收益。因此,它同时运行不更新的基线,并在测试时增加“暂时不给 Agent 读取已学文件”的对照。前者帮助判断整个演化流程是否有收益,后者检查收益是否真的依赖持久化内容。保持能力还要检查少数严重退化的路径,不能只看平均损失。
作者进一步在候选生成和保存之间设置受控对照:在选择决定已经完成后,再用从未参与选择的任务评估所有候选以及旧版本。由此分开看“本来生成了多好的候选”和“最终保存了多好的候选”。这些事后测试用于诊断选择器,绝不作为在线更新的免费真值。
实际增量。 它把能力形成、保持和规则修正做成三种可对照的任务流,并直接测候选潜力与已提交修改之间的缺口。这里的贡献是评测协议与失败证据,不是新的递归改进算法。
这不就是……每隔几轮测一次分吗? 多测几次只是前提;关键还要固定被测能力、隔离测试反馈、比较禁用记忆的结果,并把没有被选中的候选也纳入事后诊断。否则无法判断失败来自学习、遗忘,还是选择环节。
读图。 原文没有适合承担核心方法解释的流程图:Figure 1 是技能长度与成绩曲线,Figure 2 是任务流构成图,因此这里不把它们充作方案图。理解协议可以沿同一条路径读:完成一个学习任务 → 修改并保存文件 → 冻结副本测隐藏任务 → 原学习流程继续;测试结果停留在评估端,不能沿返回箭头变成下一轮的学习材料。
证据与局限。 从生成一个候选增加到四个候选,事后最好候选的收益上升,但选择差距也扩大;在该受控干预中,迁移收益反而下降。另一个配对实验里,加入保守验收后,有害提交由 12.4% 降到 6.2%,却也漏掉更多有益候选,验证与隐藏测试的判断一致率从 56.9% 到 55.8%,并未提高。因而“少出错”可能只是少提交,不能等同于“更会判断”。各方法的规则修正效果经过多重比较校正后均无可靠显著优势。所有结论受五轮长度、受控任务族和底模限制,论文没有证明某一选择规则已解决这个瓶颈。
评测数据集与环境。 EvoPathBench:自建环境发布 1,800 条流,三模板、六任务族、两市场层;每流五次更新、六快照,学习与隐藏测试隔离。指标分为泛化增益、禁用 artifact 的效果、平均/尾部保持损失和规则修正收益;候选选择使用学习侧验证,隐藏测试负责最终诊断。原文未单列全部 probe 数及主表独立重复数,保留待核(v1 §3–4、App. A–C)。
[!abstract]- Abstract 完整中文翻译 自演化 Agent 将交互反馈转成持久化内容,例如记忆或技能,再用这些内容指导后续决策。随着这些内容在经验流中反复更新,它们支持的能力也会变化。因此,仅看最终表现不足以完整描述自演化过程。过程层面的评估十分必要:它能识别某项能力何时出现,以及后续更新是在增强、保留还是削弱它。为此,我们提出 EvoPathBench,用于跟踪持久化内容层面自演化中的单项能力。EvoPathBench 固定基础模型和工具,在连续检查点冻结演化内容,并在留出的任务回合中评估目标能力。基准使用公开交易数据和校准轨迹,检验三种能力:对未见任务的泛化、经历无关学习后的保持,以及面对新证据时的规则适应。实验表明,在相似未见任务上的收益常在分布变化下减弱;保持损失集中在少数演化路径上;没有一种方法实现可靠的规则适应。此外,自演化虽然能生成在留出任务上有明显收益的候选内容,实际选中的更新却始终未能充分兑现这种潜力。这些发现将能力层面的过程评估确立为分析自演化的基础,并指出候选评估与选择是需要改进的关键环节。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.24663 v1;首次提交 2026-09-21 14:28:06 UTC,即北京时间 2026-09-21 22:28:06。方法 §3,主结果 Tables 2–5,App. A/B 的任务与隔离协议,App. C 的顺序和随机性审计。封面 Date 为 9 月 22 日;这里保留 arXiv v1 的真实首次提交时间。 原论文 v1。
TTSE:把环境事实与操作经验分开更新
作者:Ruimin Pei、Yongkang Wu、Shangyi Zheng、Yaqing Zhang、Deyang Li、Jianjun Tao、Xinyu Zhang、Xiang Zhang。
机构:Poisson Lab, Huawei(v1 第 1 页)。
任务背景。 例如在文字化家务环境中,Agent 要按要求寻找物品、打开容器、清洗或搬动物品,直到环境确认目标完成。“柜门关着时看不到里面的物体”描述环境,“需要多件物品时放好第一件后继续找”才是操作建议。把两者混在一份经验里,一旦任务条件改变,系统很难分清究竟是事实失效,还是做法的适用范围太宽。
核心方案。 TTSE 将两种内容存成独立规则库:环境事实称为 FACT,带条件的操作方法称为 TIP。第一批任务没有旧规则,Agent 先执行,再从成功与失败轨迹中提炼初始经验。以后每批执行前读入当前规则,结果产生后再更新,因此今天学到的内容确实能影响下一批任务,而不只是本题重试。
更新先处理失败:找出误导了行为的已注入规则,将其移入带原因和时间的退役池。随后检查互相矛盾的旧规则,尝试找出被省略的适用条件,合成为“在什么情况下采取什么动作”。最后才比较本批成功和失败轨迹,对规则做局部新增、修改、确认或删除,保留没有出问题的知识。检索部署时,两类规则分别进入环境说明和操作提示文件,供后续执行使用。
这里的“事实”仍是从证据归纳出的规则,需要持续核验,并不天然可靠。遇到分类不确定的内容,方法默认放入 TIP;理论把错误拆成环境信息不足与条件下操作不佳,但不意味着所有单库系统都做不到同样区分。
实际增量。 把两种错误来源落实到独立的编号、证据记录和淘汰过程;矛盾不只触发删除,也可以成为发现隐藏适用条件的线索。模型、外层归纳流程与评估规则保持固定,属于持久经验更新。
这不就是……给记忆加两个分类标签吗? 如果只是贴标签,增量很小;这里让分类影响后续怎样注入、怎样追责、怎样保留证据,以及怎样把矛盾改写成条件规则。双轨的价值应看与同预算单轨的比较,而不是与完全没有经验的基线相比。
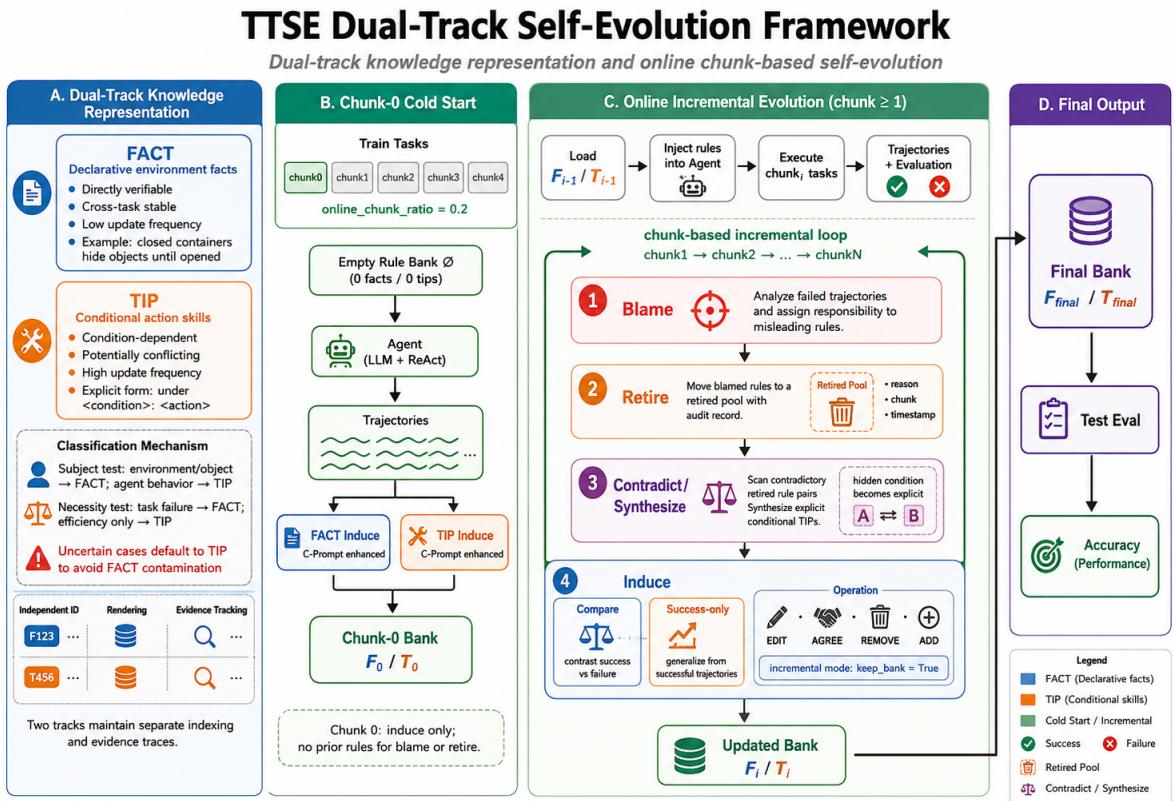 原论文 v1,Figure 1,PDF 第 4 页。
读图。 从中左的 B 区开始:空规则库对应冷启动,第一批执行轨迹分流形成 FACT 和 TIP。再看 C 区上方,下一批先加载已有两库,再执行任务并收集成败;下方依次做追责、退役、矛盾合成和归纳,绿色返回线把更新后的规则送回下一批。右侧是训练结束后的规则库与测试;PinchBench 的逐组在线评估是正文另述的部署协议,不能把图右侧 Test Eval 套成它也有独立测试集。
证据与局限。 在 SOPBench 的 892 个任务上,固定 Bayesian 生命周期后,双轨比统一单轨提高 2.99 个百分点;摘要强调的约 15.4 点是对无学习基线,不能全归因于分类。仓库领域贡献约 78% 的总收益,危险品领域略有下降。GDPevo 中 full 比 TIP-only 高约 2.4 点,但未检验显著性。PinchBench 均分由 0.7439 到 0.7822,验证了在线经验注入的实用性;它没有独立留出集,不能拿来证明未见任务泛化。论文展示的是有限训练与任务流收益,未证明无界持续增益。
评测数据集与环境。 GDPevo 用于四条件消融,12 任务组,实际题数待核;SOPBench 使用五域 892 题,每条件三次评估,报告 micro 成功率与配对检验。ALFWorld 为 500 训练、134 valid-unseen 测试,五批更新,报告成功率/动作步数;ScienceWorld 涵盖 30 类型、各三评估,报告奖励与原生成功率,实际实例数待核。PinchBench 固定 v2.0.0 / 819384ae,147 题分 15 组在线更新,每配置三运行,独立 judge 连续评分;没有固定 train/test 划分(v1 §5、Tables 2–7、App. B/D)。
[!abstract]- Abstract 完整中文翻译 随着大语言模型 Agent 被应用于持续交互环境,推动其自身能力演化成为实现长期自主性的核心问题。当前,环境知识通常被视为外部固定输入,而不是 Agent 持续演化的一部分;强化学习虽然通过环境交互优化策略,却往往只适应固定任务分布或单一环境。本文提出双轨在线自演化框架 TTSE,将演化知识分为 FACT,即可靠性由交互证据持续验证的环境事实,以及 TIP,即以任务条件为前提的执行过程。从决策理论出发,我们将 Agent 的额外风险分解为环境表示遗憾与条件执行遗憾,刻画了按环境条件决策严格优于忽略条件决策的条件,并用 FACT 识别错误和跨条件错配代价界定下游风险。在实践中,GDPevo 消融验证了双轨演化的优势;在 ALFWorld 和 ScienceWorld 上,TTSE 进一步表现出更好的任务适应能力。此外,TTSE 可兼容已有技能自演化方法:结合 Bayesian-Agent 后,单轨消融验证了双轨优势,并在 SOPBench 五大领域的三次独立重复实验中显著提高汇总分数。最后,在真实端到端任务基准 PinchBench 上,TTSE 通过检索注入集成到通用 Agent 框架中,并在三次独立运行中稳定优于基线。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.24289 v1;首次提交 2026-09-21 08:47:16 UTC,即北京时间 2026-09-21 16:47:16。方法 §3–4、Figure 1;实验 §5、Tables 2–7;SOPBench 配对统计 App. C;PinchBench 的软件版本与无留出协议见 App. D。PDF 标题带 for LLM Agents,元数据标题未带,身份为同一 v1。 原论文 v1。
Harness-Zero:把外部执行规则变成模型自己会做的动作
作者:Haoran Ye、Yuxing Lu、Haonan Dong、Zhaochen Su、Guojie Song。
机构:Peking University(State Key Laboratory of General Artificial Intelligence / School of Intelligence Science and Technology;College of Future Technology);Google;The Hong Kong University of Science and Technology(v1 第 1 页)。
任务背景。 假设用户让 Agent 修改一份表格,并要求已有内容不被误改。专门的运行框架可以提醒它先检查结构、保存后重新读取文件,再确认输出是否正确;把这些规则撤掉,原模型未必还会自发执行。论文要解决的是:能不能先借用外部规则教会模型,再让它在一个固定、简洁的工具环境里保留这些行为?
直接模仿原框架的成功轨迹会遇到障碍:原框架可能有学生部署时没有的工具,也可能私下替学生做了检查。学生看见结果,却学不到如何用自己的动作重现过程。
核心方案。 Harness-Zero 先用训练任务改进专门的执行规则,再把它们转换成一位审阅 Agent 的参考材料。学生始终使用部署时的固定框架,提出动作后先不执行;审阅者结合当前可见轨迹和参考规则,决定原样放行,还是给出一个完整的替代动作。替代动作必须用学生可调用的工具表达,不能把隐藏的正确答案或环境状态直接塞进去。
例如学生准备提前宣布完成,审阅者可以把它改成“重新读取保存文件并检查”的操作。这个操作会真正经过学生的执行框架,结果也进入学生轨迹,因此纠正不仅改变最终答案,还补齐了学生能够观察和学习的中间过程。审阅者自己的讨论则留在私有上下文里。
最后,对保留下来的已执行轨迹做监督微调,让模型学会这些检查和操作习惯。部署时撤掉专门框架、参考材料和审阅 Agent,只留下训练后的模型及原本固定的工具接口。实验中的参数更新是 LoRA SFT;它完成了外部规则向模型行为的一次迁移,没有展示模型更新后再次搜索框架的长期循环。
实际增量。 蒸馏对象是外部系统诱导出的行为,关键桥梁是“在动作执行前,把规则翻译成学生能完成的局部纠正”。它处理了来源框架与目标框架动作空间、信息可见性不一致的问题。
这不就是……让强模型改答案后再 SFT 吗? 差别在纠正必须接住学生当前轨迹,并使用部署时真的存在的动作。实验也专门比较了直接教师轨迹和给审阅者真答案:训练数据看起来更成功,并不保证撤掉教师后学生学得更好。
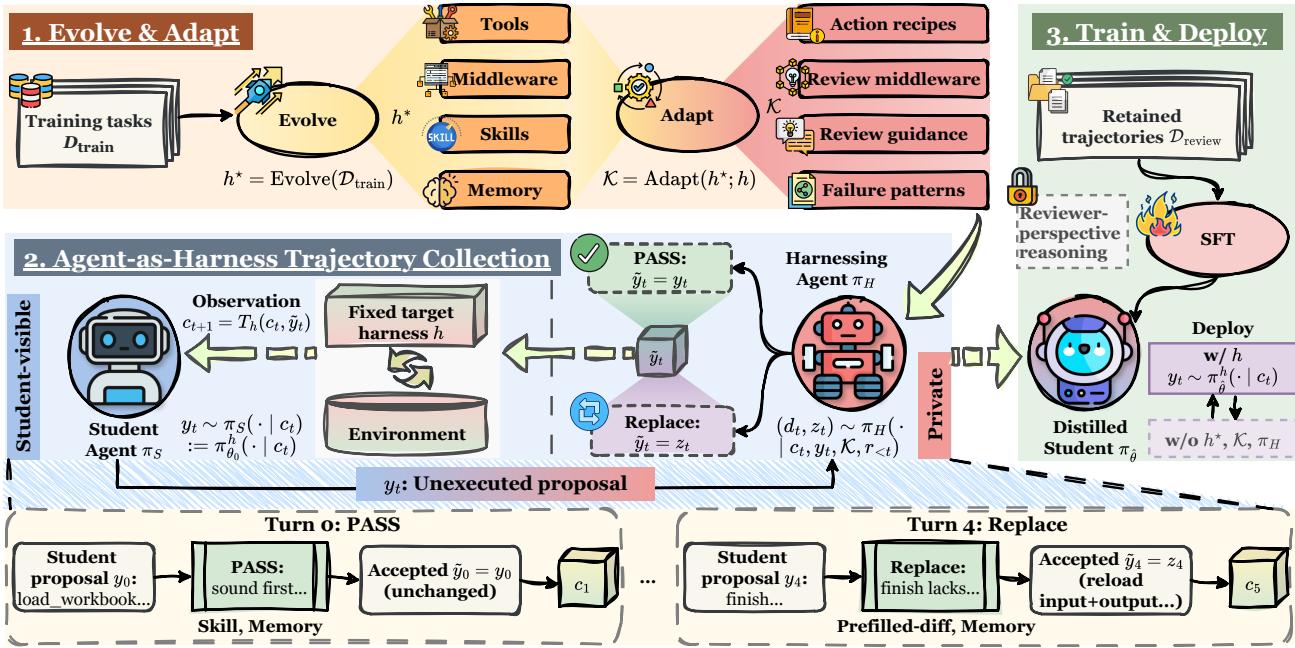 原论文 v1,Figure 1,PDF 第 4 页。
读图。 先看左上:训练任务得到一套外部执行规则,随后被转换成审阅者能使用的参考。再沿中部学生发出的“尚未执行提案”走向右侧审阅者,经过放行或替换分支后,动作才回到中间固定框架执行,观察再返回学生。最右侧是训练与部署阶段:保留的轨迹进入 SFT,最终部署只带模型和固定框架。图中的学生执行循环与右侧的一次训练是两种时序,不是已验证的多代自改进循环。
证据与局限。 Qwen3.5-9B 在三个领域上的宏平均由 23.3% 到 44.3%,高于保留专门框架的 41.7%;但化学任务仍是 30% 对 38%,未能完全内化领域知识。在该任务的监督对照里,直接教师轨迹蒸馏后为 12%,真答案审阅为 15%,方法为 30%。这些结果支持纠正的表达方式很重要,但不能据此声称模型已普遍掌握工具实现。蒸馏使用更强的 GPT-5.6 Sol 审阅者,并分别训练各领域;推理时的同模型审阅实验是另一组设置,不能混成“不用更强教师”的训练结论。审阅还有额外采集成本,主表宏平均也混合了任务成功率与场景完成率。
评测数据集与环境。 SpreadsheetBench Verified:400 题版本,300 演化/采集、100 测试,保留 487 条成功轨迹,pass@1。AppWorld:147 train+dev 题用于训练,test_normal 168 题组成 56 场景,指标 SGC,保留 282 条成功轨迹。USPTO Retrosynthesis 本篇子协议:十类反应均衡取 500 训练、100 不相交测试,保留全部 500 轨迹并报告 pass@1;原语料发行版待核。三项在 Harbor 中运行,不能把不同指标的宏平均理解成合并样本准确率(v1 §4、App. D–E)。
[!abstract]- Abstract 完整中文翻译 Agent 的运行框架是协调模型与环境交互的外部系统,可以显著改善表现,但部署时这些收益仍依附于框架。不同领域、实例和模型各自最合适的框架不同,因此通用 Agent 要么使用次优的共享框架,要么在不断增多的专门框架之间路由。我们研究 Agent 框架蒸馏:以领域或实例优化过的框架作为训练指导,将其诱导出的行为迁入模型权重,使收益在单一固定目标框架下仍然保留。难点在于两个框架的动作空间与可用信息不同,优化框架的指导不能直接作为目标框架的监督。我们提出 Harness-Zero,通过“Agent 充当框架”实现蒸馏。受优化框架指导的审阅 Agent 在学生响应执行前进行纠正,并用目标框架的动作空间表达纠正,将框架指导转成训练示范。用所得轨迹微调,能够把框架诱导的行为内化到模型,从而在部署时移除专门框架。覆盖知识工作、工具使用和科学任务的实验显示:一,对使用同一演化框架的前沿模型,让 Agent 承担框架功能平均优于代码框架;二,在部署时移除专门框架后,Harness-Zero 将基础模型的宏平均任务成功率从 23.3% 提升到 44.3%,甚至高于仍挂载该框架时的 41.7%;三,在三个领域的 28 种行为模式中,它平均恢复了 82.3% 原基础模型不具备、但由框架诱导出的行为。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.24974 v1;首次提交 2026-09-21 17:55:20 UTC,即北京时间 2026-09-22 01:55:20。§3/Figure 1;§4 Tables 1–4;App. D 轨迹保留,App. E 分领域训练,App. F 审阅成本。 原论文 v1。
Critical-State RL:奖励有波动,不代表这一轮值得训练
作者:Zixiang Chen、Wenting Zhao、Zhepeng Cen、Akshara Prabhakar、Jielin Qiu、Jianguo Zhang、Zhiwei Liu、Tulika Manoj Awalgaonkar、Liangwei Yang、Shelby Heinecke、Silvio Savarese、Huan Wang。
机构:Salesforce AI Research(v1 第 1 页)。
任务背景。 用户提出操作请求时,必要工具可能暂时不可用;稍后系统才把工具补回来。Agent 先要避免胡乱修改状态,再要在工具可用后真正执行请求。整条任务最后失败,既可能是前面没等工具,也可能是后面仍然拒绝执行。
如果固定第一轮回答,再多次运行后续对话,结果仍会时好时坏。这时奖励虽然有波动,却不能说明改变第一轮回答就能改善结果;训练可能只是追着后续随机性跑。
核心方案。 Critical-State RL 先由任务设计者确定可考虑的调用位置和局部奖励,检查奖励是否反映当前动作对最终任务的影响,以及相对参照策略是否还有改善空间。然后在同一个前缀下采样几个不同动作;每个动作固定下来,再分别重复采样后续执行。
这种两层采样将两种变化分开:不同动作的平均结果差异,是当前调用可能提供的学习信号;同一个动作之后的成绩起伏,则来自后续噪声。通过检查的位置按前一种信号选择,接着只对所选调用产生的响应计算 RL 损失。周围调用提供上下文或结果反馈,不接收这次训练的梯度。
但“不直接训练其他调用”不等于它们的行为不变:更新的仍是共享模型参数,部署到整条轨迹后可能影响其他位置。因此局部信号更清楚之后,还必须重新检验整条任务的表现,论文的理论保证也带有局部更新和分布条件。
实际增量。 把“有成功也有失败”和“当前动作值得改”分开,用嵌套采样估计动作相关信号,再通过选择不同训练位置做受控比较。位置和奖励并非全自动发现,不能把它描述成会自行设计训练算法的 RSI。
这不就是……找关键步骤,只给关键步骤算 loss 吗? 新增部分在“凭什么认定关键”:不是看哪个位置附近奖励最抖,而是固定动作后先量出后续噪声,再比较不同动作的平均效果。论文还发现只换梯度 mask、仍用整条轨迹的同一标量奖励,不能复现局部奖励训练的收益。
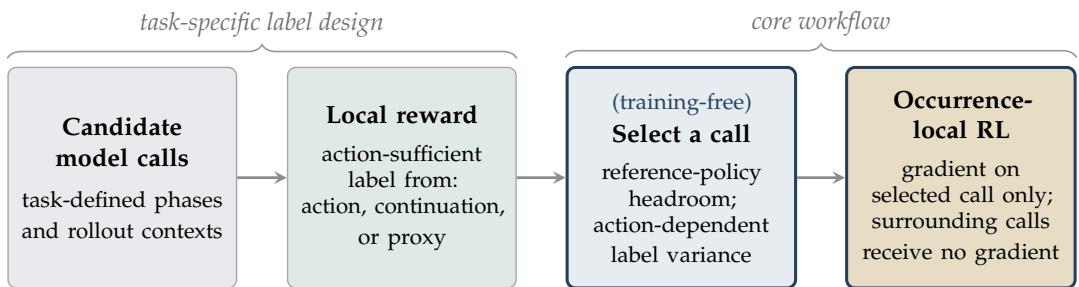 原论文 v1,Figure 2,PDF 第 4 页。
读图。 从左侧任务给出的候选调用开始,先进入局部奖励设计;这两块属于任务设定,不是已经学出的自动诊断器。之后蓝框用冻结策略的采样检查改善空间与动作相关方差,最后黄框才训练选中的调用。整张图先诊断、后训练,没有训练中不断重选位置的返回箭头;后续执行可以产生奖励,但不等于它也获得梯度。
证据与局限。 对不启用思考的 Gemma,工具缺失任务应训练工具恢复后的响应,主实验准确率从 14.0% 到 28.3%;训练此前的决定反而到 9.5%。缺参数任务则相反,训练参数补齐前的决定更合适。主结果使用固定第 30 步和配对评估,被选位置有四个训练 seed,替代位置只有点估计,不能把证据强度视为对等。更关键的是,附录写明诊断场景来自 BFCL test items:结果支持在这个诊断设置里选对位置,但不能当作对全新基准完全无接触的迁移检验。日志一致率、关键词代理奖励和完整任务成功率也不能互相代替。
评测数据集与环境。 BFCL v4:主实验的每条件配对评估为 200-item multi_turn;诊断三格各 64 场景,缺参数恢复格 54,每场景 8 动作×4 后续采样,这些是重复执行而非独立任务。另用 agentic/memory 子任务均分评估存取训练,分母待核。论文自建诊断与训练场景 记录日志重复调用、合成工具缺失、记忆训练及控制模拟;训练规模和日志开放性未完全披露。补充实验按 BFCL Overall 选模的结果与固定 checkpoint 主表分开(v1 §4–5、App. C–E)。
[!abstract]- Abstract 完整中文翻译 多轮工具使用的失败可能取决于一次模型调用,但仅看奖励变化并不能判断哪一次调用会从训练中受益。如果奖励依赖后续交互,波动可能反映后续随机性,而不是当前动作之间的差异。我们提出 Critical-State RL,用于识别多轮交互中可训练的状态。给定任务定义的候选调用和局部奖励,方法判断奖励是否捕捉了该动作对任务成功的影响,以及是否有可能超过参照策略。随后,它使用嵌套采样,将动作相关的奖励变化与后续执行噪声分开,并在选定状态用上下文老虎机式训练优化策略。在 BFCL v4 上,实验比较了诊断所选位置与其他位置的训练。对于缺失函数的任务,诊断选择工具可用后的响应;对于缺失参数的任务,则选择缺失参数补充之前的响应。训练所选响应能提高表现,包括缺失函数任务约 14 个百分点的提升;训练替代位置则持平或变差。我们还将同一方案应用到不同模型和任务,包括日志中的重复调用避免,以及记忆管理。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.24985 v1;首次提交 2026-09-21 17:57:20 UTC,即北京时间 2026-09-22 01:57:20。Figure 2、§3/Algorithm 1;§4 Tables 1–2;App. C.3 的测试条目诊断与评测协议;App. D 应用、App. E 有条件理论。 原论文 v1。
ACLArena:先合并通用行为,再隔离各任务的强化学习更新
作者:Haixin Wang、Xiaoxuan Wang、Junkai Zhang、Han Zhang、Renliang Sun、Alexander Taylor、Yidan Shi、Haoran Deng、Chenguang Wang、Jason Cong、Yizhou Sun、Wei Wang。
机构:University of California, Los Angeles;University of California, Santa Cruz(v1 第 1 页)。
任务背景。 一个模型先学数学,再学检索回答,接着学与用户对话并调用电商接口,最后强化指令遵循。后一个阶段学得更好,并不保证前面的能力还在。例如电商任务需要遵守业务规则、操作数据库,这类训练可能让模型原来会用的搜索或推理方式退化。
研究者需要回答的不只是“要不要回放旧数据”,还包括应从旧模型保留什么:它产生的轨迹、它对学生当前回答的指导,还是它本身的参数。
核心方案。 ACLArena 先沿相同四阶段训练模型,在每个阶段都测旧任务与域外任务,再比较三种能力合并方式。第一种让旧阶段教师在线评价学生自己生成的内容;第二种把各专长模型产生的高质量轨迹收集起来做监督学习;第三种直接合并参数。它们分别复用在线指导、离线行为与权重,但实验发现常常是恢复一项、损失另一项。
作者据此提出两步结构:先用多领域高质量轨迹训练一个共享底座,让它具备较通用的任务行为;随后冻结底座,为各领域分别训练一个小型低秩参数增量,也就是 LoRA 专家。每个专家只在对应环境中做强化学习,新领域更新不再直接覆盖旧领域的专门参数。
实际执行时,系统依据可见的环境和工具信息选择对应专家。保留下来的学习结果因此有两种载体:共享模型保存合并后的通用行为,各专家保存容易相互干扰的专门能力。它并没有学会自行发现下一阶段要学什么,也未验证同一回合里动态组合多个专家。
实际增量。 先把遗忘现象、训练信号与合并路线放在同一对照中,再利用“共享行为 + 隔离强化学习增量”缓解干扰。新增专家的参数成本会累积,不能把它当作资源不增长的单模型终身学习。
这不就是……用 LoRA 分任务训练吗? 参数隔离本身是已有思路;这篇值得看的增量在前面的诊断和共享底座构建:先说明离线行为合并能恢复什么、哪里仍有冲突,再让隔离的 RL 专家补足局部适应,不能把整套方法的收益只归因于加了适配器。
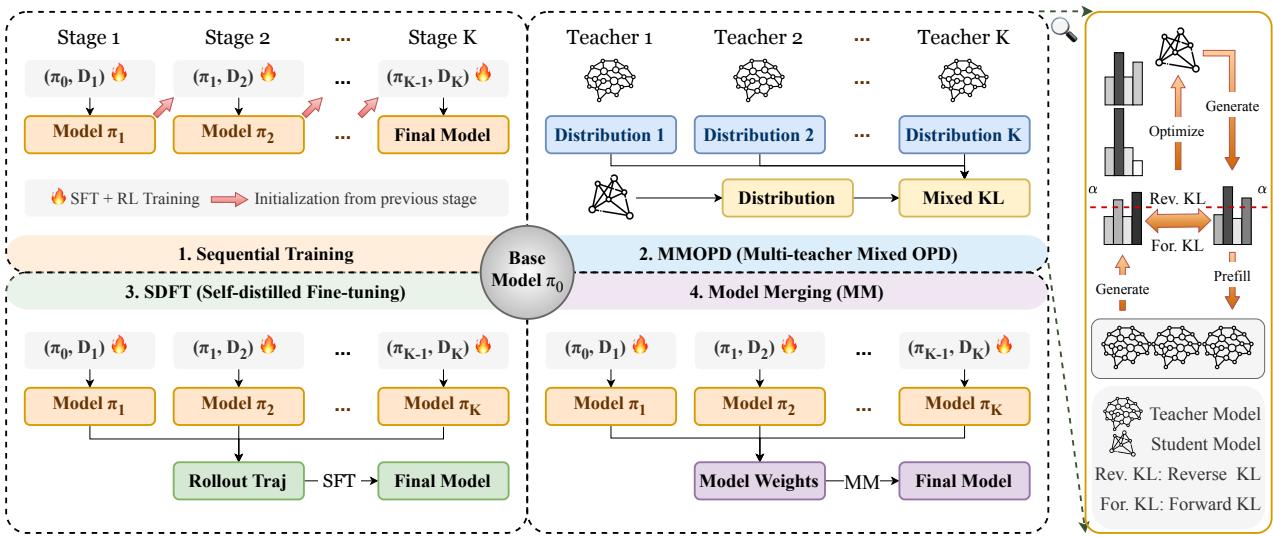 原论文 v1,Figure 1,PDF 第 1 页。
读图。 从中央同一基础模型出发,左上沿阶段箭头不断修改同一份参数,是顺序训练;右上让多个教师的分布监督学生,是在线蒸馏;左下先取模型产生的轨迹再训练,是离线行为合并;右下则直接合并权重。这张原图比较四种基础路线,没有画出最终的 LoRA 专家方案;上文“冻结共享底座、分领域训练并路由”的部分来自正文方法补充,不应在图中硬找对应箭头。
证据与局限。 顺序训练的搜索成绩曾到 45.2,进入电商阶段后降至 14.6;最后学完指令遵循后回到 33.5,表明最终分数会掩盖中途退化。新方案在 NQ 达到 49.7、retail 达到 32.9,接近独立专家的 49.9 和 33.2,同时保住 85.0 的 IF-Eval;它仍不是每列最好,例如 IF-Bench 29.1 低于顺序终点 30.8。主要证据基于 Qwen3-8B-Base 和固定课程;任务环境不清楚、同一回合跨多领域时怎样路由仍未验证。论文也未提供足以完成严格等总成本判断的所有对照。
评测数据集与环境。 数学及知识使用 AIME 2026(每题 16 次采样取均值)、GPQA-Diamond、MMLU-Redux。搜索以 NQ 为域内,域外单跳取 PopQA 与 TriviaQA 均值,多跳取 2WikiMultiHopQA、Bamboogle、HotpotQA、MuSiQue 均值;统一 E5/Wikipedia-18、top-3、至多五轮。τ³-Bench 使用 basic split,retail 训练及域内评估,telecom/mock 域外评估,以最终数据库状态判断成功。指令遵循使用 IF-Eval 和 IF-Bench;IFTrain 属于训练来源。原文未逐项给出实际测试题数/revision,均保留缺口;主表三运行统计不是三倍独立题目,AIME avg@16 也不是 pass@16(v1 §5.1、Tables 1–2、App. F)。
[!abstract]- Abstract 完整中文翻译 面向工业部署的通用 Agent 需要整合多种能力,而这些能力通常在不同训练阶段获得。然而,目前 Agent 持续学习还缺少成熟方案,人们也不充分理解不同整合范式之间的取舍。为弥补这一缺口,我们提出 ACLArena,用于系统研究、分析和评估 Agent 持续学习。我们首先构建顺序训练流程,从模型层面和 token 层面两个互补视角深入分析遗忘与泛化的机制。在这些分析指导下,我们系统比较多教师在线策略蒸馏、自蒸馏微调与模型合并,评估它们在保留新能力的同时恢复旧能力的效果。通过广泛实验,我们详细刻画能力怎样跨阶段迁移。最后,我们提出一种新的持续学习方案,将高质量轨迹的离线回放与经过强化学习专门化、带路由的多个 LoRA 专家结合,显著改善 Agent 跨领域学习的能力。在四类推理与 Agent 任务的域内和域外评估中,实验展示了分析的价值和方法的有效性。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.23989 v1;首次提交 2026-09-21 01:48:37 UTC,即北京时间 2026-09-21 09:48:37。Figure 1 为路线比较,最终 MLE 见 §6.3/PDF p12;设置 §3、§5.1、App. B/F。SDFT 采样次数正文 §5.1 写 group size 8,App. E 写 16,复现前待核。PDF 标题为 Agent Continual Learning,元数据标题为 Agent Continue Learning;作者 Alexander Taylor 按 PDF 首页保留。 原论文 v1。
TimEvolve:等真实结果到来,再更新下一次预测的决策方式
作者:Yifan Hu、Xilin Dai、Zhiyuan Qu、Yiding Liu、Zewei Dong、Jiang-ming Yang、Qiang Xu。
机构:Ant International;Tsinghua University;The Chinese University of Hong Kong(v1 第 1 页)。
任务背景。 例如系统根据到今天为止的历史数值和公开文本,预测未来一段时间的交通量。它可以调用多个数值预测器,也可以让语言模型结合证据提出修正。真正的答案要等未来发生以后才知道;今天更可靠的预测器,到了新阶段也未必仍然最好。
如果只把误差写成一条回忆,下一次究竟相信谁、选择哪种推理方案、允许修正多少,可能仍然沿用原来的固定规则。
核心方案。 TimEvolve 在真实结果出现之前,先保存所有专家预测以及候选方案的完整预测曲线,再选出本次使用的方案。这样,未来到来时不仅能给已选答案打分,也能检查当时没有选中的候选;不能在知道答案之后重新生成候选来冒充事先预测。
反馈到来后,系统做三项持久更新:根据各专家的历史误差调整信任权重,根据候选预测的可见特征与实际误差学习今后怎样排序,再学习应该在多大程度上采用语言模型提出的修正。最后一项相当于在数值先验与候选预测之间学习一个混合比例;某次修正碰巧有益,只为以后训练这个比例提供一个样本,不会倒改本次已提交的答案。
这些权重、排序器和干预系数一起保存为下一版本。只有预测窗口完整结束,结果才能参与以后时刻的更新;仍未到期的重叠窗口继续等待。底层语言模型、数值模型、工具与提示保持冻结,改变的是组织它们的决策策略,并不是模型自己重写学习算法。
实际增量。 把同一个延迟结果同时用于专家信任、路径选择与干预幅度,明确保存未选候选,形成可检验的“先承诺、后揭晓、再更新”协议。这是有持续状态的在线自我改进组件,未验证严格 RSI。
这不就是……看谁预测准,下次多信谁吗? 专家加权确实是其中一部分;它还学习不同候选方案在什么形态下更可信,以及应采用多少修正。能用同一个真实结果评估所有候选,是因为这些预测没有改变未来世界,不能把这种全信息监督误当成一般 Agent 都能免费获得的反事实奖励。
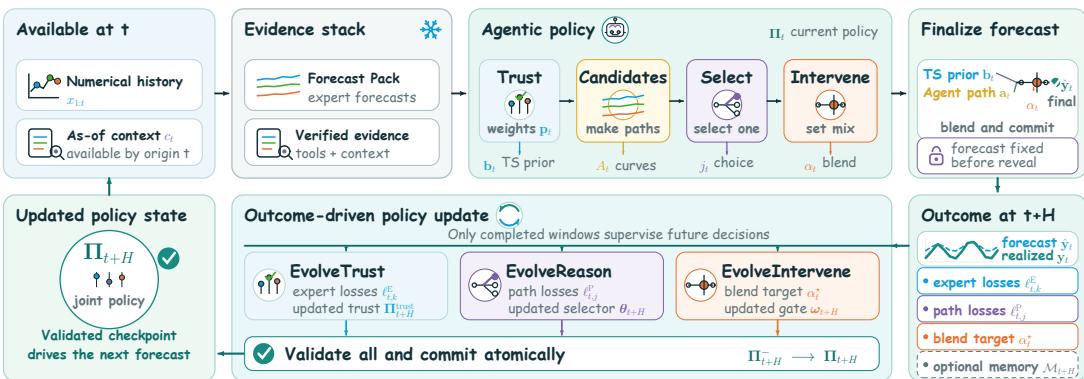 原论文 v1,Figure 2,PDF 第 5 页。
读图。 从左上 t 时刻可用的历史与文本开始,先得到数值专家预测和证据,再经过信任加权、生成候选、选方案、定修正比例,右上锁定提交结果。真正跨时间的箭头走向右下 t+H,此时真实结果才出现,并分别产生专家误差、候选误差和合适混合比例的训练标签。底部三路更新合成新的策略状态,再回到左侧供后续预测使用;不能把底部标签提前送回右上正在提交的预测。
证据与局限。 在八个 Time-MMD 领域、十五种方法的比较中,它在七个领域同时取得最低 MSE/MAE。更有解释力的对照是冻结三个策略更新、保留相同前向计算:相对这个基线,平均各域误差降幅为 MSE 6.3%、MAE 7.6%,支持收益来自反馈驱动的更新,而不仅是多调用了预测器。仍需注意,域×预测长度不是独立任务数量,窗口之间也有重叠;完整的随机种子不确定性和等总计算对照尚不足。它解决的是这里的预测组织问题,不能据此声称通用 Agent 会持续自主变强。
评测数据集与环境。 Time-MMD 原版九域,本篇使用八域、每域四个预测长度;按时间 70/10/20 划分。训练数据确定标准化,测试期间允许已到期窗口反馈更新策略;stride=1,目标缺失项不参与评分,报告标准化空间 MSE/MAE。窗口长度以观测数计,不能直接读成天数;原文没有给出本次每域有效测试窗口总数与数据 revision,保留待核(v1 §5、Table 4、App. B)。
[!abstract]- Abstract 完整中文翻译 Agent 时序预测面对的是底层机制会变化的系统,因此数值模型、推理策略与干预规则的相对效果天然随时间改变。时序 Agent 不仅需要调整输出预测,还需要调整决定信任哪些组件以及如何协调它们的组织策略。随着预测期结束、真实目标出现,部署过程自然提供了适应所需的监督信号。在观察目标之前提交全部数值专家预测和候选 Agent 路径,能让每次真实结果评价整个备选集合,在不增加标注的情况下提供延迟反馈。但现有时序 Agent 主要通过预测修正、反思或检索利用经验,没有系统地将真实结果转成持续更新的联合组织策略,用来管理后续预测时点。为系统利用这种反馈,我们提出 TimEvolve:一个冻结底层模型的时序 Agent,将每次真实结果转成对专家信任、Agent 路径选择和干预强度的联合持久更新。按时间排序的“预测、揭晓、更新”协议将反馈用于后续预测。在八个 Time-MMD 领域的实验中,TimEvolve 在十五种方法中取得最优平均 MSE 和 MAE 排名,并在七个领域同时取得两个指标的最低误差。结果展示了从部署过程中实际经历的未来学习预测策略的价值。
[!info]- 来源、版本与阅读依据 arXiv 预印本 2609.24862 v1;首次提交 2026-09-21 16:33:59 UTC,即北京时间 2026-09-22 00:33:59。机制 §3–4/Figure 2;结果 Tables 1–3;时间、缺失值与窗口口径 App. B/Table 4;固定前向计算对照 App. C。 原论文 v1。