CoPE:让一次成功交互教会更多步行动
作者:Haofei Yu、Yixing Chen、Yining Zhao、Xuyan Ye、Yuxiang Liu、Zhigang Hua、Yan Xie、Shuang Yang、Jiaxuan You。机构:UIUC、UC San Diego、Meta AI。 发表:2026-10-14(UTC);核对版本:v1。
一个购物Agent要根据需求搜索商品、查看属性并下单,每做一步才获得新的页面。训练这样的模型需要许多昂贵交互,而最后的成功或失败只有一个信号。预测整张下一页面又会把大量学习能力花在无关文字上。CoPE问的是:能否利用一条成功轨迹里真正做过的动作,让当前状态也学会预见后面该怎么走?
当前策略先采集轨迹,所有轨迹参与GRPO;其中成功轨迹额外拆成“截至当前的历史—当前及未来数步动作”样本,中间的未来观测不作为预测目标。模型在附加预测指令下拟合这些动作片段,预测损失按每组成功轨迹数归一化,再与GRPO损失加权相加。两个任务共享同一组参数,因此未来动作监督会改变执行策略使用的表示;但两种提示下的输出分布不必相同。部署时撤去预测指令,仍然做一步、看一步,没有额外预测模型或动作重排开销。
本文与下一观测预测辅助训练及GRPO比较,在三个模拟环境的总体指标上更好,ScienceWorld成功率从64.5%升至72.5%。动作会从当前历史和更早的多个历史被反复监督,这与只模仿成功轨迹当前动作不同;后者在该消融中反而比GRPO低7.5个百分点。论文还用独立LoRA预测器在推理时重排动作,帮助GRPO但未进一步帮助CoPE,为共享参数吸收多时间尺度信息提供支持性证据。
成功轨迹也可能含绕路或无效动作,成功筛选并不等于每步都是最佳动作。理论中成功条件动作分布的性质不能直接变成共享参数、不同提示下实际策略的单调保证。τ²-bench整体仅由27.5%升至28.7%,Airline子域从26.2%降至16.2%;AppWorld引用的外部成绩采用不同子集,公平直接对照应看本文GRPO。样本效率按训练步数和指定里程碑测量,不是所有环境都证明了同样的总算力收益。
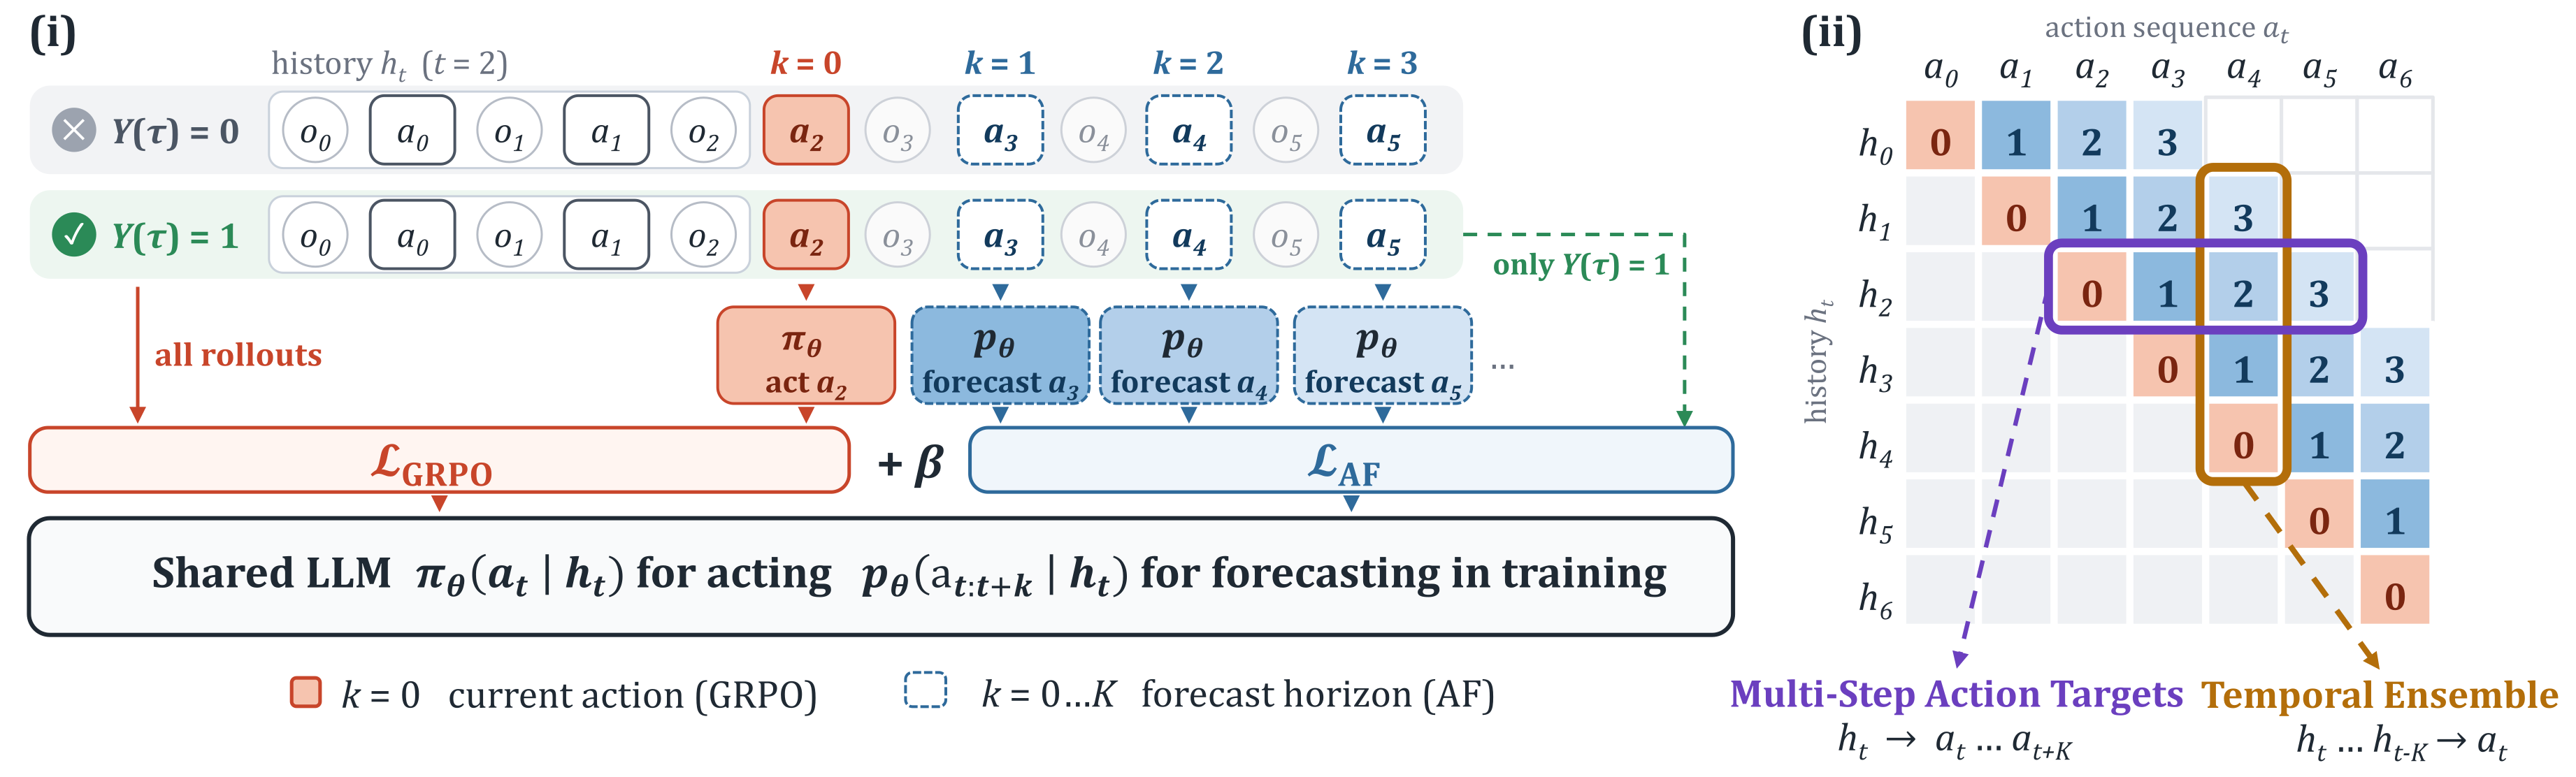
原图Figure 2,v1。先从左侧成功和失败轨迹看两条流向:全部进入红色GRPO项,只有成功轨迹进入蓝色预测项,两项一起更新底部共享模型。右侧沿一行看,是一段历史预测多个后续动作;沿一列看,是同一个动作从多个较早历史接受监督。图中权重标β,正文Algorithm 1写λ,均指辅助损失系数;这些预测分支只在训练中使用。
评测数据集与环境。 ALFWorld训练2,420/测试200个游戏文件;ScienceWorld 2,120/200个任务类型—变体对;WebShop 3,930/200条合成购物指令,仅1,000商品配置。τ²-bench 178/100任务,测试Retail40、Airline20、Telecom40,Avg@4后按三域等权;AppWorld训练90,normal168/challenge417,按状态测试成功率。模拟环境及τ²使用Qwen2.5-7B,AppWorld用14B。上述是本篇划分,不替代各基准的全量规格。
完整中文摘要
语言Agent训练受长程rollout的高成本制约,标准Agent强化学习却只从终局标量奖励学习,未充分利用中间步骤的监督。此前方法使用估计逐步成功概率的价值目标,或拟合环境反馈的观测目标,但两者都难以构造:各步价值目标来自同一标量,网页和终端日志等观测冗长嘈杂且只预测一步。我们提出CoPE,增加第三类多步动作目标。在成功的在线轨迹上,CoPE训练策略骨干生成每段历史之后的动作序列;同一个动作也会从更早的历史被预测,形成由共享骨干在训练中吸收的时间集成,使行动和预测共同改善。推理仍每次只行动一步,没有额外开销。在ALFWorld、ScienceWorld、WebShop、τ²-bench、AppWorld五项基准上,CoPE在模拟环境的总体表现超过GRPO及预测辅助目标基线,也改善两项现实应用的总体指标;在ScienceWorld上,相对ECHO和GRPO的样本效率最高分别达到1.9倍和2.0倍;所有收益只需一个策略骨干,不需额外模型、独立预训练或推理开销。代码位于https://github.com/ulab-uiuc/CoPE。阅读依据。 原论文 v1:§4–9、Algorithm 1、Figure 2、Tables 1–3/7、附录A.3/B。
CriticOPD:老师看得出错误,为何仍会接着错?
作者:Kaixiang Zhao、Tianrun Yu、Shangzhe Li、Yuxiao Yang、Amanda Hughes、Weitong Zhang、Taylor W. Killian。机构:Brigham Young University、UNC Chapel Hill。 发表:2026-10-14(UTC);核对版本:v1。
学生算错了中间一步,老师接着它的解答续写,竟然也沿着错误走下去;换成请老师指出错在哪里,它却能找出来。OPD通常在学生自己生成的前缀上取教师概率作为监督。本文追问:当老师已被错误前缀带偏时,这些逐token概率还能教会学生纠错吗?
先让学生生成完整解答;对错误或截断的解答,固定教师结合参考答案列出错误位置与改法。保留原解答直到最后一个被批注的错误段落末尾,由学生看着批注和答案续写替代后缀。教师在有批注的条件下为后缀打分,学生训练概率则在没有批注的条件下计算,只监督这段新后缀;正确解答或没有有效批注的样本继续普通OPD。这样被训练的token仍由学生生成,而纠错提示仅作为训练特权信息,推理时不需要教师批注。
诊断中,原本可解问题的教师续写准确率随错误前缀加深从0.82降到0.29,但其已指出错误的有效比例仍约73%–81%。CriticOPD利用的是这种“能识错、不能直接续对”的差异,而非直接换上教师写的答案。六项数学测试的宏平均,0.6B学生从OPD的34.80%到38.86%,1.7B从50.08%到54.65%;去掉具体批注、只给答案的消融降至48.67%,低于该单种子OPD的50.18%,说明答案本身不能解释全部收益。
错误标记有效比例是模型裁判给出的精度,不是找全错误的召回率。主方法依赖参考答案;有批注采样、无批注计学生概率的目标是有偏替代目标,不能直接称为严格on-policy KL。主结果三训练种子,在独立653题验证集用seed42选步数后复用于另两个种子,测试不参与选点。额外批注和续写增加部分步骤成本,但不能据此断言总成本更高:附录D同40步GPU小时为OPD的0.96倍,选中checkpoint总成本17.2 GPU小时、为OPD的0.42倍;该比较受生成长度和选中步数影响。数学外平均仅70.47%到70.69%,代码两项下降,不能外推为全面能力提升。
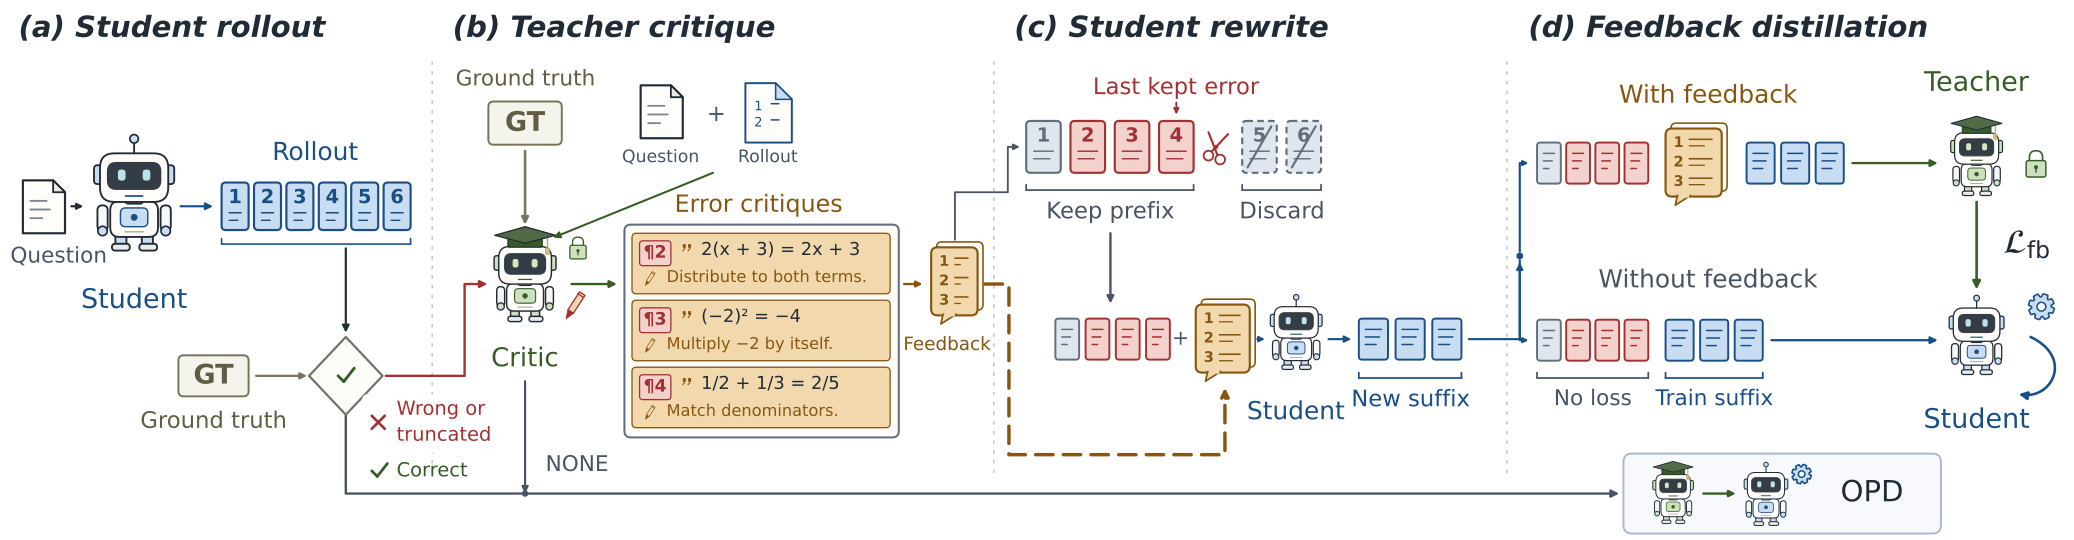
原图Figure 2,v1。沿上方流程看学生先产生错误解答,再由教师指出错误;中间保留的前缀包含最后一个错误段,学生需要从这里真正纠错。右侧打分和训练的两个上下文不同:教师看见批注,学生用于训练的概率看不见批注。理解这个不对称,就能分清训练特权信息和部署时依赖。
评测数据集与环境。 最终测试:AIME 2024 30题、AIME 2025 30题、AMC 2023 83题(按作者口径,非单场40题)、MATH500 500、OlympiadBench 675、Minerva Math 272;前三项每题32次、后三项8次采样,六基准等权,非pass@32。DAPO-Math-17k只用于训练。验证集MATH-val500题与MathArena四场2025竞赛153题分别采样4/8次,用于checkpoint选择;已核实来源:论文附录C。附录迁移测试用MMLU-Pro、MMLU各2000题分层子集,ARC-C、已核实来源:OpenBookQA、HumanEval+、MBPP+;每题4次采样,代码按扩充测试pass@1。
完整中文摘要
On-policy蒸馏(OPD)在学生自己的rollout上使用教师提供的逐token监督训练学生,通常假定教师能从学生写出的任意前缀到达正确答案。我们把这种性质称为教师的可恢复性,并发现它在错误rollout上会失效:教师虽然能识别错误,却仍会沿着学生错误继续。我们提出CriticOPD,利用错误识别恢复可恢复性。教师批注错误rollout,使学生能够在错误之后重写解答。教师在上下文包含批注这一特权信息时为重写结果打分,学生则在训练时使用不含批注的修订解答。在两个Qwen3学生和六项数学推理基准上,CriticOPD优于OPD,其中竞赛题的提升最大。代码公开于https://github.com/kzhao5/CriticOPD。阅读依据。 原论文 v1:§2–4、Algorithm 1、Tables 1–2/6、附录C.5–6/D/E。
Proximal KL:旧策略生成的答案怎样继续用于训练
作者:Hao Bai、Jiarui Yao、Tong Zhang。机构:University of Illinois Urbana-Champaign。 发表:2026-10-13(UTC);核对版本:v1。
假设一个数学模型正在边生成解题过程、边用答案是否正确来训练。生成一批答案期间,训练端可能已经更新了参数;这些旧答案仍有价值,但直接当作当前模型生成的数据会使更新偏移。本文研究怎样复用它们,同时避免整条长答案的重要性权重连乘带来的高方差。
训练时保留每个 token 当初被采样的概率,再分别计算两种比值:当前模型相对采样模型的比值用于校正数据,当前模型相对本轮冻结参考模型的比值用于约束更新。对于一个 token,算法从整条回答的奖励优势中减去当前位置及后续位置的 KL 成本,再乘当前 token 的采样校正权重,更新模型参数。实际实现对单项成本限幅,并允许只累积一个有限窗口;参考模型和采样模型按各自节奏刷新,因此二者不必相同。使用模型解题时不需要这个训练循环。
本文与保持相同数据、优化设置的 GRPO 变体比较:七组离策略配置的八项数学评测微平均均更高,最大增加 2.58 个百分点;另一个单次更新、无数据复用的同策略对照仅表现相近。机制层面的增量是证明完整未来 KL 信用与当前 token 权重结合后,在覆盖和局部表达能力假设下仍以精确近端最优策略为唯一驻点,而不是声称这个有偏更新处处等于原目标梯度。
理论要求完整、未限幅的未来信用及特定基线;实际组标准化、限幅、有限窗口和 Adam 并不自动继承理论保证。有限样本保证还针对固定特征的线性模型与投影更新。实验主要是 Qwen3 数学训练,1.7B 主表有三种随机种子,4B 未给同等多种子统计;高陈旧度配置也调整了窗口,不能将全部差异解释为单一因素的因果效果。
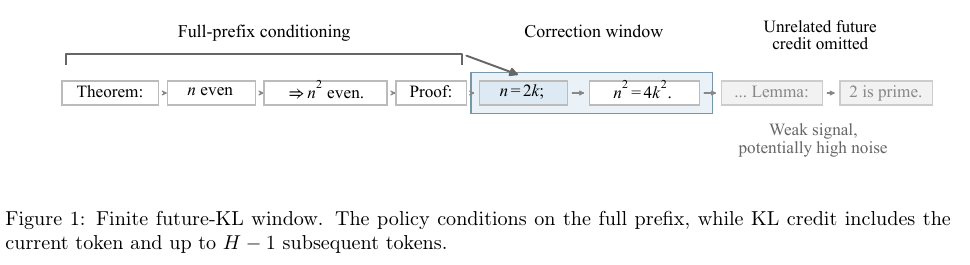
原图 Figure 1,v1,PDF p.6。从左侧完整证明前缀进入当前 token,再看蓝色窗口:模型预测依然使用完整前缀,截短的是向后累积的 KL 成本。右侧淡色步骤不进入当前窗口,并不表示模型不能生成或读取这些步骤。参考策略如何刷新由正文算法补充,图本身没有证明窗口越短越好。
评测数据集与环境。 MATH500、OlympiadBench、MinervaMath 分别为500、674、272题;Gaokao2023MathEn为383题,四者用 greedy pass@1。AIME24、AIME25分别30题,AMC23/24分别40/45题,每题16次。mean@16是回答正确率,pass@16是至少成功一次的题目比例;主表微平均分母是每种子4,149次回答。Gaokao本篇身份与协议已核实来源:原论文附录 C.1。训练用9,453条过滤后的DAPO数学题,不能混作测试规模。
完整中文摘要
可验证奖励强化学习中的离策略数据可能来自异步生成、生成与训练策略不一致,以及回答复用。逐 token 重要性加权避免沿整条回答连乘似然比,但通常使策略梯度有偏。我们证明,在覆盖与局部表达能力条件下,完整未来 KL 信用使精确近端最优策略成为更新的唯一驻点,即便数据来自多个旧策略的混合也成立,无需完整回答权重或拟合 critic。我们进一步证明,在持续覆盖与随时间变化的行为策略下,连续时间表格型总体更新会收敛,并在附加假设下给出线性逻辑模型的有限样本奖励保证。这些结果启发了 Proximal KL:区分近端参考与采样策略,以有界未来 KL 信用替代 PPO 裁剪。在 Qwen3-1.7B 与4B的七组匹配离策略比较中,覆盖两种学习率、回答复用及生成陈旧性,Proximal KL 在八项数学基准的微平均准确率上全部超过 GRPO,最大提升2.58个百分点。独立同策略比较的综合准确率相近。在周期刷新实验中,该方法避免了 PG 与 CISPO 的崩溃,以更少策略更新达到更高训练准确率。消融表明逐 token 校正优于序列级及无权重对照;保留逐 token 校正时,未来 KL 反馈比 PPO 裁剪更不易受所测试的基线扰动影响。有限未来窗口在 AIME24 mean@16、pass@16 上超过完整尾部;固定策略测量显示截断降低了所测窗口范围内的校正方差。阅读依据。 原论文 v1:§3–6、Algorithm 1、Figure 1(PDF p.6)、Table 1、附录 A/C/E/F。
Before They Can Solve:训练之前,怎样看出代码 Agent 的潜力
作者:Tan Yu、Alexander Bukharin、Khushi Bhardwaj、Jennifer Williams 等(完整名单见原文)。机构:NVIDIA、University of Minnesota–Twin Cities、University of California Berkeley。 发表:2026-10-07(UTC);核对版本:v1。
假设要从几个基座模型里选一个训练成修复软件问题的 Agent。真正的工作是读仓库、修改代码、运行测试,最后交出能解决问题的补丁;但未经后训练的基座可能连工具调用格式都写不对,端到端失败率就掩盖了它的代码能力。本文让模型从一段真实修复过程的关键位置接手,观察它是否已有解决问题所需的行为。
研究者先重放强模型成功的代码修复轨迹,在代码改变后运行测试,定位累计补丁第一次从失败转为通过的位置。这个位置之前的上下文交给基座,正确动作仍被遮住。随后用三种方式探测:计算基座赋给已认证动作的每字节负对数概率;让它在正确动作与测试失败的替代动作间选择;或者让它续写若干次,只要测试认可就算成功。被复用的是轨迹、仓库状态和验证器,评估过程本身不更新基座参数,也不要求复现唯一的文本答案。
相对整段轨迹求平均,本文只测决定性动作的 BPB,在同一十模型队列、DeepSWE来源轨迹上,与后训练 SWE-bench Verified 排名的 Spearman 相关从0.915升至0.964。三种探针分别测支持正确动作、区分备选与真正生成,避免把“更像轨迹作者”直接当作更会解决问题;同一SFT流程的三基座实验也保留了排序趋势。
十组公开模型来自不同后训练方法与执行框架,相关性仍混有训练配方差异;统一SFT只覆盖三个基座,且部分轨迹来源的探针一致性较弱。论文没有为这些相关系数给出bootstrap区间。来自SWE-bench Verified本身的前缀再预测该基准属于同基准证据,不能当独立泛化;采样预算从16增至32也不保证排序更好。
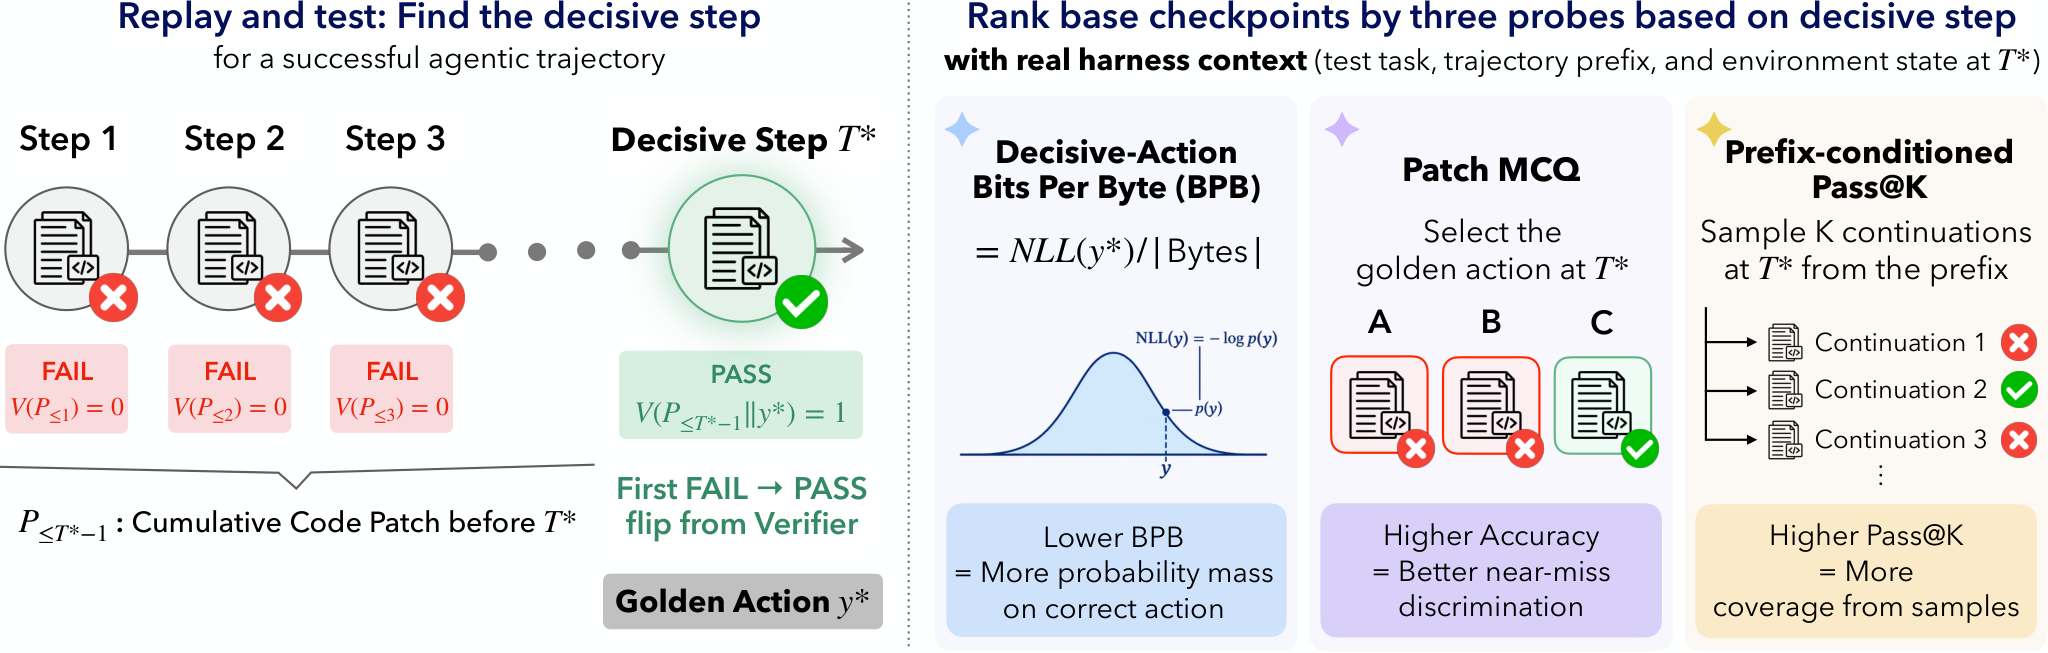
原图Figure 1,官方v1 HTML。先沿左侧轨迹寻找第一次测试通过的位置,再把此前上下文交给右侧三个探针。三个分支共享同一个决策点:蓝色衡量对认证动作的概率,紫色比较正确与错误备选,黄色真正生成并验证续写。右侧不是依次执行的三步训练,而是三种互补评估。
评测数据集与环境。 SWE-bench Verified、SWE-bench Pro与DeepSWE用于轨迹构造;下游目标还包括Terminal-Bench 2.1及SWE-bench Multilingual。DeepSWE MCQ为756道选择题/392个实例,Verified为576题/249个实例;续写探针分别120/98个实例,每实例8、16或32次,不与原始全基准规模混算。Multilingual身份及本篇目标口径已核实来源:原论文§4.3与附录C。附录E还将HumanEval、MBPP、RepoBench等作为有界代码任务对照,非训练集。
完整中文摘要
怎样预测哪个基座检查点值得昂贵的Agent后训练?端到端pass@K测试基座分布里是否已存在成功行为,但不适合Agent编程:许多基座无法可靠产生完成任务所需的规范工具调用。单次或短程任务通过把多步交互压成固定提示与单个补丁绕开工具调用失败,却也回避了我们关心的核心能力——在仓库持续变化时,跨多次工具使用维持一致状态。为弥合差距,我们将后训练Agent的成功轨迹作为基座潜力的前瞻信号。重放轨迹并在每次代码修改后重新测试,可找出决定性步骤:累计补丁第一次使仓库从测试失败变为通过的位置,认证该动作在先前上下文下解决了任务。受Agent轨迹覆盖原则启发,我们在这里建立三个无需基座冷启动执行框架的筛查:决定性动作BPB衡量已认证动作的概率质量;Patch MCQ让模型在该动作和被同一验证器拒绝的备选之间选择;前缀条件pass@K评估功能正确生成的支持,并认可任何通过测试的续写。在十组公开基座与后训练模型中,三种方法的排序都与后训练SWE-bench Verified pass@1高度一致。由于仅需要基准的成功轨迹和验证器,这些方法也可将未来的Agent编程基准转化成基座评估。阅读依据。 原论文 v1:§3–4、Figure 1、Tables 1–3、附录 C/D/J/K。
Scaling Discovery Requires Forgetting:保留最佳成果,忘掉搜索过程
作者:Shangyin Tan、Ben Zhou、Lakshya A Agrawal、Jialin Zhang、Yilin Chen、Qiuyang Mang、Donghyun Lee、Dennis Jacob、Koushik Sen、Alex Dimakis、Matei Zaharia。机构:UC Berkeley、Stanford、Bespoke Labs。 发表:2026-10-14(UTC);核对版本:v1。
例如让代码Agent不断优化一个慢内核:每次改代码、跑评测,再根据耗时继续修改。多给预算后,它却可能反复声明已经到极限,甚至想到新办法也不肯实现。把四个Agent并行运行或让它们互看成果也不能彻底解决。本文尝试只保留目前最好的代码,让下一轮摆脱此前尝试过程的影响。
搜索被分成多轮。轮内四个Agent各自维护会话和候选记录,可通过共享候选及其评测分数了解同伴成果,而非直接相互聊天。到轮间边界,固定harness的reducer选出全队最佳候选和分数,清空所有会话与其余候选历史,再让四个新会话从这个候选开始。继承的是工作成果;模型参数、任务裁判、重启规则和最初指令不随实验学习。它也不等于随机从零重启,因为上一轮已验证的改进还在代码里。
主实验四项任务、每配置三次运行,团队加遗忘在各项最终最佳成绩的均值上均优于单Agent和独立并行Agent。更直接的AHC014对照从同一个停滞状态继续30次提案:团队保持历史平均改善1.4%,清空后改善9.2%,对应花费24.67与15.32美元。这个对照说明收益不只来自“有四个Agent”;重启后编辑幅度与思考token也回升,支持历史约束探索的解释。
主表同时改变通信与遗忘,不能仅靠主表拆出两者独立贡献;同状态消融只做AHC014。全部实验使用Pi与DeepSeek V4.1 Flash,四项均是可自动评分的代码优化;三次重复且团队遗忘收益的标准差达6.9个百分点。预算按论文当时API美元成本匹配,不是等原始token数,也未统一计入评测GPU成本。三次固定重启尚未解决何时忘、该留下哪些失败教训;多数后续轮收益递减,没有无限增长证据。与同期Fork-and-Flush的差异是进一步清空工作区候选历史,论文没有直接对照其效果。
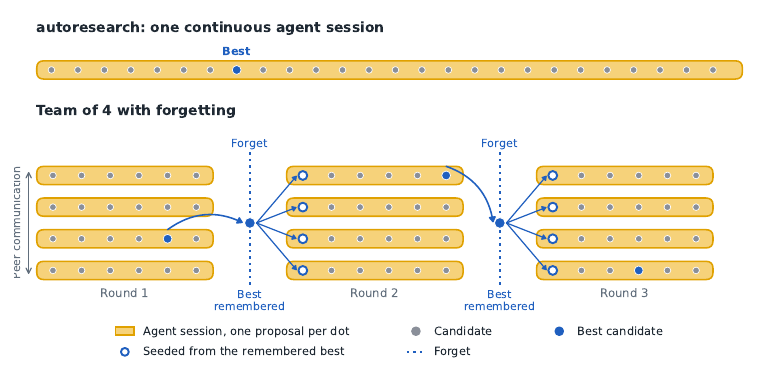
原图Figure 2,v1第4页。上方长条是一条持续增长的会话;下方每根虚线都结束整队旧会话,蓝色实心点表示唯一留下的最佳候选。下一轮四条分支都从它出发,因此“忘记过程”与“保留进展”同时发生。图中轮内横向关联表示可读同伴候选,不代表独立训练了四个模型。
评测数据集与环境。 已核实来源:论文附录A/Table 4;本篇口径:AHC014写C++网格构造程序,30个官方测试案例取均分,预算20美元;Frontier-CS仅Q171,75案例、相对参考解缩放至0–100,20美元;Anthropic VLIW kernel在模拟机器优化树遍历及哈希内核,以周期数越低越好,40美元(不是KernelBench);nanochat-autoresearch每候选单H100训练5分钟,最小化验证BPB,搜索预算20美元。四任务各三次独立搜索,报告每次搜索最好候选的均值与标准差;30/75是评测案例数,三次是搜索重复次数。
完整中文摘要
使用LLM Agent开展自动化研究已在多个领域显示潜力。通过迭代优化和可评分验证器,Agent能够发现新想法。扩展自动化研究可以让单个Agent迭代更久、让多个Agent并行运行,或进一步让并行Agent交流并在彼此候选上继续构建。然而,我们发现随着历史积累,三种策略最终都会进入平台期。每个Agent被自己过去的尝试锚定,修改越来越少、越来越小,此后追加预算也难带来进一步改善。本文表明,进一步扩展发现过程的关键是遗忘:定期丢弃包含每个Agent会话和候选历史的搜索状态,并从已找到的最佳候选重新开始,可以解除搜索停滞,让同样预算走得更远。我们在能交流的Agent团队中实现遗忘,在启发式编程、内核优化和模型训练的四项任务上评估。结果相对并行Agent最高改善15%,相对单Agent最高改善39%。研究提示,对开放式发现而言,允许Agent记住什么,与给它多少算力同样重要。阅读依据。 原论文 v1:PDF v1 §3–5、Figure 2、Tables 1–4、附录A/B。
Physical RSI:机器人变强,与改进方法变强之间
作者:Hai Zhou、Fan Yang、Zeyi Chen、Lejun Zhang、Chenyang Fu 等30位作者。机构:Shanghai Jiao Tong University、Google、Microsoft、UC Berkeley、Stanford、MIT等,完整对应关系见原文署名。 发表:2026-10-13(UTC);核对版本:v1。
假设机器人学会从桌上拿杯子,接着在不同位置拿得更稳。这证明能力改善,却还没有回答:它是否学会了更有效地改进自己?本文是一篇框架与综述,研究应怎样描述机器人保留下来的变化,以及需要哪些对照,才能把技能提升、学习方法更新和真正的递归收益区别开。
框架把执行任务的模型权重与外部程序放在一侧,把产生、训练和验收更新的改进程序放在另一侧。机器人交互产生的经验进入存储,改进程序据此修改执行系统;通过验收的变化由后继版本继承。若改进程序还改写自己的诊断、训练或验收规则,就进入元层更新。规则能被改写仍不等于它变好了:要从相同起始系统与经验、相同预算出发,分别运行新旧改进程序,再由循环外的独立评价器比较它们产出的系统。
本文用两个轴组织L1–L4:更新能力还是改进过程,收益在同一任务还是跨任务;L5额外要求独立验证的递归增益。它进一步按所需技能的序列区分任务:杯子换位置通常只是实例变化,增加开柜门或改变技能顺序才可能构成新任务。按此口径,综述检查的七类协议有五类未建立跨任务改进证据,其中有的只是信息不足,而非已经证明不能迁移。
作者结论是所综述文献尚未满足本文定义的Physical RSI,并不是对所有机器人工作做了穷尽性否定。L0–L5是该文提出的分析标准,不是公认能力排行榜;含人工介入的系统被放在L0并不表示任务性能低。物理仿真反馈与真实机器人反馈均可满足其物理落地定义,但仅由学习世界模型想象得到的反馈不够;仿真有效仍不证明真实部署可靠。普通固定训练程序里不断更新critic,也不自动构成元层递归。
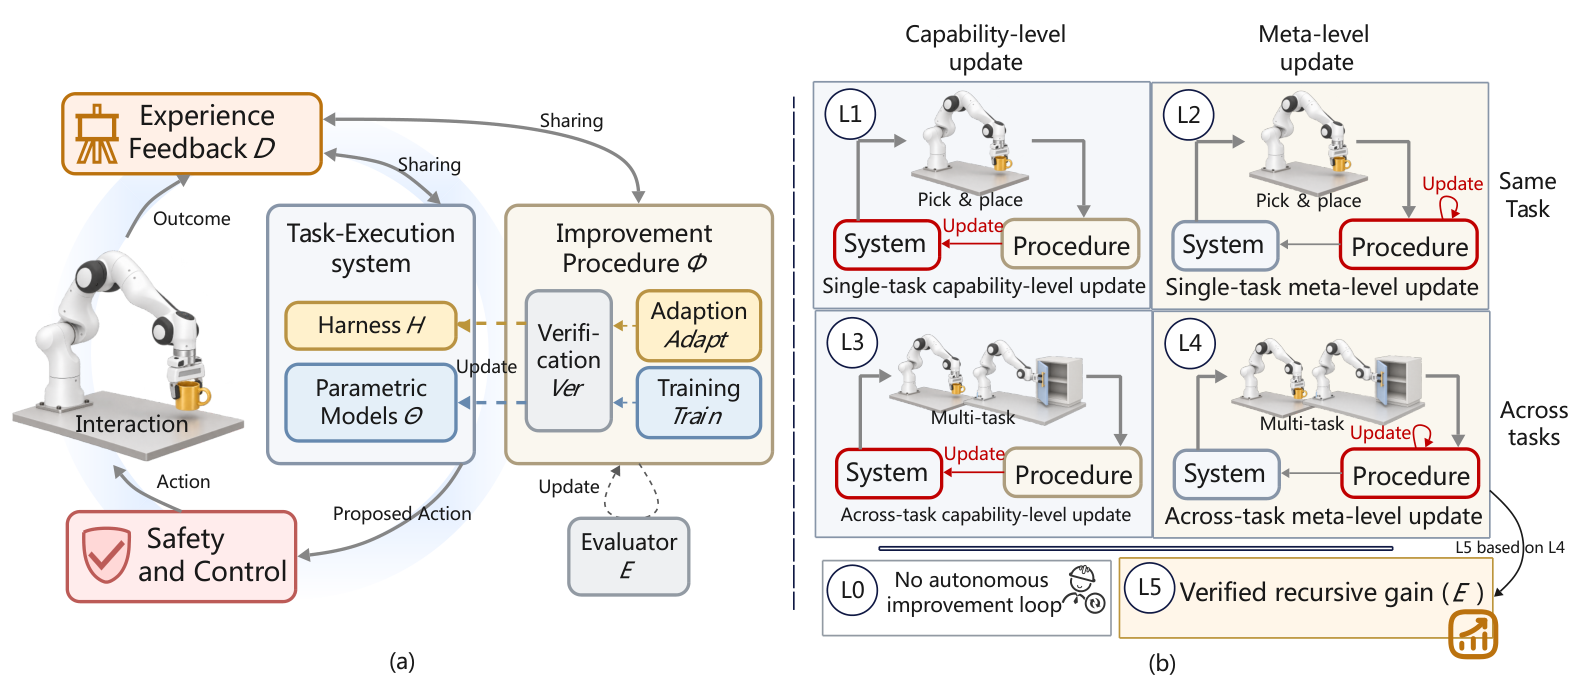
原图Figure 1,官方v1。先沿左图从执行系统经过安全控制到机器人交互,结果返回经验库;右侧改进程序读取经验,经Adapt或Train提出改变,再由Ver决定是否继承。下方E站在改进循环之外,尤其用于评价Ver自身的修改。右图横轴区分改什么、纵轴区分收益范围;L4到L5的箭头代表新增的证据要求,不是多运行几轮就能自动升级。
评测数据集与环境。 不适用:本文是框架与综述,没有新增训练或机器人成功率实验。Table 4列举LIBERO、Meta-World及RSI相关评测资源,属于文献梳理,不能记为本文实际跑过的测试。七类协议的归类是作者对已有文献的判断,原研究未在本轮逐篇复核。
完整中文摘要
机器人的任务执行越来越自主,但其改进仍主要由人推动。本研究考察物理递归自我改进:物理经验引导机器人能力与改进程序的持久更新,使后续改进在跨任务情境中更有效。该方向面临观测噪声、连续动力学、昂贵试验和不可逆后果的挑战。我们提出L0–L5框架,区分能力层与元层更新,以及任务内与跨任务收益,并将L5保留给经过独立验证的递归增益。我们围绕外部执行程序适应和模型训练梳理已有方法,同时考察约束执行与连续更新的安全控制机制。分析表明,尽管自我改进已有显著进展,所综述文献还未展示满足本框架定义的物理RSI。我们提出可靠反馈、因果归因、安全保持及基准建设等研究重点,描绘让机器人在保证安全的同时自主改进其学习方式的路径。Physical RSI的GitHub仓库为https://github.com/SAIL-Research-Lab/Physical-RSI。阅读依据。 原论文 v1:§2定义1–2与任务身份、Figures 1–3、§5安全边界、§6核验与评估。
Δ-MOPD:多位教师究竟该教来什么
作者:Hejian Sang、Zhengze Zhou、Shayan Mohajer Hamidi、Xiaomin Li、Rohit Jain、Alborz Geramifard。机构:Iowa State University、LinkedIn、Harvard University。 发表:2026-10-07(UTC);核对版本:v1。
假设一个小模型既要解数学题,又要遵循指令,你准备让不同专家教它。学生先自己生成回答,教师在这些回答的每个位置给出词元分布,训练再把学生拉向教师。但更大的教师不仅带来后训练学到的技巧,也带来其原有基座的偏好;几位教师一起教时,较强的一股拉力可能盖过其余信号。
Δ-MOPD把每位教师与它进入本次后训练前的精确检查点配对,在学生访问的同一前缀上相减两者的logit。再将这些变化加到学生冻结初始模型的logit上,统一softmax成目标分布。学生通过逐token反向KL形式的在线蒸馏更新参数,教师、教师基座及学生初始锚点都不更新。若某位教师恰好从学生初始模型训练而来,这一改法就退化为原有终点监督;真正改变的是异源教师的贡献。
本文固定教师选择、提示与更新预算,比较完整教师终点和教师相对变化。三教师组合的数学宏平均比终点组合高4.11个百分点,五基准宏平均高1.95个百分点;双教师综合准确率则相近。分阶段路由的两种训练顺序都改善,顺序间差距从10.50降至6.42个百分点;每次只用一名教师的交错路由只有接近的表现。这说明蒸馏目标构造是一条与“选哪个教师”分开的设计轴。
变化量仍同时包含能力、风格与校准,不等于纯能力差分。主要配对实验只替换Polaris这一异源教师,其基座仍属同一模型谱系;不能据此断言任意异构专家都能相加。方法还需要教师精确前身及兼容词表,跨tokenizer四教师扩展没有同等配对终点对照。增加前身评分会让单次更新变慢,较少更新达到同等能力与更便宜的一步训练是两件事。
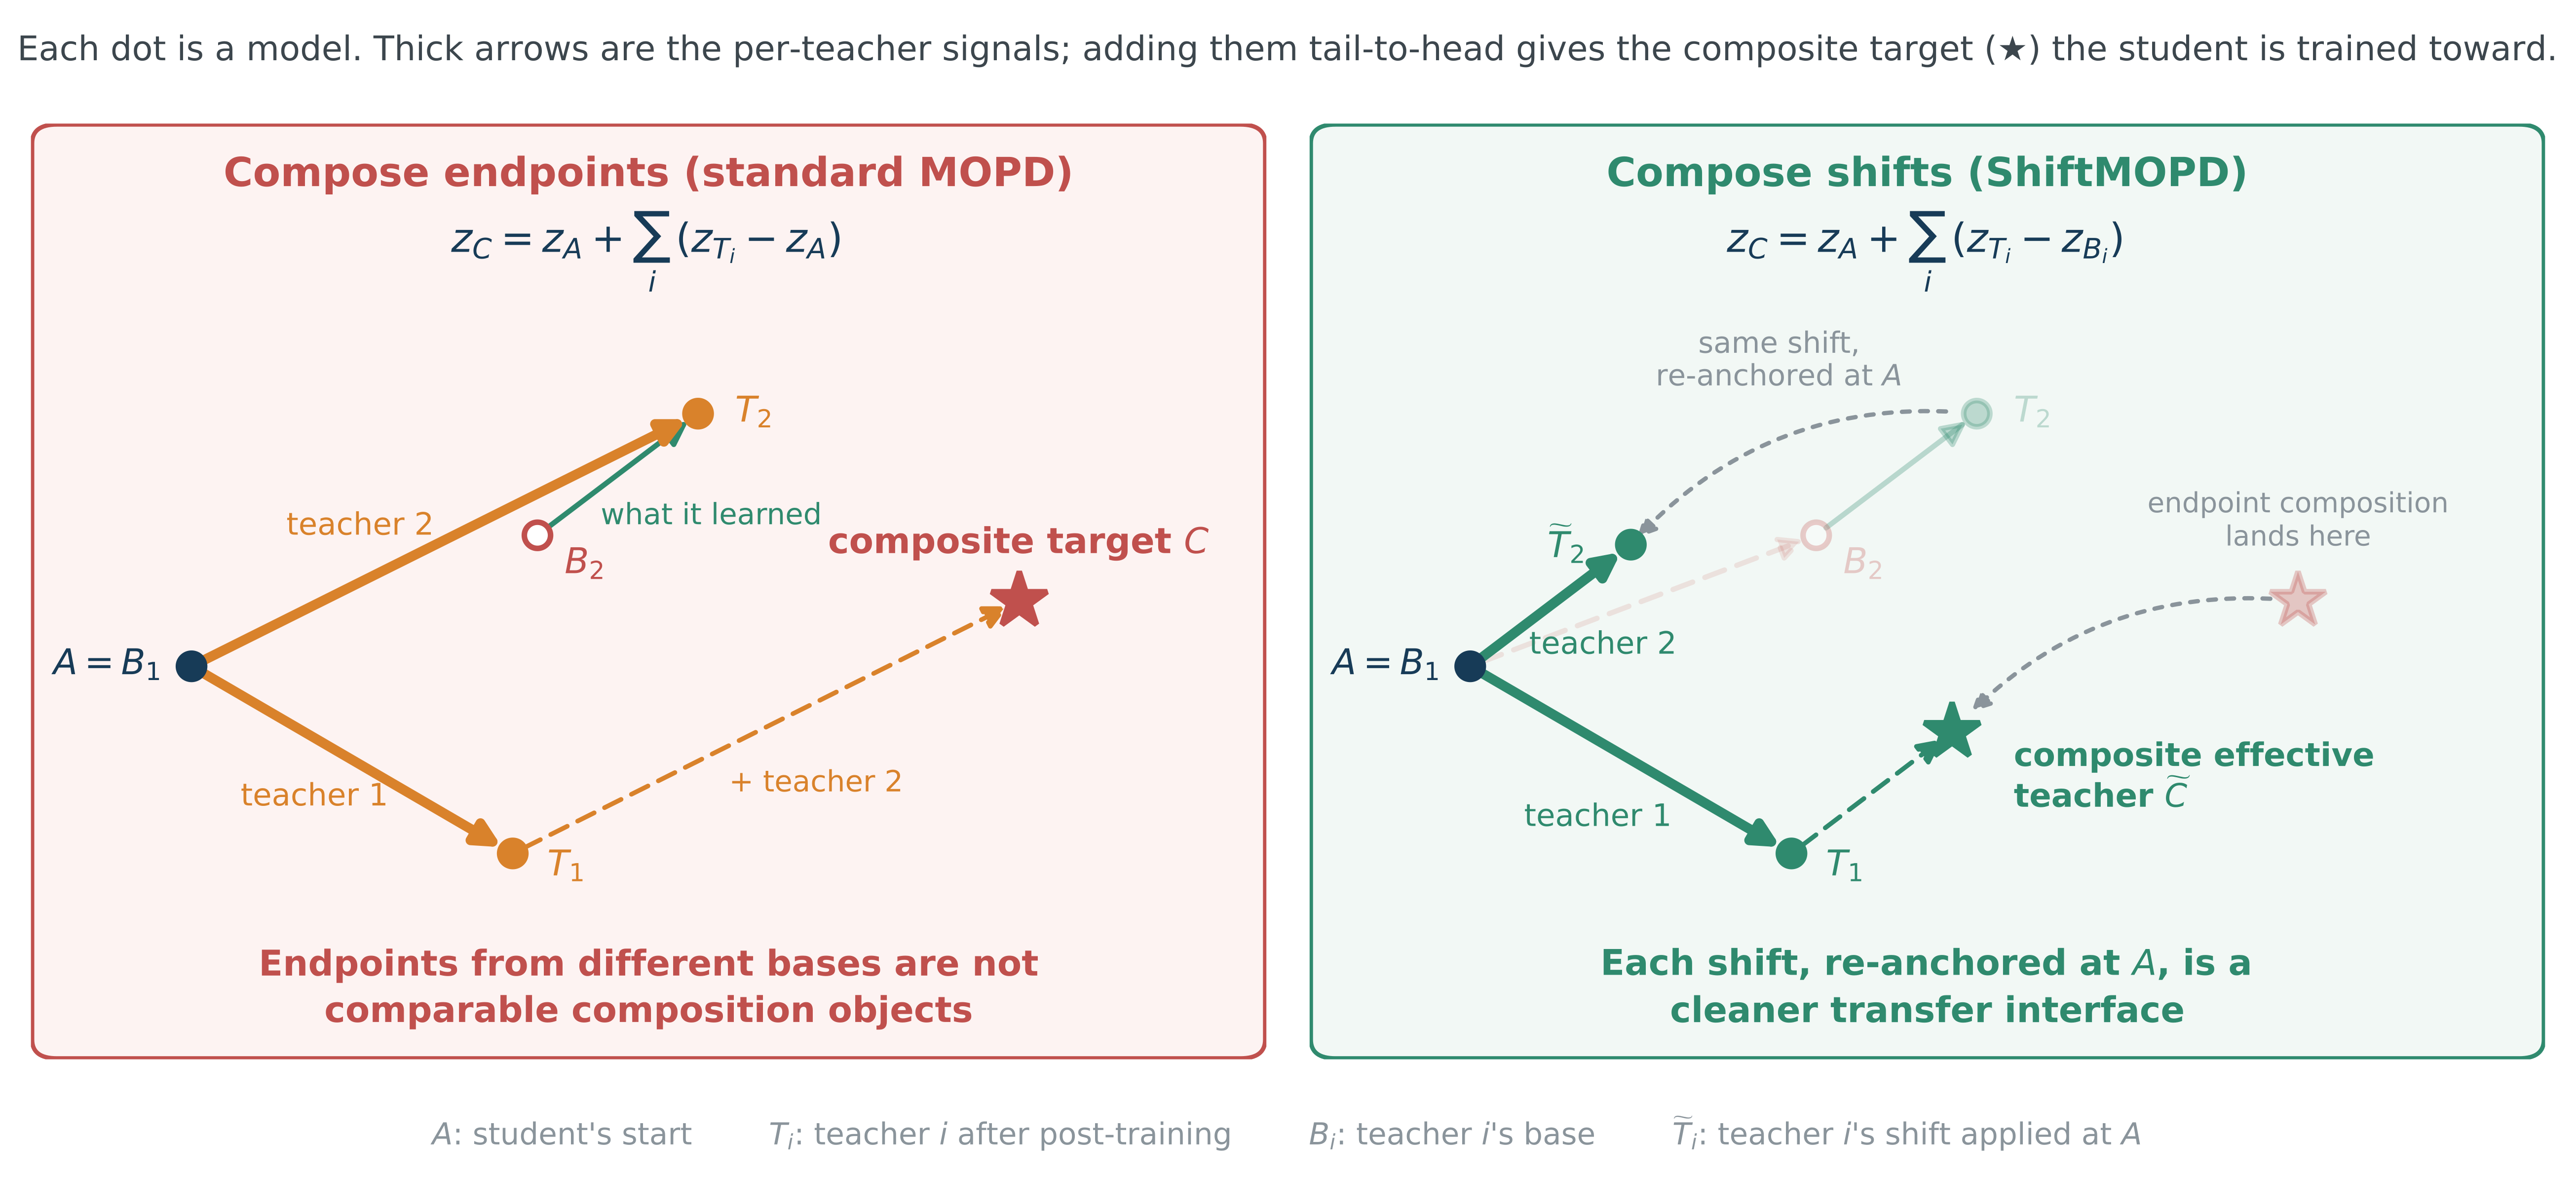
原图Figure 1,官方v1 SVG完整渲染。先看左边从学生起点A指向教师T2的长箭头:它同时跨过基座差异和后训练变化。右边只把B2到T2的绿色变化平移到A,再和教师1的变化相加,得到新的星形目标。图表示的是同一前缀上的输出空间示意,不是直接把模型权重相加;归一化与学生更新由正文给出。
评测数据集与环境。 AMC2023 40题、MATH-500 500题、AIME2025 30题、GPQA-Diamond 198题、IFEval 541题,合计1,309个固定测试项。获取与机制实验的Avg@K分别采用16/1/16/4/4次,扩展和路由实验使用greedy pass@1;五基准宏平均逐基准等权。BigMath、TextbookReasoning及Llama-Nemotron IF是训练提示来源,不能混成测试。带误差条条目为五个独立训练种子的均值与样本标准差,不外推到所有表格。
完整中文摘要
多教师在线策略蒸馏用于两种情境:同领域组合中,多位教师为同一提示领域的学生rollout评分,并合成单一目标;路由领域蒸馏中,不同领域提示分配给对应专家。两者通常传递教师的最终策略,把后训练改变与教师基座继承的偏好混在一起。我们提出Δ-MOPD,将教师减基座的logit变化重新锚定到学生冻结初始化,并在两种情境下固定教师选择,与终点监督比较。我们首先展示妨碍终点迁移的机制:继承的基座拉力可能大于后训练变化;去掉它会降低教师项范数比以及目标与学生间KL。实验表明,变化目标在同一状态组合多个教师信号时尤其有用。三个教师组合时,Δ-MOPD比终点组合高4.11个数学百分点和1.95个五基准百分点;两个教师时准确率相当。分阶段路由下,两种顺序平均表现都更好,观察到的顺序差距从10.50降至6.42个百分点;交错路由每次更新只涉及一个教师,两种目标表现相当。分阶段结果提供了支持性证据,表明收益可能扩展到跨训练阶段积累的信号。目标构造因此是多教师在线蒸馏中独立于教师选择的一条设计维度。阅读依据。 原论文 v1:§3–6、Figure 1、Tables 2–5、附录B/E/F。