Who Verifies the Verifier? Co-Evolving Inspectable Graders with Self-Improving Agents
作者:Xing Zhang, Guanghui Wang, Yanwei Cui, Ziyuan Li, Wei Qiu, Bing Zhu, Peiyang He
机构:AWS Forward Deployed Engineering;HSBC Holdings Plc. / HSBC Technology Center, China(首页)
首次发表:2026-10-08;本次核对 v1。
让 Agent 反复写报告,每轮把失败总结为可复用技能,下一轮再调用。困难在于报告没有单元测试:如果用于判错的评分器也由系统自己修改,成绩上涨究竟说明报告更好,还是评分器更容易放行?
作者把评分器保存成可读的检测器组合:有的检查语法,有的实际执行,有的只让模型判断一种语义错误。系统从漏检和检测器分歧中归纳失败类型,生成新检测器;仅来自无标签分歧的检测器先进入影子池,证明能提高十个固定锚定样例上的一致性后才可被选用。组合搜索同时考虑锚定一致性、无标签输出上的可靠性加权共识和复杂度,拒绝全部通过、全部失败或全部弃权的退化组合。随后,当前评分器给技能循环提供失败类型,技能文字被保存并用于下一批任务;模型参数不更新,外层选择规则、任务参考和技能回滚锚点保持固定。
本文与人工初始组合、其中的单一 LLM judge、移除锚定保护及移除检测器生命周期的设置比较。最有价值的增量是分开测量评分器和执行者:移除锚定保护会产生几乎全部放行的评分器,但下游技能分数没有随之崩溃。无筛选练习本身也可能让技能变好,因此不能再拿任务分数作为评分器正确性的替代证据。
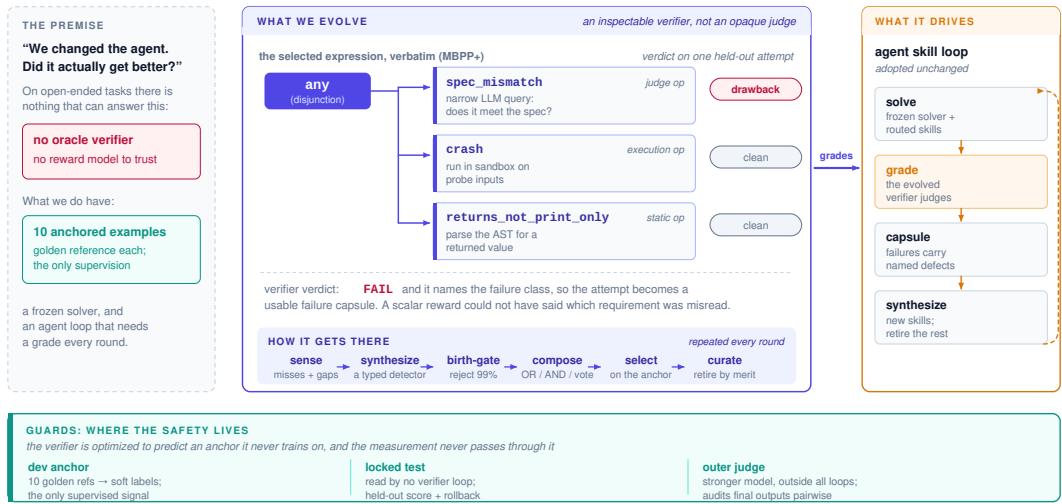
Figure 1,v1,第3页。 原文
从左侧十个带参考的锚定例子开始看。中间蓝框把三个检测器组合为一个判错表达式,任一检测器指出问题就得到具名缺陷;右侧技能循环把该缺陷变为失败记录,再合成和保留技能。底部绿色区域不是可演化对象:开发锚点约束搜索,锁定参考检查评分器,外部 judge 审计最终输出。正文进一步说明,锁定集合仍被技能回滚使用,不能把整套系统说成从未接触测试。
MBPP+ 上评分器一致性从约 0.417 到 0.625,三个 seed 方向一致,但按任务聚类检验的峰值 p=0.12,不能写成显著提升。每个领域仅有 40–48 个任务用于技能评估,且该集合也参与技能回滚;峰值又从该集合选出,绝对成绩偏乐观。报告修复同时增加检测器和重写失败提示,不能把收益归因于检测器单项;外部 judge 的任务感知 rubric 是事后修订,也不是独立确认。
评测数据集与环境。 MBPP+:筛除冻结模型五次全对的题后,train/dev/test 为 60/10/40,隐藏测试判定;已核实来源:Spider 2.0-Snow;本篇口径:59/10/40,官方执行结果比较,单次生成且各组共享 schema grounding。已核实来源:本文报告生成任务;本篇口径:73/10/48 个段落任务,评分器测试包含 96 个锁定输出项,技能以归一化 rubric 分数测量;均三 seed、100 轮技能更新。开发、技能回滚与评分器最终检验用途不可混同。
完整中文摘要
我们改变了 Agent:它真的变好了吗?每个自我改进循环都会数百次回答这个问题,而答案都来自验证器。开放任务往往没有验证器,因此循环只能使用人工 rubric,或让裸 LLM judge 评价同类模型输出,带来奖励投机与共同盲点。我们让验证器成为演化对象:它是由小型、主要确定性的缺陷检测器组成的可检查表达式;检测器从聚类失败中合成,诞生时受门控,选择依据是与十个锚定参考项的一致性及无标签输出的共识,而不是 Agent 的得分。在 MBPP+ 上,相比人工初始组合,所有 seed 的留出一致性提高约 0.21,最终超过组合内的裸 LLM judge。一个发现应改变共同演化验证器的验证方式:移除锚定保护会使验证器退化成全部放行,但这样的验证器仍能同样有效地训练技能。下游任务分数无法认证自演化验证器。任务分数能回答它是否足以驱动学习;在这方面,演化验证器可以替代部分参考信号。Double Ratchet 将验证器与有生命周期管理的技能循环配对,在代码生成、企业 text-to-SQL 和无参考报告生成中,保留同一循环使用真值或 rubric 所得提升的 88–110%。当演化技能钻报告 rubric 的空子时,外部 judge 发现了问题,增加一个检测器修复了它;而这个 judge 在获得任务契约前,本身也判断错误。阅读依据。 原论文 v1:§3–5,Figure 1,Tables 1–3,Appendices B/D/F。机制与对照依据本文,未将作者主张写成独立新颖性确认。
Tracing the Thoughts of a Coding Agent Playing ARC-AGI-3: Lessons for Continual Learning
作者:Chen Wu, Josh Passenger, Yin Song
机构:AWS(首页三位作者均署名)
首次发表:2026-10-08;本次核对 v1。
让一个编码 Agent 玩没有说明书的格子游戏:它写脚本读取行动日志、推断规则,再输出下一串动作。过关后棋盘和目标变化,旧脚本中的尺寸或方向可能突然失效。真正的问题是,它带走的是游戏规则,还是把上一关的偶然条件也当成了规则?
系统保持模型权重和执行框架不变,每轮仅把日志路径交给分析 Agent。Agent 用脚本重建状态和检验假设,写 actions.json 后由 runner 逐条执行;分数变化就清空尚未执行的动作。跨轮状态主要存在自己写的脚本与笔记中,完整交互日志由框架另行保存。本文新增的是测量协议:以过关时间划分任务边界,给文件标注出生任务,再数新任务是否引用、复制、改写或放弃旧文件,而非提出新的记忆训练算法。
相对于只看游戏得分,文件追踪揭示两种不同的迁移:630 次脚本引用中仅 33 次跨关;很多知识通过复制函数或重新写脚本进入下一关,而不是调用一个不断增长的技能库。对于前关已写、随后实际跨越边界的 2,319 个脚本,1,726 个未再被改写或复用。作者还追踪了方向常量跨关失效的案例:将方向变成必须重新传入的参数,比反复修补固定值更能避免把旧条件带到新关。
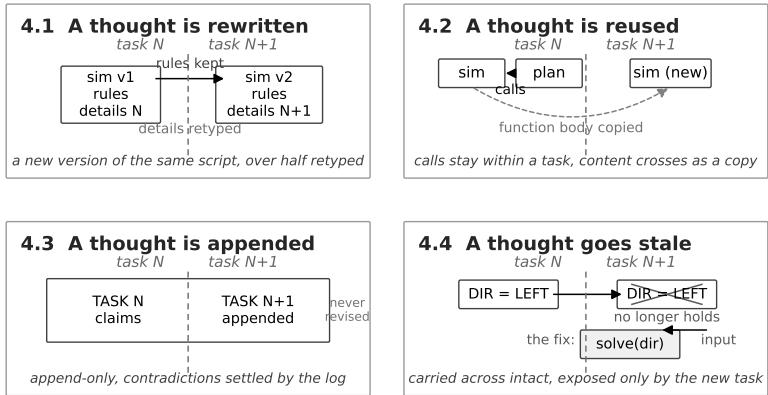
Figure 3,v1,第8页。 原文
四格都从 task N 跨到 task N+1。先看左上,旧模拟器中的规则被留下、关卡细节被重写;再看右上,实线调用留在任务内,虚线表示函数内容跨任务复制。左下说明笔记只追加,矛盾要回到原始日志裁决;右下把同一个方向常量带过边界后失效,修复是在调用时重新提供方向参数。图展示的是被观察到的记录变化,不是四种已经验证优劣的训练策略。
七次运行同时改变骨干、提示、动作上限和运行模式,不是七个同条件重复,不能据此排名模型或作单因素因果结论。所有 689 个边界都在同一游戏内部,不是跨游戏迁移;旧关从未重访,因此丢弃脚本不等于能力遗忘,更不能由此证明没有灾难性遗忘。统计仅见文件里的外显记录,不是模型内部完整思维。正文还出现 4,786 个已归属脚本与 4,907 个文件计数的不同口径,不能混作同一个分母。
评测数据集与环境。 已核实来源:ARC-AGI-3;本篇口径:公共 demo 的 25 个游戏、183 个关卡,七个异质运行观察到 689 个游戏内关卡边界;动作效率采用 RHAE,推理和读日志工具调用不计入游戏动作数。未复测旧关、无跨游戏文件共享;主要分析指标是脚本引用/复制/重写/丢弃计数,而非参数持续学习准确率。
完整中文摘要
我们研究编码 Agent 如何在一串抽象推理任务中学习。它在固定框架中运行冻结基础模型,通过编写和运行 Python、shell 脚本行动。除写下的材料外,它不保留跨轮状态,因此每个形成、携带、纠正或放弃的想法都留下记录;这里的想法指写入文件的信念、规则或计划。我们让它玩没有说明的 ARC-AGI-3 交互推理游戏。每个游戏由多关组成,上一关成功的策略可能在下一关失败,因此每个新关都可视为新任务。Agent 用脚本和文字笔记记录知识,框架保留全部动作和观察。我们的贡献是从形成到纠正或放弃,沿文件追踪想法的测量协议,并将其应用于来自两个模型家族、三种骨干的七次评估运行。一个任务写的脚本很少在后续任务再次被引用,630 次引用中仅 33 次跨任务,因为多数脚本嵌入当前关卡状态。Agent 往往把知识重写进新脚本,保留一般规则、放弃关卡细节,并丢弃边界之前写下脚本中的 74%。只有模型阅读的笔记从不修订:它不断追加、不删除旧主张,积累的矛盾由日志裁决。由于日志保存一切,遗忘表现为选择性丢弃,而非证据消失。代价最高的错误是把硬编码值带到它不再成立的任务。这些发现来自 Agent 写下的文件,无需访问模型,构成对其持续学习外显过程的白盒分析。阅读依据。 原论文 v1:§3.1–3.4、§4.1–4.4,Tables 1–3,Figure 3。机制与对照依据本文,未将作者主张写成独立新颖性确认。
Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
作者:Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee
机构:Adobe Research;University of California, Los Angeles(首页)
首次发表:2026-10-13T17:59:51+00:00(UTC);本次核对 v1。
给 Agent 一堆混乱的零售数据,让它重建正确的 SQLite 仓库。它可能修好了表结构和大部分记录,却在提交前耗尽上下文;如果只奖励最终通过,这次尝试与完全没做事一样都是零分。Tev 想让这些部分成功成为可验证的训练信号。
作者先生成一个完整正确的隐藏数据世界,再构造带依赖的工作流程,渲染干净文件并施加可逆损坏。任务输入、最终检查器和进度规则都由同一个世界派生,避免各自生成后互不一致。训练时,Agent 每轮运行 bash 改工作区;评分器按流程节点计算已完成程度,未满足前置条件的节点不能提前拿满分。逐轮奖励是进度势的增量,最终还加提交成功奖励;实际总奖励等于成功指示加 0.25 倍终点进度。DPPO 更新执行模型参数,以逐轮 return-to-go 和同轮组内基线分配信用;因此同组全部失败时,只要最终进度不同仍可学习。任务生成器、隐藏真值及评分程序没有随策略递归改写。
本文在同一 Tev-Gym 上比较终点稀疏奖励、按整轨迹归一化的进度奖励、直接重复奖励当前进度,以及完整逐轮塑形。9B 消融中,完整方法 ALE-CM 平均分为 0.29,稀疏奖励为 0.25;作者报告 27B 稀疏设置因几乎全是零优势组而未完成一个优化步。这支持中间信号对极难任务的训练价值,但增量包含进度构造、return-to-go 和归一化方式,不宜简化为“给过程分就有效”。
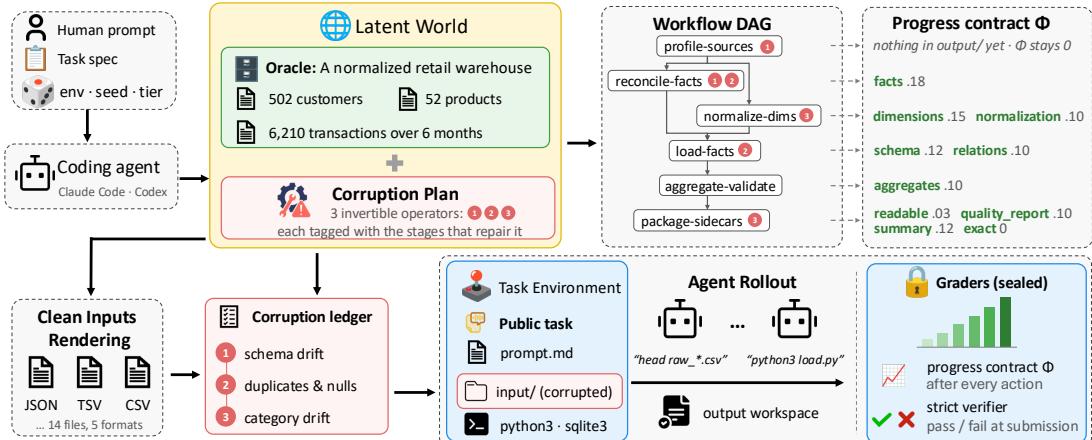
Figure 3,v1,第4页。 原文
从左上的任务规范进入隐藏世界:先有正确仓库和损坏计划,再沿下方生成 Agent 真正看到的脏文件。上方 DAG 把恢复过程拆成有依赖的工作阶段,右侧进度契约给这些阶段定义可检查状态。Agent 的每次操作只改变公开工作区,密封的进度评分器在右端测量变化,最终严格验证器另行判断提交。它不是把答案交给执行模型,而是让训练端持有能够检查部分完成的参考。
PPRS 保留终点势,明确改变随机策略的优化目标,不享有经典 PBRS 的原目标不变保证。9B/27B 分别使用 264 个较易环境和全量 1,170 个环境,跨规模不是只改参数量的对照。主要消融在 9B、单训练 seed;ALE-CM 只有 18 题,TB 3.0/4.0 只测领域与运行环境筛选后的 22/18 题。前沿模型采用各自原生框架,27B 与基座的同框架比较更适合归因;词面无重叠不能证明所有结构性泄漏都不存在。
评测数据集与环境。 已核实来源:Tev-Gym 与 ALE-CM 本文规格;本篇口径:训练环境 1,170 个、7 领域,9B 仅用 unit tier 的 264 个;ALE-CM 18 题来自 23 题 computing/math split 中可在 Linux 容器运行的部分,每题 5 rollout,报告平均分 S@1 和完全通过 P@1 及 best-of-5,非 18×5 个不同任务。已核实来源:TB 3.0-CM 的任务清单;本篇口径:22 题。Terminal-Bench 4.0:CM 子集 18 题;Terminal-Bench 2.1:89 题、5 trials。27B 的 TB 2.1 用 Terminus-2,9B 用 Vanillux2;不可混为同一框架排行榜。
完整中文摘要
长程 Agent 因能够在有经济价值的任务上自主工作数小时乃至数天而受到关注,这种能力对于自动发现和递归自我改进很重要。然而开放模型仍受限于训练数据和可行训练方案:复杂长任务难以构造、验证,奖励也很稀疏。我们同时解决这两方面。首先提出 Tev-Gym,包含七个领域的 1,170 个经过验证、具有稠密渐进奖励的长程任务环境。它采用先构造潜在世界的方法,先建立任务领域、工作流程和每步预期状态的完整正确隐藏规范,再从规范逐步渲染面向 Agent 的环境,从而控制复杂度并得到自然的进度指标。其次,通过进度势奖励塑形 PPRS 把进度转成逐步稠密奖励,提高训练效率并让原本难以训练的任务可训练。该方案得到 Tev-27B,在 Agents’ Last Exam 计算与数学科学领域 ALE-CM 上明显提高,Pass@5 达到文中 GPT-6 Astra 和 Claude Opus 5 的水平。虽然只用 ALE 相关数据训练,它仍泛化到 Terminal-Bench 3.0 与 4.0 子集,超过文中 GLM 5.2 与 Gemini 3.7 Flash,并在 TB 2.1 等中等时长任务上达到文中 Claude Opus 4.8 的水平。阅读依据。 原论文 v1:§2–4、Eq. (3)–(4)、Figure 3、Table 5、Appendices A.6/A.9/B/C.1–C.2。机制与对照依据本文,未将作者主张写成独立新颖性确认。
Two Clocks: Why Larger Rollout Batches Learn Slower but Fail on Schedule in Reinforcement Learning with Verifiable Rewards
作者:Yuante Li, Junwei Quan, Kai Qiu, Kate Zhang, Yicheng Tao
机构:Carnegie Mellon University;University of Toronto(首页)
首次发表:2026-10-13T17:58:57+00:00(来源原始时间);本次核对 v1。
用 GRPO 训练数学模型时,一次采更多回答似乎更划算,但同一批回答要被拆成多个 mini-batch 连续更新。第二步开始,当前模型已经偏离生成这些回答的旧策略。即使按 batch 的平方根增大学习率,训练会不会同样快、同样稳?
作者用两个计数器描述训练:到指定准确率消耗多少回答,是进度时钟;首次满足预设崩溃条件前消耗多少回答,是失败时钟。在噪声主导归一化和局部二次损失假设下,大 batch 配更大学习率意味着更少但更长的更新步,每个样本的一阶位移相近,却因曲率损失更多有效进步。另加累计漂移达到阈值的假设,推出不加 ratio clip 时崩溃样本数沿平方根规则近似不变。clip 抑制偏离过大的 token 更新,主要换来稳定性。实际建议是在较小、仍高效的 batch 学习,接近失败风险前切大 batch,同时重置优化器并重新 warm-up。
本文与固定 batch、去掉或放宽 ratio clip、相同检查点与数据的回放对照。每 rollout 八次更新时,512 到 4,096 的 batch 变化会拖慢达到同准确率的进度;去掉 clip 后差距仍在,所以不能只归咎于截断梯度。无 clip 设置中,大 batch 只经历少量优化步就失败,小 batch 步数多得多,但消耗的回答数接近。两段 batch 调度接近最好固定 batch 的结果,同时约四分之三回答在大 batch 阶段生成。
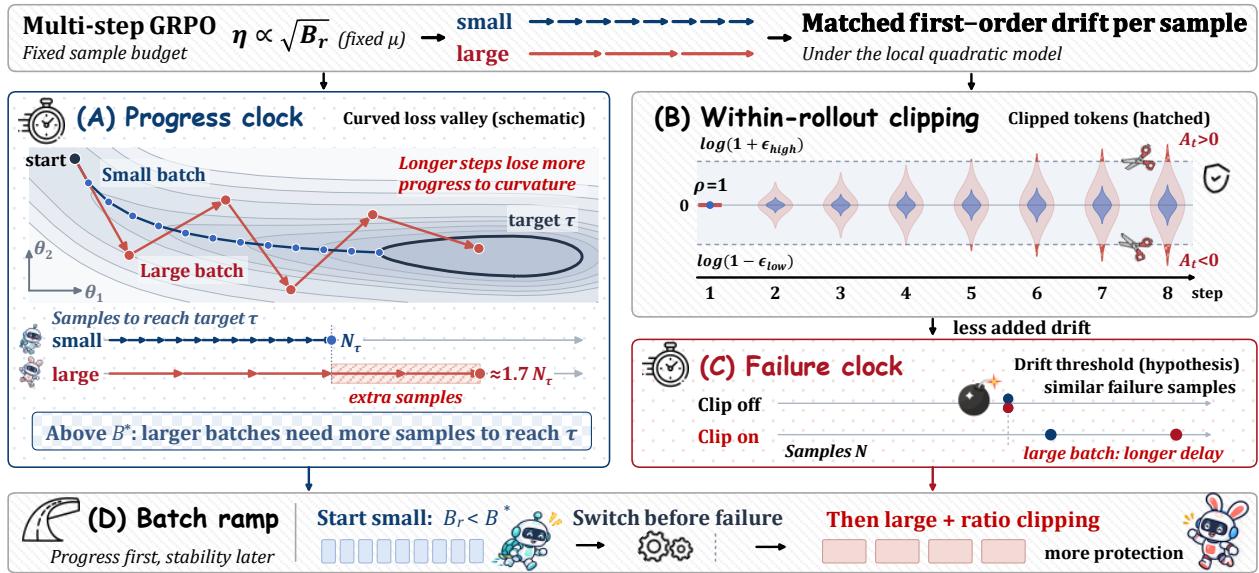
Figure 2,v1,第4页。 原文
先看左侧曲面:红色大 batch 用更少、更长的步子移动,相同一阶位移未换来相同的目标接近程度。右上展示同一 rollout 内更新越多,token 概率比越容易越过 clip 边界;右下把这个稳定作用放到按回答数计的失败时钟。最下方才是推导出的调度:先在临界 batch 以下取得进度,再切换到带 clip 的大 batch。图中漂移阈值明确标为假设,不是已测出的普适物理量。
理论是局部近似,失败时钟另依赖漂移阈值假设,不能当作所有训练的定律。主要证据来自 Qwen 家族数学任务;部分主设置两 seed,跨数据集、通用 checkpoint 和 7B 复验只有一 seed。曲率项没有直接完整测量,结论依靠可检验预测;回答数匹配不等于 token、GPU 时间或墙钟匹配。调度同时重置优化器和 warm-up,不能把全部收益独归 batch 改变。
评测数据集与环境。 DAPO-Math-17k:主要训练数据,另用已核实来源:DeepScaleR-Preview(本文 §4、Appendix B) 做第二数据集复验。本篇评估是 512 个留出问题、每题四次采样 mean@4,每消耗 8,192 个回答测一次;通常预算 98,304 个回答,G=8,每回答最长 3,072 token。失败优先定义为准确率降至此前最好值的一半以下,否则用持续梯度范数异常;未失败者是右删失,不能记为无限稳定。未提供独立测试清单版本,保留该复现缺口。
完整中文摘要
可验证奖励强化学习依赖昂贵的模型生成回答,因此常增大 rollout batch 并按平方根规则缩放学习率。已有研究称,在每 rollout 只做一次优化器更新时,该规则近似保持逐样本进度,但实际多步训练中的情况尚不清楚。我们提出双时钟框架,区分取得进步所需样本和崩溃前消耗样本。在局部二次模型下,平方根规则保持逐样本一阶漂移,却不保持进度:大 batch 做更少、更长的更新,曲率带来的损失更大,因此存在依赖学习率的临界 batch,超过它会降低样本效率。漂移阈值假设预测另一条失败时钟:沿平方根规则,失败前样本数近似不变。在 Qwen2.5-Math-1.5B 上跨 16 倍 batch 范围的受控 GRPO 实验支持两个预测。概率比裁剪推迟失败,对大 batch 尤其明显,但去掉裁剪后进度差距仍存在。放宽裁剪用稳定性换取短暂速度收益。另一数据集、通用 checkpoint 和 7B 模型也重现进度差距。最后,我们用双时钟框架导出简单多步 RLVR 调度:从临界 batch 以下开始,在失败前切到更大 batch。代码已提供。阅读依据。 原论文 v1:§2–6,Figure 2,Tables 2–5,Appendices A/B/D/F/G,Limitations。机制与对照依据本文,未将作者主张写成独立新颖性确认。
SkillScaffold: Scaffolding Agentic Reinforcement Learning with Policy-Adaptive Skill Credit Assignment and Selective Injection
作者:Wenlin Zhong, Hao Wang, Kun Yuan, Fan Yang, Jinluan Yang, Dian Jin, Xu Tan, Yiquan Wu, Kun Kuang
机构:Zhejiang University;University of the Chinese Academy of Sciences;Kuaishou Technology;Zhejiang University of Science and Technology(首页)
首次发表:2026-10-13T17:46:25+00:00(来源原始时间);本次核对 v1。
训练一个家庭任务 Agent,把脏物品清洁后放到指定位置。四次无提示尝试有成有败,你可以总结几条技能再帮助它探索,但一条看似合理的提醒也可能让本来会做的模型走错。问题不是能否生成技能,而是这条技能对当前模型、当前任务是否真的有帮助。
共享模型先以执行者身份采四条不带技能的 Scout 轨迹,由环境标注成败,再以生成者身份提出四条技能。它不为每个候选重新跑环境,而是在同一批固定轨迹上比较加技能与不加技能时,模型对自身推理和动作 token 的平均对数似然差。成功轨迹更可能、失败轨迹更不可能,对应较高效用;只有最佳候选效用大于零才注入四条新的执行轨迹,否则继续不带技能。执行者用环境奖励做 GRPO,生成者用停止梯度的效用做另一组 GRPO,两组优势独立归一化并共同更新同一参数。部署时去掉生成、评分和技能注入,只保留更新后的执行模型。
本文与普通 GRPO、技能RL以及随机选技能、打乱技能效用配对、强制注入、关闭生成者学习等设置比较。ALFWorld 完整方法成功率 94.8%,去掉拒绝门后为 85.8%;固定候选集的独立 rollout 检查也显示,只挑最高分不如允许不注入。相对于把所有技能视为有益,关键增量是随当前策略变化估计技能作用,并把这个信号用于生成者学习;收益不依赖部署时继续携带技能库。
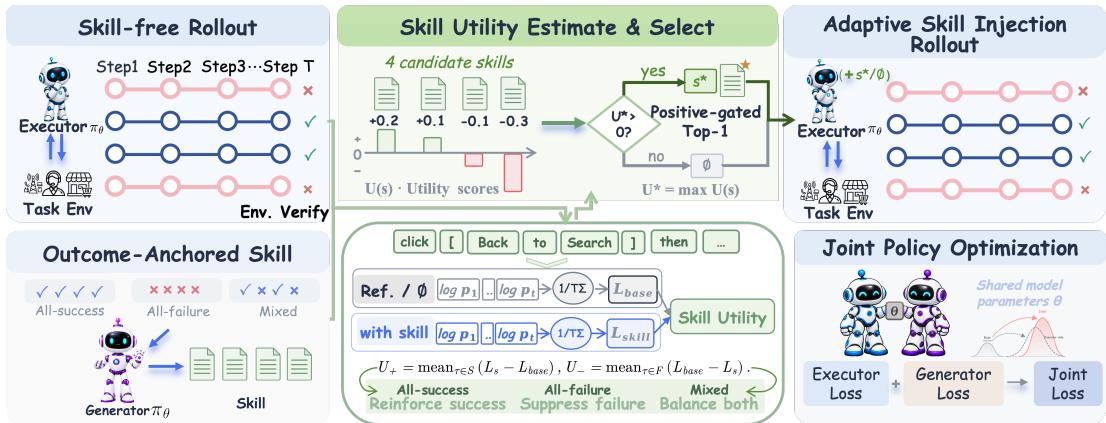
Figure 4,v1,第5页。 原文
从左侧不带技能的 Scout 开始,成败标签进入技能生成;中间评分路径重复读取同一轨迹,只改变技能上下文,避免为每个候选重新执行环境。正效用门决定把哪条技能送往新的 Post-Scout,或走无技能支路。最右端两种奖励各自形成 GRPO 信号后汇入共享参数。图里的技能文本是训练支架,正文明确部署时整条技能路径关闭。
似然效用衡量的是已有轨迹与技能的兼容性,不是直接测得的因果回报。附录下游保证需要额外的局部代理校准和估计误差条件,实验使用阈值零,不能宣称无条件安全选择。内化分析回测早期受技能帮助的训练题,只证明这些题后来可无技能完成;泛化证据应另看 ID/OOD 测试。主要结果为 Qwen3-8B,主表未给多训练 seed 方差;省去候选环境 rollout 仍有生成和重评分开销,不能视为与 GRPO 等总算力。
评测数据集与环境。 ALFWorld:3,553训练任务,134 valid-unseen测试,成功率。WebShop:3,320训练goal,454 ID与207 OOD,按类别划分且Other下采样。ScienceWorld:electricity子集460训练variation、230 ID与155 OOD episode,非全任务套件。τ²-Bench:三领域共900条合成RL训练记录,先用SFT模型过滤全对/全错组;所有RL对照同SFT起点,用户模拟器为DeepSeek-V4-Flash,报告Pass@1,正文未清楚给出本篇最终测试总数,保留缺口。所有主模型Qwen3-8B,均无技能部署。
完整中文摘要
Agentic RL 让语言模型从多轮交互和可验证结果中学习。文字技能可把以往交互压缩为可复用指导,改善探索,但已有方法常假定注入有益,或依靠间接反馈和昂贵 rollout 判断效用。我们的先导研究发现,有限采样下基于 rollout 的技能信用估计既昂贵又不稳定;不同候选作用不同,也依赖当前策略对具体问题的能力。因此提出 SkillScaffold,把低成本技能效用估计与选择性注入结合。它复用结果已验证的训练轨迹生成候选,并用结果感知的似然比较估计效用,无需逐候选环境 rollout。效用决定是否注入以及注入哪条;没有估计为有帮助的候选就不带技能执行。联合训练使生成者能针对不断变化的执行者产生技能,支架式 RL 促进无技能推理所需的内化。ALFWorld、WebShop、ScienceWorld 和 τ²-Bench 实验显示,它在短程及长程任务上优于较强 Agentic RL 和技能RL对照;消融和分析支持效用选择与拒绝注入的重要性。代码已公开。阅读依据。 原论文 v1:§3–5,Eq. (7)–(12),Figure 4,Tables 1–5,Appendices A.1/A.2/C.3。机制与对照依据本文,未将作者主张写成独立新颖性确认。
SEAR: Self-Evolving Agentic Robotics
作者:Xinyi Wang, Bangzheng Li, Hanyu Wang, Lin Zhang, Andrea Yaoyun Cui, Zhenggang Tang, Shyamal Buch, Dejia Xu
机构:Luma AI(首页)
首次发表:2026-10-13T17:40:20+00:00(来源原始时间);本次核对 v1。
让编码 Agent 学会把香蕉放进碗里,它可以不断改抓取代码,并把成功经验存给后续任务。但分数提高可能只因为多试了几次;练习中自己重置场景,也可能总把香蕉放到容易抓的位置。SEAR 追问:保留下来的经验,在新任务和独立布置的场景里还管用吗?
同一框架支持三种执行方式:先写冻结代码作为策略,让模型在线决定动作,或让研究 Agent 收集代码教师轨迹并微调 VLA。跨任务保留版本化技能与文字记忆;自动研究产生的数据和 checkpoint 不跨任务继承。模拟任务开发使用DEV与可回报VAL状态,预算结束后只把冻结策略送到独立judge,在未见TEST状态判分。核心对照把一段长开发与等总时长的三次重启比较,再用空库与继承库之差单独测经验作用,避免把多尝试直接算作学习。
本文的独立价值在于控制层次而非新的记忆组件。RoboLab 上同一个 GPT-5.6-sol,无库为46.9%、自己的库为42.4%、继承Opus库为60.6%,说明“有库”不充分,库里内容甚至会拖累。另一个自探索案例的自建成功检测器会把错误停止规则传给后续任务,显示失败也可被继承。真机中连续十次练习成功仍可能只通过四个独立布置场景,揭示自动重置塑造了练习分布;这与普通多采样不同。
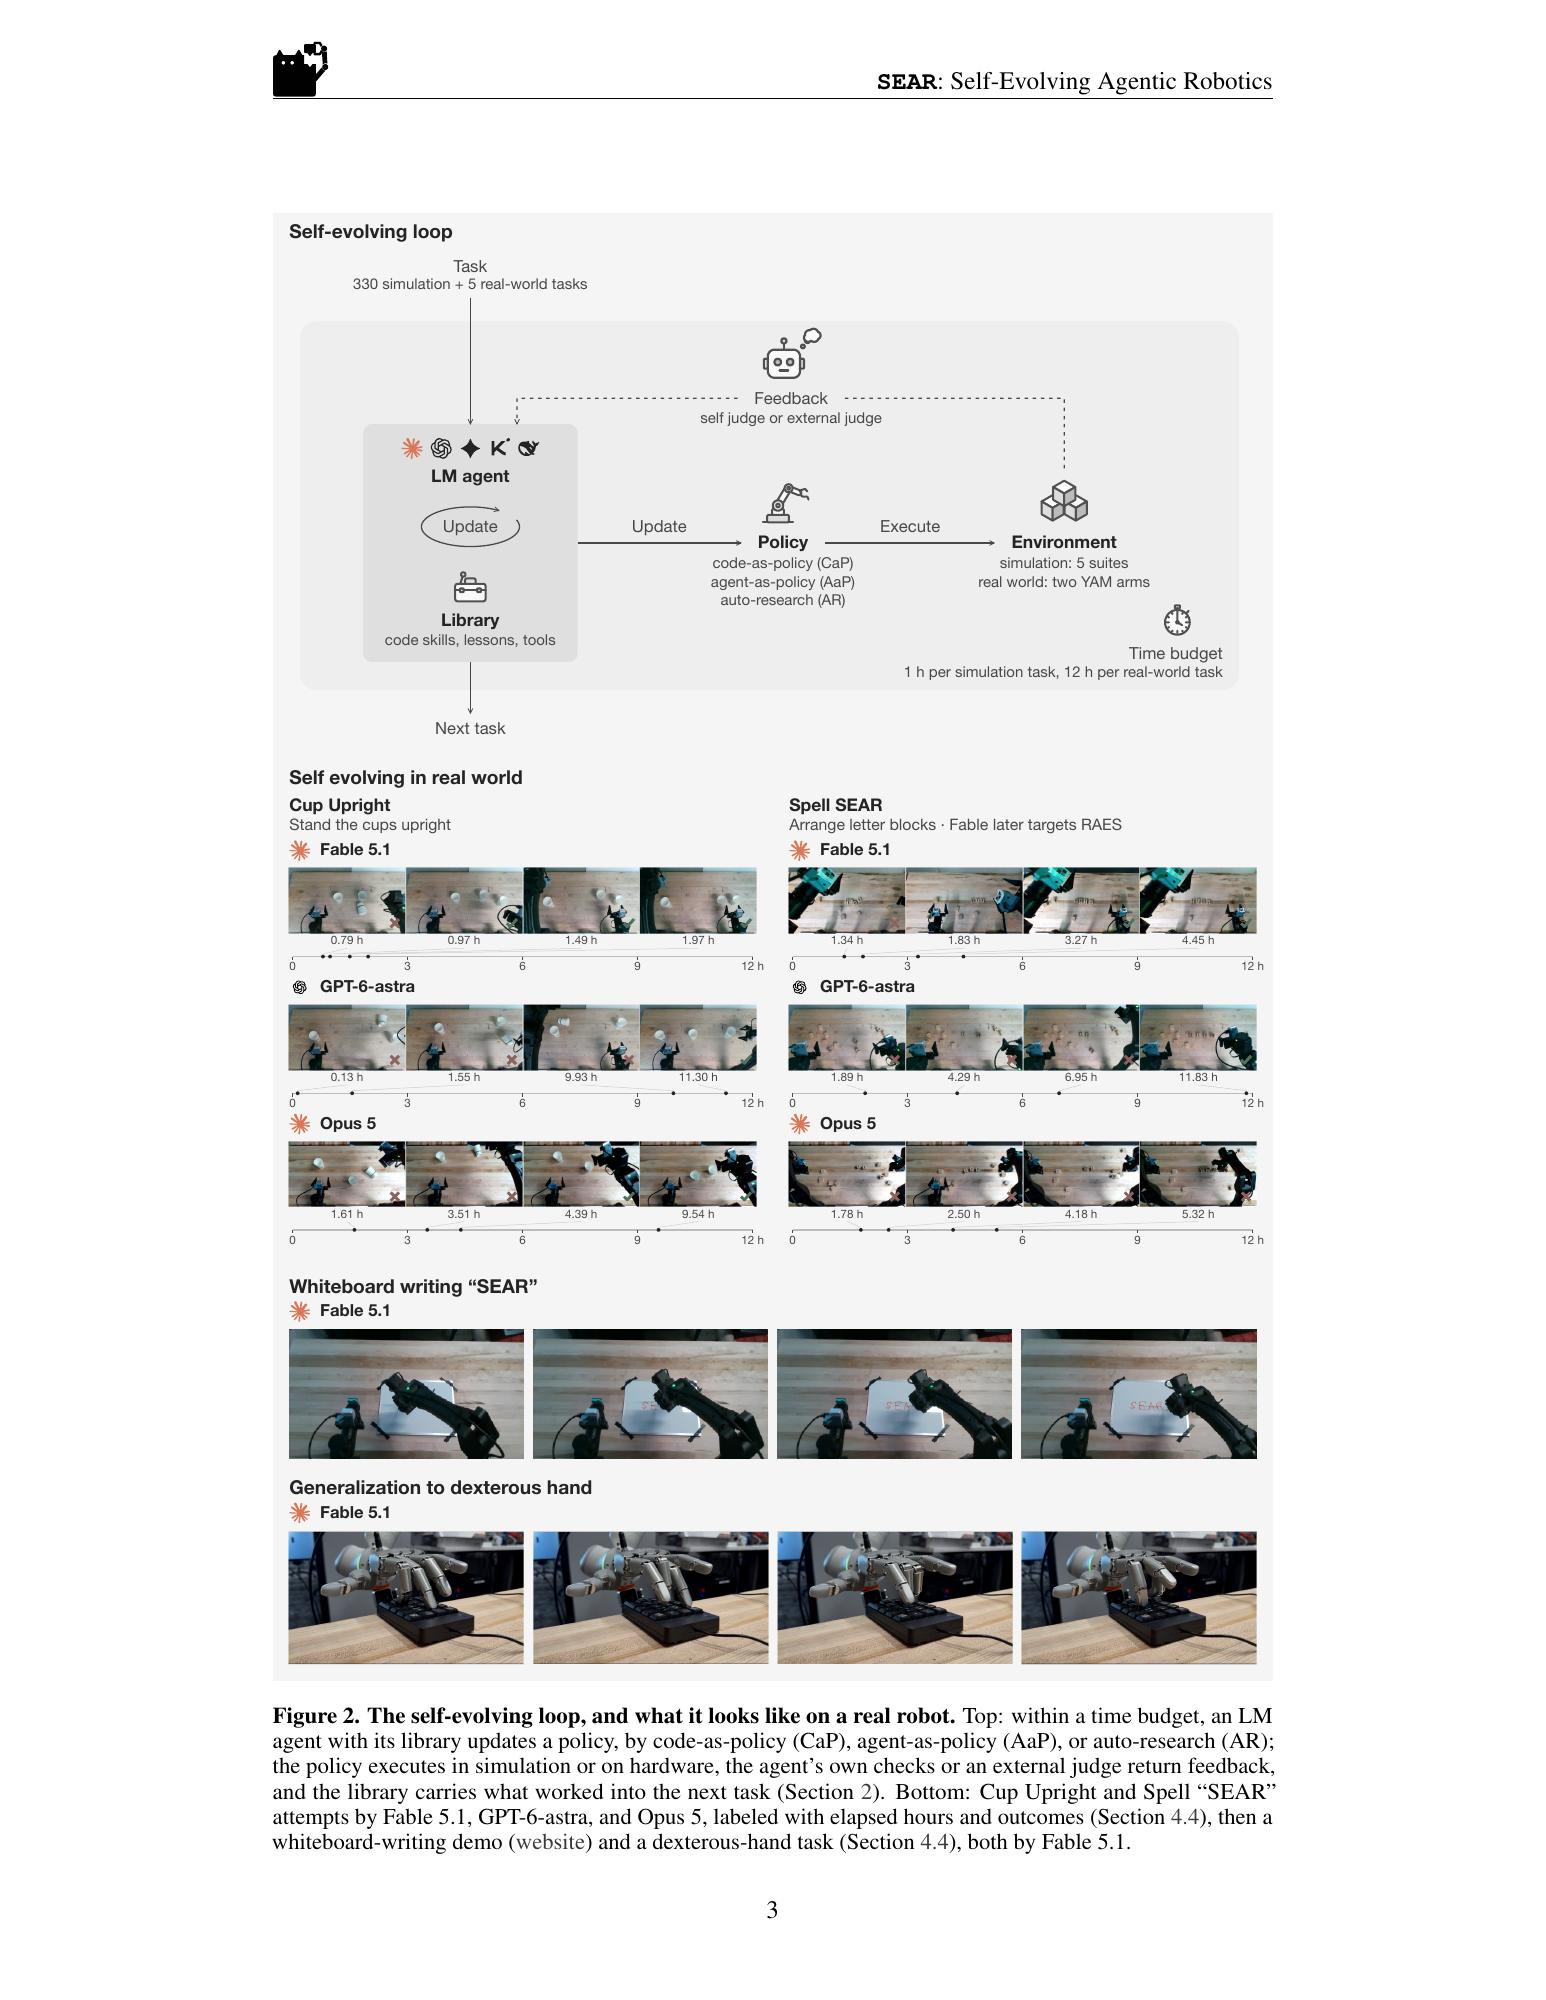
Figure 2,v1,第3页。 原文
从顶部任务进入模型Agent,再沿中间策略到环境看一次执行闭环;反馈返回后既能改策略,也能更新左下技能库。下一任务只继承该库,并非沿用全部训练状态。图下方照片展示实体练习进程,时间戳属于单次练习,不是跨任务迁移曲线。独立TEST、三次重启和空库对照由正文协议定义,不能只看这个闭环图就认定递归增益。
模拟预算匹配的是开发墙钟,不是token、环境步数或GPU总量。多数CaP条件有三次整条运行,但部分自动研究与所有真机设置只做一次练习运行;模型比较还混有不同编码工具。密封judge没有隔绝所有特权信息,作者披露Agent读取静态物体几何文件,运行时成功检查也可作为停止信号。T5真机从空库现场练习,并非仿真技能直接迁移到真机;灵巧手演示证明框架可移植,不证明跨机器人技能迁移。
评测数据集与环境。 LIBERO40任务、LIBERO-PRO160任务;已核实来源:SEAR任务与协议:robosuite 7任务、LIBERO-RIG 18任务/10种故障、RoboLab 105任务,共330模拟任务,每任务10个TEST rollout,开发/验证/最终测试状态分开。CaP通常每任务1小时、RoboLab 2小时,重启基线平分相同总时长。真机5任务每任务最多12小时,CaP每任务10个人工场景、AaP 5个;评分允许0.5部分成功,堆叠按最高塔归一化,不能把总体分直接理解为二元成功率。
完整中文摘要
前沿语言模型Agent已能自行改善机器人:编写控制代码、测试,并把有效内容作为技能和记忆保留给下一任务。我们提出SEAR框架与benchmark,围绕两个问题:Agent真的在学习,还是只是尝试更多次?学到的东西在新任务、新模拟器和真实机器人上还有效吗?框架提供三种模式:代码成为策略、Agent在线控制、或作为研究者微调VLA。评测用控制区分保留经验与重复尝试、熟悉任务、特权模拟状态、更多预算和运气。在七个前沿语言模型、330个模拟任务和五个实体任务、累计超过四年Agent运行时间中,我们强调三点。第一,学习曲线同时取决于总时长和相对模型能力的任务难度;更难任务更值得长会话,较易任务重启短尝试也一样好。第二,控制代码与共享流程能跨任务和模拟器迁移,任务专用解法则不行;真机上Agent自己设计的练习与人类设计的新场景之间存在差距。第三,不同模型适合不同演化方式,有的在线行动更好,有的先写代码更好;纯文本模型也能跟上相近能力的多模态模型,视觉有助于评错,但推理与工具使用可能更重要。我们发布评测和代码库支持后续研究。阅读依据。 原论文 v1:§2–4,Figure 2,Tables 2–4,Appendices A.8–A.9/E/J。机制与对照依据本文,未将作者主张写成独立新颖性确认。
PreciseCoder: Faithful and Generalizable Debugging Beyond Unit-Test Rewards
作者:Yunkai Zhan, Miaosen Chai, Shangshang Wang, Jike Zhong, Yuqing Yang, Deqing Fu, Serina Chang, Wang Bill Zhu
机构:南加州大学、芝加哥大学、Google、加州大学伯克利分校(首页)
首次发表:2026-10-13T17:19:10+00:00(来源原始时间);本次核对 v1。
一个函数只有一行错误,模型把整个函数重写后通过测试。下一次给它本来正确的函数,它仍然改出一个错误。测试通过奖励能教会修复,却没有告诉模型哪些修改没有必要;怎样把这种克制教进去?
每个训练任务有参考修复。作者把预测修改按块对齐参考;评估某块时,将其他错误先用参考修复,再插入这一块跑测试,核验它是否真正修好了对应故障。由此计算修改精确率与故障召回率,测试全部通过时把召回置为一,形成F1信号。测试奖励与F1各自做组内标准化,再以2:1混合并做批级缩放,更新模型参数。它奖励的是经测试验证的必要修改,不是简单扣除补丁行数;参考修复、测试与评分算法在训练中固定。
4B模型的测试通过率从单位测试GRPO的55.1%到55.3±0.9%,平均修改从13.8行降到3.0行;正确代码不修改率从19.3%到48.0±5.8%。消融表明只奖精确率会过度保守,只奖召回又改得过多。在SWE-bench Verified的同一SWE-agent框架下,9B解决率从GRPO的28.1%到32.7%,成功任务相对参考补丁的多余改动从58%降到29%,说明局部训练有仓库级迁移证据。
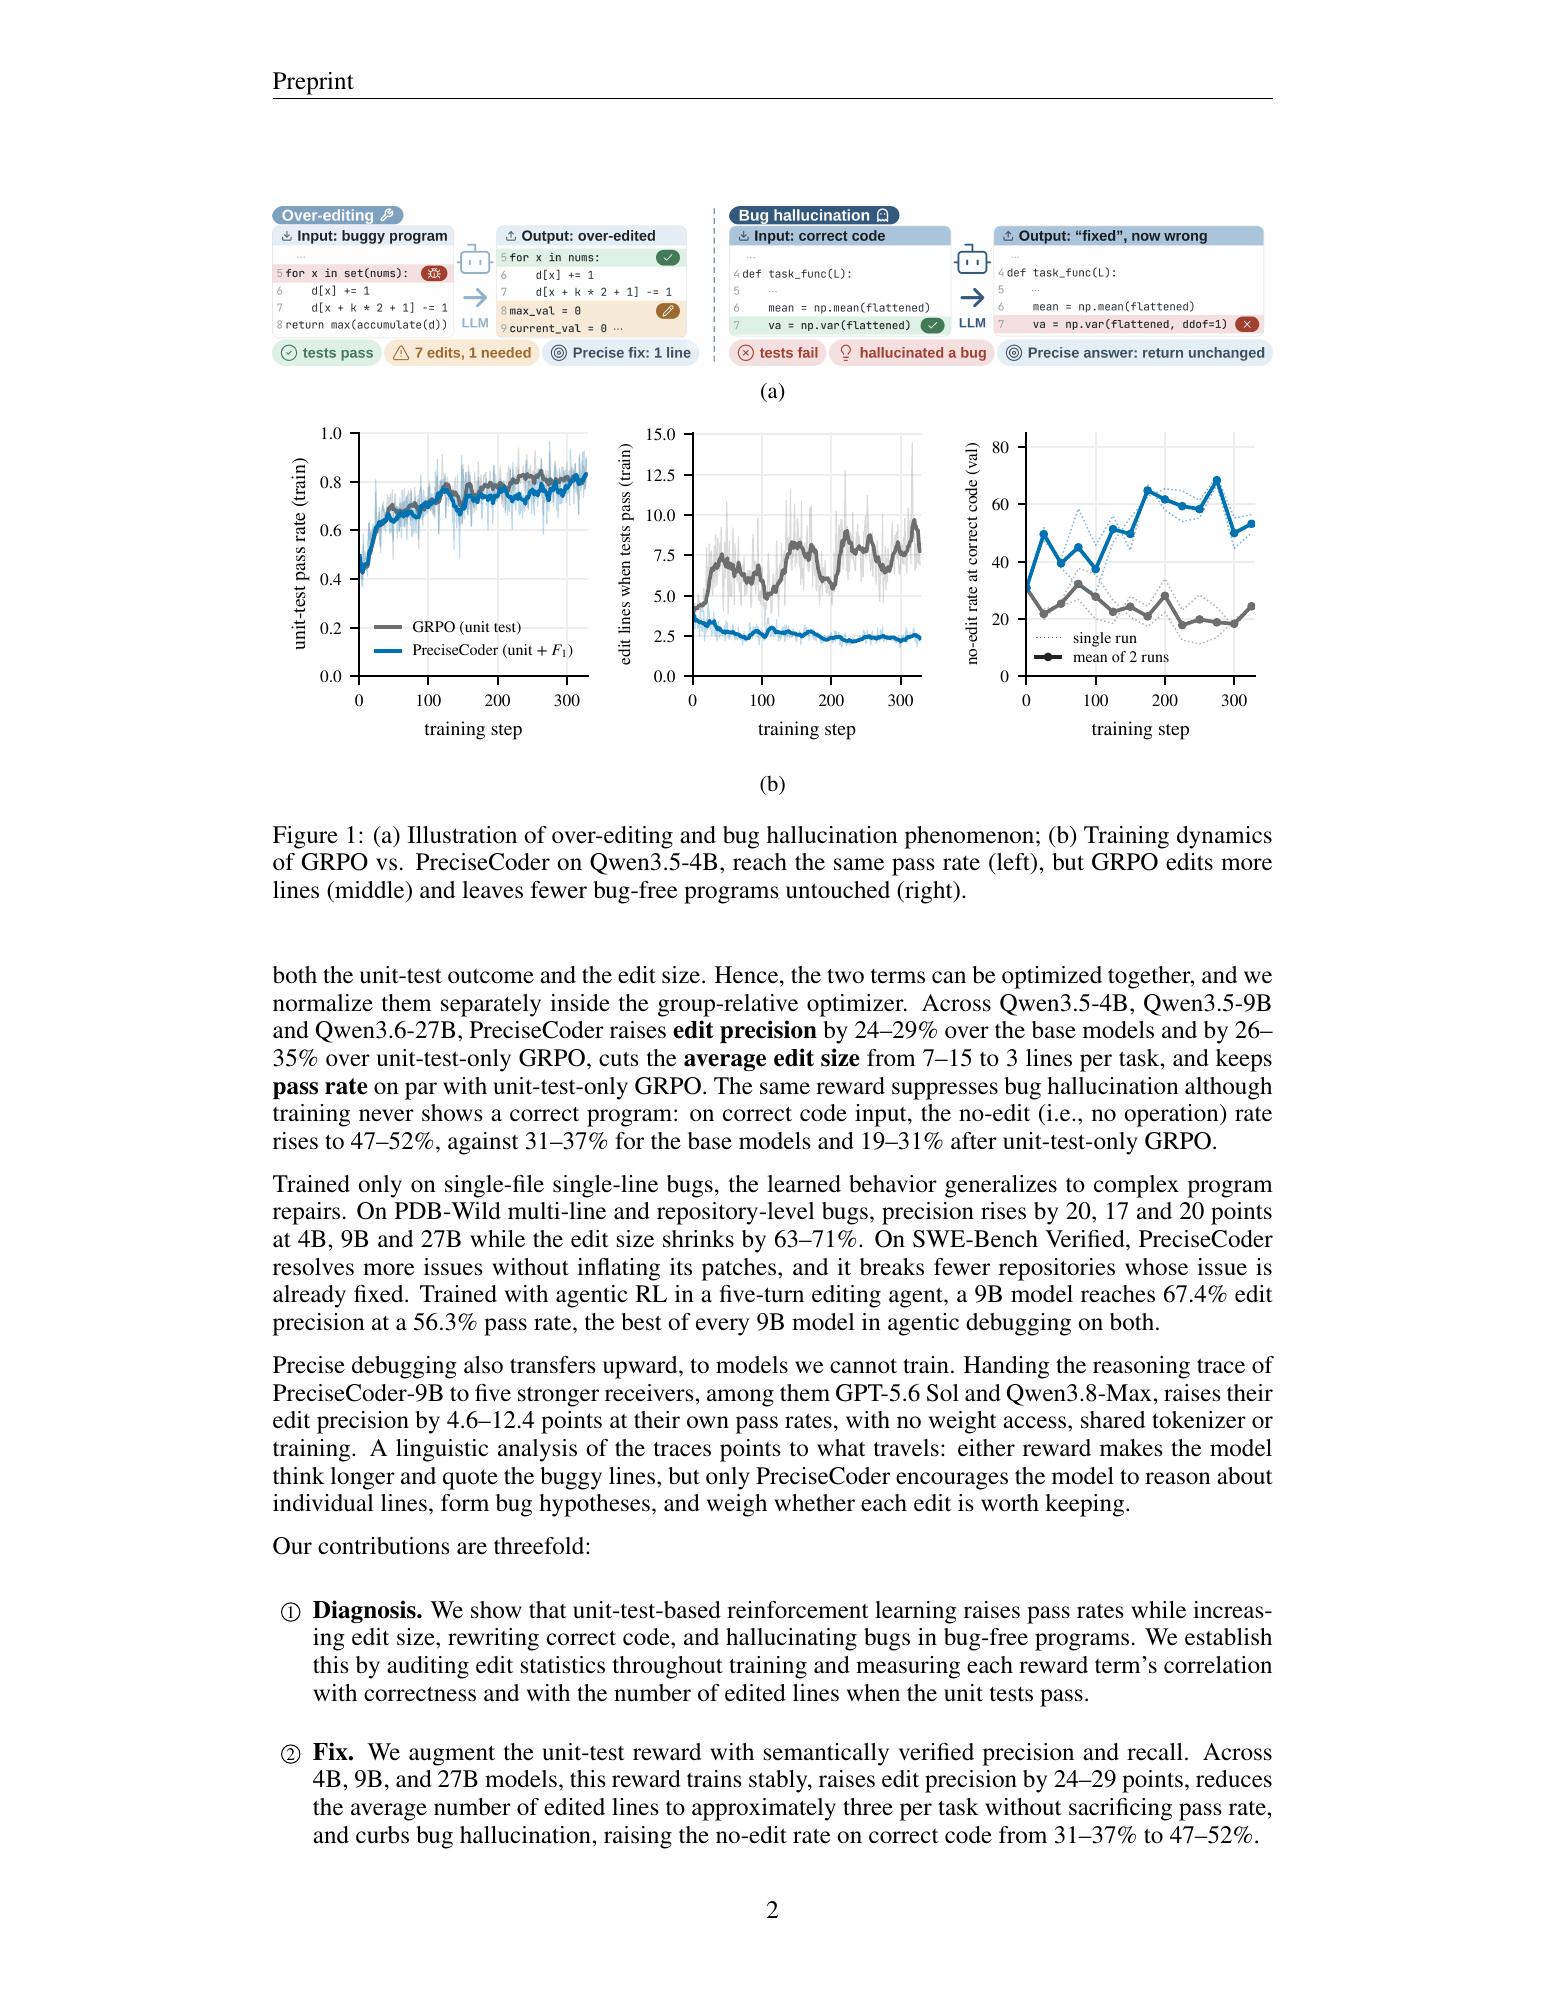
Figure 1,v1,第2页。 原文
先看上方两个例子:左边修对却多改,右边无错却改坏。下方左图的通过率接近,中图却显示灰色GRPO修改行数增加,右图显示它越来越少保留正确输入。蓝线加入局部F1后同时压低多余修改并提高不改率;右图是验证集训练动态,不能与主表三seed最终测试均值混算。
所谓语义验证仍由有限单元测试决定,且依赖参考补丁与块对齐,不是程序等价性证明。全部训练和评测限Python;4B/9B主要方法三seed,27B一seed。五轮工具编辑实验关闭run_tests,不能等同完整终端代理;弱到强思维文本传递有模型prefill与用户消息两种接口,精确率均提高但部分接收模型通过率略降。正确代码主探针仍称输入有bug,附录另测允许不修改的提示。评分增加约5–7%训练墙钟,不能称零开销。
评测数据集与环境。 SWE-bench Verified用于仓库修复,预先应用正确补丁的破坏探针为150题,主修复图未单列有效题数;HumanEval+用于未训练能力检查。已核实来源:PDB与其余实验协议:PDB-Single-Full共7,589个单行缺陷程序,其中5,274训练;PDB-Single测试1,205题,按底层问题与训练隔离。GT Debug另取1,512个正确程序;PDB-Wild 484个多行/仓库任务。附录OOD还测不属于PDB的BigCodeBench 901题、LiveCodeBench 806题、CruxEval与DebugBench Python子集(后两者该表未列规模),每题一个样本;不能把来源题库总规模当成本篇子集。
完整中文摘要
来自单元测试的强化学习是代码模型后训练的常用方法,但单元测试只问最终程序是否通过。我们分析仅有测试奖励在调试中教给模型什么,发现它提高通过率的同时,也让模型改得更多,并在正确代码中臆造错误。我们提出PreciseCoder,在测试奖励中加入经过语义核验的局部修改信号,该信号与更小修改和更高通过率相关。在4B、9B和27B模型上,PreciseCoder把平均修改行数从7–15行降至3行,通过率与仅用测试训练相当。仅以单行错误训练,它仍能迁移到仓库级程序修复,以更小补丁解决更多问题。精确性也能从较弱模型传给较强模型:给出9B PreciseCoder的推理轨迹后,GPT-5.6 Sol和Qwen3.8-Max等前沿模型无需额外训练即可提高4.6–12.4个百分点的编辑精确率。对思考轨迹的语言学分析显示,我们的奖励鼓励模型围绕具体行推理,指出错误行,并形成一致的错误假设。阅读依据。 原论文 v1:§3–5,Figure 1,Tables 2–4/6/11,Appendices B–E。机制与对照依据本文,未将作者主张写成独立新颖性确认。