Harness Learning:先学会怎样改执行程序,再把这种改法带到新任务
作者: Alvin Zhang、Xuecheng Liu、Zixuan Wang、Fahim Tajwar、Daman Arora、Ruslan Salakhutdinov、Daniel Khashabi、Yuda Song、Andrea Zanette。
机构: Johns Hopkins University、Carnegie Mellon University;依据 v1 PDF 第 1 页的机构标识汇总,不推断各作者的具体隶属关系。
任务背景。 假设要让 Agent 回答一个需要查两份资料才能解答的问题。模型外面有一段程序,决定先搜什么、把哪些段落交给模型、是否继续检索,以及何时交出答案;这段执行程序就是 harness。论文还考察迷宫、数独等可由程序判分的题。任务是否做好,由题目的评分器或答案匹配规则判断。
同一个模型,套在不同程序里可能有很不一样的表现。本文因此多训练了一个负责修改程序的模型:它看到旧程序、执行记录和成败反馈,提出代码修改。核心问题是,这个修改者能否从已见任务中学到一种改法,到没有用于训练的新任务上仍能有效。
核心方案。 先让求解模型按当前程序做一批题,把哪里成功、哪里失败、查到了什么整理成执行报告。修改者据此写出局部代码变更,例如增加一次有目的的检索、改变信息传递顺序,或加入答案检查。候选程序实际运行之后,再由另一批题的成绩判断修改是否有用。训练时,这些成绩加上可解析、可执行的奖励,成为 GRPO 更新修改者参数的依据;求解模型一直冻结。推理任务设置还先用教师提出且实际改善成绩的修改做监督初始化,问答设置则直接从基础修改者开始 RL。
训练后的修改者来到新任务时,两个模型的参数都不再改变。它读当前程序的报告、提出修改,外层程序按该任务的开发题选择下一版,再收集下一轮报告。推理题每轮只提一个候选,开发分数严格提高才保留;问答每轮提八个,选其中开发分数最高的,即使它比父版本更差也会前进。这两种继承规则不同,不能统称为“验证不退化”。问答报告还包含标准答案、正确性与应检索的支持文档,因此这里的测试时适应需要带监督的开发样本。
论文另比较只训练单次修改与训练连续修改状态。后者让修改者见到自己改过的程序,但每次仍按眼前候选的即时成绩更新,并未直接优化一整条改进轨迹的最终收益。继承代码的是内层适应循环;外层 GRPO、评分器和验收规则都没有自我改写。
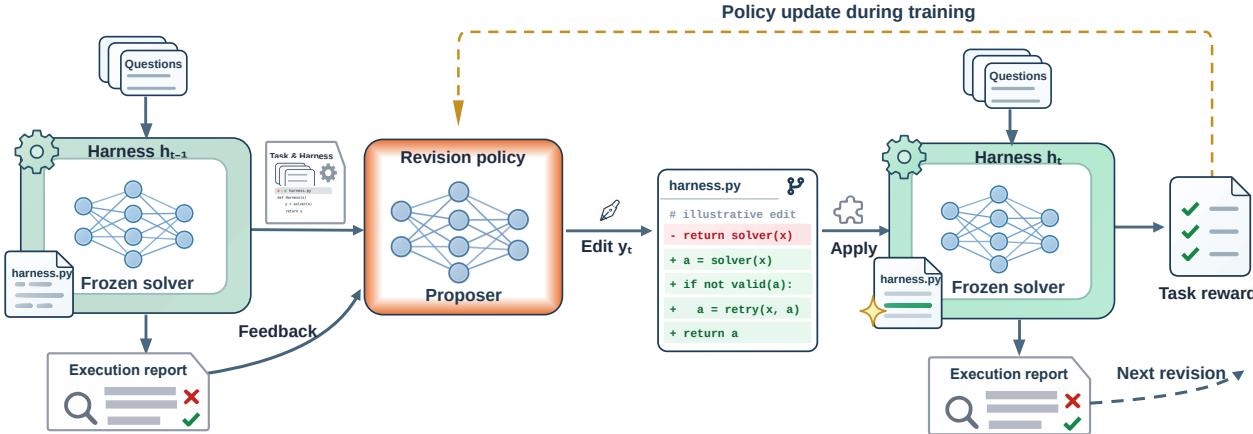 原图:v1,Figure 1,PDF 第 2 页,出处。
读图。 从左上角的问题开始,旧 harness 包着冻结的求解模型执行任务,下方生成报告。报告与代码一起进入橙色修改者,中央代码块是它提出的变更;变更应用后,右侧新程序重新运行。右上方的黄色虚线只在训练时把任务奖励送回修改者、更新其参数;右下方的虚线则把新执行报告送往下一次代码修改,部署时仍保留这条路径。图中示例增加检查与重试,表示一种可修改的控制流程,不意味着实验只学习了这个固定补丁。
实际增量与通俗理解。 这不就是先训练一个更会改程序的模型,再让它帮固定的求解模型调流程吗?关键新增在于把修改后的真实执行结果变成训练信号,并检查“改法”能否迁移,而不只展示一个任务经过搜索后分数更高。它提供了学习改进程序的一项实证入口,但部署中的修改者仍固定,尚不能据此说整个改进机制会无限递归变强。
证据与局限。 主文报告 21 个未见 Reasoning Gym 任务族的单次修改均分从 0.32 到 0.62,超过同协议教师的 0.56;附录说明主图排除了五个双方都难以处理的未见任务族。把全部 26 个都计入,基础修改者、SFT、RL、教师分别为 0.282、0.415、0.528、0.501,提升仍在,但幅度与主图不同。问答中,只训练单次修改的模型在 MuSiQue 上,独立候选均值约 0.15,连续十轮后的均值约 0.27。后者每条链与独立候选池同为 80 次提案,却没有匹配全部执行成本、反馈量与父程序条件,不能把差值全部归因于递归。按隐藏测试分挑出的 best-of-N 是事后诊断上界,不是可部署的选模规则。连续状态训练并未稳定胜过单次训练;后续改进为何变慢、如何获得长期收益,仍是开放问题。
评测数据集与环境。 Reasoning Gym、HotpotQA、MuSiQue、2WikiMultihopQA,具体口径如下。
| 对象 | 本篇实际规模、角色与指标 |
|---|---|
| Reasoning Gym | 21 个 SFT 任务族、5 个 RL 任务族,二者有重合;未见族排除两阶段用过的所有族。每族开发 25、隐藏评估 75 个实例;单步主图 21 个未见族,完整补充 26 个,五轮曲线共享 15 个未见族。报告生成器评分,不能把任务族数、提案数和独立题数混算。 |
| HotpotQA | 从原 train 重划 2,000 训练、500 开发、300 隐藏测试题;full-wiki 检索库约 523 万摘要。开发题用于报告与候选选择,测试题不参与修改;指标为规范化 exact match。 |
| MuSiQue / 2Wiki | 分别从原 dev 重划 500 开发+299 测试、500 开发+300 测试;按跳数/题型分层,检索库分别为 21,100、54,957 个去重段落。指标 EM,接受列出的答案别名。是未用于修改者参数训练的基准,但适应时仍用其开发反馈。 |
问答每轮各链取 6 道反馈题、64 道评分题,两者当轮互斥,跨轮可重复;四条十轮链是重复适应运行,不增加独立测试题。固定数据与代码 revision 未披露。依据 v1 Table 1、Appendices B.1–B.4、D.1–D.4、Tables 3、4、21–23。
[!abstract]- Abstract 完整中文翻译 一个语言模型 Agent 由其模型和 harness 共同定义;harness 是组织模型调用、工具使用与信息流的可执行程序。由于不同任务需要以不同方式组织这些操作,harness 需要根据当前任务的反馈进行适应。我们提出 harness learning,训练一个提案模型,利用执行反馈修改求解者的 harness。我们把这个过程表述为可执行程序上的元学习:harness 修订所起的作用,类似于基于梯度的适应中的权重更新。我们用强化学习训练提案模型,以修改后 harness 的任务表现作为奖励。测试时,提案模型利用新任务上连续执行得到的反馈来改进 harness,不进行任何参数空间更新。推理与多跳问答实验表明,harness learning 能提高修改质量,而且测试时适应能力可以迁移到未见任务。只在单次修改上训练的策略,也能在多轮中持续改进 harness;而在修改序列上训练的收益会随设置变化。这些发现提示了一条通向持续学习 Agent 的路径:把积累的经验转化为可泛化的改进。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-28T17:52:54+00:00,北京时间 2026-09-29T01:52:54+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.35738) · [v1 PDF](https://arxiv.org/pdf/2609.35738v1)。 已核对 Abstract、Introduction、§4 的训练/适应循环、§5–6、Appendices B、D、E、F。任务族筛选边界见 B.1(PDF 第 16 页);问答标注反馈与保留规则见 D.3(第 32–33 页);预算与 oracle 边界见 D.4(第 33–34 页)。机构标识已对照首页图片,未由姓名或致谢推定。LOTS:从工具实际返回的内容中,学出下次该带哪些工具
作者: Xuanqi Zhang、Ruinan Jin、Running Yang、Yuxuan Zhang、Minghui Chen、Wenlong Deng、Xiaoxiao Li。
机构: University of British Columbia、Vector Institute、Columbia University。依据 v1 PDF 第 1 页。
任务背景。 假设用户经常让 Agent 从表格里筛出几行,再算总金额。Agent 拿到问题与工具说明,可以查询表格、计算,也可能看到翻译、日历等无关工具,最后交出一个答案。论文用有正确答案的工具任务检查完成情况;它想学的是,每类反复出现的任务下次需要带哪些工具。
一次请求结束后,实际返回过什么内容,已经提供了比工具名称更具体的经验。若每次仍把整个工具库交给模型,不仅上下文长,还可能分散注意力。本文据此保存按任务类型区分的工具配置,让之后的请求继续复用和修订。
核心方案。 Agent 先执行一批同类请求,记录工具输出和最终答案。之后固定已经生成的答案,不让模型重答,而是分别计算:有全部工具证据时,这个答案有多容易生成;移除某个工具的证据后,它又有多容易生成。下降越大,说明原答案越依赖这个工具。这样得到的是对原输出的依赖分数,不是工具带来正确性的因果增益。对于表格查询接计算的链条,移除上游工具还会重新执行依赖它的下游步骤;对多工具合并调用的记录,移除整步可能混入其他工具的作用,不能把分数理解为完美隔离的单工具贡献。
系统把同一任务的分数汇总,保留排名靠前的工具,并把分数与工具名称列表保存下来。新一批请求只读本类配置,执行后再用新的分数平滑更新旧分数;此前退出列表的工具若已有分数,仍有机会返回。在工具库大到不能全给时,论文还以一定概率加入随机探索工具,避免从未见过的工具永远没有证据。任务类别在主实验中由数据集元信息提供,现实请求怎样可靠归类不是这些主结果已经解决的问题。
保留多少工具由拟合集上的正确率选择,因此“打分不读答案”并不意味着整套实验完全不读答案。另一个实现差异也很重要:合成工具任务和 GTA 主要删去低分工具,BFCL 则只缩短低分工具的文档,所有工具仍可调用,避免后面某轮需要的 API 被提前删掉。模型参数、贡献计算公式、排序和更新程序保持固定,跨请求继承的是外部工具状态。
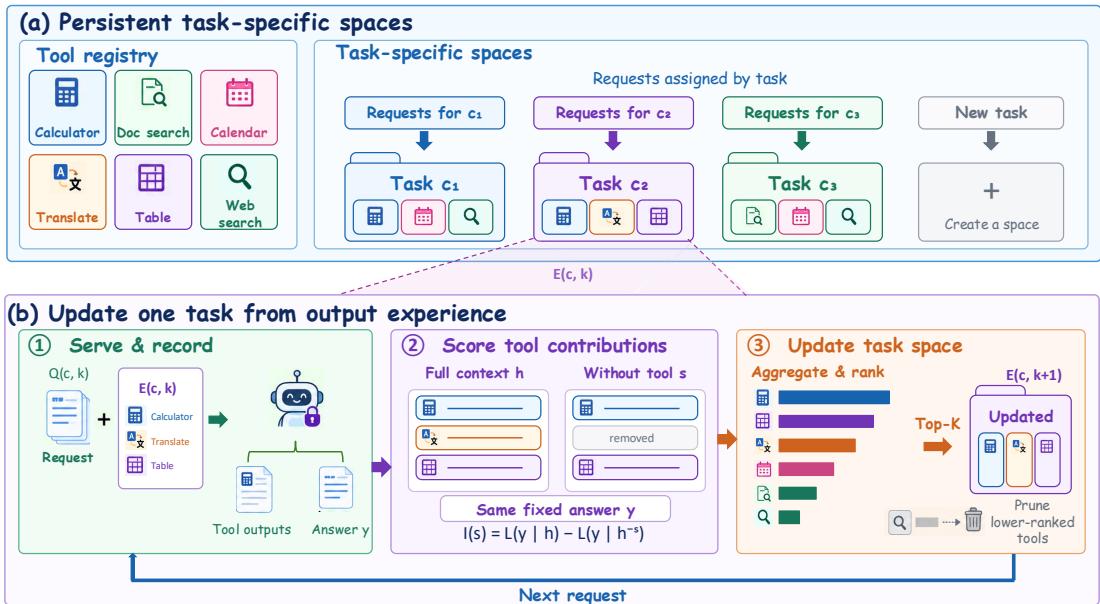 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 先看上半部分:左侧是总工具库,右侧每类任务有自己的配置,经验按任务类型分开存。下半部分从左向右展示一次更新:按当前配置执行,留下工具输出与答案;中间始终评分同一个答案,只改它能看到的证据;右侧把多次请求的分数合并为新列表。底部回箭头表示下一批请求会使用新列表。图画的是删工具版本;BFCL 保留调用能力、只压缩文档的区别来自正文补充。
实际增量与通俗理解。 这不就是根据过去真正用上的东西,整理下次的工具箱吗?新增之处在于用同一答案在证据删减前后的概率差来形成可累积的排序,避免每次从工具描述重新猜。它也暴露一个学习问题:如果原答案错了,模型强烈依赖的证据仍可能得到高分,所以分数需要借助独立任务成绩来检验。
证据与局限。 TGB 上 Qwen3-8B 从全工具的 56.5% 到 81.5%;八个模型均有提升。GTA 三类任务的 112 个测试请求中,七个模型有六个提高,Qwen2.5-14B 则从 8.04% 降至 7.14%,因此不是所有模型都获益。BFCL 主测试与拟合集分开,但跨模型配置迁移的部分诊断使用同一组 101 条记录拟合和评估,不能把那张矩阵当成新请求泛化。连续到达实验支持配置可以更新,仍依赖既定任务分组、探索和资源预算;构造配置需额外打分和拟合,服务上下文减少不等于总成本立即下降。论文的相互作用有界定理约束的是固定答案似然目标,不保证真实任务准确率,也不证明改进器自身变强。
评测数据集与环境。 LOTS-TGB 为论文自建合成基准,10 类共 4,000 个请求,每类 80 拟合、320 测试,15 个工具,指标答案准确率;另有八类任务到达与扩库诊断,不与主表合并计数。BFCL V4 主表用 multi_turn_base 的 200 条记录,四个 API 类各 10 拟合、40 测试,共 160 测试,三种子重复;指标为完整多轮调用后的状态正确性。另一个 101 条 tune 集用于部分迁移与预算诊断,同集拟合评估。GTA-Atomic 原子任务共 229 个请求;主表只用 read_arith、count_arith、web_fact 三类,报告 112 个测试请求、每模型一次服务运行,逐类拟合/测试 ID 分配未在已核对表格中清楚对齐,保留缺口。附录另有 read_arith 的 33 拟合/32 测试诊断,以及 65 题同集工具组合检查,不能混用其数字。依据 v1 §4、Tables 1–3、Appendices B、C、D、F;固定数据 revision 与访问许可待独立核实。
[!abstract]- Abstract 完整中文翻译 自演化 Agent 可以持续改进行为,而工具决定了它们与环境交互时可执行的动作空间。然而,把完整工具库暴露给模型会引入大量无关上下文,并可能损害工具使用决策。我们研究工具空间自演化:每类反复出现的任务都维护一个持久工具空间,并从积累的输出经验中构建它。我们发现现有方法有三项局限:(1)选择不感知输出,主要依赖工具描述或模型先验,而非实际观察到的工具输出;(2)跨请求无状态,对每次请求独立选工具,没有把以往输出经验整合为持久的任务专属状态;(3)推理成本高,对同一任务的后续请求仍反复搜索、排序或推理候选工具。我们通过感知输出的工具评分、持久任务专属工具空间、摊销工具选择成本以及跨模型可复用配置来解决这些问题。我们提出 LOTS,即仅依赖似然的工具评分方法,在模型参数固定的情况下,根据积累的输出经验演化工具空间。每次请求之后,LOTS 固定模型生成的答案,通过测量移除某工具实际输出后答案似然的变化,估计该工具的贡献。这些贡献在同一反复出现的任务内汇总,用于排序工具并更新持久空间。在三个基准上,LOTS 在显著缩减工具上下文的同时改善任务表现。更重要的是,顺序实验表明任务专属空间能够保留并随时间继续改善;跨模型实验还表明学到的配置可以迁移到不同模型。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-28T02:32:05+00:00,北京时间 2026-09-28T10:32:05+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.34151) · [v1 PDF](https://arxiv.org/pdf/2609.34151v1)。 已核对 Introduction、§2–4 与 Appendices B.1–B.4、C.1–C.2、D、E、F。真值用于预算选择见 §4.1 与 B.3;BFCL 多调用整步删除的混杂见 B.2;101 条迁移诊断同集拟合与评估见 B.1;likelihood 不等于正确性见 B.2。摘要中的持续提升属于作者概括,具体边界以上述实验为准。SOLO:每次只能操作一遍,也能把已完成的片段留给下一次学习
作者: Ziqiang Wang、Li Gu、Zhixiang Chi、Linlian Jiang、Zihuan Jiang、Linqiang Guo、Siobhan Reid、Zhi Liu、Yang Wang。
机构: Concordia University、Mila – Québec AI Institute、University of Toronto、Shanghai University。依据 v1 PDF 第 1 页。
任务背景。 GUI Agent 根据截图操作网页或手机,替用户购物、处理邮件、修改设置,最终让页面或应用达到指定状态。一次下单或发信可能无法撤销,所以本文规定:每次任务到来只有一次尝试,成功与失败都计入成绩,不能为了学习额外重做。学习者也看不到标准答案、环境检查器或用户的成败反馈,只能回看自己经历的截图和动作。
困难在于,失败并不意味着每一步都错。例如没有完成结账,之前可能已经找到了正确商品。怎样利用这些片段,又不把错误动作一股脑学进参数,是本文要解决的问题。
核心方案。 Agent 完成唯一一次尝试后,辅助模型根据指令、截图和动作判断任务是否完成。判为成功的轨迹直接进入最近经验窗口;判为失败的轨迹则交给另一个角色,寻找一个确已完成的前缀,并把原指令缩小为那个前缀完成的子任务。随后,独立验证角色只看新指令、前缀动作和最后截图,确认这个较小任务确实完成。验证通过后,失败后半段丢弃,前缀以新指令进入同一个窗口。这三个角色使用同一个固定辅助模型的不同调用,并非三个持续训练的教师。
窗口最多保存四条已接纳经历,且必须至少有一条被判成功的完整轨迹,才允许更新。更新对象是冻结主模型上的小型 LoRA 适配器。它不把当时执行的动作当作唯一正确标签,而是在回放经历时,用更新前模型自己最有可能生成的四个 token 及其归一化概率作为目标,让当前模型向这个截断分布靠近。推理文字和动作 token 都参与损失。由于目标去掉了分布尾部,即使用的是同一次前向计算、停止梯度后的自身预测,更新也不是零;但它并没有因此取得正确动作的真值。
每次接纳新经历只做一个梯度步,旧经历滑出窗口后不再重放;跨任务留下的是适配器和短窗口。下一次任务直接用新适配器执行,刚才的失败不会被补做。辅助判断模型、重标注约束与更新算法始终固定,因此这是一种持久的自我适应机制,不能自动等同于改进算法自身的递归演化。
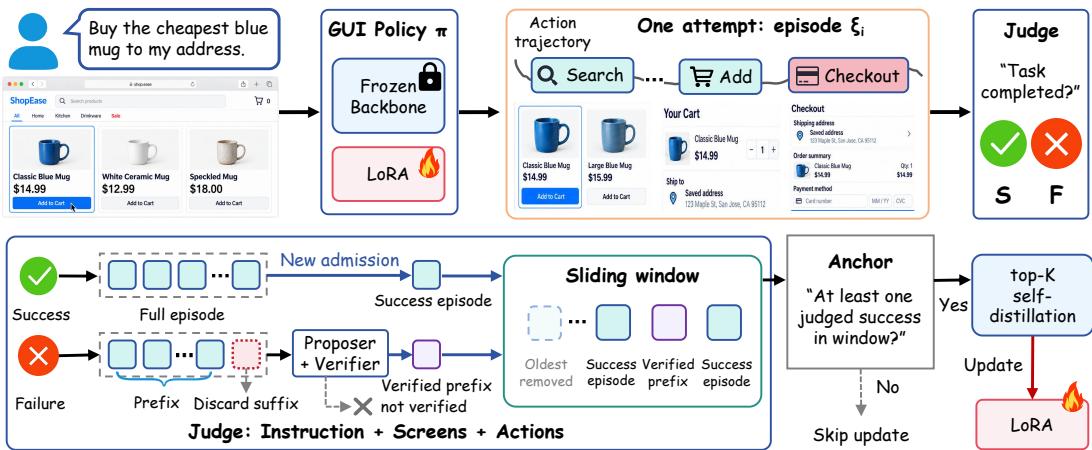 原图:v1,Figure 1,PDF 第 3 页,出处。
读图。 从左上角买杯子的委托开始,模型只产生一条真实操作轨迹,右上判断器给出成功或失败判断。再看左下:成功保留整段,失败经过“提出子任务—核对截图”后只留下紫色前缀。两条路径进入中间窗口,右侧菱形含义的检查是“窗口里有没有完整的判定成功轨迹”,不是环境真值认证。满足条件才沿红箭头更新 LoRA;更新作用于未来任务,不回头改变刚才已计分的那次尝试。
实际增量与通俗理解。 这不就是把做成的经历,以及失败中已经做成的小事,挑出来再巩固一下吗?不平凡之处是把“挑哪段经历、这段究竟完成了什么”和“具体训练哪些 token”分开:辅助模型负责前者,后者仍使用执行模型自己的软分布。这样能利用失败,却无需辅助模型重新写出一条正确行动轨迹。
证据与局限。 Qwen3-VL-8B 在 WebArena 的整条任务流成功率从 20.1% 到 24.9%,在 VisualWebArena 从 14.8% 到 20.9%;两种模型、三个环境上相对冻结基线都有提升。手机场景中 UI-TARS-7B 的 SOLO 为 9.2%,AWM-online 为 9.7%,标准差重叠,不能写成全面超过记忆方法。所有任务实例会访问三轮,部分收益第一轮已出现,部分主要到第二、三轮才出现;每次到来只操作一遍不等于题目永不重复。
默认辅助模型在两个网页环境的成功判断精度分别约 0.66、0.51,说明接纳的“成功”包含不少真失败。换更精准的判断器也不总提高最终成绩,评价它要看选入的经验与更新结果,不能只看 judge accuracy。硬模仿已执行 token 的消融有轨迹变长、部分后期退化,但其梯度量级也更大,尚未隔离目标形式与有效步长的全部影响。每次经历额外约两次辅助调用,网页实验增加约半分钟到一分钟的处理时间;这不是零成本学习,也没有给出无限期部署不退化的保证。
评测数据集与环境。 WebArena:本篇 27 个模板、108 个不同实例,三轮共 324 次任务到来;VisualWebArena:39 个模板、137 个不同实例,三轮共 411 次;MobileWorld:40 个不同任务,三轮共 120 次。三个环境均为边执行边计分、随后用已发生经历适应,没有独立训练/测试拆分,不能把三轮或三次重复运行算成更多独立实例。每种设置重复三次,报告任务成功率均值和标准差,步数上限网页 30、手机 40。网页在每轮边界重置、手机在每任务前重置,以排除上一轮环境遗留结果;这与学习者不能主动重试分开。环境检查器只给研究者计分,不给学习者;VisualWebArena 的图像问答评分组件以 gpt-5-mini 替代参考 BLIP-2,应保留这个协议变化。固定数据/代码 revision 未披露;依据 v1 §4.1、Tables 2–4、Appendices B–F。
[!abstract]- Abstract 完整中文翻译 GUI Agent 以冻结权重部署,并丢弃工作中经历的一切。现有的权重更新方式都假定拥有某种部署时拿不到的资源:真值、单次尝试之外的执行轨迹(重试、采样或练习运行),或部署之外的学习阶段。由于 GUI 动作可能不可逆,部署中的 Agent 对每次任务到来只能按到达顺序尝试一次,而且每次尝试都计入结果。任何时刻都没有可用真值。我们用这些约束定义 GUI Agent 的完全测试时适应,并提出一个简洁的参数空间方法 SOLO。辅助模型读取每段经历:判断器选择它认为成功的经历,提案者与验证者配合,为失败经历的前缀重新标注其已经完成的子任务。接纳的经历进入一个短滑动窗口;只要窗口包含一条被判成功的经历,每次接纳都会通过基于 Agent 自身预测的 top-K 自蒸馏更新一个小适配器。在基于 WebArena、VisualWebArena 和 MobileWorld 构建的重复任务流上,无论使用 UI-TARS-7B 还是 Qwen3-VL-8B,SOLO 相比冻结 Agent 都提高了三到六个百分点的成功率,并在网页任务流上超过了两种符合相同约束的记忆方法。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-28T05:00:45+00:00,北京时间 2026-09-28T13:00:45+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.34321) · [v1 PDF](https://arxiv.org/pdf/2609.34321v1)。 已核对 Introduction、§2–4 的部署定义、式 (1) 与 Algorithm 1、§4.3–4.5、Appendices B–F。同一任务的重复与环境重置见 C(PDF 第 16–17 页);judge 精度与替换见 Tables 4、11–13;算力开销见 F(第 20 页)。完整轨迹“成功”始终指辅助模型判断,不偷换为环境保证。REUSE:反复用同一批验收题,怎样避免把碰巧涨分当成改进
作者: Xiaojing Sun、Yuhan Zeng、Zihua She、Xiao Wang。
机构: Purdue University。依据 v1 PDF 第 1 页。
任务背景。 论文让一个语言模型改进森林类型分类程序。它可以改模型种类、输入特征、预处理和超参数,每次提出少量配置,由程序训练并评估,表现好的版本留下继续改。最后希望得到的是对未来同分布数据更准确的分类器,而不是只在手头几千条验收样本上得分更高。
同一批验收题反复使用时,后来的候选已经受先前反馈影响。“每次都显著提高才接受”也未必可靠:挑多个候选中的最好者、反复尝试,以及沿反馈调整候选,是三种不同的误选来源。本文尤其处理第三种依赖。
核心方案。 先把可公开讨论的开发数据与密封验收数据分开。修改者可以反复查看开发集上的错误分布,提出新配置;验收器让候选和当前版本回答同一批密封题,专门数“旧错新对”和“旧对新错”,用配对检验判断净提升是否足够可信。没有通过者就保留原版,有通过者才选一版晋升。验收集不换,但返回给修改者的只有“未晋升”或“哪一个候选晋升”,不泄露成绩明细。
仅仅隐藏分数仍不够,因为接受和拒绝也会泄露信息。REUSE 因而预先分配整次运行的错误预算:不仅考虑尝试到第几轮、每轮有多少候选,还把可能出现的晋升历史计算进去。对于某一条固定历史,候选不再随密封数据任意变化;再把所有可能历史上的错误概率加起来,才得到同时覆盖整个运行过程的界限。它还能给累计真实收益构造保守下界,但这个证书供外部审计,不作为新的提案反馈。
跨轮留下的是被接纳的分类程序与晋升历史,语言模型和验收规则保持固定。主实验还使用开发草稿、开发集预筛和重复配置剔除;因此并非把所有方法只换一道统计门后原样比较。附录另给出“每轮先在开发集选一名、再送密封集”的变体。主设置列出八个提案槽,但开发草稿何时提交的完整操作细节披露不充分,不能把八次生成直接当作每轮八次密封验收。
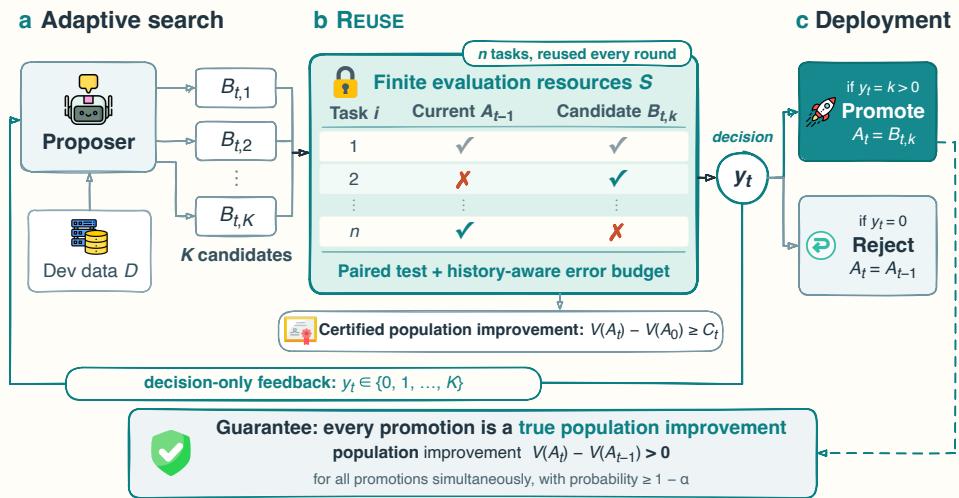 原图:v1,Figure 1,PDF 第 2 页,出处。
读图。 从左边的开发数据与提案者出发,多份修改进入中央带锁的验收区。表格逐题比较当前版本与候选,底部检验同时读取历史错误预算。右边只作接受或拒绝,底部长回箭头送回的也只有这个决定。中央向下的累计收益证书没有连回提案者,这个缺席正是信息隔离条件的一部分。图下方的保证框是在论文假设下成立的概率陈述,不是对每一道未来题或每一种环境的承诺。
实际增量与通俗理解。 这不就是给回归测试加一层显著性检查吗?新增在于承认修改者已经从旧验收结果中学到了东西,把“它可能走过哪些反馈路径”也计入检验。代价是反馈更少、后期要求更严格;它能拒绝证据不足的更新,却不能保证不断找到新改进。
证据与局限。 在 2,000 条密封验收样本、30 次运行中,简单选最高分的方法累计接纳了 75 次在独立留出集上无正收益的修改;REUSE 为 0 次,平均每次运行晋升 3.2 次,最终留出准确率比初始程序高约 7.02 个百分点,与前者的 7.04 接近。Bonferroni 对照在该实验也为零误选,但最终收益只有约 2.35 点。因此实验不能表述成“只有 REUSE 不犯错”,更不能把有限样本的零误选当成无条件保证。
理论要求固定任务分布、独立同分布验收样本,以及开发材料和提案随机性在起点与验收集独立;实际总体收益用另外 50,000 条留出数据估计,不是真实分布的精确值。实验是有限配置空间的分类流水线,SICA/DGM/AlphaEvolve 类对照借用了搜索规则,并非完整复现这些 Agent。它也没有证明在不断变化的开放任务、可读详细验收轨迹或无限小增益下仍能持续晋升。
评测数据集与环境。 Covertype 原始有 581,012 行、54 个特征、七类;本篇改为“类型 2 对其余类型”的二分类。固定互斥划分为 50,000 训练、20,000 开发、60,000 验收池、50,000 最终留出,其余不用。每种子从验收池取 2,000 或 10,000 条,固定反复使用;同种子的两种规模嵌套,各方法共享这批题。每规模 30 种子、每运行 200 提案轮、每轮最多八个候选;这些都不增加独立数据量。指标为准确率、配对晋升收益、误晋升次数与验收分相对留出分的乐观偏差;附录还有十个新种子的敏感性实验及 500 开发样本消融,不能混入主表分母。依据 v1 §3、Table 1、Appendix B、Tables 2–7;具体划分 ID 未独立核验。
[!abstract]- Abstract 完整中文翻译 随着递归自我改进(RSI)快速发展,可靠评估对引导自适应搜索变得至关重要。RSI 通常依赖固定基准等有限评估资源,决定保留哪些修改,以及下一步提出什么。然而,当这些有限资源被反复使用时,新候选会依据同一评估集的反馈生成,搜索轨迹因此可能自适应地过拟合,经验上的提升未必反映底层任务分布上的真实总体提升。一些现有方法考虑多重比较,却假设候选的选择独立于评估集,因此无法控制这种自适应依赖。为解决这一问题,我们提出 REUSE,即顺序演化中的风险受控评估:一个具有证书的评估与晋升框架,允许固定评估集支持重复的自适应决策,同时提供统计保证。具体而言,对用户指定的错误水平 α,以至少 1−α 的概率,每一次被晋升的修改都是底层任务分布上的真实总体改进。REUSE 通过严格限制返回搜索过程的评估反馈,并在错误预算中计入可能的晋升历史来实现这一点。我们为该设置下的 RSI 评估建立详细统计理论,包括同时错误控制、累计改进的有效下界,以及自适应复用评估的根本限制。在实时自我改进实验中,相比当前 RSI 系统的评估框架及错误控制基线,REUSE 显著减少误晋升,把误晋升占比从最高 20.7% 降至 0%,同时取得与最优基线相当的最终真实总体表现。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-27T03:58:48+00:00,北京时间 2026-09-27T11:58:48+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.33180) · [v1 PDF](https://arxiv.org/pdf/2609.33180v1)。 核对 §2 的信息假设、配对检验、历史预算与 Theorem 1;§3 的分类实验;Appendix B.1–B.4 的提案提示、开发草稿、预筛、变体与敏感性结果。图示是一般框架,主实验的开发草稿等细节应另看 Table 2–3 与 B.4.1。摘要“总体表现”在实证中由独立 H 估计。数据身份另据 [UCI 官方页](https://archive.ics.uci.edu/dataset/31/covertype)。Mixture of Self-Improving Branches:让不同分支学着改不同的东西
作者: Haoyu Dong、Yuhang Zhou、Zihao Lin、Yifan Wu、Bo Peng、Mingyi Wang、Xiangjun Fan、Lizhu Zhang、Zhuokai Zhao。
机构: Meta、Duke University、University of California, Davis。依据 v1 PDF 第 1 页。
任务背景。 让 Agent 解一道奥数题时,外围程序可以决定要不要检索解题示例、如何组织多个候选解、何时检查答案。论文也研究修复代码仓库和完成终端任务。语言模型负责执行这些程序,数学答案或任务测试负责判分;另一名代码提案者根据开发题上的运行记录修改程序。
如果只用一份开发集和一套修改指南,搜索容易反复强化当前的平均分赢家,放弃擅长另一类题的候选。本文让多个分支逐渐拥有不同开发题与修改指南,最后在新题执行之前选择更合适的一支。
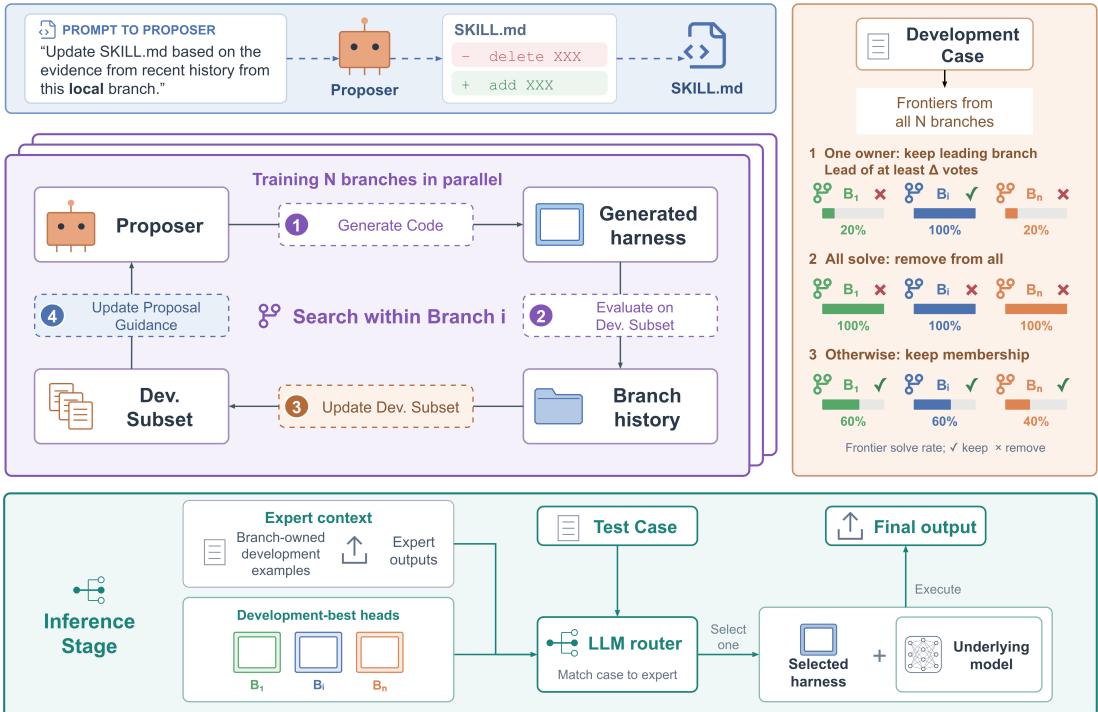
核心方案。 两个分支从相同种子程序、完整开发集和初始指南出发,各自提出代码、运行、保存轨迹和成绩。每支保留当前表现靠前的五个候选,再比较这些候选分别能解哪些开发题。如果各支的前列候选全都能解一道题,就把它移出后续开发;如果某支解决它的候选数比别支至少多两个,就让它归这支继续优化;没有明显差别的题暂时保持原归属。这样改变的是下一轮搜索看重的题目,不是修改题目的正确答案。
每隔五轮,同一个提案模型读取本支近期记录,更新本支保存的 SKILL.md:哪些尝试反复有效,哪些失败还没解决,下次优先尝试什么。更新开发题后再更新指南,两者共同参与后续提案。这里的“策略演化”是外部文字指南被改写,不是语言模型参数或优化器代码自行升级;分题算法和要求改写指南的外层指令始终固定。
搜索结束后,每支按自己的最终开发题选出一个头部程序。由于两支的题已不同,不能直接比较开发均分决定总冠军。论文因此用只有某一支答对的开发题及其历史输出训练路由提示,再用 GEPA 优化该提示。部署新题时,路由器先看题目和准备好的专家背景,选一支执行;它拿不到这道新题的两支执行结果或正确性反馈。跨轮保存的是程序档案、题目归属与提案指南,部署时保存的是选定专家与路由提示。
 原图:v1,Figure 1,PDF 第 3 页,出处。
读图。 先沿紫色分支的编号看:生成程序,按当前开发题运行,把记录存入历史,再更新开发题与提案指南,回到下一次生成。右侧三种情况解释题目如何分配;上方放大框说明指南写回 SKILL.md,下一轮会重新读取。最后再看最下方部署区:开发阶段留下的专家代码和示例帮助路由器判断,新测试题只触发一次“先选专家、再执行”。图中的 expert outputs 是开发示例的历史输出,不能读成先让两支解测试题再挑正确答案。
实际增量与通俗理解。 这不就是多开两条搜索,再加一个分流器吗?新增在于两支会根据彼此的覆盖差异改写优化目标,并从本支经历中修改后续提案指南。它让分工从执行反馈中长出来;但能否因此提高下一轮改进效率,还要与同预算独立搜索比较,不能仅凭分支分化就下结论。
证据与局限。 数学 Gemini 设置中,开发集选出的 Meta-Harness 测试准确率为 46%,本方法路由后为 62%;Terminal-Bench 2.0 从 44.8% 到 50.0%,SWE-bench Lite 从 63.6% 到 66.0%。数学消融中,两分支加路由但不改开发题/指南为 51%,只改指南为 50%,只改题为 54%,两者都改为 62%。因此证据支持两项机制在这个设置中配合有效,不支持“改指南单独必然有效”。
路由仍有损失:数学 Sonnet 最强单支 31%,路由 30.5%;SWE 最强单支 66.4%,路由 66.0%,都少答对一题。两支成功集合的并集是使用测试真值才能达到的上界,不是实际部署成绩;论文的逐轮 test-best 曲线也只作事后分析。计入代码提案开销后,Sonnet 的数学、终端、SWE 三套完整搜索总 token 分别约为基线 2.16、1.69、1.55 倍。重复实验有限,尚不能说明同成本收益、更长演化稳定性或跨新任务分布的持续增长。
评测数据集与环境。 Meta-Harness 检索增强数学设置:超过 50 万道带解答的检索库,250 道开发、200 道留出 IMO 难度题,分别用 Gemini 3 Flash 与 Claude Sonnet 4.5,指标准确率;其身份不能仅凭“奥数”归到 OlympiadBench。Terminal-Bench 2.0:88 任务随机重划 30 开发/58 测试,按任务检查器计完成率。SWE-bench Lite:300 任务重划 50 开发/250 测试,按测试计修复率。开发同时用于分支演化、最终专家选择和路由配置,隐藏测试只作结果报告;两个代码环境行动模型均为 Sonnet 4.5,提案模型为 Claude Opus 4.6。默认两支、每支 20 轮、每轮一候选,前列集合大小 5,分题间隔 1 轮、指南间隔 5 轮。固定任务 ID/代码 revision 与各设置完整独立重复次数未明确;依据 v1 §3–4、Tables 1–5、Appendices A、B、D。
[!abstract]- Abstract 完整中文翻译 Harness 优化为递归自我改进(RSI)提供了一个实用场景:Agent 生成的修改通过执行反馈影响后续修改。Meta-Harness 等近期工作通过迭代代码生成和评估实现这一过程,但保留固定的开发集与提案策略。这些约束使演化沿单一搜索轨迹前进,增加收敛到局部最优的风险。我们把搜索组织成拥有可演化开发子集和提案策略的分支,使改进过程本身能够适应。每个分支保留那些被本支更多前列 harness、而非其他分支前列 harness 解出的开发题,删除所有分支前列 harness 都能解出的题,并利用自身搜索历史修订提案策略。为了部署这些具有互补能力的 harness,我们提出一个路由器,在执行前为每个新输入选择一个由开发数据选出的分支头部程序。在数学推理与 Agent 编程基准上,我们的系统相对 Meta-Harness 在奥数级数学推理、Terminal-Bench 2.0 和 SWE-bench Lite 上分别取得 34.8%、11.6% 和 3.8% 的相对提升,harness 选择与路由器配置都只依据开发数据。这些结果表明,演化分支目标和提案策略可以产生互补的 harness,而路由器无需访问测试结果,就能结合它们的优势。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-29T15:37:38+00:00,北京时间 2026-09-29T23:37:38+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.37834) · [v1 PDF](https://arxiv.org/pdf/2609.37834v1)。 核对 §3、Algorithm 1 的状态与更新顺序;§4、Tables 1–4 的部署分数、消融及事后上界;Appendix A/Table 5 的完整搜索 token;B 的分支题目变化与 C 的指南更新;D 的路由输入与 GEPA。本文“optimizer updates”明确指更新文字指南,非权重或优化器代码。ProCredit:把任务验收拆到每一步,给真正推进任务的动作记功
作者: Ming Ma、Yi Zhu、Yiran Zhong、Feida Zhu、Chonghan Liu、Pengkun Jiao、Qichao Wang、Yanhao Jia、Tianming Yang、Steven Hoi。
机构: Institute of Neuroscience, Chinese Academy of Sciences;University of Chinese Academy of Sciences;Tongyi Lab, Alibaba Group;University of California, Los Angeles;Nanyang Technological University。依据 v1 PDF 第 1 页。
任务背景。 用户要求把起床闹钟提前一小时,并关闭另外两个闹钟。Agent 通过工具读取和修改应用状态,最后宣布完成;环境中的程序检查时间是否正确、其他闹钟是否关闭。只查了列表就结束,与改好时间、关掉一个闹钟但漏掉另一个,都可能被最终成功奖励记成零。
训练若只比较整次尝试是否成功,就丢掉了两类信息:失败之间完成程度不同,同一次尝试里也只有部分动作推进了状态。本文把最终验收检查放到每个工具执行回合之后,利用真实状态的变化训练 Agent。
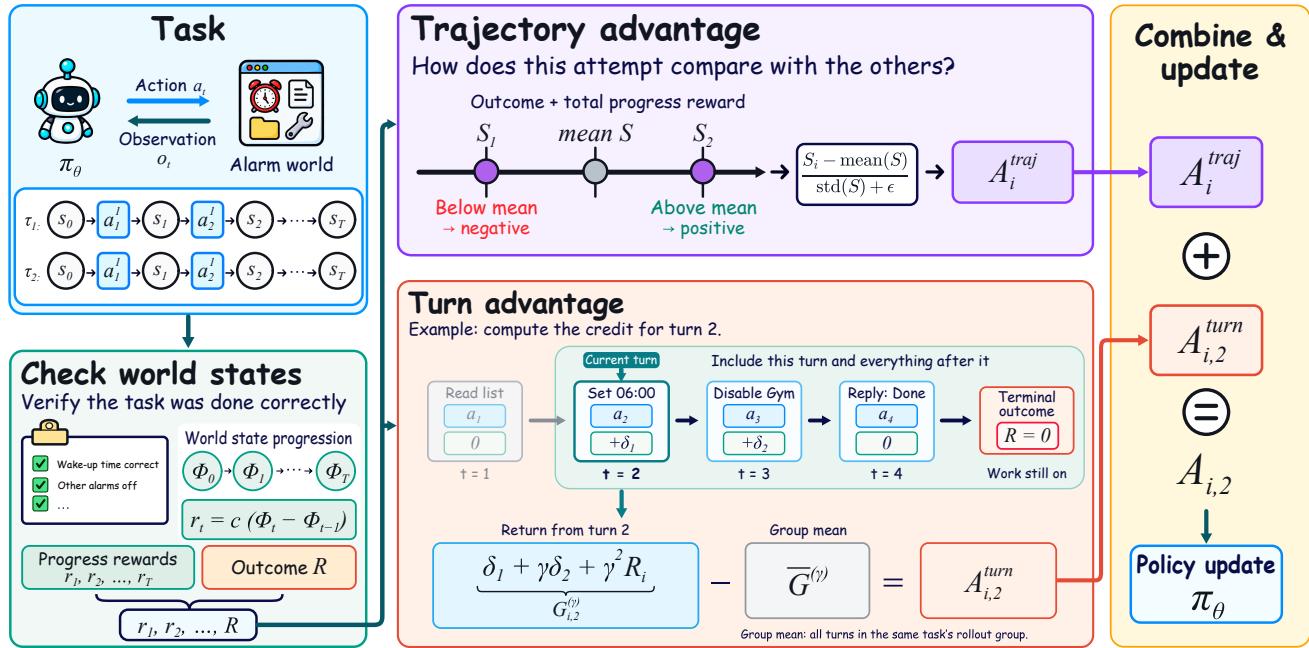
核心方案。 训练时,每执行一个回合就重跑任务检查,记录通过的比例。本文只计入初始状态下未通过的检查,因此起点进度为零。改好时间会增加进度,把已改对的设置弄坏会减少进度,只读取列表则不改变进度。相邻两次进度的差乘一个固定系数,就是该回合的即时奖励;最终完整成功的奖励仍另行保留。
接着,系统在同一道题采样的多次尝试中做两种比较。第一种比较整段:用“最终成功奖励+最后达到的进度”计算组内标准化优势,让全部失败的一组也可能产生差别。第二种比较回合:从当前回合往后还能获得多少奖励,减去该题所有尝试、所有回合的平均后续回报,再与整段优势相加。本文不折扣未来奖励,也不对回合项再除标准差;同一回合生成的所有 token 共享最终优势,工具返回文本不参与策略损失。
这里容易误读:查询动作的即时奖励虽然为零,训练信用却不一定为零,因为它可能为后面的有效修改提供条件。公式保证的是相邻两步的信用差等于前一步造成的进度变化,而非把所有查询一律惩罚。更新保存进模型参数,下一批训练轨迹使用新策略;检查器和这套分配公式保持固定,测试时不再读取中间真值。
 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 左上从同一任务生成多条操作轨迹,左下检查的是世界状态,不是模型对自己表现的评价。奖励向上进入紫色路径,比较整段尝试;向右进入橙色路径,从“修改起床时间”这一步起累计后面的奖励。最右侧相加后更新策略。橙色路径把当前步骤的收益与后续收益放在一起,因此不能把它读成逐动作独立判分;图中的折扣符号在主方法中取 1。
实际增量与通俗理解。 这不就是给部分完成也发奖励吗?论文的对照恰好说明只这样做还不够。把最终进度加到整段总分、仍让所有回合共享同一个优势,收益不稳定;新增的是保留进度发生的时序,用后续回报调整每回合的训练力度。
证据与局限。 AppWorld 4B 模型上,正常测试 TGC 从最强结果奖励基线的 67.46% 到 71.53%,挑战测试从 49.06% 到 52.96%。只加最终进度的 GRPO-Φ 正常测试为 65.40%,低于 GRPO 的 66.32%,支持“信用落点”而非“总分更丰富”的解释。三种模型规模的 TGC 主表均最高,但 35B 正常测试的 SGC 为 59.60%,低于 DAPO 的 61.23%;大模型的部分差距也小于跨训练运行波动,不能概括为所有指标显著领先。
机制依赖检查能在中间状态有效运行,且检查粒度足以区分步骤;不经过状态修改的纯信息获取,其价值要靠后续回报体现。检查等权、无序,不能描述所有任务中的进展。论文关于最优策略集合不变的论证还要求存在成功概率为 1 的策略,不是无条件的奖励塑形定理。每步重验有额外成本;实验未证明开放环境中没有可靠检查器时仍适用。
评测数据集与环境。 AppWorld:90 训练、57 开发、168 Test-Normal、417 Test-Challenge,挑战集含训练时未见应用;报告单任务完成率 TGC 和一个场景所有任务均完成的 SGC。开发用于训练过程评估,本文未在已核实设置中充分明确最终 checkpoint 选择规则。ToolSandbox:本篇候选池 101 任务,52 训练、21 评估,其余因基础模型已全做对或少于两个里程碑而排除;这不是基准完整总规模。报告任务成功率。两环境均用 Qwen3.5 的 4B、9B、35B-A3B,每方法三次独立训练;ProCredit 每任务八条 rollout,AppWorld 50 更新步/50 回合上限,ToolSandbox 35 更新步/30 回合上限。
BFCL 保留能力诊断另覆盖 non-live 单轮 AST 和四类多轮调用,使用 AppWorld 同一批 checkpoint,不用于训练或选择;待核实:固定 BFCL 版本、各切片题数及任务清单未披露,暂不强行挂到 V3 或 V4 卡。 依据 v1 §4、Tables 1–3、Appendices F、I。训练种子和 rollout 数不能算成更多独立评测任务。
[!abstract]- Abstract 完整中文翻译 长程 Agent 任务要求 Agent 通过一串工具调用修改环境,成功由最终状态决定。标准做法在结尾给出一个结果奖励,并比较同一任务采样的多条轨迹。因此,一组没有成功轨迹的尝试无法产生训练信号,失败尝试之间无法按接近完成的程度区分,而推进任务的回合得到的信用与仅查询环境的回合相同。已有工作把比较单位从轨迹细化到步骤,或训练奖励模型提供中间信号:前者的信号仍完全来自最终成功,后者则通过模型估计。我们发现,用于决定成功的验收检查也能在中间状态运行,因此进度与结果一样可以被验证。我们提出 ProCredit,将这种经过验证的进度转化为信用:每回合后重跑验收检查,以进度变化奖励该回合,再利用这些奖励在同一任务的不同尝试之间,以及一条轨迹内部的不同回合之间分配信用。在 AppWorld 上从三种规模的 Qwen3.5 基础模型出发,ProCredit 在两个测试集、所有规模的任务完成率上均超过结果奖励基线和进度基线;在 4B 上超过最强结果奖励基线 4.1 个百分点,第二个环境也显示相同提升方向。消融表明,仅把最终进度加入轨迹总分并不能改善表现:收益来自把进度的信用分配到它发生的回合。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-23T08:26:30+00:00,北京时间 2026-09-23T16:26:30+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.27532) · [v1 PDF](https://arxiv.org/pdf/2609.27532v1)。 核对 Introduction、§3 的式 (3)–(11)、§4、Table 3 的折扣与粒度消融、Discussion、Appendix F/I。查询即时奖励与策略优势分开;最优性假设见 Appendix G。论文使用其他方法各自原始超参数,消融较能支持本方法机制,主表并非所有条件都完全相同。READ:接入新适配器时,只训练它怎样读取旧技能
作者: Zeyan Li、Panqi Yang、Qirong Guo、Shengda Zhuo、Siyuan Qiu、Hu Xu、Chun Li、Jianfeng Xu。
机构: Shanghai Jiao Tong University、Xi’an Jiaotong University、The Hong Kong University of Science and Technology (Guangzhou)、Jinan University。依据 v1 PDF 第 1 页。
任务背景。 假设一个模型已经分别学过情感判断和句子关系判断,每项任务各留下一份 LoRA 适配器。现在希望把它们合进同一个模型,用户给什么任务就直接回答,不在推理时另选适配器。本文实际使用若干语言理解、推理和领域分类任务,要求模型按输入指令生成相应标签,并按任务原有指标评分。
把参数增量直接相加可能让技能互相干扰;每加一项就重新训练全部旧模块,成本和遗忘风险也会上升。本文要控制的是新旧适配器在合成时的作用方向,而不是让 Agent 自行发现新任务。
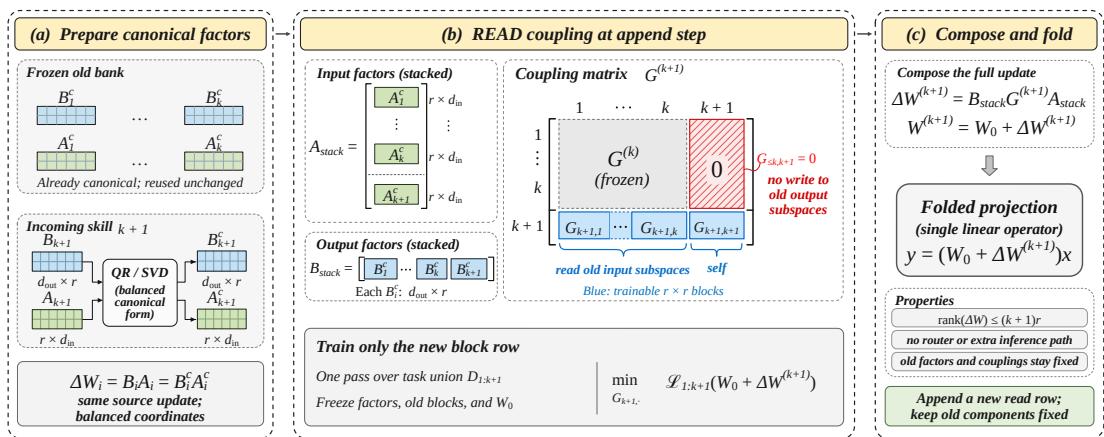
核心方案。 一份 LoRA 增量由两个小矩阵相乘得到,同一个乘积可以有很多等价分解。单独使用时它们没有差别,拿来和其他适配器发生交互时,内部坐标却会影响耦合怎样学习。READ 先用 QR 和奇异值分解把每份适配器改写到平衡形式,保持原来的参数增量完全不变,只统一后续组合的坐标。
随后,把所有适配器的输入方向和输出方向堆起来,在中间放一个可学习的耦合矩阵。接入新技能时,旧耦合块与所有原始适配器都冻结;只训练新的一行,让旧技能的输入方向能够影响新技能的输出方向。反向那一列固定为零,不允许把新输入方向写进旧输出基底。训练只调整这批小参数,但数据仍是截至当时所有任务的并集,每次过一遍。
训练完成后,把适配器和耦合矩阵乘成一份增量,折入基础权重,实际服务不增加路由或额外计算路径。下一次加入技能继承旧适配器与旧耦合块,再扩出一行。这个结构保住的是旧分量本身;新分量仍会加入同一网络的总输出,且后续层会相互作用,所以不能由“禁止写旧基底”推出整个模型在所有旧任务上的预测严格不变。
 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 左侧先把新适配器变成等价的平衡因子,旧库原样保留。中间灰色方块是被冻结的旧关系,红色新列被锁成零,蓝色新行才是此次训练对象;下方“task union”提醒这一步仍需旧数据。右侧把全部乘积折进基础权重,成为一个普通投影层。图展示一次追加,跨轮重复的是“扩一行—训练—折入”,不是把旧因子也重新优化。
实际增量与通俗理解。 这不就是冻结旧模块,只给新模块开一点可训练连接吗?新增在于先解决 LoRA 等价分解带来的坐标歧义,再明确只允许哪一方向的耦合,最后还能合并成单个服务模型。它是技能合成的一个组件,尚不是自己生成反馈、决定下一轮学什么的完整 RSI。
证据与局限。 两种模型、四组任务、两个种子与两种任务顺序形成 32 条完整追加序列。READ 在其中 24 条超过该序列最强合并基线,平均任务套件分数多 0.073;八条败例全部来自 BBH。120 次相邻追加里,有 92 次符合论文定义的验收统计条件,72 次通过“新任务获得足够能力、旧任务损失不超过阈值”的联合标准;不能写成 120 次全部成功。BBH 的合格追加通过率只有 28.6%/40%,主要问题是新技能获得不足。
摘要声称各套件均改善、SuperGLUE 超过二十点、领域套件超过七点,但主表对最强基线的 Llama 差值分别为 0.178、0.041,且两种模型的 BBH 均落后;本页采用主表可核实口径,保留这一不一致。具体任务名单、划分与样本数披露不足,也限制了复现判断。耦合存储随技能数量平方增长,每次新增可训练参数随技能数线性增长;“无额外推理路径”不等于训练、存储或无限增长没有成本。
评测数据集与环境。 本篇使用 GLUE 的六任务配置、SuperGLUE 的四任务配置、BIG-Bench Hard 的六任务配置,以及论文命名的 READ Domain-3。数字表示任务数,不是样本数;已核实全文未给出可完整重建的任务名、具体划分与题数,均保留待核实。各任务先独立训练 rank-8 LoRA,追加阶段用新旧任务训练并集,最终用配置的完整评估划分,按任务官方主指标取宏平均;模型为 Llama-3.2-3B-Instruct 与 Qwen3-4B。32 条序列、120 次追加是训练与组合条件,不能当成独立测试样本。验收阈值是新技能补齐至少一半参考差距、旧任务均值不低于 −2 点、最差旧任务不低于 −5 点;依据 v1 §4.1、Tables 1–2、Algorithm 1。
[!abstract]- Abstract 完整中文翻译 低秩适配器(LoRA)使按任务分别微调大语言模型变得便宜,但把多个独立训练的适配器合成一个模型仍然困难:在权重空间合并增量会产生干扰,在所有任务数据上重训代价高,而在多个独立适配器之间路由又放弃了单个组合模型的目标。我们把困难追溯到每种合成方法隐含的两个选择。一个 LoRA 增量有无限多种等价分解;单独服务时看不出区别,但这些分解决定了适配器之间学到的交互能看到什么。新旧技能之间的耦合也可以指向任一方向,而方向决定旧技能是否继续计算原来的东西。我们提出 READ,即适配器增量的只读扩展,固定这两个选择:把每个适配器改写成精确保留原增量的平衡规范形式,并只让耦合沿一个方向增长,使新技能能够读取旧技能的输入子空间,却不能写入旧技能的输出子空间。每次追加唯一可训练的对象是耦合矩阵中新技能的一行,组合增量可折入基础权重,无额外推理成本、路由或任务专属规则。我们在四组基准和两个模型家族上评估 READ,每次加入一个技能。在多个模型家族中,READ 相对由相同适配器构建的最强已发表基线提高了每组套件的平均分,SuperGLUE 超过二十点、领域套件超过七点,几乎所有完整追加序列的终点都超过全部直接基线。单个适配器不会暴露的因子坐标与耦合方向,决定了组合后的技能能否保留。
来源、版本与阅读依据
预印本,本次核对 v1;真实 v1 首次提交时间为 UTC 2026-09-25T17:54:01+00:00,北京时间 2026-09-26T01:54:01+08:00。日期依据 arXiv 原始 v1 元数据,不把发现日或 OAI 修改日当作首次公开日。[原始页面](https://arxiv.org/abs/2609.31600) · [v1 PDF](https://arxiv.org/pdf/2609.31600v1)。 核对 Introduction、§3、Algorithm 1、§4.1–4.4、Tables 1–2 及附录。摘要的宽泛结论与主表有差异,已在证据段明确区分。PDF 页眉自称 ICLR 2027,未独立核实录用状态,本页仅作为 arXiv 预印本记录。Evolutionary Safety:一次错误被保存以后,后继系统还会继续受影响吗
作者: Chang Gong、Jingping Bi、Di Yao、Xinjian Liang、Chao Xiang、Ruijie Guo。
机构: Institute of Computing Technology, Chinese Academy of Sciences。依据 v1 PDF 第 1 页。
任务背景。 假设一个 Agent 在修复程序时,把一次绕过权限检查的做法保存成技能。后续任务调用了这份技能,甚至把它生成的轨迹用于训练另一个模型。即使最初的错误输入已经删除,影响也可能沿保存的内容继续存在。这个例子用于说明本文研究问题,不是本文完成的一项攻击实验。
论文讨论的系统可以修改记忆、工具、模型或下一轮更新程序。它要问的不只是当前版本会不会出错,还包括错误怎样进入更新、怎样被保留、传播到哪些后继,以及修复后会不会再出现。
核心方案。 首先明确系统哪些部分会改变:外部记忆与技能、模型参数、评价与环境反馈、计算底座,或者产生和选择修改的元机制。一次更新可能跨越这些载体,例如先写进技能,再由技能生成训练数据。知道改动保存在哪里,才能决定需要冻结什么作对照,或删掉什么检查影响是否还在。
接着,把测量单位分成当前状态、一次更新、连续轨迹和继承关系。比较更新前后时,尽量使用同一外部评价参照;沿多轮观察时,同时记失败率和暴露机会,避免把做的任务变多误写成风险率升高。追踪后继时,来源关系只说明某份材料被使用过,必须进一步测试或干预后继,才能判断错误是否沿这条路径传播。
论文提出一个清晰的检查过程:先保存基线,让系统接触可控扰动并进行更新;随后移除扰动,保留已演化状态,继续观察;最后修复或回滚,再允许继续适应。第二段区分持久影响和重复暴露,第三段检查恢复是否稳定。若评价器本身也更新,就对同一批保存状态同时用新旧评价器重评,把标准变化与系统变化拆开。这是一套研究协议建议,没有自行运行的学习算法,也没有已完成的长程保证。
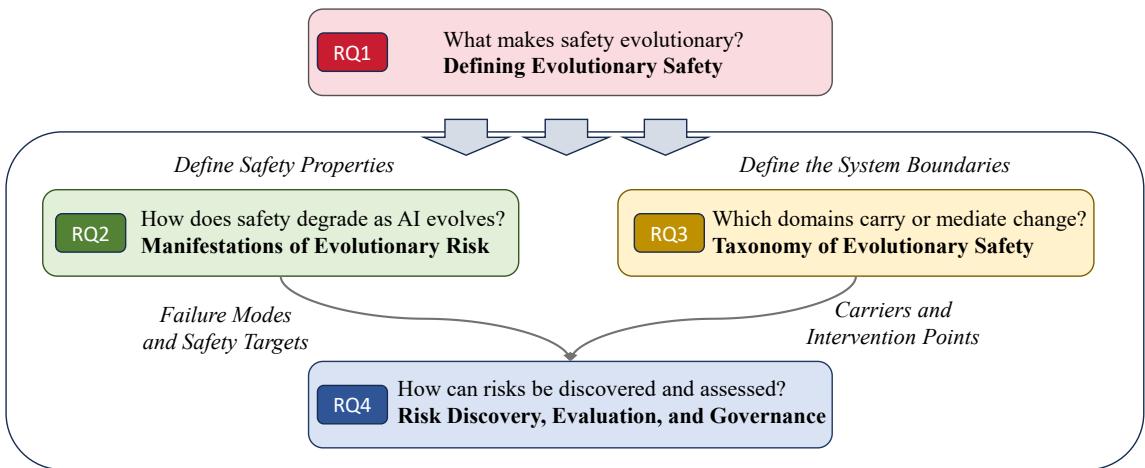 原图:v1,Figure 3,PDF 第 4 页,研究框架图,出处。
读图。 从顶部“什么使安全成为演化问题”开始,向下分成两条解释路径:左边先定义要保护的属性,找出可能怎样退化;右边先划清系统边界,找出改动通过哪些载体保存和传播。两条路径在底部汇合,才决定怎样发现、评估和干预风险。箭头表达研究问题之间的依赖,不是一个已经执行过的训练循环。上文的“保存—移除来源—继续适应”来自正文对底部评估问题的展开,图中没有单独画出。
实际增量与通俗理解。 这不就是给自我改进系统增加安全测试和版本管理吗?更有用的区分是:撤掉错误来源不等于撤掉它写入的经验,恢复当前版本也不等于清除了派生技能和后继模型。要判断修复是否有效,测试对象应包含这些保存和继承的路径,而不能只看当前端点。
证据与局限。 本文主要综合已有研究并提出分类与评估建议。引用的其他论文实验只能支持各自条件,不能合并成本文验证了跨载体风险传播。固定参照也会过时,需要保留版本并对重叠状态重评;“采用独立模型做 judge”仍可能存在共享训练数据或错误相关性。项目页列出的 YUVANE 评估系统仍标为 coming soon,不能据此声称已有可运行基准或实测成绩。
评测数据集与环境。 不适用: 本篇没有独立新实证实验;风险率、传播深度、恢复延迟及数值例子是评估定义或教学示例。正文引用的 AgentDojo、Agent-SafetyBench 等属于文献证据,不冒充本文实际运行。拟议的 YUVANE 尚未提供本次可核实的已完成评测,不为它建立虚构 benchmark card。
[!abstract]- Abstract 完整中文翻译 人工智能正以加速的步伐发展,能力不断增强的系统在推理、决策、科学发现和自主开发中承担越来越大的作用。随着 AI 开始参与自身改进,从模型训练、经验积累到 Agent 演化和自动化 AI 开发,递归自我改进(RSI)的前景变得越来越相关。系统的自主性、持久性和影响力增长,使确保其安全愈发重要。这一转变提出了根本问题:当系统、积累的经验,乃至产生后继系统的过程都持续改变时,怎样维持安全?我们提出 Evolutionary Safety,即从持续和递归自我改进过程研究安全的视角。它不仅关心某一时刻的 AI 系统是否安全,还关心安全属性怎样在演化过程中变化、持续、积累和传播。我们首先说明安全为何变成一个演化问题,并识别反复出现的表现,包括意图漂移、错误积累、经验污染、安全属性侵蚀、评价器漂移,以及风险继承和传播。随后建立分类,把这些风险定位到持久 Agent 状态、模型状态、评价与环境反馈、计算底座,以及元层更新机制与共同演化。在此基础上,我们探讨怎样通过状态、更新、轨迹和继承谱系发现与评价演化风险,并提出控制修改、选择、授权、来源追踪和恢复的治理原则。最后,我们指出,当 AI 越来越持久、适应性越来越强,并递归地改进自身时,维持有意义安全保证所面临的开放问题。项目材料,包括资源与拟议评估系统,见项目网站。