SkillPivot:保留走对的前半程,只从真正走偏的地方学习
作者: Yichun Feng、Jiawei Wang、Haozhe Sun。
机构: 中国科学院大学、中国科学技术大学、美团。依据 v1 PDF 第 1 页,按论文署名顺序记录。
任务背景。 Agent 拿到一个需要查资料、调用工具的问题,并参考现有操作说明,一步步取得信息,最后交出可由任务评测器判定的答案。例如,论文用“找到符合日期和预算限制的航班”说明这种过程:前面的搜索与筛选可能都有效,后面却开始查错方向,最终失败。学习的对象是下一批任务还会使用的自然语言技能,而不是这一次回答本身。
如果直接把整条失败轨迹交给模型复盘,正确的探索也可能被当作问题改掉。本文想找出“从哪里开始走偏”,并比较在同一段已有经历之后,怎样继续才有可能做对。
核心方案。 学生先带着当前技能执行任务,保存工具调用、观察和答案。失败之后,系统逐步检查工具是否有效执行、有没有取得比此前更接近标准答案的信息,以及是否反复重复旧动作。它把持续低分的转折附近选为干预点,保留前面有用的历史。这里“接近目标”的判断使用了标准答案的语义表示,因此是有真值的离线学习流程,不能直接理解成部署时无需答案就能判断进展。
接着,更强的教师拿到同一前缀、当前技能和学生的完整失败轨迹,尝试从这个位置继续做完;中间另有反思器给教师下一步提示。只有教师答案通过任务评测器,才把它的成功后缀与学生的失败后缀组成对照。修订模型先提炼单题差异,再聚合出局部修改,可以补操作步骤、改适用描述,也可以因证据不足而不改。这样,修改有一个具体的参照:同样走到这里,下一步究竟差在哪里。
候选技能最后交给模型审查,分别判断是否保留旧规则、是否形成可复用规则,两项达到阈值才写回技能库。这道门的明确实现是比较新旧技能文本,不是完整的环境回归测试。 正文前面提到成功池用于保护旧行为,但没有给出与文本门对应的可复核重跑协议,不能把“no regression”标签当作已经验证不退化。后继继承技能文本;教师模型、检测规则和外层更新程序保持固定。
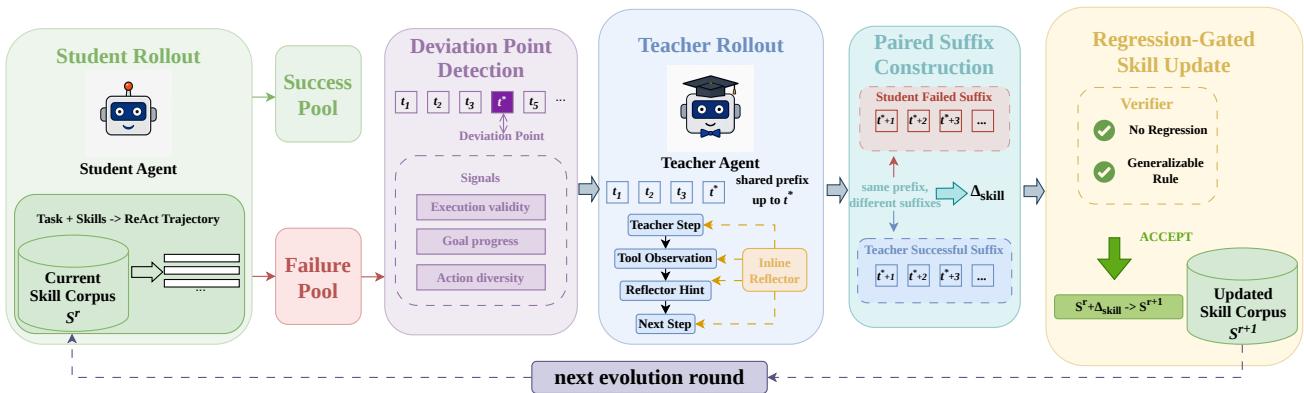 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 从左边带着技能库的学生开始,失败轨迹进入紫色的转折检测块,再把保留的历史交给蓝色教师块。教师内部的小循环表示工具观察与反思提示交替出现。向右进入青色区域,红色失败后缀和蓝色成功后缀才成为技能修改的依据;最右侧审查通过后,底部虚线把新技能送回下一轮。图中的绿色勾表示审查决定,不代表另有未画出的独立测试证明长期收益。
实际增量与通俗理解。 这不就是让老师从学生卡住的地方接着做,再据此修改操作说明吗?新增机制在于固定共同前缀,使对比集中在后续分歧,而不是拿一条从头重做的标准轨迹要求学生照抄。相较已读的 SelfOp 与 SkillAA,这是另一种构造局部诊断证据的方法;本文没有直接比较这两者,不能据此判断谁更好。
证据与局限。 ToolQA 六组累计演化后,均值从 53.18% 到 59.36%;但最后一行已用过全部六组,不能当作全部未见任务上的增益。较早阶段在尚未参与演化的组上也出现改善,支持有限的跨组迁移。干预实验中,强教师接续成功率为 56.18%,从头重做为 35.65%;换成学生自身作教师则为 37.40%,显示教师能力本身是重要成本与收益来源。WildClawBench 从 34.35% 到 73.00% 是在完整任务集上反复演化并评估,主要证明同任务集适应。三次重复不等于三个新测试集;论文也没有统一核算全部教师、反思与审查成本,不能将短补丁直接等同于低总成本或严格 RSI。
评测数据集与环境。 ToolQA:本篇使用 SRA-Bench 配置的技能库,1,428 题分成六个互斥组,每组 238;组依次进入演化,所有组每阶段都评估,必须按阶段区分已见与未见。LogicBench:均分六组、每组用于演化后评估所有组,确切题数与固定 release 未披露,不能沿用其他论文的 1,520 题。WildClawBench:只用提供并调用技能的任务,精确子集数未交代;六轮均在完整选中集上演化、评估。三者按各自官方任务成功口径报告,配置独立重复三次。依据 v1 Experiments 的 RQ1、RQ4、RQ7 与 Tables 1–4。
[!abstract]- Abstract 完整中文翻译 大语言模型 Agent 越来越依赖自然语言技能来解决复杂的工具使用任务。然而,这些任务通常有多条有效解法,因此,强迫失败轨迹去匹配一条固定成功轨迹,并不是合适的技能改进方式。此外,失败轨迹很少从头到尾都错:Agent 可能先收集了有用证据并取得实质进展,随后才偏入错误的后半程。因此,我们认为,技能自演化应该识别有效问题求解从哪里开始失效,而不是粗略反思整次失败。基于这一认识,我们提出 SkillPivot,一种由偏离点引导的技能自演化框架。SkillPivot 利用执行有效性、目标进展和动作多样性,检测从有效前缀转向错误后缀的过渡。更强的教师随后从同一前缀继续,在相同交互历史下产生成功的替代后续。通过对比学生的失败后缀和教师的成功后缀,SkillPivot 在保留已有有效指导的同时生成局部技能更新。ToolQA、LogicBench 和 WildClawBench 上的实验表明,SkillPivot 持续优于参与比较的技能演化方法,改善多个 Agent 模型,并生成紧凑、可迁移的技能更新。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-24T07:31:00+00:00(UTC),北京时间 2026-09-24T15:31:00+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对 Introduction;方法中的偏离检测、教师接续与 Regression-Gated Skill Update;Experiments RQ1–RQ7,Tables 1–4,Figures 2–4。原论文共 9 页。检测器使用标准答案、文本验收与已见/未见任务的区别,均依据正文保留;摘要中的概括不替代这些边界。
TimeEvo:把失败变成测量工具,再检查修好的题是否多于改坏的题
作者: Jie Yang、Yan Zheng、Jiarui Sun、Xiran Fan、Junpeng Wang、Liang Wang、Zelin Xu、Qinghua Liu、Zhengyu Fang、Yiwei Cai、Philip S. Yu。
机构: University of Illinois at Chicago、Visa Research、University of Florida、The Ohio State University、Case Western Reserve University。依据 v1 PDF 第 1 页。
任务背景。 Agent 拿到一条或几条时间序列、一个分析问题和若干选项,需要从数据中找出支持答案的证据。例如,面对“这段曲线是否出现异常变化”,它可以直接判断,也可以调用程序计算局部波动、趋势或变化点,再选择答案。训练阶段有标准选项,可以知道哪些题做错;实际测试时只能看题目和数据。
困难是“增加一个看起来有用的工具”未必改善整个系统。工具可能测错对象,可能被用到不适合的问题上,也可能让原本答对的模型改错。只看最终平均分,会把修复旧错和引入新错混在一起。
核心方案。 系统先让没有工具库的模型答题,再把训练集中的错误按缺失能力归组。规划器不急着写代码,而是明确需要测什么、输入是什么、怎样判断测量有效、哪些问题适用和不适用。随后才生成、修改、缩小范围或删除工具。生成的 Python 工具主要返回数值证据,不能把某个答案选项直接写成结论;必要的预测模块或训练集内校准模型也有明确接口。这使工具承担“补充观测”的工作,最后判断仍由 Agent 完成。
候选工具先通过小规模预筛,再把整个候选库与旧库放到同一批验证题上对照:原来错而现在对的记作修复,原来对而现在错的记作损害。准入门首先要求净收益的保守下界为正;论文还设有单轮补充规则,允许在净修复达到门槛且损害率不超过 10% 时接受。因此,接受并不等于零损害,也不代表每个通过者都满足同一种显著性标准。失败的候选最多做一次归因裁剪并复验,仍不通过就回滚。
部署时,模型先保留一份原答案,再检查少量符合适用范围的工具。只有工具实际执行、模型明确决定替换时,才改掉原答案;没有合适工具就沿用原答。下一轮继承的是工具代码、使用说明和适用范围,底层语言模型与外层更新流程保持固定。验证门决定是否保存修改,测试集才用于判断这份修改能否迁移。
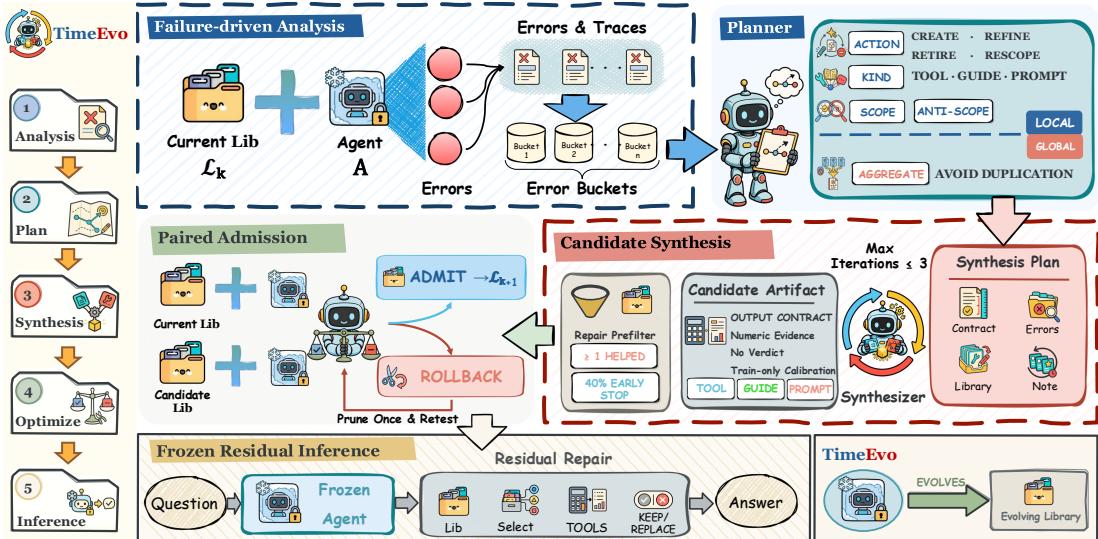 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 从左上旧工具库及 Agent 的运行结果出发,错误先被整理成能力缺口,向右交给规划器决定要补哪种测量。右侧向下才进入工具合成;底部向左经过预筛和整库配对验收,通过的修改返回工具库,未通过的撤销。最下方的实际答题流程与上方演化阶段分开:它使用已经冻结的库,先保留原答案,再考虑证据是否足以支持改答,并不是每道测试题都重新演化工具。
实际增量与通俗理解。 这不就是从错题里写辅助函数,再挑好用的留下吗?新增的是把“函数算得对”“函数用得合适”和“整个 Agent 是否因此更可靠”分开验收。它还把改坏的题显式算进代价,避免工具库看起来更丰富、平均分略升,却悄悄丢掉原有能力。
证据与局限。 主实验在十项任务、三个骨干上各做一轮演化,平均准确率分别增加 8.79、7.21、8.73 个百分点。便宜模型生成的库迁移到更强模型后总体也有收益,但部分任务出现下降,例如转到 GPT-5.6-sol 的分类任务下降 2.50 个百分点。额外三轮异常检测实验中,第二轮主要修订说明,第三轮被拒绝;这支持“有限更新后停下来”的机制,尚未证明持续发现新工具或无限递归增益。在线答题成本与建库、反复验证成本应分开,不能用测试阶段少量工具调用代表总成本。摘要称代码可用,但本次打开官方仓库只看到 “Code is coming soon”,复现入口尚不完整。
评测数据集与环境。 本篇使用 TemporalBench 等下列六个来源的十项任务。表中是 TimeEvo 实际题数,不是来源数据集的总规模;训练用于生成工具,验证用于准入,测试用于最终准确率,同源基础序列按分组规则隔离。依据 v1 Table 2、Appendix C。
| 评测对象 | 训练/验证/测试题数及本篇口径 |
|---|---|
| TemporalBench | T1:400/156/158;T2:324/123/126;T3:517/196/202;T4:324/123/126。分别覆盖历史理解、无事件预测、临床协变量问答、含事件预测。 |
| TimeSeriesExam | 448/149/149;测试为 99 道单序列、50 道双序列题。 |
| Merrill Time-Series Reasoning | 240/120/240;从官方 5,779/1,000/1,036 划分取子集。 |
| Time-MQA | 异常检测 400/400/400,分类 240/120/240;来源约 37,000 行先去重,行数不等于独立序列。 |
| MMTS-Bench Match | 160/80/160;400 行对应 112 个独立目标序列,按目标分组。 |
| TSAQA Data Transformation | 400/400/400,选择题与真假判断各半。 |
固定 release 与完整处理代码仍待核实。三种模型、迁移实验和重复运行不增加独立题目数;三个模型使用各自生成的库,不能把每个结果都当作同一固定工具库的重复验证。
[!abstract]- Abstract 完整中文翻译 时间序列 Agent 通过调用外部工具回答分析问题,而它携带哪些工具通常在人运行 Agent 之前就已决定。然而,我们识别出这种设置中的两个问题。第一是人类与 Agent 的工具错配:由专家整理的 21 个工具在一些任务上有帮助,在另一些任务上却有害,并在我们测试的每一种骨干上降低异常检测准确率。第二是静默损害:一轮通用自修订改变了 147 个答案,其中 56 个被改坏,而最终分数变化不到一个百分点。两者源于同一个缺口:工具是否有帮助要在运行时逐题决定,工具却事先提供,并用一个平均分评价。为此,我们提出 TimeEvo:把诊断出的失败聚成能力缺口,为每类缺口规划测量,合成只提供证据的工具,并且只通过配对准入门接纳候选工具库。在十项时间序列问答任务和三个骨干上的实验表明,TimeEvo 从空工具库起步,在每项任务、每个骨干上都提高了准确率;在便宜模型上长出的工具库安装到更强模型上后,仍能带来收益。代码地址为 https://github.com/Muyiiiii/TimeEvo 。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-23T03:08:12+00:00(UTC),北京时间 2026-09-23T11:08:12+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对 Introduction、方法、Figure 2、Tables 1–2、工具准入与部署附录、多轮演化及迁移实验。代码状态另依据本次查看的官方仓库;摘要的“每项任务都提高”对应主实验,不能覆盖所有迁移或诊断设置。
DSC-Gate:策略更新后,旧动作信用不一定要全部重算
作者: Hongye Yang、Boxiao Huang。
机构: Georgia Institute of Technology,College of Computing。依据 v1 PDF 第 1 页。
任务背景。 一个处理退款的 Agent,可以先检查订单状态,也可以先核对退款资格,之后再完成退款流程。过去的交互告诉它,从哪个动作开始更容易成功,这就是这里的动作信用:给定后续策略,某个起始动作预计能带来多少回报。现在 Agent 经过一次训练,后续处理变好了,旧信用还能不能用?
直接重跑所有路线最稳妥,却需要大量新工具调用。本文关心的是更小的问题:即使两个动作的绝对回报都变了,它们的先后排名也可能没变。只有变化足以影响当前选择,重新收集证据才有必要。
核心方案。 系统先比较两个起始动作会把 Agent 带到哪些后续状态。如果模型更新主要影响两条路线都会经过的地方,收益可能共同增加,排名仍然稳定;如果更新集中在只有一条路线会经过的地方,就更可能翻转选择。论文把“分支访问差异”与“策略更新影响”结合起来,估计本次变化对这两个动作差距的敏感程度,而不只看整个模型改了多少。
接着用旧轨迹做便宜的校正。旧回报作为锚点,系统查看新策略相对旧策略如何改变轨迹中后续动作的概率,再用这些变化估计信用的一阶修正。它需要保存旧策略概率等信息,也依赖旧数据覆盖到相关行为;不是把旧答案换个权重就能处理任意大的策略更新。
最后,门控程序依次做三个判断:旧差距扣除漂移和不确定性后仍足够明确,就直接复用;否则计算修正后的差距,如果仍能分出胜负,就采用校正值;两者都不够才运行新策略补采样。这里保存的是轨迹、信用估计及校正证据,后继策略可以继续利用它们。门限由独立开发、校准任务确定,主测试冻结,不能把经验校准当作任意分布下都成立的保证。
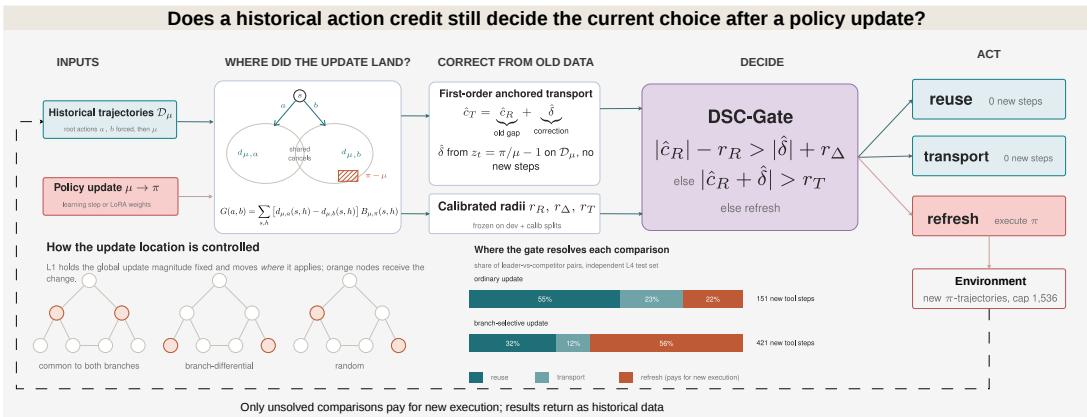 原图:v1,Figure 1,PDF 第 3 页,出处。
读图。 从左边的旧轨迹和策略更新开始,信息分成两路:上路找出更新与分支差异的重合位置,下路用旧轨迹校正信用并估计不确定性。两路在右边门控处汇合,分别流向复用、校正或刷新。只有刷新分支向环境请求新执行;底部返回箭头表示新证据会补进历史记录。图展示的是一次更新之后怎样节省重估成本,并没有画出一个自动改写训练算法的递归过程。
实际增量与通俗理解。 这不就是旧数据能用就接着用,不够再采新数据吗?新增机制是把“够不够”定义为能否可靠区分当前竞争动作,并利用分支差异估计排名翻转风险。它因此允许绝对价值有所漂移,却保留仍然正确的选择,也避免为本来没有竞争的动作花大量预算提高数值精度。
证据与局限。 在独立的 360 个工作流任务上,新工具步数从 472 降到 286,减少 39.4%;相对基于旧差距的门控,平均 regret 只增加 0.00004,置信区间落在预设非劣界内。真实零售工具 Agent 的一次 LoRA 更新后,新步数从 207 降到 143,观察到相同方向。这里节省的是更新后的额外交互,旧数据、策略训练和大规模校准的成本未计入这组在线数字。历史样本不足、更新过大、行为支持不足时,校正会失效或变得不确定,仍须采新数据;不能将一次更新的结果写成长期免重估。
评测数据集与环境。 DSC-Gate 自建工作流套件:L1 用 120 开发、120 迁移、240 确认任务研究漂移;L2/L3 另有 480 个任务,按 96 开发、96 校准、288 确认划分;L4 再用 360 个独立任务评估冻结门控。每动作历史预算 16/64/256 条、五个种子属于重复采样,不是独立任务。指标为信用误差、动作选择 regret、新工具步数。τ³-bench:真实验证使用 retail 与 Qwen3-4B-Instruct-2507,一次 LoRA 更新,三个根动作各 64 条旧 rollout;本篇独立任务数及固定 release 未说明,保留缺口,不套用他篇规模。依据 v1 Experiments、Real-tool Validation、Appendices A–G。
[!abstract]- Abstract 完整中文翻译 工具使用 Agent 会不断用新的交互数据更新。然而,每次策略更新后,先前估计的动作信用可能已经过时。从头重算可能需要大量额外工具调用和环境交互,让重复更新越来越昂贵。我们提出一个简单问题:历史动作信用究竟何时需要更新?关键观察是,动作价值改变并不一定意味着决策改变。只要策略造成的漂移不足以推翻已有动作排名,历史信用仍然有用。基于这一点,我们引入成对分支敏感性,刻画策略更新对区分两个候选动作的下游区域影响有多强。然后推导一阶锚定信用迁移估计器,用旧干预轨迹更新历史信用,并提出决策充分信用门 DSC-Gate,在复用、迁移和重新采样之间选择。实验表明,分支敏感性对信用漂移的解释力明显强于全局策略距离。有足够历史数据时,信用迁移能降低估计误差,但对决策的帮助主要集中在影响动作区分分支的更新上。在完全独立的测试集上,相较基于差距的门控,DSC-Gate 的平均 regret 只变化 +0.00004,同时把平均新增工具步数从 472 降到 286,减少 39.4%。真实工具 Agent 的参数更新后也观察到了相同模式。总体而言,结果说明 Agent 无需在每次策略更新后重算动作信用:大量历史证据可以复用或低成本校正,从而减少保持动作决策有效所需的额外交互。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-24T04:13:15+00:00(UTC),北京时间 2026-09-24T12:13:15+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对 Introduction、分支敏感性与一阶迁移推导、DSC-Gate 算法、L1–L4 实验、真实参数更新验证及 Appendix G 成本核算。非劣结果只对应论文预设任务与校准条件。
DCE+SRCL:让今天学会的反思,成为明天的教师反馈
作者: Shangjian Yin、Zehao Zhao、Kavosh Asadi、Rui Liu、Yuchen Lu、Shike Mei、Hang Cui、Luke Simon、Zhouxing Shi、Hamed Firooz。
机构: Meta AI、University of California, Riverside。依据 v1 PDF 第 1 页。
任务背景。 模型拿到一道数学题,要独立写出推导和最终答案。训练数据有参考解答,但部署时没有;训练要解决的是:怎样把“看过参考解答时知道该如何继续”的能力,转移给只看题目的模型。与只在整段答案结束后给对错奖励不同,蒸馏可以在模型自己走出的每一步上提供下一词分布。
如果始终让初始模型担任教师,它可能在学生已经学会回头检查时,仍然建议立即结束。本文因此让教师随学生更新,同时处理另一个副作用:反思更强后,解答可能越来越长,重复怀疑已经走对的步骤。
核心方案。 在第 k 轮,当前模型只看题目,先生成自己的解答轨迹。训练随后把同一参数版本放进教师角色:教师额外看到参考解答的开头,并沿学生已经生成的前缀预测下一词;学生仍然只能看题目和自身前缀。把两种上下文下的预测分布拉近,就能让学生在它实际容易走到的位置学习更合适的继续方式。教师输出作为停止梯度的目标,更新只通过学生分支进行;一次更新后的参数又同时成为下一轮学生和教师,这就是动态共同演化 DCE,并不是两个独立模型各自训练。
为了减少反复自我怀疑造成的冗长,当前模型还会在不看参考解答的情况下,改写自己刚生成的回答。系统只接收更短、自然结束、结构有效、保留完整推理且最终答案通过检查的改写,再用交叉熵学习这些简洁目标;没有合格改写就只做蒸馏。这部分称为 SRCL。参考答案没有交给改写模型,但仍用于验收,所以整个流程有外部真值约束,不能称为完全无监督自改进。
后继继承的是模型参数,既影响下一轮自己生成什么轨迹,也影响拿到参考解答后会提供什么反馈。参考数据、损失形式、验收规则和外层训练程序仍由研究者固定。主设置还改变了参考解答放入上下文的位置,因此需要看教师刷新与提示格式的交叉消融,不能把全部差值都归因于“递归”一个因素。
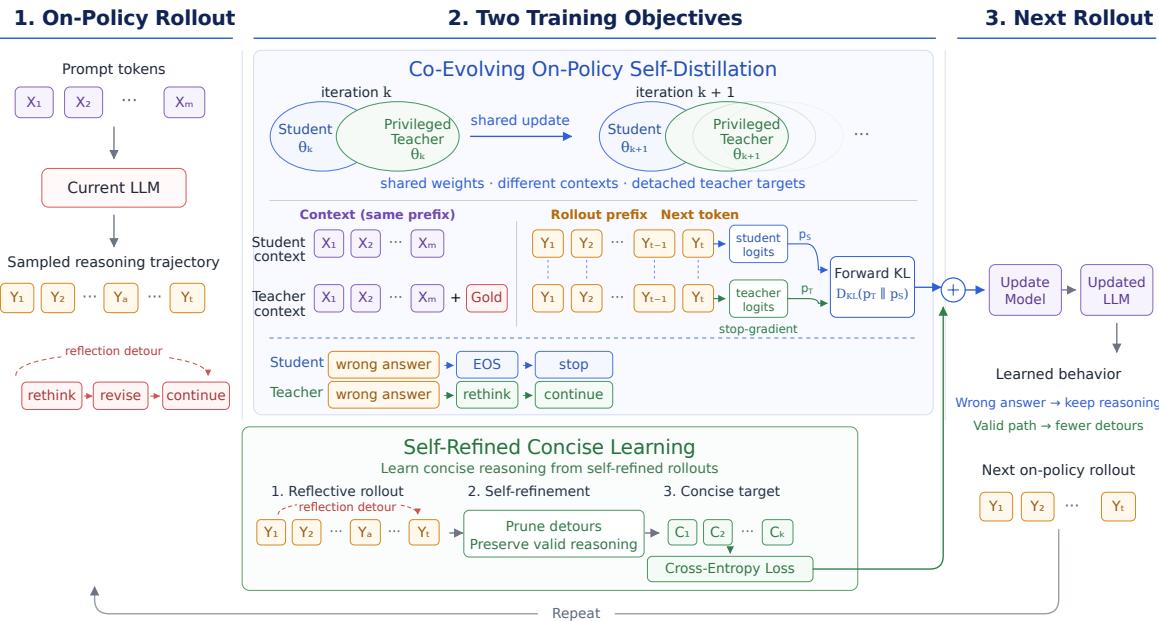 原图:v1,Figure 2,PDF 第 5 页,出处。
读图。 左侧模型先生成一条轨迹,进入中间上下两条训练路径。上路把同一前缀分别交给普通学生和多看了参考解答的教师,比较下一词分布;教师旁的 stop-gradient 表明目标不会从这条分支反向更新。下路删去原回答的绕路部分,合格改写才产生简洁性训练信号。两路在右侧汇合更新参数,底部回箭头把更新后的模型送回下一次采样。图中的“学会继续推理、减少绕路”是预期行为;训练曲线才能回答这些行为是否真的持续改善。
实际增量与通俗理解。 这不就是让同一个模型先看答案当老师,再不看答案当学生吗?新增的关键是老师也随着学生参数刷新,使新学到的修订行为进入下一轮教学;再用经过答案验证的短改写,约束这种教学是否只让推理越写越长。它修改了反馈生成模型,尚未让系统自己改写反馈目标或优化算法。
证据与局限。 Qwen3-8B 在四个竞赛数学集上的 Average@12 为 65.97%,对照 OPSD 为 30.35%;相对只有 DCE 的设置,输出长度减少 7.80%,但相对 OPSD 仍明显更长。原模型开启 thinking 的参考成绩已达 62.08%,所以这不是从完全没有的推理能力凭空增长 35.62 个百分点。教师刷新与上下文位置的交叉实验支持刷新有独立贡献,但各方法的实际生成量不同,相同长度上限不等于等计算预算。
更值得保留的是反例:1.7B 模型的 DCE+SRCL 在第 50 步达到 26.88%,继续到第 200 步降至 1.53%,回答几乎顶满长度预算。主结果来自选取的训练 checkpoint,论文还在同组基准上反复比较超参数;没有清楚给出独立选模集与一次性确认测试的完整隔离协议。因此,它提供了递归教学的机制和有限实验收益,也直接展示了训练失稳,不能当作持续增长已被证明。
评测数据集与环境。 主评测为 AIME 2024、AIME 2025、AIME 2026 和 HMMT February 2025,每套 30 道,共 120 道独立题;每题采样 12 次,报告平均答对率 Average@12,而非 12 次中至少一次答对的 pass@12。生成上限 32K,温度 1.0、top-p 0.8;训练用 14,717 道 OpenThoughts 数学题,训练与评测用途分开。附录另评 MATH-500、GPQA-Diamond、AMC 2023,也报 Average@12,本篇未明确逐套实际题数与固定 release,不从名称或其他论文代填。依据 v1 §4、Tables 1、11–19、24、26;这些基准也参与 checkpoint 和超参数比较,独立选模边界待核实。
[!abstract]- Abstract 完整中文翻译 On-policy 蒸馏让学生模型先生成轨迹,再匹配外部教师对下一词的预测,从而向学生提供密集的词元级监督。On-policy 自蒸馏 OPSD 去掉了外部教师:学生的一份冻结副本在上下文中额外获得标准答案,作为教师;学生只接收问题,并学习模仿这个拥有额外信息的教师,而教师在整个训练期间保持冻结。已有研究表明冻结教师有助于训练稳定,但我们认为,这也可能阻止教师吸收学生在训练中学到的改进。我们的主要贡献是用包含两个互补组件的递归框架解决这一限制。首先,让拥有额外信息的教师与学生共同演化,使一轮学到的修订行为指导下一轮,我们将其称为动态共同演化 DCE。其次,更强的修订能力也可能让回答过于冗长、反复自我批评,因此我们还使用模型自身 on-policy 回答经过验证的较短改写进行训练,称为自精炼简洁学习 SRCL。全面评测表明,DCE+SRCL 在多个模型规模和四个竞赛级数学基准上优于 OPSD。具体而言,在 Qwen3-8B 上达到 65.97% Average@12,比 OPSD 高 35.62 个百分点,同时相对单独 DCE 将平均输出长度减少 7.80%。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-25T00:42:31+00:00(UTC),北京时间 2026-09-25T08:42:31+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 首页写有 September 11, 2026,但它是稿件内日期;本条按已核实的 arXiv v1 提交日期记录,不把稿内日期当作首次公开。重点核对训练算法、Figure 2、教师刷新与提示格式消融、小模型全程曲线、额外基准和解码预算。
MemProbe:记忆答对了多少,还要看该改时改没改、不该改时守没守住
作者: Jiaqi Ding、Guorong Wu。
机构: University of North Carolina at Chapel Hill,Department of Computer Science;Guorong Wu 另署 Department of Psychiatry。依据 v1 PDF 第 1 页。
任务背景。 记忆系统持续接收用户对话或工具状态,之后需要回答“现在是谁负责这个项目”“之前是谁”“这次变更来自哪里”。例如,已经确认的负责人交接应该更新,另一个同事临时帮忙则不应覆盖负责人。系统要保留当前值,也要区分旧值、消息来源和变化顺序。
两个系统可能总准确率相近,一个却太容易被新说法带跑,另一个则守着过时信息不肯改。本文试图让这两种失败在评测中分别显现,而不是继续压成一个分数。
核心方案。 研究者先规定一条事实最初是什么、新信息何时出现、可信度如何,以及最终应该更新、保留还是保持不确定,再生成自然对话。四类实验分别改变新旧关联的干扰、误导来源、旧事实被重复强化的程度,以及旧记忆是否在新信息出现前被重新唤起。这样,两段表面都像“后来又有人说了一个值”的对话,可以对应不同的正确更新行为。
每个 episode 都从空记忆开始,逐条输入会话,不能在回答时直接把整段原文塞回记忆系统。到提问阶段,再取出系统保存或检索到的信息,交给尽量统一的 reader 回答。除了当前事实是否答对,还检查旧事实、来源、冲突状态和时间顺序;把需要接受有效更新的题单列为可塑性,把需要抵抗弱证据的题单列为稳定性。这里沿时间保存的是记忆状态,没有训练一个会自行改进维护规则的模型。
为了定位失败,论文另设全上下文读出、普通检索和直接提供相关证据的诊断对照。如果原文全给时能答对,系统取出的记忆却答不对,问题可能在保存或检索;即便给了相关片段仍答错,才需要继续检查证据整合和 reader。对照帮助缩小原因,不能仅凭一个差值就认定某个内部模块必然有错。
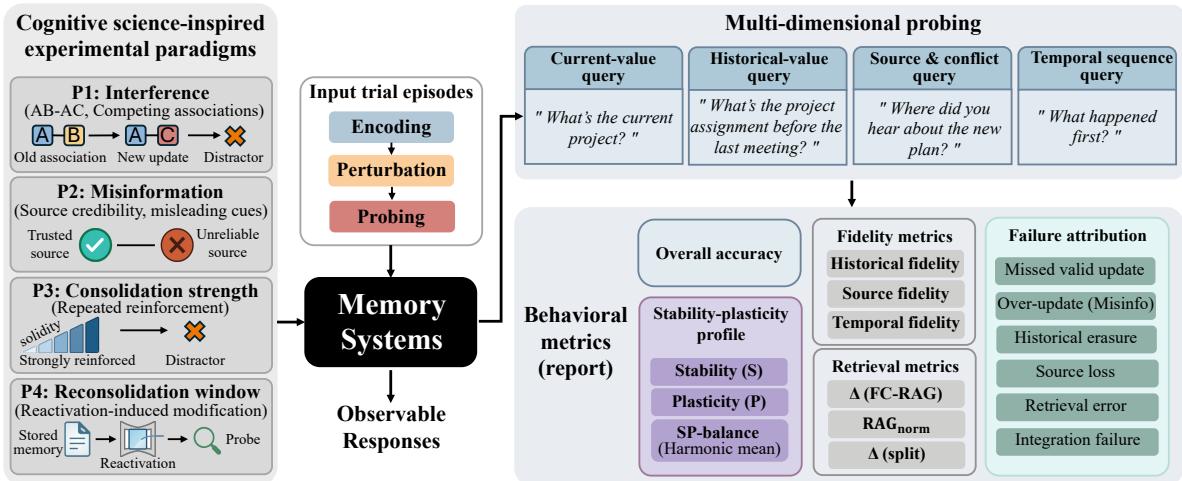 原图:v1,Figure 2,PDF 第 4 页,出处。
读图。 左边四类实验控制“记忆受到什么影响”,中间按建立记忆、施加扰动、提问的时间顺序交给被测系统。右上不同问题读取当前、历史、来源和时间信息,回答再向下进入稳定性、可塑性和失误类型统计。图是一次诊断的流程,没有从成绩返回系统训练的箭头;不要把测量框架读成自动改进记忆的闭环。
实际增量与通俗理解。 这不就是给记忆系统设计一组更新和抗干扰测试吗?关键是把“正确答案是什么”背后的更新条件控制住,再分开测保存、覆盖、来源归属与时间重建。总分相同的系统因此可以显出相反的维护倾向。
证据与局限。 主套件中,Graphiti 和 LangMem 总分为 62.5% 与 65.2%,但前者更能保留历史值,后者更容易跟上当前值;A-MEM 总分 88.4%,来源归属却只有 64.5%。换成 Qwen3-32B reader 后,绝对成绩下降,排序大体保留,说明 reader 同样影响结果。附录用 40 个新 episode、12 种不重叠事实类型和另一生成模型做了复查,主要诊断方向重现,部分系统排序变化。它仍是人为控制的小样本场景;统一 reader、兼容性补丁和未纳入的系统限制了产品间比较。本次打开官方仓库显示为空,不能按论文的发布声明认为完整实验包已经可用。
评测数据集与环境。 MemProbe:主套件 56 个 episode、1,246 条会话、224 个探针问题,四类各 14 个 episode;12 个 episode 的关键信息分散在不同会话,44 个不是。另有 40 个独立构造的 episode,不能把第二套的会话数、探针数按主套件比例推算。六种增量记忆系统使用逐会话摄入,主 reader 为 Gemini-3-Flash,支持配置时内部抽取用 Gemini-2.5-Flash;第二套用 GPT-5.6 reader。指标包括各类探针准确率、稳定性/可塑性及调和均值、来源与时间保真度,置信区间按 episode 重采样 2,000 次。依据 v1 §4–5、Appendices A–F;它是诊断测试,未划作训练集或更新验收集,组件精确版本待实验包公开后核对。
[!abstract]- Abstract 完整中文翻译 Agent 记忆系统越来越多地用于维护长期用户偏好、任务状态和不断变化的事实,但现有评测经常把记忆行为压缩为最终答案准确率。我们提出 MemProbe,一个受认知科学启发、用于诊断 Agent 记忆稳定性与可塑性权衡的框架。它源于认知记忆研究的一项核心认识:记忆具有重构性,并受到干扰、来源可靠性、强化和重新激活的影响。MemProbe 将这一认识转化为四种可复用实验范式:干扰、错误信息、巩固强度和再巩固窗口,用来控制何时应该更新记忆、保留记忆或视为不确定。它进一步把正确性拆为行为画像,揭示系统如何更新、保留、归属和按时间组织信息。我们用一个包含 56 个 episode 的诊断套件实例化这些范式,并在统一协议下评估六种增量记忆系统。结果表明,总分相近的系统具有不同的行为画像。MemProbe 提供了这样的诊断视角,将总体表现转化为可解释的、随时间维护记忆的行为画像。代码地址为 https://github.com/jq-ding/MemProbe 。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-24T21:10:36+00:00(UTC),北京时间 2026-09-25T05:10:36+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对四类实验设计、Figure 2、Tables 1–8、reader 消融、主套件构建与 Appendix F 独立实例。发布状态以本次打开官方仓库为准;摘要的发布声明按原文翻译。
CPB:共享记忆里的多次赞同,可能只是一条消息被反复转述
作者: Xiaoyang Li、Yiqi Wang、Chencheng Zhu、Ke Xu、Wencheng Yang、Zequn Sun、Pingan Song、Yiqun Duan、Taotao Cai。
机构: University of Southern Queensland、University of New South Wales、Aikaier、Nanjing University、Facebook。依据 v1 PDF 第 1 页,保留论文署名,不按作者现职推断。
任务背景。 六个 Agent 分别读取分配给自己的来源,把候选事实交给共享记忆的准入策略。策略可以写入、要求更多证据、只保留在本地或弃权;只有写入的内容,下一轮才会被其他 Agent 检索。最后,一个没有外部来源的消费者只根据共享记忆回答问题。
假设最初的一条错误消息被三个 Agent 换种说法复述,它看起来像得到三次支持,实际上可能没有任何新增证据。一旦被写入,后续 Agent 又把它当作依据,错误就获得了继续传播的机会。论文要分清:准入时有没有误判独立性,以及写入后是否真的被读取和采用。
核心方案。 CPB 先构建两种互补测试。静态部分从公开标注材料取得事实判断,再人为配置 Agent 看到哪些证据、来源之间是否同源,并用固定准入规则给出标准动作。来自同一个根来源的三段支持只算一个独立来源。它能大规模检查策略是否遵守这套规范,但传播后果仍来自设计好的模拟,不能直接代表运行中的团队。
动态部分真正运行 Agent、共享库和消费者:每轮按固定顺序处理候选,记录每次写入与检索,再观察消费者最后说了什么。评测者事先知道输入来源的谱系,策略本身看不到这个真值;新生成说法的派生关系也并非完全可观测,主要依赖 Agent 声明。因此,源头真值用于评价,不被偷偷交给普通策略。不同策略改变了库内容,后续 Agent 产生的候选也会改变,不能假设它们始终面对同一条候选流。
论文比较多数表决、近重复去重、疑似复制折扣、来源类型门控和模型审查等策略,再分别统计真假信息的准入率、错误内容的实际暴露和最终采用。保存到下一轮的是共享事实;没有更新模型参数,也没有学习一个逐轮变强的准入器。循环用于观察记忆写回怎样影响后继行为。
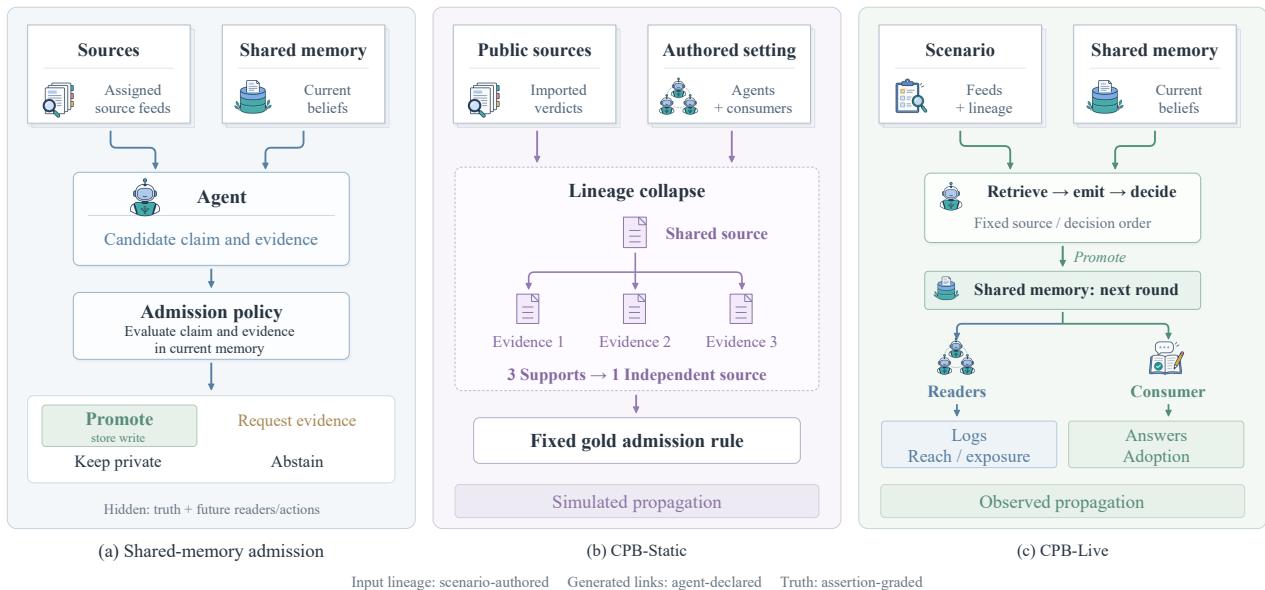 原图:v1,Figure 1,PDF 第 3 页,出处。
读图。 左边先看通用准入接口:来源和已有记忆进入 Agent,候选事实送到策略,四种动作中只有绿色的 promote 会写库。中间是静态测试,同根的三条证据合并成一个来源,再与固定标准动作比较。右边则是实际运行:写入后的共享库被读者和消费者使用,一路从日志统计暴露,一路从答案统计采用。两条测量路径不能混为“造成了现实损害”,它们都是这个模拟环境内的后果。
实际增量与通俗理解。 这不就是防止把转载当成多个独立消息源吗?新增的是把这件事放进持续读写的 Agent 团队,既测写入决策,又测后继是否受影响;并明确承认输入来源的谱系与生成内容的派生链有不同的可观测程度。
证据与局限。 按声明的来源类型设门,消费者错误采用率为 0.06–0.09,低于其他能够回答的策略的 0.22–0.47;但“来源自称权威”本身也能误导策略。只要库里留下没有相竞争真消息的错误事实,消费者在 0.97–0.99 的探针上会复述它;这个数字受“消费者只能读库”的实验条件约束。更严格的去重会同时拒绝许多真消息,不能把错误采用率低单独当作更好的学习或共享能力。论文没有做等回答覆盖率的完整比较;不同策略面对的后继候选不同,结果主要是系统级诊断而非纯分类器胜负。完整运行记录还注明待接收后发布,本轮没有复跑。
评测数据集与环境。 Correlated Promotion Benchmark(CPB):Static 为 1,200 个六 Agent episode,600 训练、200 验证、400 冻结测试;训练基线和阈值只用对应划分。Live 每个骨干运行 100 个预设配置,每配置六 Agent、六轮,其中 60 个基础配置含 50 个场景及 10 个换序变体,另有两组各 20 个双来源/改写配置;四个骨干重复相同配置族,不等于 400 个独立新场景。额外 30 个真假与形式交叉配置只在两个骨干上运行,不并入主表;审查器比较使用基础 60 个配置。指标包括真假准入、日志暴露、消费者采用和答对率;Static 的标准动作由规则定义,Live 的后果来自运行日志与答案。依据 v1 §3–5、Appendices A–B、E、I、O、R;原始语料只是构造来源,不把 FEVER 等材料的全量规模计入本篇测试。
[!abstract]- Abstract 完整中文翻译 评估共享 Agent 记忆中的事实准入很有挑战,因为反复出现的说法可能被误当成独立证据。Agent 可能复制或改写检索到的信念,而接受一条错误事实会让后续 Agent 暴露于它。为研究这一问题,我们提出相关性晋升基准 CPB,评估候选事实是否应该进入共享记忆。CPB-Static 从公开标注来源构建冻结测试划分,并给出固定标准动作。CPB-Live 让多 Agent 团队运行在共享存储之上,记录全部写入和检索,并追踪场景定义的来源谱系。一个独立消费者仅依据存储内容作答。我们在四个 Agent 家族上评估八种准入策略。结果表明,对来源去重的策略在拒绝错误事实的同时,也拒绝许多真实事实;保持回答覆盖率的策略则接纳了几乎与无限制共享同样多的错误事实。根据声明的来源类型设门,将错误采用率降到 0.06–0.09,其他可回答策略为 0.22–0.47。一旦一条没有竞争真消息的错误信念进入记忆,所有家族的消费者都会在 0.97–0.99 的探针上断言它。没有一种非 oracle 策略能够在原文复制、改写和自称权威的改写三种情况下都稳定拒绝错误事实。这些发现揭示了无法访问来源谱系的准入策略的局限。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-25T04:48:31+00:00(UTC),北京时间 2026-09-25T12:48:31+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对 Figure 1、准入定义、Static/Live 构建、Table 1、消费者采用条件、评分审计和 Appendix R 发布边界。作者列出的代码入口,本条不宣称已验证完整产物可下载。
LW2S:验证器有没有用,要比较同一道题跳过它之后会怎样
作者: Jinfeng Xu、Zheyu Chen、Ziyue Peng、Zheng Lin、Shuo Yang、Jinze Li、Zheng Xing、Mengran Li、Victor C. M. Leung。
机构: The University of British Columbia、The Hong Kong Polytechnic University、The Hong Kong University of Science and Technology、University of Luxemburg(原文拼写)、The University of Hong Kong、Shenzhen University、Sun Yat-Sen University。依据 v1 PDF 第 1 页。
任务背景。 一个解题工作流先规划,让两个执行者各自回答,再验证,最后整理答案。对于代码题,交付的是能通过测试的程序;对于数学和选择题,交付的是可与标准答案比较的结果。后面的验证和总结有时能纠错,有时只增加 token,甚至把已正确的中间答案改错。
只保存“完整跑完后成功了”不能说明验证器有贡献,因为不知道没有它会怎样。本文从同一道题的受控跳步轨迹学习:看到当前中间结果后,哪些后续步骤值得继续执行?
核心方案。 训练阶段对同一道题既运行完整流程,也分别运行只跳过一个组件的流程,记录结果、token 和延迟。只有在其他条件保持一致时,二者的差异才可归因到这次跳步。系统把“跳过后奖励不低于完整流程”作为标签,针对每种跳步动作训练一个逻辑回归模型;输入来自当前已经看到的文本、答案一致性或可执行测试,不能使用尚未运行的后续结果。
预测概率还不够。系统在独立校准来源上选阈值,要求退化风险和收益满足规则;多个来源要分别通过,不能用一组大收益掩盖另一组损害。实际执行还需通过任务相关条件:数学题检查执行者数值是否一致,代码题可要求两份程序都通过可见单元测试。选择题字母一致可能只是共同误解,因此它只是可检查的信号,不能当作答案正确的保证。
如果当前不适合跳过验证器,工作流照常验证,之后还可以判断是否省略总结。这不是把两种省略收益相加:每道题最终选择一条实际收集过的完整后续轨迹,连到达后一个决策点所花的验证成本一起算。后继保存的是动作分类器和阈值;新题由这些固定规则控制执行,不在每道测试题上重新训练。
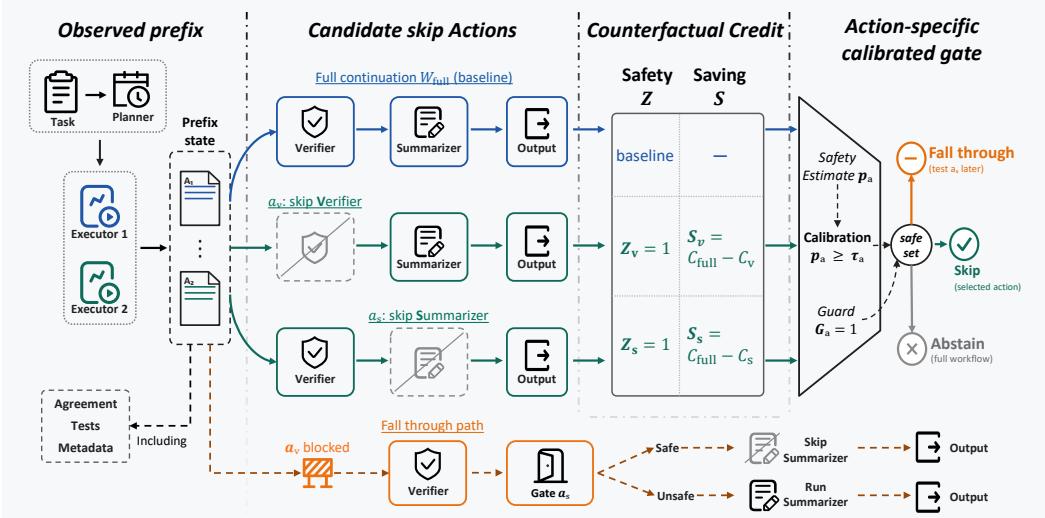 原图:v1,Figure 1,PDF 第 3 页,出处。
读图。 左边的规划与两个执行者产生可见前缀,中间蓝线是完整流程,两条绿线分别是省略验证器或省略总结的受控对照。训练时由这些轨迹取得奖励保持标签和真实节省量,右侧才学习、校准跳步门。底部橙线展示部署中的顺延:早期跳步被拒绝,就先运行验证器,再决定要不要总结;不能把图中的多个候选分支当作一次测试都要执行。
实际增量与通俗理解。 这不就是学一个便宜分类器,决定要不要继续调用模型吗?关键是监督信号来自同题的受控省略,而不是根据完整日志猜组件贡献;同时区分“在校准集没见到退化”和“任意新题都安全”。
证据与局限。 Qwen2.5-7B 在六个设置上减少 8.6%–31.2% 的组件 token,五个设置未观察到单题退化,MMLU 仍有一道被改坏,即使总准确率与完整流程相同。数学、代码的一致性信号与选择题的共同错误并不等价。基线都被改造成同一跳步接口,比较的是这套受控协议中的决策规则,不能理解成击败各原始系统的全部能力。收集完整与反事实轨迹本身有成本;节省比例是部署所选轨迹相对完整流程,不包含训练数据制作的全部费用,也不是端到端墙钟加速保证。
评测数据集与环境。 MATH 主 Qwen 设置每种省略各评 250 题;GSM8K 200 题;MMLU 100 题;MBPP 两个 slice 各 100 题,使用可见测试作为特征及相应程序奖励,未披露独立隐藏测试口径。按 Table 11 报告每个设置的准确率、单题退化、选择覆盖率和组件 token 节省,不能把两种 MATH 跳步中的题直接相加为独立样本。Table 2 资源账本记主矩阵 1,100 个任务记录、6,600 条轨迹,所有模型与拓扑实验共 3,290 个任务记录、19,740 条轨迹;跨设置重叠未充分列明。训练、校准、测试按轨迹来源隔离,完整训练数量、Mistral 逐基准题数及固定 release 待核实。依据 v1 §3–5、Appendices A.1、A.9–A.14。
[!abstract]- Abstract 完整中文翻译 多 Agent 大语言模型工作流利用规划、执行、验证和总结改善任务表现,但每个组件的价值取决于此前已经产生的状态。执行所有组件可能浪费计算,也可能覆盖一个正确的中间答案。我们把组件省略表述为反事实信用分配:完整工作流日志揭示已执行轨迹的奖励,受控跳步干预则揭示省略未来某一步的后果。我们提出 Learning What to Skip(LW2S),从这些干预中学习针对各动作的安全性模型,并结合留出校准与领域原生约束选择跳步。如果早期跳步被拒绝,控制器可以继续执行,再重新考虑后面的组件。在数学推理、选择问答和代码生成中,使用两个指令模型家族,LW2S 在已评估设置下降低了记录的 token 成本,同时保持或提高完整工作流的总体准确率。更大模型和第二种拓扑实验进一步考察组件冗余,而共同错误案例说明,仅凭一致性不足以选择跳步。这些发现把高效工作流执行与学习单个组件在当前条件下的效用联系起来。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-25T03:02:57+00:00(UTC),北京时间 2026-09-25T11:02:57+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对动作标签定义、逻辑回归特征、校准风险解释、Figure 1、Tables 1–2、10–11、MBPP 顺延记账与 MMLU 共同错误反例。这里的 safety 特指相对完整工作流不降低任务奖励,不是广义安全保证。
RL Starts before RL:蒸馏后的分数,不一定说明接下来更容易学好
作者: Shuai Dong、Yongfu Zhu、Yuqi Xu、Weichu Xie、Liuwenpu、Ziyue Wang、Kaiwen Tuo、Congcong Wang、Siyuan Wang、Wenqi Shao、Shuai Yang、Ji Zhao、Caoyuan Ma、Wenzheng Chang、Taiqiang Wu、Xinlei Yu、Hongrui Wu、Xiaoxuan He、Fangke Chen、Dianyi Wang、Kanghui Tian、Sirry Chen、Xingyu Liu、Xiangnan Wu、Jiawei Guo、Haowen Hou、LingHan Chen、Zhongyu Wei、Jiaqi Wang。
机构: Fudan University、SII(原文缩写)、JD.COM、Peking University、The Hong Kong University of Science and Technology、The Chinese University of Hong Kong、Shanghai Jiao Tong University、The University of Tokyo、The University of Hong Kong、Stanford University、Zhejiang University、China University of Geosciences、Institute of Automation, Chinese Academy of Sciences。依据 v1 PDF 第 11 页完整作者及单位表,首页仅列部分作者。
任务背景。 同一个学生模型准备进入基于答案对错的强化学习。研究者可以直接开始,也可以先让它模仿强教师的完整解答,或者让学生先写自己的解答,再由教师对学生走到的每一步提供下一词分布。最终任务是回答数学或图文推理问题,训练中的整段奖励由答案验证器给出。
通常容易先比较“准备阶段结束时谁分数高”,再选一个去做 RL。本文问的是另一件事:一个此刻答题更好的模型,是否也更适合后面的训练?如果准备方法改变了可供探索的后续路径,只看眼前准确率就可能选错。
核心方案。 实验从同一学生出发,构建三种起点。直接 RL 使用原模型;SFT 用经过验证的教师答案做逐词模仿;on-policy 蒸馏则让学生先生成自己的前缀,教师在这些前缀上给出完整下一词概率,再让学生分布接近它。后者的意义是:教师在学生实际容易走到的地方提供多种继续方式,而不是只让学生追随教师的一条既定路线。
随后三种模型进入同一组 RL 数据、验证器和优化配置,分别记录训练前后成绩。另一组对照再拆开两个因素:前缀由学生还是教师生成,以及使用反向 KL 还是正向 KL。前者倾向于惩罚学生把概率放到教师不支持的位置,后者也会惩罚学生漏掉教师支持的方向;实际作用取决于有限模型、采样前缀与优化过程,不能把它们简化为某一种永远更好。
论文还在进入 RL 之前,从同一训练池取固定难题多次采样,检查正确答案覆盖率、与教师概率分布的接近程度,以及部分推理词位置保留多少不确定性。学生参数会传入后续 RL,但教师与整套训练流程由研究者固定;这是一项“怎样准备下一段学习”的实验,不是 Agent 自己选择并递归改写学习规则。
核心方案图。 本次核对的 v1 图 1–5 均为成绩、覆盖率或分布诊断,没有独立的训练流程方案图,因此不拿成绩图代替方法图。训练时序已在上文展开;原始对照设置见文末依据。
实际增量与通俗理解。 这不就是先蒸馏,再强化学习吗?本文的关键增量是追踪同一蒸馏结果进入 RL 之后的变化,并发现准备阶段看起来更优的选择可能反转。选择目标因此从“现在多答对几题”转向“经过下一段训练以后能达到什么水平”。
证据与局限。 文本模型直接 RL 前后均分为 36.48→51.90,SFT 起点更高却为 37.75→47.48,OPD 为 37.02→59.18。也就是说,OPD 起初只比原模型高 0.54 个百分点,最终却高 7.28。图文设置中,学生前缀上的反向 KL 蒸馏先领先正向 KL(60.66 对 60.17),RL 后却落后(63.02 对 64.87);换成教师前缀,反向 KL 又在前后都领先。
初始 Pass@k 近似相同也可能出现不同训练终点,支持“覆盖率不够解释全部收益”,但分布接近、熵与成绩的相关性尚未证明因果。附录明确说运行监测到崩塌才停,各运行不一定等长,报告 checkpoint 的选择标准未记录;目标对照每种只有一次蒸馏加一次 RL,未估计训练种子方差。加上教师与准备阶段成本,这组结果支持所报终点的性能比较,不能表述成固定总预算下必然更高效。
评测数据集与环境。 本篇使用 AIME 2024 等下列评测对象,按基准等权平均,文本八行、图文二十行,并不意味着有二十八套互不重叠数据。逐项实际题数、固定 release、完整基准解码与 judge 配置未列出,以下不以基准标准总量代填。
| 用途 | 实际评测对象与本篇口径 |
|---|---|
| 文本八项;其中七项也用于图文模型 | AIME 2024、AIME 2025、AIME 2026;AMC 2023、2024 两行;HMMT(月份待核);OlympiadBench。 |
| 仅文本列表中的另一项 | MinervaMath。 |
| 图文中的综合视觉与知识问答 | MMMU、MMMU-Pro、We-Math、RealWorldQA、MMStar、SimpleVQA、AI2D、MMLU-Pro、SuperGPQA。 |
| 图文中的约束、长文档与图表 | MM-IFEval、MMLongBench-Doc、CharXiv DQ、RQ 两行。 |
这些对象用于报告训练前后表现及 VL 目标对照;选模与最终确认测试的隔离规则未明确。训练另用 100K OpenMathInstruct/100K OpenMMReasoner,RL 分别用 17K DAPO-Math/16K 混合提示。后者来源含 OlympiadBench,作者声明与评测提示分开,但没有给出题目 ID 去重清单。诊断各取 RL 池 1,024 个固定问题,每题采 64 次,不是上表基准的测试题数;训练每题 rollout 数也不能替代基准评测采样数。依据 v1 Appendices A–D、Tables 3–7、14。
[!abstract]- Abstract 完整中文翻译 强化学习能够改善推理,但表现取决于训练从什么策略开始。我们研究 on-policy 蒸馏作为 RL 的准备阶段,并询问其收益是否超出了蒸馏后模型初始准确率的改善。在相同 RL 配置下,从 OPD 初始化的学生达到比直接 RL、或先监督微调再 RL 更高的最终表现。即使 OPD 几乎没有带来即时准确率提升,这种优势也可能出现。RL 前的 Pass@k 不能完整解释收益:相近甚至更高的数值,不一定带来更好的 RL 后表现。行为分析指向一个可能解释,即超越首选词一致性的教师分布对齐。这种对齐可能偏向更高质量的推理路径,同时保留可由 RL 通过结果反馈进一步精炼的其他选择。我们进一步考察轨迹来源和散度目标如何影响蒸馏对后续 RL 的价值。标准反向 KL 的 OPD 在 RL 前更好,但正向 KL 的 OPD 在 RL 后超过它;使用教师生成的蒸馏轨迹时,反向 KL 在两个阶段都保持领先。这说明更合适的蒸馏目标取决于轨迹来源和后续训练。结果支持把 OPD 视为 RL 的准备阶段,并根据后续训练达到的表现选择蒸馏方案。
[!info]- 来源、版本与阅读依据 预印本;本次核对 v1。v1 首次提交为 2026-09-23T14:03:46+00:00(UTC),北京时间 2026-09-23T22:03:46+08:00。日期依据为 arXiv OAI 的 v1 元数据,不是网页抓取日期。原始入口:论文页、v1 PDF。 核对全文方法与行为诊断、作者完整名单、Tables 1–6、Appendix A.3 的运行及 checkpoint 边界。区分“后续采用相同配置”与“相同长度/总成本”,保留作者对机制解释的假说性质。