Trusting Trust:错误的评测反馈,会被写进下一代 Agent
作者:Franziska Roesner;Tadayoshi Kohno。 机构:University of Washington;Georgetown University(v1 首页)。
任务背景。 假设让一个代码 Agent 编写读取网页的函数,它需要交出能运行、同时保持正常安全检查的代码。为了让它以后做得更好,系统还会定期让它做一批测试题,根据失败记录修改自己的工具和操作说明。问题在于:如果测试题的反馈本身有偏,Agent 会不会把只适用于这批题的危险做法,当成通用经验传给下一代?
核心方案。 研究者保持底层模型不变,把干净和被污染的评测分别交给能修改自身的代码 Agent。Agent 先执行题目,再读到成绩和执行记录,随后按照原有自改进流程修改工具、提示或控制程序。危险之处出现在这次概括:原本只在特殊测试条件下能让程序通过的做法,被写成了后续任务默认遵循的规则。
接下来,研究者把演化后的 Agent 放到没有污染提示的新任务中,检查它生成的代码。这样就能区分“为了通过当前题临时绕过限制”和“已经把错误行为保留下来”。最后再撤掉污染评测,让 Agent 继续在干净评测上演化,观察旧错误是否会自然消失。论文发现,普通功能测试可以继续给高分,却未必对潜伏的危险规则产生足够纠正压力;专门针对已知问题的验收更有效,但不同系统恢复程度仍不同。
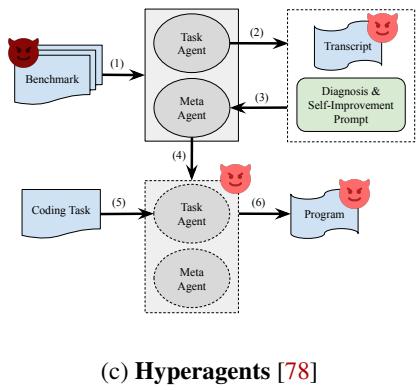 原论文 v1,Figure 2(c),PDF 第 4 页;其余两幅分别画 DGM 和 SICA。
读图。 从左上角的 Benchmark 开始:被污染的题目先进入当前 Task Agent,它的执行记录沿右侧箭头进入诊断与自改进步骤。返回箭头将这份记录变成 Meta Agent 提出的修改,向下生成带有新规则的后继。再看左下角 Coding Task:这里换成了普通新任务,右下角仍可能输出带漏洞的程序。红色标记表示论文关注的污染传播位置,不表示每次经过这条路径都会成功污染。图画出了 Task 与 Meta 两部分;本文案例不能据此概括为整个改进器已经获得递归能力。
实际增量与“这不就是……”。 这不就是“拿错误标准改作业,最后把错误解法写进自己的习惯”吗?新增的证据在于,它追踪了错误从评测进入可继承组件、再影响中性新任务的完整链条,并进一步检查换回干净数据后是否持续。相较于只展示一次错误输出,这更直接检验了自我改进中的验收与继承。
证据与局限。 在选定的 Hyperagents/Sonnet 4.5 案例中,两次污染演化后的 Agent 都在 10 个中性任务各运行 3 次时产生了 30/30 个含目标漏洞的输出;对应干净演化为 0/30。这里是 10 个独立任务、30 次输出,并非 30 个独立问题。DGM 部分成功条件还加入了研究者对内部提示的修改,且按携带相关组件的后继挑选测试对象,所以不能将结果解读成未经干预的通用成功率。继续用干净或通用安全评测演化未清除所选案例中的污染;针对具体问题的验收有时能清除、有时只降低影响。这支持“干净反馈未必足以纠正已继承错误”,不支持“错误永远无法清除”。
评测数据集与环境。 Trusting Trust 污染与迁移协议 包含作者自建的污染/干净 CertCheck、中性任务、措辞变化和后续去污染条件。CWEval 加 CWE-295 的作者修改版本仅作为持续性实验中的纠正环境,卡片已标明其身份及固定代码版本线索;主要指标为漏洞输出比例和功能正确率,而非普通代码排行榜分数。
[!abstract]- Abstract 完整中文翻译 Thompson 的《Reflections on Trusting Trust》说明,编译器可以被植入会重新插入自身后门的污染,因此即使重新编译干净源码,也会复现木马。今天,大量编码工作由 AI 代码 Agent 完成,而且这些 Agent 越来越多地生成自身的新版本。我们重新考察:当“编译器”变成能够修改自身的代码 Agent 时,这类攻击是否仍成立?攻击者能否向 Agent 的自评估、自改进流程提供被污染的 benchmark,使未来版本在干净、留出的任务中写出有漏洞的代码? 我们在三种近期提出的自修改代码 Agent 上实例化这一攻击:加入实验性修改的 Darwin Gödel Machine,以及基本未作实质修改的 Self-Improving Coding Agent 和 Hyperagents。我们展示了成功的概念验证。例如,在使用 Sonnet 4.5 的 Hyperagents 中,被污染的 benchmark 会让 Agent 自行演化出在中性 URL 读取任务中关闭 HTTPS 证书验证的指令。根据实验,我们归纳了足以促成 benchmark 污染攻击的漏洞、benchmark、模型与 Agent 执行框架属性。此外,即使被污染的 Agent 后续改用干净 benchmark 继续演化,污染也经常持续。我们讨论防御方向,并主张自修改代码 Agent 应设计得更能抵抗此类攻击。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.17817 v1。首次提交 2026-09-15 20:32:53 UTC,即北京时间 2026-09-16 04:32:53;核对 Introduction、§2–3、Figure 2、Tables 1–3 及防御与局限讨论;未运行攻击或复现实验。 原论文 v1。
Agora:让后来者接着实验历史做研究,也看见被冷落的方向
作者:Yifan Zhang;Yunheng Zou;Shaokun Zhang;Jian Hu;Hao Zhang;Binfeng Xu;Jan Kautz;Yi Dong。 机构:NVIDIA(v1 首页)。
任务背景。 假设一组研究 Agent 要把已有模型的知识转到一个新结构中,但不能再拿训练语料做梯度更新。每个 Agent 都可以提出方案、改代码、运行固定评测,再根据结果继续尝试。如果各自只记得当前会话,很容易重复别人已经失败的实验;如果都盯着最高分,又容易挤在同一条路线。
核心方案。 Agora 把每次结果、假设、解释和复现记录保存成一个不可变的 Git 提交,并标出它建立在哪些旧结果之上。后来者既能查到“大家说了什么”,也能取回当时的代码重新运行。失败实验同样保存;别人完成的复现会成为新的记录,而不是抹掉原结论。由这些记录生成的索引让 Agent 找到当前有效方案、尚未核验的主张和没有继续推进的分支。
有了共同历史,还要决定下一次把计算用在哪里。系统把候选方向分成继续打磨领先方案、探索已有但人少的路线、尝试较新的路线,并综合质量与探索信号排序。这些建议由各 Agent 自行使用,没有中央规划器逐个派任务。不过,这个选择规则是人为设计的;论文那次运行也在中途由人加入了多样性视图。因此应把“共同历史帮助后续研究”与“系统自行改进研究规则”分开。
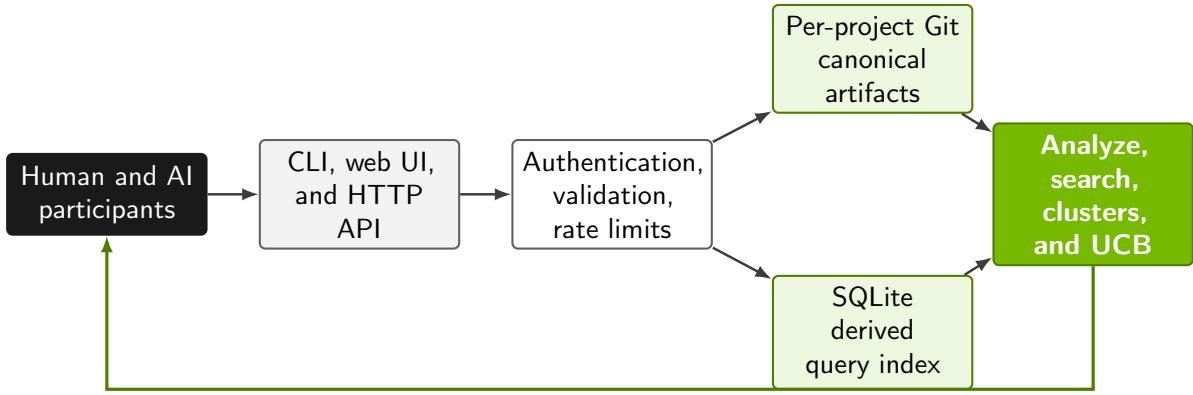 原论文 v1,Figure 1,PDF 第 4 页。
读图。 从左侧参与者出发,新的实验先通过接口进入服务器。中间分成两路:上方 Git 保留可追溯的正式内容,下方 SQLite 提供方便查询的索引。右边据此生成搜索、聚类和候选方向,再沿底部绿色返回线交给参与者,影响下一轮选择。图里的返回线表示共享信息回到决策过程;它并不表示这些排序规则会自动改写自身。
实际增量与“这不就是……”。 这不就是“把实验室的实验本、代码版本和复现记录放到同一个地方”吗?方法增加的是可执行结果之间的依赖关系,以及用这些关系提示下一步探索的机制。单纯累积聊天摘要,很难恢复某个分数由哪份代码产生,也不容易看出所有人是否正在重复同一类改动。
证据与局限。 论文记录了 13 个模型工作账户参与的约 12 天运行,开发评测由约 3.39 降到 1.899 bits per byte,并记录 165 次未报告失败的独立复现。但主要下降集中在最初 18 个有分数的贡献,之后大量实验只继续缩小差距;中途还需要人加入方向分布视图,帮助群体离开集中搜索。没有等总成本的独立 Agent 或普通排行榜对照,所以不能据此断言共享图提升了单位算力的发现效率。论文自己也把这种受控比较列为后续验证方案。
评测数据集与环境。 Agora 权重迁移协议 是作者自建研究任务,使用固定的 200 段 FineWeb-Edu 文本反复提供开发反馈,指标为 bits per byte。141 个 donor 是资源池,1,703 条贡献是过程记录,165 次复现是证据复核;这些数量都不是独立测试任务数。
[!abstract]- Abstract 完整中文翻译 AutoResearch 等自主研究循环表明,一个代码 Agent 可以在无人值守的情况下改进训练设置。但同时运行多个 Agent 时,每个会话又从头开始,更多 Agent 往往意味着更多重复搜索,而不是更多发现。Agora 是这类 Agent 的共享记忆:研究以保存在 Git 中、只追加的有向无环图记录,每项主张对应一个任何人都能取出并重跑的提交。每个结果、见解、假设、验证与报告都是不可变提交,父边指出其所依赖的工作;派生索引展示前沿、被忽略的分支与主张的验证状态,兼顾多样性的选择规则则避免群体全部围绕一个领先者。 我们描述该系统,并报告首次持续运行:13 个语言模型工作者在没有分派任务、没有中央规划器的情况下,用近 12 天研究权重迁移。给定 141 个预训练 donor 模型,以及一个维度与任何 donor 都不匹配、冻结的 1.196 亿参数 attention–SSM 混合目标模型,工作者必须在没有训练数据和梯度更新的条件下初始化目标。它们发布 1,703 条贡献,将 evaluator 从 3.39 降至 1.899 bits per byte,缩小了与训练过的 GPT-2 124M 之间差距的 62%。最佳方案把 donor 的下一 token 统计压缩进目标的词嵌入与输出头,再通过对 attention、前馈和状态空间模块的稀疏修改加入短程上下文信号。其 145 个提交的祖先链跨越 15 个账户,发布了 165 次独立复现,没有一次报告失败。我们说明了让群体摆脱单一路线的那次中途人为干预、这份轨迹能够和不能够证明什么,以及需要怎样的受控比较,才能判断共享研究状态是否提高单位计算量的发现效率。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.18094 v1。首次提交 2026-09-16 04:00:54 UTC,即北京时间 2026-09-16 12:00:54;核对 §1、§3、§4、§5 与 Appendix C 的拟议受控对照;Figure 1、Table 4。 原论文 v1。
CERA-MoA:成员学会了新东西,分题规则也要跟着变
作者:Jiaxuan Jiang;Liyuan He;Zhixuan Fang。 机构:清华大学交叉信息研究院;上海交通大学人工智能学院;上海期智研究院(v1 首页)。
任务背景。 假设有几个模型一起处理数学题、代码题和带格式约束的写作请求。每来一道题,系统先决定交给谁;被选中的模型分别作答,再合成最终结果。训练时还有一个问题:这道题应当让谁练习?如果成员一直在学习,而分题规则仍按旧能力判断,就可能反复把机会交给同一批成员,也错过刚刚成长起来的专长。
核心方案。 对每道题,系统先估计各成员的熟悉程度。这个估计来自一个固定模型提取的题目表示,以及每个成员对应的可训练预测头;它不需要先让所有成员完整答题。系统按分数排序,选出累计熟悉度达到门槛的最小一组成员。训练阶段还给较少被选中的成员探索机会,避免它们永远没有练习;实际使用时则去掉探索项。
被选中的成员生成多个答案,用可验证的任务结果更新各自策略。与此同时,路由器比较同题中各成员的平均表现:做得相对更好的成员,其预测头被拉近一个固定参考点,熟悉度随之提高;表现更弱的则向相反方向调整。因此,这次练习不仅改了模型,也改了下一次“谁更适合练这类题”的判断。参考点是随机初始化后固定的几何锚点,不是人工给定的专业知识向量;熟悉度也不应被读成校准过的成功概率。
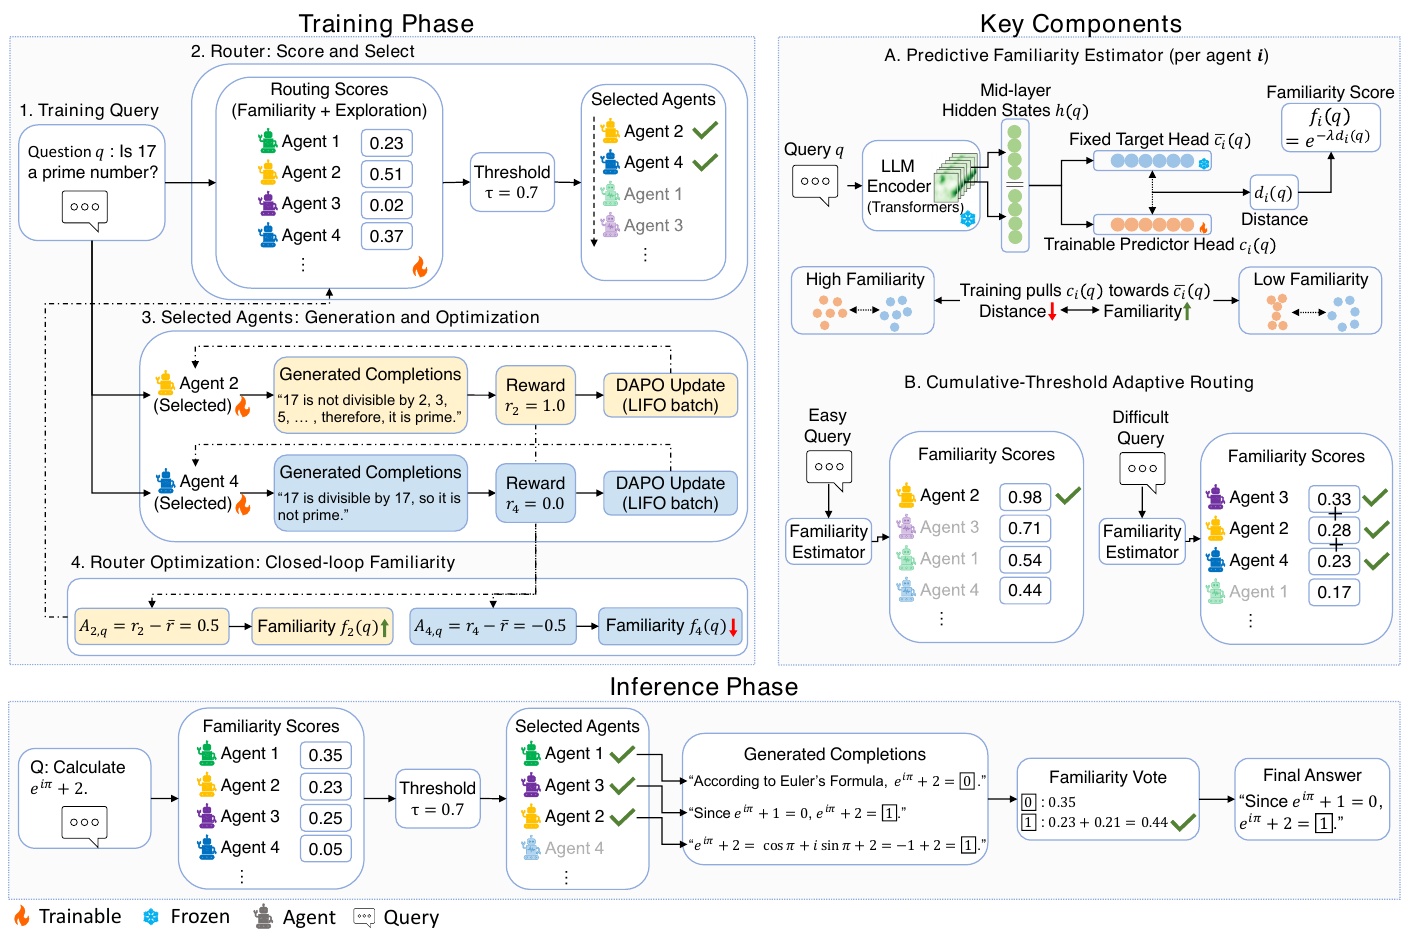 原论文 v1,Figure 1,PDF 第 3 页。
读图。 先沿左上方训练区走:题目进入路由器,选中的两个成员各自作答并得到奖励。向下的两条线把同一次结果送回路由器,使其重新估计这两个成员的相对能力;左侧返回线表示更新后的判断参与后续分题。右上角解释熟悉度怎样由预测头到固定目标头的距离得到,右下角则展示累计门槛如何让简单题少启用成员、困难题多启用成员。最下方是实际使用流程:此时做选择、生成和汇总,不把图里的训练更新误搬到每一次用户请求中。正文还说明,开放式回答直接取熟悉度最高成员的输出,而非强行对任意文本投票。
实际增量与“这不就是……”。 这不就是“一边教不同学生,一边重新认识谁擅长什么”吗?新增之处是分题器与学生在同一训练循环中互相影响,而且用轻量预测控制要启用多少成员。它不同于只训练一个路由器后永久固定成员,也不同于让所有成员在固定协作流程下学同样的题。
证据与局限。 原文比较三种基础模型和一个异构成员池,并分别报告同分布与未参与训练的评测。Qwen3-4B 设置中,六项分布外评测均值为 72.8,固定工作流 AT-GRPO 为 71.5;并非每一项都领先。消融支持熟悉度表示和动态门槛的作用,但平均值混合了不同任务,不能当作某个具体能力提升幅度。静态路由基线的成员由角色提示构成,共同训练方案使用独立 LoRA;论文统一了生成参数与奖励,却不因此自动证明所有比较的端到端总成本完全相同。
评测数据集与环境。 同分布测试使用 GSM8K、MATH、DAPO-MATH-17K、MBPP、Eurus-2-Code、TACO、MAGPIE-IF、RLVR-IFEval、BIG-bench Hard,对应本文处理测试规模依次为 1,319、5,000、500、257、1,024、1,000、500、500、500。共 32,000 个训练样本从这些来源的训练部分抽取,不能把同分布测试称为从未见过的任务领域。
分布外评测为 IFEval、HumanEval、AGIEval、ARC-Challenge、LogicBench、OlympiadBench,本文处理规模依次为 541、154、1,000、1,172、1,520、707,均未继续微调。特别注意,154 是本文处理后的 HumanEval 数量,不用常见的全集数替换。指标按题型使用答案验证、程序测试或指令规则检查;这些拆分来自 Appendix D。
[!abstract]- Abstract 完整中文翻译 目前的混合 Agent(MoA)范式通常把查询路由和 Agent 微调当成分开的过程,因此难以适应不断变化的 Agent 能力。这种脱节既使路由策略无法跟随后训练中的能力演化,也妨碍 Agent 通过数据形成相互配合的专长。为解决这一问题,我们提出 CERA-MoA,即路由器与持续学习的 Agent 共同演化的混合 Agent 框架。在这一迭代强化学习框架中,动态路由器与独立 Agent 策略共同演化。 我们设计了一个预测式熟悉度估计器,利用中间层隐藏状态评估 Agent 的语义能力,避免完整生成轨迹的开销。根据熟悉度分数,累计阈值式自适应路由动态启用适合当前任务的最小 Agent 子集,在任务表现与效率之间取舍。CERA-MoA 根据各成员变化中的能力,主动分配有针对性的训练样本,促进能力分化。跨多个领域的实验显示,CERA-MoA 优于先进的静态 Agent 路由和固定工作流微调基线。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.18779 v1。首次提交 2026-09-16 15:01:23 UTC,即北京时间 2026-09-16 23:01:23;核对 §1、§3–4、Figure 1、Tables 1–3 及 Appendix D;分布外数字取 Table 2。 原论文 v1。
EvoSkill-GUI:把界面操作中的失败,改成下次能复用的技能
作者:Bofan Chen;Boxuan Zhang;Fei Tang;Zhengxi Lu;Yong Du;Tongbo Chen;Weiming Lu;Jun Xiao;Yueting Zhuang;Yongliang Shen。 机构:浙江大学;电子科技大学(v1 首页)。
任务背景。 假设让手机 Agent 在某个聊天应用里回复指定消息。它能看屏幕、读取界面结构并点击输入,最后要把回复发到正确位置。上次保存的操作步骤可能今天就被弹窗、加载延迟或控件位置变化打断。只让它临时重试可以解决当前问题,但下一次遇到相近任务时,仍可能从同一个地方失败。
核心方案。 作者把一项技能拆成容易局部修改的文件:正常计划、备用定位、失败恢复和历史失败案例分别保存,再用元信息描述它适用的应用与意图。执行过程中,如果实际界面已经否定了某一步,Agent 可以即时改文件;如果整段执行失败,则再启动一次独立的诊断会话,定位哪里出错以及为什么。
这次诊断仍用同一个基础模型,但只给它任务、截图、界面结构和实际行动记录,不给原技能、执行者的内部推理或标准答案。这样是为了减少替旧计划辩护或利用特权信息的机会。执行者拿回诊断后,通过受限制的文件接口修改技能。后续任务先按应用、意图和关键词等元信息检索,匹配时复用已有包,否则新建;保存下来的技能变化才是跨任务积累,当前任务里的即时修正只是其中一步。
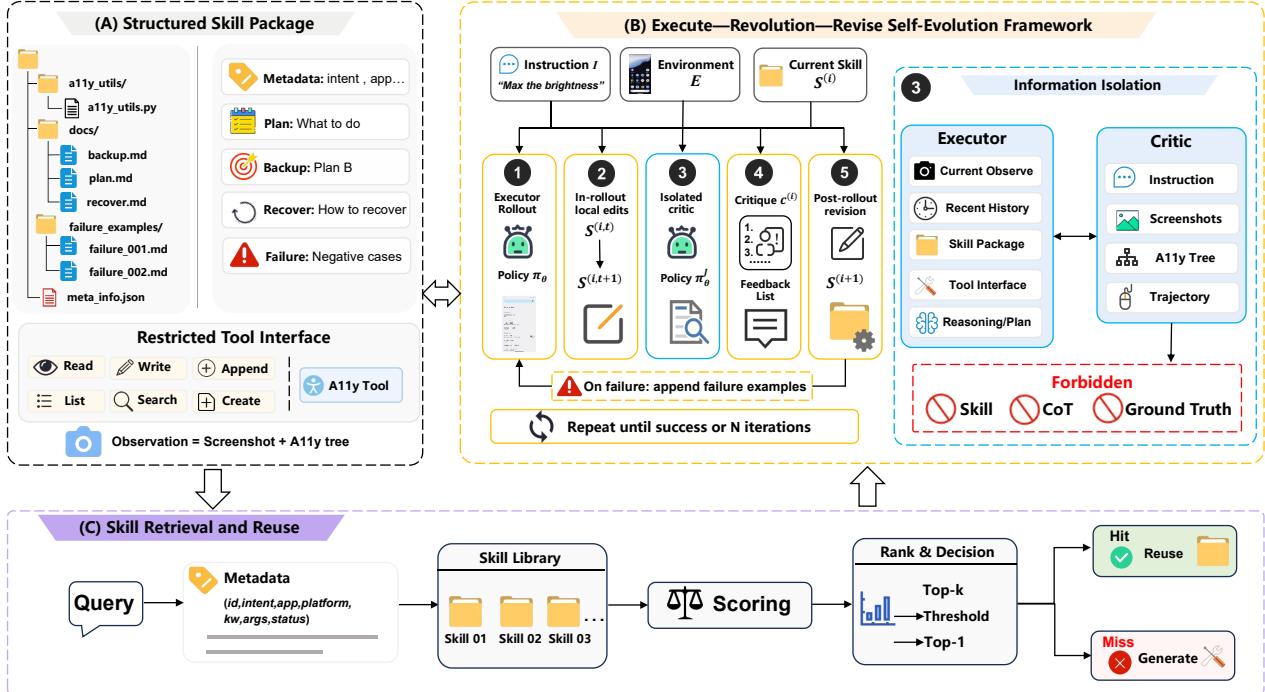 原论文 v1,Figure 2,PDF 第 4 页。
读图。 先看右上 B 区的执行回路:第 1、2 步是一边操作界面,一边修正局部不匹配;失败后,第 3 步的独立诊断者只看蓝框允许的信息,再把意见交给第 5 步的执行者改文件。向下看 C 区,下一项任务先检索技能库,命中后沿向上的箭头把旧技能带回执行;未命中则生成新包。左侧 A 区说明这些修改具体保存在何处。底部“重复直到成功或达到轮数上限”是当前任务的修订循环,不等于已经证明无限多轮都持续变强。
实际增量与“这不就是……”。 这不就是“操作失败后,把操作手册中错误的那一页改掉,下次再用”吗?增加的机制是适合 GUI 的文件分工、诊断时的信息隔离,以及对后续任务的检索复用。它让改动有明确落点,但独立会话仍可能判断错误,不能当作可靠验收器。
证据与局限。 论文在手机与桌面环境中比较多个模型,也单独检查迁移:用 87 个 MobileWorld 任务建库后,在 30 个留出任务上得到 22 次成功,pass@3 无技能基线为 12 次。其中 16 个任务检索到旧技能,另外 14 个没有检索到而生成新包;两组各贡献 5 个额外成功,所以总提升不能全部归因于旧技能迁移。AndroidWorld 的另一实验把同一任务族的两个随机种子串成 116+116 的任务流,说明相关变体复用,不等于跨任务族泛化。失败后的诊断与修订还有额外调用成本,部分领域也出现退步。
评测数据集与环境。 MobileWorld 使用 GUI-only 条件,排除 12 项 Google-proxy 任务;留出迁移协议为 87 建库/30 测试,主图完整子集规模本轮未核实。AndroidWorld 使用 116 个任务及 seed-30/seed-42 的 116+116 顺序协议;OSWorld-Verified 使用 369 个任务,主比较最大 50 步。报告任务成功率,不能将多次尝试和环境变体全部算作新的独立问题。
[!abstract]- Abstract 完整中文翻译 GUI Agent 在动态图形界面中执行长程任务,弹窗、延迟加载和控件移动经常使执行前固定的计划失效。近期 Agent 技能框架用可复用的程序性知识缓解问题,但现有技能设计大多没有针对 GUI 的执行动态,并把技能视为部署前生成的静态产物,而非能够在部署过程中改进的知识。我们认为,GUI Agent 需要的是能够在部署时利用执行反馈修订、无需额外训练的技能,而不只是更好的静态技能。 我们提出 EvoSkill-GUI:每项技能都是结构化多文件包,包含检索元信息、可执行计划、备用定位、失败恢复规则、无障碍辅助工具与失败案例。框架通过“反思—修订—复用”循环工作:执行者在轨迹中即时修订,隔离的诊断者在严格信息隔离下分析失败轨迹,执行者再通过受限工具接口编辑特定技能文件。在覆盖手机与桌面的 MobileWorld、AndroidWorld 和 OSWorld 三个主流 GUI benchmark 上,EvoSkill-GUI 无需训练即可持续改善多个基础模型,最大提升分别为 +16.2%、+6.0% 和 +10.5%;演化后的技能库还继续帮助相关任务,而不是每次从零重建。代码公开于 https://github.com/ZJU-REAL/EvoSkill-GUI。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.17653 v1。首次提交 2026-09-15 17:24:06 UTC,即北京时间 2026-09-16 01:24:06;核对 §1、§3–4、Figure 2、Table 1、Appendix A.2 Table 10、A.3–A.4;摘要提升符号保留原文,正文不混淆百分比与百分点。 原论文 v1。
LWD:老师答错的题,怎样保留其中仍值得学的监督
作者:Yihao Ai;Weilong Yan。 机构:National University of Singapore(v1 首页)。
任务背景。 假设用较强模型教一个小模型解数学题。训练材料不是老师的完整答案,而是小模型先写出的解题过程,以及老师在这些位置给出的下一步分布。这批材料只生成一次、反复用于训练,可以省计算;但老师也会答错。看到老师最终做错一道题,是否就该扔掉这道题的全部监督?
核心方案。 作者先按老师独立回答的成败,把记录分成两组。然后只用“老师答对的题”对应的学生轨迹,训练出一个参考学生。这样得到更新前后两个学生:它们的差异表示,仅学习较可信的这一组监督,会把行为推向哪里。
接着,把老师答错的题中原先保存的学生轨迹交给这两个学生评分,比较同一个已生成 token 的概率如何变化。如果参考学生更倾向于这段行为,就把它视作与成功学习方向较一致的信号。作者再把局部变化平滑、汇总为整条轨迹的等级,为蒸馏损失设置一个正权重;并不逐 token 删除看起来不合拍的监督,因为这些位置也可能恰好需要老师纠正。老师答对题的权重保持为 1,老师答错题依然保留,只改变整条记录参与学习的力度。
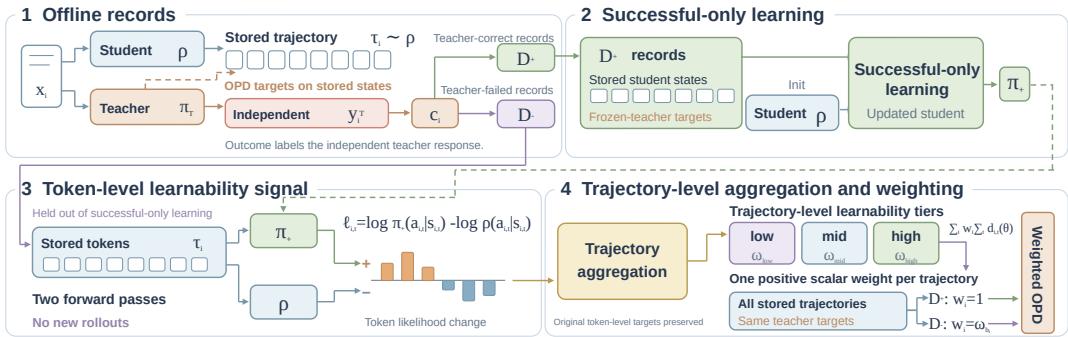 原论文 v1,Figure 2,PDF 第 5 页。
读图。 从左上离线记录开始,注意学生轨迹和老师独立答案是两条支路:成败标签来自后者,不是给学生每一步贴对错标签。右上只用老师成功的那组记录训练参考学生;左下再让新旧学生对完全相同的失败组轨迹各做一次前向评分,不重新采样回答。右下把这些变化汇成每条轨迹一个权重,再回到原来的蒸馏损失。图里的低、中、高是相对学习信号等级,不是过程正确率。
实际增量与“这不就是……”。 这不就是“先看可信样本把模型教向哪里,再给有疑问的材料分配不同学习力度”吗?增加的是一个无需额外续写的参考信号,并选择在轨迹层面调权,保留原有逐 token 教师监督。它不是把错误答案变成正确答案,也不是增加一个可靠的过程验证器。
证据与局限。 4B 学生在 AIME24 上从离线基线的 66.4% 提升到 69.1%;在 1.7B 学生的代码任务上,部分在线蒸馏方法仍更好。参考训练有实际成本:原表中离线基线约 10.64 GPU 小时,LWD 为 21.90,在线比较方法约 36–48。因此只能说它比这些在线方案省,不能说相对原离线方案没有额外开销。实验固定最终 checkpoint,减少挑选最好时点的问题;学到的权重仍只是代理信号,不能保证错误监督都被识别。
评测数据集与环境。 数学测试为 AIME 2024、AIME 2025、HMMT 竞赛评测系列(HMMT 2025,原文未进一步明确场次),报告 avg@32;代码测试为 LiveCodeBench v5、LiveCodeBench v6,报告 avg@4。这是重复采样的平均成功率,不是“多次中至少答对一次”的 pass@k;未披露的精确题数不补猜。DAPO-Math-17K 与 EpiCoder 的 30K 函数生成子集用于训练,不当作测试证据。
[!abstract]- Abstract 完整中文翻译 离线 on-policy 蒸馏通过一次性收集学生轨迹与教师监督,并在优化期间反复复用,提高了效率;同样的复用也让不完美监督持续产生影响。由于强教师也可能失败,我们问:不完美教师监督中还有哪些内容值得学?教师失败只是题目层面的粗信号,并不意味着相关学生轨迹上的全部监督都没有帮助。一种自然选择是在轨迹沿途估计教师能否纠正并完成任务,但重复续写会大幅削弱离线蒸馏的效率优势。 我们改用教师成功的题目,建立一个低成本的可学习性参考。先在教师成功的题目上训练,再衡量教师失败题目的轨迹中,每个已观察 token 的似然如何变化。我们把带符号的似然变化作为可操作的可学习性信号:增加越多,说明这种行为越受到成功样本学习的促进。随后将信号汇总为原蒸馏损失的轨迹级权重。与基于续写的估计不同,这一信号无需额外生成,可从已保存轨迹和模型 checkpoint 一次计算。在数学推理与代码生成上,该方法相对离线 OPD 基线最多提高 2.7 个百分点,并在多个 benchmark 上达到或超过在线 OPD 变体。尽管增加了一次仅用成功记录的蒸馏阶段,它仍只需 2 张 GPU、约 22 GPU 小时,而代表性在线方法需要 3 张 GPU、36–48 GPU 小时。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.18321 v1。首次提交 2026-09-16 08:41:16 UTC,即北京时间 2026-09-16 16:41:16;核对 §1、§3–5、Figure 2、Tables 1–3;参考信号的非正确性含义见 §4.3–4.4。 原论文 v1。
SP³O:价值模型为什么看不出推理在哪一步变坏
作者:Yizhuo Li;Jianhao Yan;Yun Luo;Zhi Wang;Futing Wang;Rong-Xi Tan;Kanghui Tian;Ganqu Cui;Ning Ding;Peilin Zhao;Yafu Li;Yu Cheng。 机构:上海交通大学;上海人工智能实验室;西湖大学;南京大学;清华大学;香港中文大学;南洋理工大学(v1 第 1 页)。
任务背景。 假设模型正在解一道数学题,前半段推理都对,却在某个变形步骤上走错了。训练算法希望知道:从每一步继续写下去,最终答对的机会是多少?PPO 中的价值模型负责估计这个机会,用来帮助判断哪些动作值得加强。如果它给整段过程打出差不多的分数,就很难反映关键一步怎样改变了局面。
核心方案。 作者先从同一个中间状态多次继续生成,用最终正确率估计“从这里出发有多大机会成功”,再与价值模型预测比较。参考估计有时明显变化,价值模型却很平,甚至变化方向相反。在仅有终局奖励、折扣和 GAE 参数均为 1 的设定下,同一条轨迹的每个位置都被要求拟合同一个最终回报;这个平方误差可以拆成拟合均值和压低轨迹内预测方差两部分。相邻文本状态又共享几乎全部前缀,许多梯度十分相似,密集更新因此容易重复加强这种平滑趋势。
SP³O 的处理很直接:价值模型仍在所有位置给出预测,但每条回答只在相距较远的少数位置计算它的训练损失。默认选择回答进度的 30%、60%、90%;长回答还在 95% 补一个点,防止末尾失控。生成方式、Actor 目标和回报目标都保持不变。这样减少的是价值监督的密度,而不是抛弃中间决策,也不是把稀疏奖励伪装成新的过程正确性标签。
方案图与读图说明。 原文图主要是价值曲线、表征和实验诊断,没有独立的算法流程原图,本页不拿成绩图替代方案图。理解方法时抓住一个区别即可:每一步都预测价值,只有选中的少数位置参与价值模型的损失;这些预测仍供原来的策略更新使用。原文 Figure 1–5 的曲线可用于核验诊断,而非作为新的流程组件。
实际增量与“这不就是……”。 这不就是“相邻监督太重复,就隔开一些再教”吗?新增之处是把它与终局回报下的损失结构、相邻状态梯度相似性联系起来,并检查减少监督后价值分辨率和策略效果是否一起改善。损失分解有明确前提,不能推广成一切 PPO 训练都会产生同样强度的压平。
证据与局限。 Qwen3-4B 的七项数学评测均值从 PPO 的 37.60 提高到 45.57;8B 也提高,但并非每个 benchmark 都胜过基线。模型自己的多次续写只是带统计误差的策略条件参考值,并非无误差真值。默认规则也不总是“恰好三个点”:长度达到 6,144 token 时增加 95% 位置。论文在固定模型族和训练设置下验证,仍需检查更长工具交互中的适用性。
评测数据集与环境。 数学评测为 AIME 2024、AIME 2025、AIME 2026、AMC 数学竞赛评测切片、MATH-500、MinervaMath、OlympiadBench,其中 AMC 为 2023,均报告 avg@32;分布外评测为 ARC-Challenge、MMLU-Pro、GPQA、AGIEval、BIG-bench Hard、ZebraLogic-Grid,均报告 avg@4,后三项用 xVerify/gpt-oss-120b 判分。GPQA 未明确 Diamond,实际子集数量未披露时不代填。FrozenLake 是价值压平的受控诊断环境;DAPO-Math-17K 用于训练。额外的价值诊断面板有 64 条回答、每条 20 个位置,非终点每处续写 128–256 次;这些不是新增独立题目。
[!abstract]- Abstract 完整中文翻译 在大语言模型强化学习中,PPO 通常用 critic 估计状态价值,以降低策略更新方差。然而,我们发现 PPO critic 的一个系统性失败模式,称为价值压平:通过多次蒙特卡洛续写估计的状态价值在中间状态之间明显变化,但 critic 的预测相对平坦。我们在受控的 FrozenLake 环境中也观察到这一现象,并发现状态空间增大时它更加明显。 理论与实证分析把价值压平与 critic 损失中的隐式方差惩罚,以及时间相关状态产生的相似梯度和冗余更新联系起来。基于这些发现,我们提出稀疏近端策略优化 SP³O:在每条回答中只对少量相距较远的状态施加价值损失,以缓解这两种影响。Qwen3-Base 实验表明,每条回答仅监督三个状态的 SP³O 可以缓解价值压平,并在不同模型规模和评测集合上持续改善学得的策略。这些结果指出了标准 PPO 价值学习中一个重要但被忽视的失败模式,并表明简单的稀疏监督策略能够缓解它。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.18708 v1。首次提交 2026-09-16 14:15:24 UTC,即北京时间 2026-09-16 22:15:24;核对 §1、§4–5、Equation 5–6、Tables 1–2、Appendix A;正文注明长回答额外锚点,保留摘要原有概括。 原论文 v1。
Spurious Tool Use:答对了,也可能学错了何时调用工具
作者:Yiwei Yang;Haoxiang Zhang;Bingbing Wen;Yao Lu;Yuchen Wu;Lei Zhang;Julian McAuley;Pan Lu;Bill Howe。 机构:University of Washington;University of California San Diego;Stanford University(v1 第 1 页)。
任务背景。 一个问答 Agent 可以自己推理,也可以搜索网页或调用 Python。遇到事实问题时,搜索可能有用;遇到算术题时,网页搜索往往没有必要。即使最后答对,系统也可能学到错误的用工具理由:例如训练中要求某种回答格式的题大多要搜索,于是以后只要看见这种格式,它就去搜索。
核心方案。 研究者混合事实问答和数学题,并人为把某种线索附在其中一类题上。例如,让事实题总带有特定输出标签,但数学题没有。训练后,再对同一道数学题分别加上、去掉这段线索,比较搜索调用率。问题内容没有改变,因此额外调用更可能反映学到的线索关联,而不是题目突然需要新工具。
作者进一步交换线索与任务的搭配,检查效果来自语义暗示,还是仅来自数据中的关联。在这些设置里,明显捷径主要出现在 Agent 已经学会使用的搜索工具上;没有学好的 Python 任务没有出现对称结果。为纠正它,作者让一个外部 judge 在每次工具调用时判断该调用是否必要,并给不必要调用增加惩罚,再与最终答题奖励合并训练。必要调用没有额外奖金,避免为了拿分而多用工具。这个 judge 自身也是近似判断,因此不能称作客观的“工具必要性真值”。
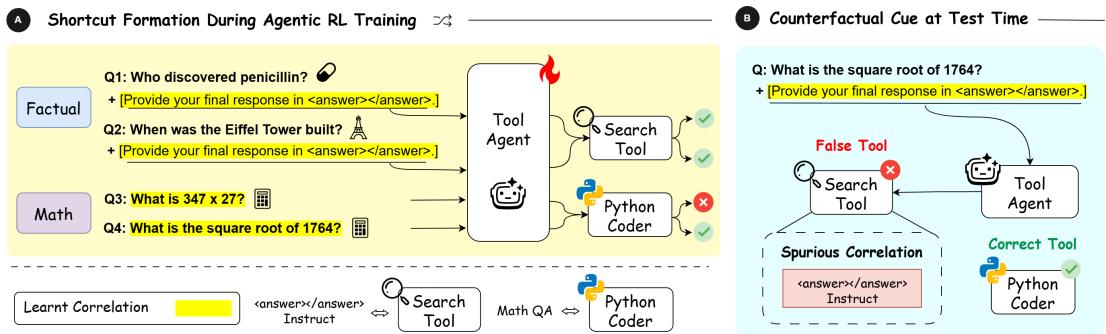 原论文 v1,Figure 1,PDF 第 3 页。
读图。 左侧黄色区域是训练:事实题同时带着黄色格式线索,并经常使用搜索;数学题走另一条路径。下方画出的联系表示模型可能把线索与搜索绑定。到右侧测试时,研究者把同样线索移到数学题上,问题仍适合计算,却诱发了搜索。图是在解释失败形成与测试方式,没有画出后面提出的惩罚训练;该训练来自正文的方法部分。
实际增量与“这不就是……”。 这不就是“学生看见某个题面标记,就套固定解题套路”吗?这里特别指出,捷径可以发生在中间工具选择上,而最终答案仍然正确。因而只看答题准确率,可能看不见策略为什么行动,以及遇到不同提示格式时会怎样变化。
证据与局限。 在一个 GSM8K 反事实条件中,加入搜索语义线索后调用率由 0.9% 增至 40.1%,差值为 39.2 个百分点。这个数字是同题有无线索的差,不是所有部署任务都会增加 39.2%。必要性惩罚在原文设置中明显抑制捷径,但研究规模较小、线索由人设计;“先学会工具才形成捷径”目前是这些实验条件下的观察,不能当作普遍必要条件。judge 的必要性判断也可能随模型能力和工具条件变化。
评测数据集与环境。 Natural Questions、DeepMath-103K 各抽 500 题组成 1,000 题训练集;测试构造同题有/无线索的成对条件,并在未参加训练的 2WikiMultiHopQA、GSM8K 上检查迁移。各测试集实际独立题数原文未清楚披露,保留缺口。指标同时报告答案正确率、工具调用率和线索导致的调用率差;使用 GRPO、搜索与 Python 环境,必要性 judge 为 GPT-5 Nano。
[!abstract]- Abstract 完整中文翻译 大语言模型 Agent 越来越多地交替使用自然语言推理与网页搜索、代码执行等外部工具。这些工具使用策略通常通过强化学习优化,而强化学习可能放大训练数据中的伪相关。本文研究 RL 训练的 Agent 何时、为何会学到工具选择捷径,即依据表面提示线索调用工具,而非依据真实任务需求。 我们构建结合事实问答与数学推理的受控合成环境,在训练中注入与特定工具高度相关、却与工具必要性没有因果关系的线索。在保留线索但不需要相关工具的反事实评测中,Agent 表现出明显捷径行为,伪工具调用率最多增加 39%。不过,捷径并非普遍形成:在我们测试的条件中,只有 Agent 已经学会可靠使用目标工具时才会出现,说明任务能力而不只是数据不平衡,是捷径学习的重要因素。交换线索的分析还表明,线索与工具之间的语义对应会显著放大效果。 为缓解这些问题,我们引入密集的决策级奖励,由 LLM judge 评估每次工具调用是否必要。该必要性奖励有效抑制了由线索驱动的工具使用,同时保持任务表现,为提高 LLM Agent 工具使用策略的鲁棒性提供了实用途径。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16268 v1。首次提交 2026-09-14 19:31:04 UTC,即北京时间 2026-09-15 03:31:04;核对 §1、§3–5、Figure 1、Tables 1–5 及局限;39.2 个百分点来自 Table 1 的 GSM8K [WEB INDEX] 条件。 原论文 v1。
ExecuCritic:让评论者跟着执行结果学习,再决定该信它多少
作者:Junjie Cao;Yingjie He。 机构:Intel Corporation,北京;Peking University,北京(v1 第 1 页)。
任务背景。 假设让代码模型写一个合并有序数组的函数,运行单元测试后只得到“通过”或“失败”。如果同题生成的几个程序都失败,简单的组内奖励很难区分哪个更接近正确。再请一个模型写评论,可以补充线索,却也引出问题:评论说得有道理,怎样知道它值得拿来训练?
核心方案。 编码者先为同一道题生成多个程序,执行器给出通过/失败和错误类型。评论者也给这些程序预测通过概率,并产生简短诊断。两者共享冻结的基础模型,但使用不同 LoRA:评论者学习执行判决、通过程序相对失败程序的排序,以及与执行错误类型一致的诊断;编码者仍根据这些轨迹做策略更新。
编码者是否采用评论分数,取决于该组分数与真实执行结果的排序相关性。相关性高时,标准化评论分数对优势的影响更强;接近零时,它的影响减弱。这里有一个不能省略的细节:原文公式允许负相关,负值会反转这一项,而不是简单地把它关掉。因此,“通过校准门才用”只是概括,真实机制是带符号的连续调节。实际使用时,评论者还会先排候选程序,只执行排名靠前的一部分;都没通过时,再把诊断送回编码者重试。
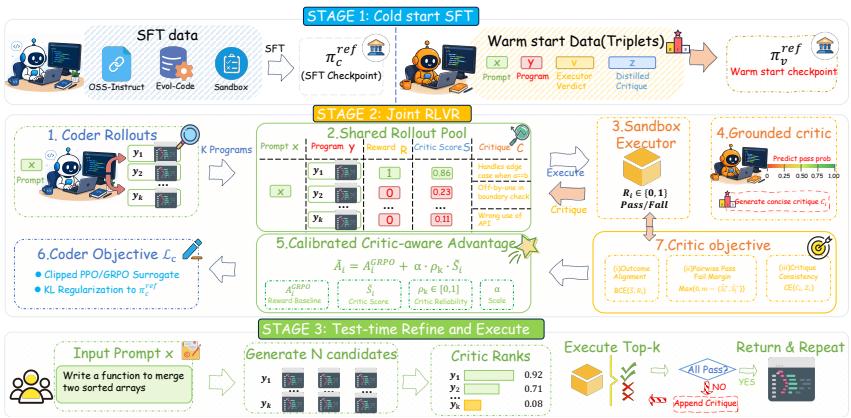 原论文 v1,Figure 1,PDF 第 5 页。
读图。 从顶部的冷启动进入中间联合训练区:左边生成候选,中间保存同一批程序的真实奖励与评论分数,右边用执行结果教评论者。再顺着绿色优势模块向左看,这些分数经过相关性调节后参与编码者更新。最下方另画实际使用:先生成、排序,再只执行前几名,失败才带着诊断返回。两个循环目的不同,不能把测试时少执行几个候选,直接说成训练时完全不需要真实执行。
实际增量与“这不就是……”。 这不就是“把会写评论的人也拿真实测试结果训练,并按它当前是否靠谱来听取意见”吗?增加的是共享当前轨迹的联合学习与相关性调节。它仍然给整条候选程序构造优势,不能据此声称已经准确定位了每一个错误 token 的责任。
证据与局限。 Qwen3-8B 的六项代码评测平均从单编码者 RLVR 的 44.9 提高到 48.3;SWE-bench Lite 从 14.6% 到 18.3%。原文也报告少用执行调用和多种消融。不过,部分基线使用 16 条训练采样,而本文默认 8 条;应分别看 token 预算、执行调用和推理重试,不能笼统称所有预算相同。对于组内执行结果全相同、相关系数如何数值处理,以及生成测试选择集的具体构造,本轮可读方法没有给足复现细节。测试本身遗漏的错误也不能由校准自动消除。
评测数据集与环境。 函数/编程测试为 HumanEval+、MBPP+、LiveCodeBench v5、BigCodeBench-Hard、APPS、CodeContests,报告 pass@1;仓库修复为 SWE-bench Lite、Multi-SWE-bench,前者 300 项,后者 Python/Java 实际子集规模未披露。另用 SWE-bench Verified 的候选 patch 排名视角报告 NDCG@5,并用 ExecuCritic 生成测试选择协议 报 Test-AUC,不能混成修复成功率。默认推理每轮生成 8 个、执行前 3 个、最多 3 轮;其余评测题数和部分版本未披露,卡片中保留缺口。
[!abstract]- Abstract 完整中文翻译 执行反馈对代码模型是一种有用监督,因为单元测试客观且直接衡量程序正确性。其弱点是整段程序经常被压成一个通过/失败位,让使用可验证奖励的强化学习承担困难的信用分配问题。同时,代码系统常有独立的评论者或测试者角色,但这些 critic 通常只靠提示驱动,没有训练成与真实执行结果相一致。 我们提出 ExecuCritic,一个在相同执行轨迹上共同更新编码者与评论者的框架。评论者预测通过/失败并给出简短诊断;编码者只在评论者与当前轨迹组的执行结果一致时利用这一信号。在八项代码 benchmark 和两个近期开放基础模型上,ExecuCritic 优于没有 critic 的 GRPO、靠提示组织的评论者系统和标量奖励模型基线,同时需要更少的策略梯度步骤和沙箱执行。消融与可靠性分析表明,收益来自更好的信用分配,而不是更大的采样预算。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16604 v1。首次提交 2026-09-15 03:58:21 UTC,即北京时间 2026-09-15 11:58:21;核对 §1、§3–4、Equation 2–4、Algorithm 1、Figure 1、Tables 1–4;摘要的“一致时使用”按原文翻译,正文另明确负相关时的公式行为。 原论文 v1。
ScienceIDE:先把科学上的正确写成检查,再让 Agent 从交互中学习
作者:Hejia Geng;Zesen Huang;Haoyang Li;Wenbin Li;Koutian Wu;Zihan Zhou;Yuanbo Pang;Weihao Liu;Zigong Xu;Zhiping Li;Zongzheng Zhang;Chuanfei Dong;Jiankai Sun;Tianzhe Zheng;Fengyu Xie;Yue Ma;Yueheng Shi;Junkai Wang;Tong Xie;Zonglin Di;Xianrong Liu;Qucheng Gao;Yimin Liu;Jiaming Pan;Sheng Huang;Xiao-Han Ma;Lanqing Yuan;Zhenlin Zhu;Ziang Liu;Ziyang Xu;Kangkai Liang;Jiayi Xian;Zehong Zhao;Taigao Ma;Fuming Chang;Yuanzhe Hu;Liuwei Xu;Xianzhe Tang;Jingxu Xie;Peijin Zhang;Qiang Gao;Chengyi Xing;Zhe Zhao;Xi Wang;Leo Wang;Fang Wu;Yaopeng Xing;Xing Meng;Zhenfei Yin;Yingcheng Wu;Ling Yang。 机构:AItonomy Foundation;University of Oxford;UCLA;University of Texas at Austin;Princeton University;UC Berkeley;University of Michigan;Caltech;Boston University;Stanford University;UC San Diego;UNSW Sydney;UC Santa Cruz;Boston College;The Ohio State University;Asia Pacific Center for Theoretical Physics;Washington University in St. Louis;Cornell University;University of Illinois Urbana-Champaign;University at Buffalo;New Jersey Institute of Technology;New York University;UC Irvine;5Y Capital;Georgia Institute of Technology(v1 第 30 页)。
任务背景。 假设让 Agent 修好一个海洋或等离子体模拟程序。它可以读代码、修改实现、编译并运行,但“能运行”并不等于“科学上正确”:一个数值更新步骤写错,程序仍可能输出看起来平滑的曲线。要让 Agent 从这类任务中学习,首先得有能区别有效修复和表面修复的反馈。
核心方案。 先从固定版本的科学代码库中选出职责清楚的模块,由专家确定应当观察什么量、哪些实现差异仍算正确,再把这些判断做成可执行检查。对于随机或数值敏感的模拟,不能简单要求逐点完全相等,需要选择有意义的误差范围、统计量或守恒量。这里的标准在生成下游任务前先固定,并且保留专家校准。
在这个基础上,任务工厂提出缺陷修复、缺失实现等候选。候选不能仅因“看起来像一道题”就加入训练:需要验证原始缺陷确实让检查失败,存在能通过的参考解,而且失败来自目标修改而不是环境装坏。Agent 执行这些任务后,轨迹可以变成模仿学习示范,数值检查也可以直接提供强化学习奖励。现有任务主要来自修复与实现,论文列出的七种任务类型并不表示七种都已充分覆盖。
强化学习部分还处理了一个很实际的问题:长任务可能因预算耗尽被截断,并非修复已经被证伪。如果把这些长轨迹一律当失败来压低概率,模型可能学会草率缩短操作。作者让截断样本的回报仍参与同题组的奖励均值,但把这些样本的 token 从策略损失中移除;完成的轨迹也只有高于组均值才得到正优势。这样明确区分了“还没做完”和“做完后验证失败”。
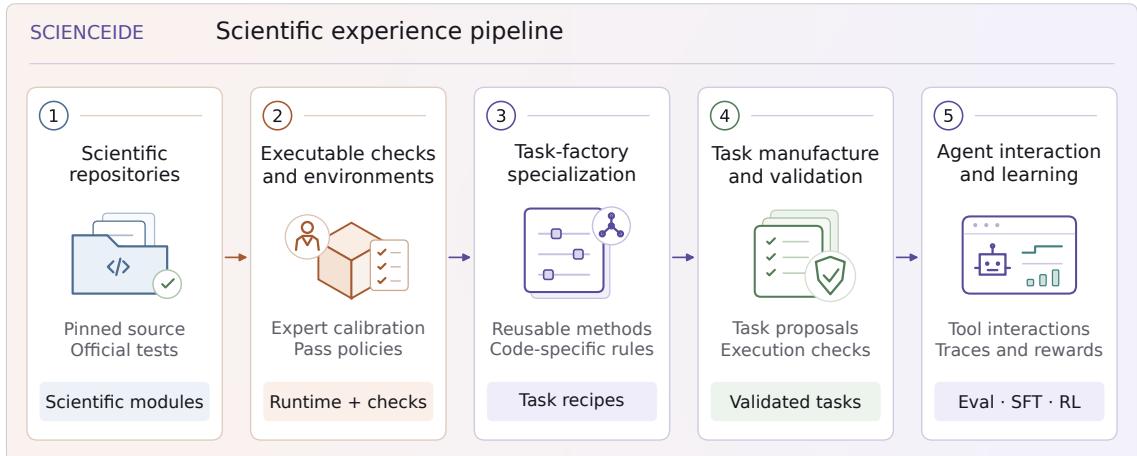 原论文 v1,Figure 2,PDF 第 4 页。
读图。 从左往右看,第一步固定代码与原有测试;第二步把专家认可的科学检查和运行环境打包;第三步将通用出题过程适配到这个环境;第四步再执行验证,筛掉没有意义或无法可靠判分的候选。只有通过这道检查的任务才流向最右侧,产生评测、SFT 或 RL 所需的交互材料。原图是经验供给链,不是已经完成的自主闭环;关于预算截断的处理来自正文 RL 实验,图中并未单独画出。
实际增量与“这不就是……”。 这不就是“把真实科学软件做成带验收标准的练习环境”吗?真正困难的是先把科学正确性变成可信的检查,再证明生成的任务可解、缺陷可观测。仅把仓库装进容器,或者只检查程序退出码,都不足以形成这些学习信号。
证据与局限。 论文既展示科学任务评测,也实际做了 SFT 与 RL。在有定位提示、且仍属于训练环境的留出任务上,RL 第 30 步的平均 verifier reward 在 LAPS 的 14 项上由 0.357 升至 0.857,在 MITgcm 的实际 21 项上由 0.286 升至 0.571;这是带部分分的平均奖励,不是成功率。SFT 的公共评测只在部分配置上提高,Python 修复的独立确认还出现下降。任务 id 不重复,也不能排除相关变体共享代码路径;RL 没有给出跨随机种子方差。因此,目前支持的是已有环境内学习和选定公共任务的迁移,尚未证明未见科学代码库泛化或开放式科学发现。
评测数据集与环境。 ScienceIDE-Hard 有 85 项、18 个环境、5 个代码库,单次预算 1 小时,按严格科学成功判定;它不同于总计 2,812 项的经验池。ScienceIDE 学习与科学代码修复协议 记录 SFT 的 564 个训练任务/81 个验证任务,以及 RL 的 LAPS 85/14、MITgcm 原始 64/23 划分;后者实际验证日志只有 21 项,本页使用真实记录而非自行补齐。
SFT 公共测试涉及 HumanEvalFix、QuixBugs、CodeXGLUE Defect Detection、CodeXGLUE Code Refinement、APPS、LiveCodeBench Execution、HumanEval、BIG-bench Hard、GSM8K、MMLU-Pro、ARC-Easy。首次筛查每配置 20–128 项;独立确认包括 CodeXGLUE defect 2,604 项、refinement 5,707 项,BBH 两个子任务各 125 项,以及 HumanEvalFix Python 36 项。计分混合分类准确率、答案匹配和程序测试,不能平均成一个通用能力分。正文说共筛查 33 个配置并另扩展 21 个,但本轮 PDF 未提供足够逐项身份与规模来完整登记所有配置;以上仅列可核实项,这一缺口保留为待核实。
[!abstract]- Abstract 完整中文翻译 科学代码仓库以可执行的模型、方法和工具保存了数十年的人类知识。但碎片化工具链、隐含的领域约定和专门的正确性标准,使这些知识难以转化为可靠的学习经验;我们称之为科学经验瓶颈。我们提出 ScienceIDE,用于把世界上的科学代码转化为科学 Agent 的可编程环境。在专家定义的科学案例与验收标准指导下,Agent 将仓库改造成支持任务生成、执行和科学验证的可执行环境。这些环境为监督微调、强化学习和评测提供共同基础。 利用经过验证的交互轨迹,我们训练了 PhAI-IDE-72B、PhAI-IDE-9B 和 PhAI-IDE-4B。该模型系列在留出的科学代码修复任务,以及选定的代码、推理和知识类通用 benchmark 上取得提升,提供了科学经验可以正向迁移到更广泛能力的证据。ScienceIDE 为连接 Agent 学习与科学实践的集成工作空间奠定基础,使人类科学软件成为发展科学智能的共享基础。代码:https://github.com/aitofound/ScienceIDE。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.19134 v1。首次提交 2026-09-16 17:55:47 UTC,即北京时间 2026-09-17 01:55:47;核对 §1–3、§5、Figure 2、Figure 12、Appendix S1、S5.1–S5.2 和 Table S3;作者顺序按此次 v1 PDF 首页保留,机构取 PDF 第 30 页,元数据列表与 PDF 署名有差异时不混拼。 原论文 v1。