ScienceBuddy:先改执行方法,再让模型在新方法下学习
作者:Shuhan Xue、Jianyuan Zhong、Ziyuan Nan、Wenbin Li、Zhaochen Yu、Jinchao Ding、Qiang Gao、Pengyu Zhan、Yuntong Zhang、Tian Cheng、Zhenfei Yin、Yingcheng Wu、Ling Yang。 机构:PhAI Labs;复旦大学中山医院肝癌研究所/肝胆外科及移植、复杂表型遗传调控全国重点实验室、复旦大学;Shanghai Academy of Natural Sciences;Shunwei Capital;University of Oxford;Stanford University;Princeton University。按 v1 首页署名与 p.29 Organizations 汇总。
任务背景。 假设研究者把一份基因分析材料交给 Agent,请它查找证据并判断哪些候选值得关注。Agent 可以读取材料、查询数据库、执行 Python,再提交答案及支撑材料;研究者还可以追问依据或纠正需求。论文的受控实验把这类工作落实为文献问答、数据库判断、实验流程排错、基因与变异评估等任务,按各题固定的标准检查答案。
难点在于,一次被提醒后改对答案,并不意味着下次会做得更好。系统可能需要先学会“查哪份表、怎样核对字段”,也可能是模型本身还不擅长理解证据。ScienceBuddy 把这两类问题接在一起处理:先改模型周围的工作方法,再让模型在改好的工作方法下训练。
核心方案。 沿着上面的例子,系统先把研究者的请求、后续反馈和实际工具记录整理成可重复执行的任务及验收标准。此时要分清两种用途:历史记录帮助发现工作方法的缺陷、定义以后练什么;模型真正训练时,则要重新生成当前模型的执行轨迹,不能把旧对话直接当成当前策略采出的数据。
接下来先固定任务模型,让另一个参数固定的辅助模型查看执行证据,提出指令、技能或允许的上下文设置修改。这些工作方法统称为 Harness。候选必须满足修改范围,并在相同验证任务、种子和执行预算下比原版本更好,才被保留下来;否则继续用原版本。保留下来的 Harness 执行新任务,产生下一次修订可用的记录。论文中单独考察 Harness 的案例只开放指令和技能文本修改,执行循环等设置仍固定。
当这一阶段结束,系统固定选出的 Harness,让任务模型重新做题,以固定评分标准给出的结果训练模型。这里使用 GRPO:比较同一道题多次尝试的回报,增加较好尝试的概率、抑制较差尝试。训练结束后,模型权重与已选 Harness 一起交给下一轮;由于模型能力变了,下一轮需要重新判断原有工作方法还是否合适。模型与 Harness 都被继承,但验收标准、工具基础设施和辅助改进模型没有因此获得任意改写权限。
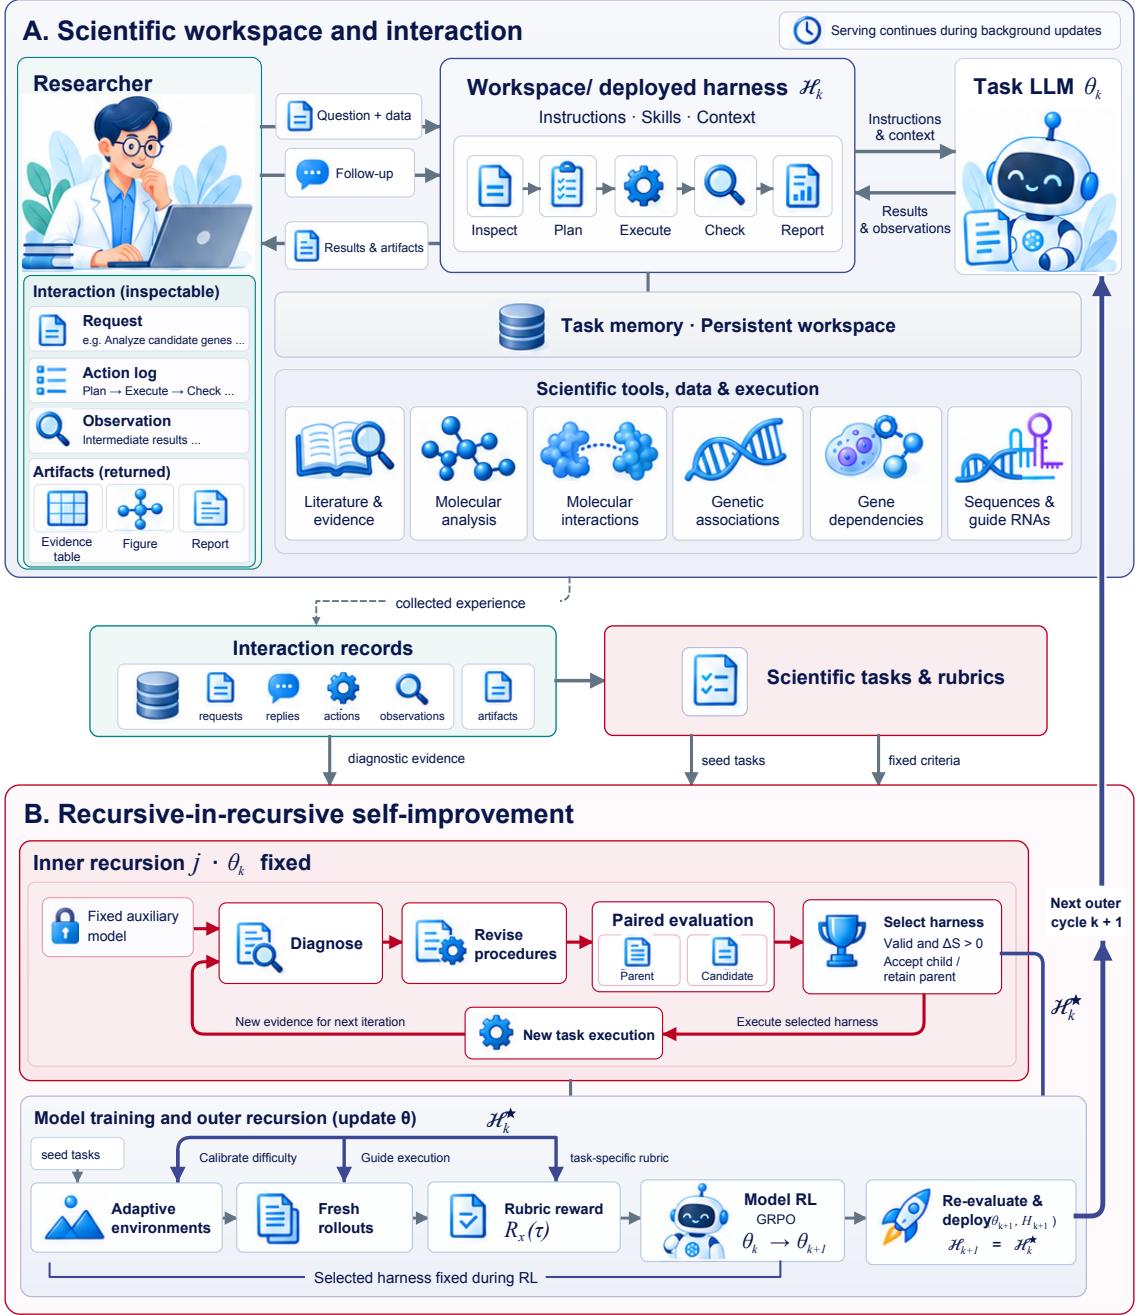
图源:机构版技术报告 v1,Figure 2,PDF p.2,MinerU 抽取原图;已与 arXiv v1 的对应方法说明核对。
读图。 从左上角研究者送入的问题和材料开始,顺着箭头看:中间的工作框架安排检查、计划、执行和报告,右边的任务模型负责产生回答与操作决定。往下进入“Interaction records”,你看到的是这次工作留下的请求、回复、操作、观察和产物;它们一方面变成诊断依据,另一方面形成可练习的任务和固定验收标准。
真正的两层循环在下半部分。先看红色框:辅助模型诊断并修改程序,与原版本配对比较;接受后再去执行新任务,把新证据带回左侧。再往下看蓝色路径:选好的 Harness 固定下来,模型产生新轨迹、取得奖励并更新参数,最右侧的长箭头把更新后的模型送回下一轮。图里的自适应环境和在线后台更新属于完整方案;不能仅凭这些箭头就认为长期部署中的所有环节都已经得到实验验证。
这不就是先改操作说明,再让模型按新说明练习吗? 大体可以这样理解,新增的一步是把两者串成会继承结果的循环:新的工作方法改变训练经验,模型学过以后又改变下一轮应该怎样写工作方法。难点在于维持可靠反馈和独立验收,否则两个组件可能只是共同适应同一批验证题。
贡献与证据。 v1 的三轮案例每轮进行 10 次 Harness 搜索、20 次 RL 更新,最终系统的首次作答测试准确率从 42.2% 升至 73.3%。这支持“有限轮次的共同更新可以提高该组科学任务表现”;它没有给出相同总搜索、辅助模型调用和训练成本下,对单独优化一种组件的完整因果对照。第二轮 Harness 的起始验证分数也低于上一轮结束值,说明更新模型后仍需重新验证适配,不能把整个过程理解成单调上升。
另两个独立案例分别报告固定模型时首次作答准确率从 31.1% 到 51.1%,以及固定初始 Harness 时 pass@4 从 48.3% 到 67.8%。后一个指标是“四次至少答对一次”,与首次作答准确率不同。受控实验的模拟反馈由参考答案辅助产生,不能等同于真实研究者长期协作的证据。当前官方代码的 3 步 Harness/30 次 RL 配置也不同于 v1 的 10/20,这里没有混用两套结果。
评测数据集与环境。 ScienceBuddy 科学任务评测集:v1 从 LAB-Bench、Biomni-Eval1 组织 LitQA2、DbQA、ProtocolQA、GWAS 四族,共 895 个清单任务;三循环用验证准确率选 Harness、用独立测试的首次作答准确率报告效果,另有固定 Harness 的 pass@4 案例。895 不是各实验测试题数;所核对 v1 没有清楚列出三循环各划分规模,不用当前代码的 715/90/90 倒填。依据 §4.2–4.4、Appendix S1.1–S1.3。
[!abstract]- Abstract 完整中文翻译 我们介绍并发布 ScienceBuddy:一个交互式科学研究工作空间,将能够持续改进的科学 Agent 带入研究者的日常工作。ScienceBuddy 协助研究者完成科学任务,同时把他们的请求、反馈和执行证据转化为持续学习所需的任务与评价准则。其核心是“递归中的递归”自我改进,这一范式把 Harness 演化与模型强化学习连接起来:内层递归在模型固定时改进 Harness,外层递归则让模型在改进后的 Harness 下训练。Harness 演化塑造训练经验,而模型学习又为 Harness 适应创造新的机会。我们展示了研究者交互、Harness 修订和模型学习的案例,其中基准案例覆盖四类科学任务。通过将 ScienceBuddy 作为研究产品发布,我们把这一范式提供给科学界,并向“发现智能”迈出一步:科学 AI 通过与研究者的持续合作向前发展,并随着它所支持的研究共同演进。项目网站:http://science-buddy.io。
[!info]- 来源、版本与阅读依据 预印本/机构技术报告;arXiv:2609.17523 v1。首次提交为 2026-09-15 17:55:28 UTC,即北京时间 2026-09-16 01:55:28;机构页面署 2026-09-16,未给时区。发现于 2026-09-17 本轮 OAI 与官方项目页补查。已核对 Introduction、§2、§4.2–4.4、Appendix S1.1–S1.3、机构列表;方案 Figure 2,关键结果 Figure 8–10。v1 §4.2 的标题写 Two-Cycle,但正文、图注和步骤明确写三轮,本条按实际实验说明保留。原文:arXiv v1、机构发布、当前实现说明,访问 2026-09-17。
When Agents Slow Down:继续跑下去,是否还值得这笔预算
作者:Kaiyuan Liu、Qiuyang Mang、Bo Peng、Wenhao Chai、Hanchen Li、Shreyas Pimpalgaonkar、Luke Zettlemoyer、Alex Dimakis、Alvin Cheung。 机构:UC Berkeley;University of Washington;Princeton University;Bespoke Labs(v1 首页)。
任务背景。 假设让 Agent 写一个装箱程序,把一批不同形状的小块尽量紧凑地放进大框。它可以不断修改程序、运行评测并查看分数;每次都可能比上次好一点,没有一个简单的“答对就结束”。研究者真正想知道的是:继续给同一次会话投入 token,还能得到多少进步,何时应该另开一次独立尝试?
核心方案。 论文先把每次中间提交的分数和截至当时的累计 token 记下来,再追踪每个预算点之前找到的最好方案。为了把不同任务放到一起分析,它不直接平均装箱分数、程序速度等不同量纲,而是在同一道任务内比较“谁的最好方案更好”,再用成对胜负拟合 Elo。跨系统比较要使用共同拟合的 joint-Elo;单个系统独立拟合的 self-Elo 只适合看它自己的曲线形状,绝对分值不能拿来给不同系统排名。
接着给曲线加一条外部参照:如果每次尝试相互独立、成本相同,而且得分来自连续分布,那么预算每增加十倍,独立抽样并保留最好结果对应增加 400 Elo。Agent 初期可能比这条线增长得快,随后却慢下来。论文据此估计继续延长会话失去边际优势的位置,再把总预算分给若干较短的独立会话,最后取最好方案。这个分配规则依赖测得的曲线与假设,不是所有 Agent 都适用的固定“跑多少 token”阈值。
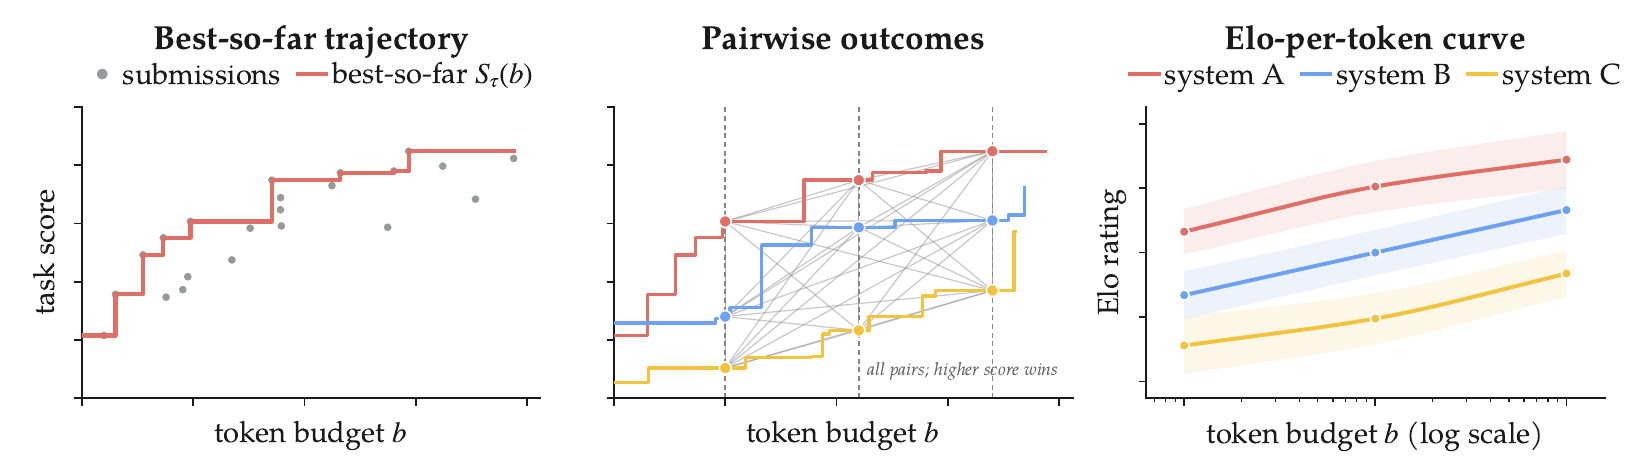
图源:v1 Figure 2,PDF p.5。MinerU 未独立识别这张矢量流程示意图,已从原 PDF 渲染提取。
读图。 从左边灰点开始,每个点是一份提交;红色阶梯只记住截至该预算的最佳成绩,所以它天然不会下降。中间把不同会话、系统和预算点的最好成绩配对,得到谁胜谁负;右边才是由这些比较拟合的 Elo 曲线。正文另外作了一个重要处理:计算 self-Elo 时,删除同一次会话不同时间点的互比,否则“历史最好成绩不会下降”这一数学事实就会制造虚假的增长证据。
这不就是看搜索的边际收益,再决定是否重开吗? 是,但增加了一个跨任务可比较的测量方法,以及独立采样的理论参照。它让“分数仍在涨”和“越来越会利用反馈”成为两个不同的问题。
贡献与证据。 主实验覆盖 4 套 Agent、4 个基准中的 14 个问题,每个组合 5 个独立会话。另在同一装箱任务上考察 GEPA、AdaEvolve 和会更新参数的 TTT-Discover;这些受控设置也没有维持持续加速。100M 总 token 的装箱实验中,三会话分配比单会话高 264 joint-Elo,比十会话高 355;这是六种候选分配中的最好结果。
边界同样关键:第二个 MoE 负载均衡任务里,一、二、三会话之间的差别在附录置信区间下无法区分,因此不能写成“分成三份普遍最好”。独立采样参照依赖独立同分布、等成本等条件;论文关于陷入早期搜索方向的解释是一种假说,不是所有停滞的已证实原因。人类比较主要使用比赛时间,Agent 使用 token,除特定同时间轴案例外不能据此比较绝对效率;也没有验证新策略迁移到未见任务。
评测数据集与环境。 FrontierCS 4 题、ALE-Bench 3 个竞赛任务、MLS-Bench 2 题、FlashInfer-Bench 5 个 kernel,共 14 个主实验问题;另有 FrontierCS 多格骨牌装箱和 MLS-Bench MoE 负载均衡分配实验。指标为任务原始分数、best-so-far 与 Elo,5 次会话是重复运行。§4.1、Appendix C.1/E 明确子集与预算;没有固定原始基准版本号。
[!abstract]- Abstract 完整中文翻译 大语言模型 Agent 在修改解法、使用工具、探索替代方案和决定何时停止时,会自适应地分配测试时计算。这种测试时策略使 Agent 表现如何随计算增长变得难以衡量。我们研究能为中间提交提供连续分数的开放式任务,使长轨迹中的进展可被观察。我们提出 Elo-per-token 分析:追踪每个 token 预算下找到的最好方案,并用 Bradley–Terry 模型把不同评分尺度的任务内排序汇总为 Elo。我们将其应用于四套通用 Agent、四个开放式基准,单次会话最长达到 100M token;同时对三种反馈驱动的 LLM 优化框架进行受控单任务干预。独立采样提供了一个具有理论刻画的参照,其 Elo 随计算量的对数线性增长。相对此参照,Agent 起初可以更快地把 token 转化为 Elo,但边际收益会递减,最终低于参照。相比之下,在共同的 AtCoder 启发式竞赛任务上,历史最强人类参赛者随比赛时间呈超线性进步,提供了持续学习以及 Agent 减速后仍有较大进步空间的证据。我们把边际 Elo 收益与独立采样参照相等的单会话预算定义为扩展拐点。以此确定单会话预算,在 FrontierCS 多格骨牌装箱中把 100M token 分配给并行会话,相对一个长会话提高 264 Elo,相对十个短会话提高 355 Elo。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15309 v1。首次提交 2026-09-14 09:57:49 UTC,即北京时间 2026-09-14 17:57:49;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§3–7、Appendix C.1、D、E;Figure 2 是方法构造,Figure 8 是分配实验,附录 E 保留第二任务统计不确定性。 原文:v1 PDF。
LifeMem:把具体操作与可迁移的经验分开保存
作者:Yuli Qiu、Yutong Li、Wei Su、Zeming Liu、Wanxiang Che、Heyan Huang、Haifeng Wang、Yuhang Guo。 机构:北京理工大学计算机学院;北京航空航天大学计算机学院;哈尔滨工业大学社会计算与交互机器人研究中心;Baidu Inc.(v1 首页)。
任务背景。 假设 Agent 先处理网店退货,后来又处理机票取消。两件事都需要先核对用户和订单,再判断能否执行,但具体 API、字段和允许的操作不同。任务完成与否由各环境的反馈判断。把网店的整段操作原样拿去做机票任务,可能在最关键的调用上出错;只留一句“先检查状态”,又可能不够具体。
核心方案。 LifeMem 先把历史轨迹按“完成事情的步骤结构”分组,而不只按文字主题相近分组。新轨迹到来时,先找相关旧轨迹,再判断它能否归入对应流程;能归入就更新这一组的描述,不能则新建组。如果某组既积累了足够多的轨迹,内部行为又开始分散,就把它拆细,避免“售后处理”最终塞进互相冲突的操作经验。
每组随后提炼一份不绑定具体环境的文字技能,例如先核验用户身份和当前订单状态。实际做新任务时,系统同时取两层材料:同一环境里的具体轨迹,帮助模型正确使用当地的操作接口;这些轨迹所属组的抽象技能,提供跨环境共享的处理原则。保留下来的是轨迹分组、描述和技能,任务模型的参数没有随这个过程更新。
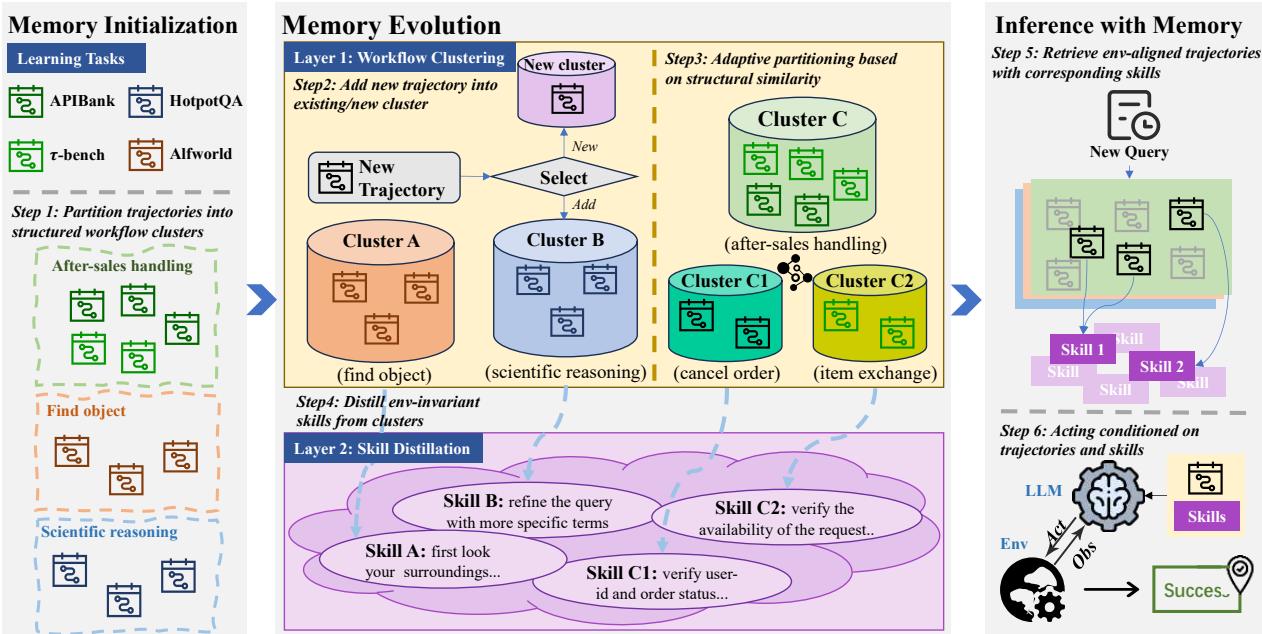
图源:v1 Figure 2,PDF p.4,MinerU 抽取。
读图。 从左侧不同环境的轨迹进入中间看:新轨迹先选择已有组或创建新组;右上的一个售后组再被拆成取消订单与换货两组。下方紫色区域把这些操作记录概括成技能。最后看最右边:新问题既取到与当前环境匹配的示范,也取到关联技能,再一起指导下一步动作。这里的“演化”主要发生在记忆内容与分组结构,图里没有主模型训练循环。
这不就是把操作案例归档,再配一份通用办事原则吗? 可以这样理解,新增的是按流程而非只按语义组织案例,并让分组随经验的数量与差异调整。具体案例防止操作脱离环境,抽象技能才负责迁移;两层不能互相替代。
贡献与证据。 论文在十种环境的训练材料流上比较记忆方法,使用三个固定模型。以 GPT-4o-mini 为例,只有环境匹配轨迹时总体指标为 42.84,加上技能后为 44.13,说明主要收益并不能全部归给抽象技能。任务流随机打乱后,同一模型结果降至 39.63,也表明有利的任务顺序会影响结论。FEVER 与跨业务环境的迁移实验提供了进一步证据,但主表并非每个任务族都领先,数据分析与网页任务也存在不如其他方法的情况。
总训练材料 12,489、主测试实例 1,230,另新生成 2,310 条交互轨迹,其中 1,541 条成功;这些是不同计数单位。正文 Table 1 将 tau 条目标作 airline,而迁移段落又写从 retail 到 airline,本条保留这一口径疑点,不替作者统一。轨迹入库、聚类和技能提炼的额外模型成本也应计入系统比较。
评测数据集与环境。 ALFWorld、ScienceWorld、API-Bank、tau-bench、HotpotQA、WebShop、LifelongAgentBench、ToolQA-coffee、MiniWoB++、Mind2Web 构成十环境材料流;主实验测试量依次为 134、139、262、115、100、100、—、80、48、252,LAB 没有单列主测试。另以 FEVER 和 tau-airline 检查迁移。指标为总体表现及归一化后向迁移;上述均为本文子集,来源 Table 1–5、§5–6。
[!abstract]- Abstract 完整中文翻译 大语言模型 Agent 应当能够在其生命周期内复用过去的经验,持续适应新任务与新环境。然而,现有基于记忆的 Agent 难以跨环境迁移可复用经验,并且随着经验积累会出现灾难性遗忘。为应对这些问题,我们提出 LifeMem,一个使 Agent 能够在多个环境之间迁移知识的终身学习框架。学习时,LifeMem 根据底层工作流程对累积的交互轨迹进行聚类,提取可复用技能;推理时解决新任务,Agent 会召回相关技能和轨迹来指导行动。我们在十个环境、超过 13,000 个任务及约 2,000 条新标注交互轨迹上开展实验。结果表明,LifeMem 能够在终身学习中有效复用经验,减少对已学任务的遗忘,并实现更好的跨任务迁移。进一步分析显示,任务流的顺序影响学习,而在记忆中合并结构相似的轨迹可以提高表现。数据集与代码见 https://github.com/BITHLP/LifeMem。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.12655 v1。首次提交 2026-09-11 10:00:43 UTC,即北京时间 2026-09-11 18:00:43;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§4–6、Table 1–5、Figure 2;本条按 v1 首页写末位作者 Yuhang Guo,OAI 作者字符串的拼写与首页存在差异,署名以原文为准。 原文:v1 PDF。
VG-OPD:老师先证明这一点更可靠,再指导局部 token
- Who Teaches Which Token? Verifier-Gated Multi-Expert On-Policy Distillation for Scientific Reasoning
作者:Xun Xu、Zaixi Zhang。 机构:Fudan University;Hong Kong University of Science and Technology(v1 首页)。
任务背景。 让学生模型回答一道科学题,可能既要算对数量,也要解释机制、判断证据。假设一个化学专家算得比学生准,却把反应机制讲错了;把它整篇回答都当标准,学生就会连错误一起学。论文研究的任务是:学生先独立作答,再决定由哪位专家帮助它纠正哪些部分。
核心方案。 学生先对同一道题生成多次回答,评分器逐条检查每个答案满足了哪些要求。对于没有满足的要求,再让对应能力的专家独立回答原题;只有专家在该项检查中确实比学生更好,才允许它参与监督。例如专家只在计算项上有优势,就不能因为“总体很强”而自动取得整篇答案的指导权。没有合格专家时,这次就不加教师信号。
取得准入后,专家再查看学生实际写出的轨迹,找出自己认为概率较低的 token,并扩展到相邻位置。多个专家的范围重叠时,每个 token 最终只接受一位专家的监督,强度由相关评分项的重要性决定。这些局部信号与原有 GRPO 的任务回报一起更新学生;模型参数是最终保留的变化,下一批轨迹仍由更新后的学生重新生成。
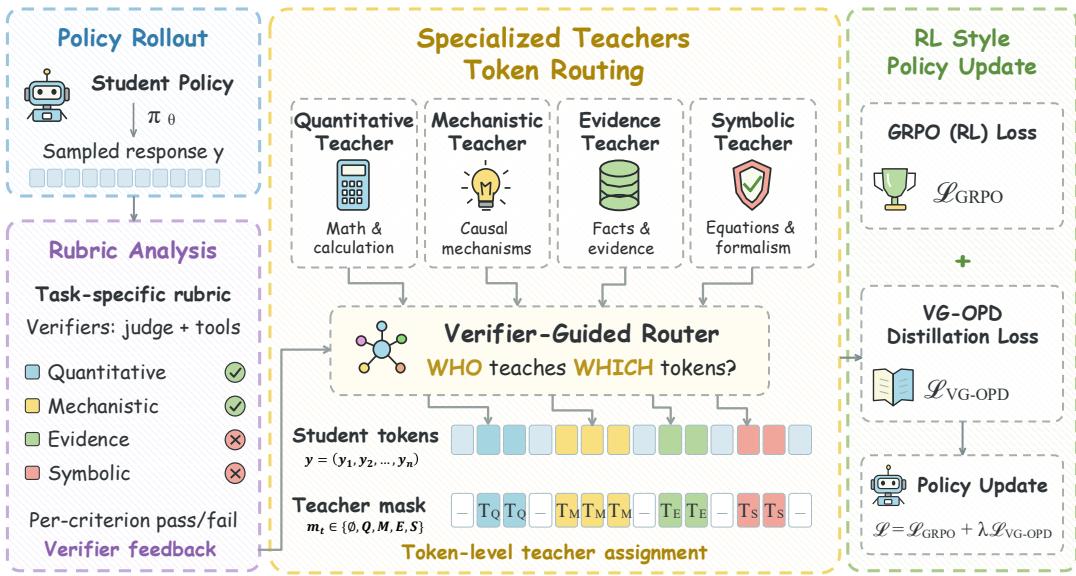
图源:v1 Figure 2,PDF p.4,MinerU 抽取。
读图。 从左上角学生生成的回答往下看,先经过按要求拆分的评分,而不是立即交给所有老师。中间把通过核验的老师与学生 token 对上,颜色表示教师归属,空白表示没有附加蒸馏信号;右侧才把这些局部信号与任务奖励合起来训练。图里的路由是概念示意,实际准入按正文中的逐项核查决定;低概率位置只是分歧定位,并不证明那个 token 本身就是错误原因。
这不就是让擅长某一部分的老师只改那一部分吗? 新增的关键是先用同一项验收标准检查老师是否真的有优势,再限制监督范围。它没有直接取得每个 token 的真实因果贡献,仍然借助“逐项答案核验+概率分歧”来近似定位。
贡献与证据。 论文在固定数据、训练步数、教师池和蒸馏系数下做分配消融:把同样覆盖量的监督随机放到其他 token,下降幅度大于若干整段监督方案。这支持“指导位置有用”,而不只是“增加了教师计算”。4B 学生的科学推理组平均从 rubric-GRPO 的 53.0 到 55.0,领域科学从 56.0 到 59.3;通用推理并非每列都超过单独 RL。
这里的教师项只产生非正的局部优势,主要抑制被选中的不合适 token;论文因此保留任务奖励来共同训练,单独堆叠蒸馏可能使分布收缩。验证器会犯错,教师自己的答案更好也不等于其每处 token 判断都可靠;多专家试答、前向评分和 rubric judge 的成本必须另外计入。
评测数据集与环境。 GPQA-Diamond 198、RaR-Science 正文称 500、SciBench 580、ChemBench 1,391、RaR-Med 150、MMLU-Pro 固定 2,000 题、MATH500 500;均为评测用途,统一 greedy、最多 4,096 新 token,报告准确率或 rubric 判定。RaR-Science 的 74 条去污染移除与 500 题的先后口径仍有缺口;依据 Table 1–3、Appendix B.8。
[!abstract]- Abstract 完整中文翻译 多教师在线策略蒸馏正在成为把专家能力整合到单个模型的一种常见方式:先用 RL 训练专家,再让学生在自身生成的轨迹上接受蒸馏。现有流程往往按序列分配监督,即每个问题交给一个领域教师,所有 token 取得相同权重,这隐含假定教师对整份回答都同样有用。我们发现,有用的教师信号在推理轨迹中既稀疏又不均匀,因此提出一个更细的问题:谁应该教哪个 token?VG-OPD 通过验证回答这个问题:专家在某项答案标准上的反事实增益决定它能否教学,它与学生的分歧确定监督位置,标准的重要性决定权重;经过门控的 KL 以附加 token 级优势进入 GRPO。在科学推理中使用 RL 训练的能力专家时,VG-OPD 在 4B 与 8B 学生的七个基准上取得最佳总体表现,两个规模均在五个基准上排名第一,最大收益出现在知识密集的科学推理任务。进一步分析表明,收益来自对经过验证的监督进行局部定位,而不是增加教师或蒸馏损失:把相同监督预算放错位置是破坏最大的一项改动,无差别蒸馏会使 RL 低于其自身基线,而门控蒸馏能带来提升。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15404 v1。首次提交 2026-09-14 11:34:22 UTC,即北京时间 2026-09-14 19:34:22;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§3–4、Algorithm 1、Table 1–3、Appendix B.8;摘要的排名表述保留作者原意,投入判断以主表和受控消融为依据。 原文:v1 PDF。
HISPO:把长回答分成几段,再控制每一段的更新
作者:Quoc-Vinh Lai-Dang、Hyo-Sang Shin。 机构:KAIST,Cho Chun Shik Graduate School of Mobility(v1 首页)。
任务背景。 给模型一道数学题,它写出很长的推导,最后由答案检查器判定对错。训练时通常知道整份答案是否成功,却不知道每一句推理分别贡献了多少。HISPO 关心的是:模型更新后再利用旧轨迹训练,应该逐 token 调整更新幅度,整篇一起调整,还是在两者之间选一个单位?
核心方案。 采样回答时,系统同时记下模型在每个位置有多不确定,也就是 token 分布的熵。先平滑这条曲线,再取相隔足够远的高点作为分界,把一整篇回答切成连续片段。片段边界和权重在这批轨迹后续训练时固定下来,避免边训练边改变比较单位;分界反映不确定性变化,不保证恰好对应人能读出的推理步骤。
得到整份回答的组内相对奖励后,HISPO 把这份信号按片段的不确定性分配权重,再在每段内部按长度分摊。新旧策略对各 token 的概率比不再单独裁剪,而先在片段内取几何平均,再对这个共享比率进行裁剪。于是同段 token 的更新幅度彼此关联,又不必把整篇长回答当成一块。
方案图。 所核对原文用公式和算法说明更新过程,图 1–2 是评测曲线,未见合适的核心方案原图;不把成绩图作为方法图。
这不就是给高不确定片段多一点训练权重吗? 还多了一层:片段同时成为新旧策略概率校正与裁剪的单位。熵权重只是一种分配启发式,整段仍共享最终回报的正负,不能理解成已经识别了真正导致错误的那一步。
贡献与证据。 Qwen3-1.7B-Base 在统一平台与相同训练配置族下比较 GRPO、DAPO、GSPO 和 HISPO,采用 LoRA、32 个问题的 batch。作者报告六个基准的 Pass@8 都高于最强对照,而 Acc@8 在五个基准匹配或超过最强对照;AIME25 相对 GSPO 的 Acc@8 增加 2.50 个百分点。
这些结果来自用同一评测套件监控和选取 checkpoint,不能视作额外独立测试集上的确认。Acc@8 是八次作答正确性的平均,Pass@8 是最佳八次成功率的 bootstrap 估计;较高 Pass@8 也不等于单次作答更可靠。更大模型、完整参数训练及其他任务仍缺验证。
评测数据集与环境。 MATH500、Minerva、AMC23、AIME24、AIME25、OlympiadBench:六套件用于监控/选 checkpoint,随后报告 Acc@8 与 Pass@8;MATH 7,500 题用于训练,不冒充测试。正文未逐一列明所用子集的全部题数和版本,保留缺口;依据 §4、Appendix A.2。
[!abstract]- Abstract 完整中文翻译 具有可验证奖励的强化学习已成为提高语言模型数学推理能力的重要方法,但长回答带来困难的信用分配问题:不同部分对最终正确性的贡献可能不均等。现有策略优化目标通常在 token 级或序列级进行重要性采样校正,GRPO、DAPO 和 GSPO 因而采用不同的分配粒度。我们提出 HISPO,一种片段级策略优化方法:在采样时根据熵构建连续片段,赋予柔性的熵显著性权重,并在片段粒度进行裁剪的重要性采样校正。它提供了介于 token 级 GRPO/DAPO 与序列级 GSPO 之间的校正单位。我们通过在数学推理任务上微调 Qwen3-1.7B-Base 进行评估。在六个基准上,HISPO 的 Pass@8 均高于最强基线,Acc@8 在五个基准上匹配或超过最强基线。在 AIME25 上,相对 GRPO,Acc@8 与 Pass@8 分别提高 3.75、3.78;相对 GSPO 分别提高 2.50、1.27。这些结果表明,片段级校正是长篇数学推理 RLVR 中值得探索的粒度。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15471 v1。首次提交 2026-09-14 12:29:00 UTC,即北京时间 2026-09-14 20:29:00;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§3–4、公式 11–24、评测协议与 Appendix A.2;分段不能等同于真实过程奖励。 原文:v1 PDF。
BPO:利用整条轨迹,避开中间状态价值的估计
作者:Zhuoqing Song、Haotian Xu、Xikun Zhang、Lidong Bing。 机构:Apodex US, Inc.;Princeton University(v1 首页)。
任务背景。 模型做一道数学题,只在最后拿到“答案对或错”的奖励。若训练方法要求知道每个中间推理状态以后能得到多少回报,就得额外估计这些状态价值,而长推理中的估计可能不准。BPO 想保留一种有理论依据的策略更新,同时尽量绕开这些中间估计。
核心方案。 BPO 从策略镜像下降出发:既让策略倾向更高回报,又限制新旧策略的距离。对只有终局奖励的自回归生成,中间状态价值之差沿着整条回答相加时会相互抵消,剩下终局奖励和初始状态价值。因此可以把原本涉及许多中间状态的条件改写为轨迹级目标,而不训练一个逐步评价状态的 critic。
真正落到训练代码时,论文还做了几次近似:线性化目标,用同题多条轨迹的回报估计初始价值并归一化,把全词表 KL 换成“当前 token 与其他 token”两类概率的近似,最后加平滑、遮罩与裁剪。得到的更新仍由整条回答的组内优势决定方向,但幅度多了一个由新旧策略互补概率之比得到的权重。只说“又一种 GRPO 权重”会漏掉推导来源;反过来,把理想目标的等价定理直接安到近似实现上,也不成立。
方案图。 原文的主要图是训练准确率曲线,方法用公式与推导展开;未见适合替代这条推导的方案原图。
这不就是把中间项抵消以后,再做一个可计算的近似更新吗? 是。值得理解的新增部分在于先说明理想目标为什么保持原问题的最优解,再明确哪些近似把它变成不需要 critic 的实际损失。
贡献与证据。 在 Qwen3-30B-A3B-Base 上,论文固定训练材料和其他配置,仅改变策略损失。400 个训练 step 对应 3,200 次优化器更新;每批 256 个问题、每题 16 条轨迹。按最佳 checkpoint 汇报,三个 AIME 的平均正确率为 50.5%,最强基线 CISPO 为 47.4%;在固定最后一步比较时,BPO 为 49.4%,此时最强基线 DPPO 为 45.5%。两个口径不应混写。
最佳 checkpoint 正是按这三个评测集的均分选出,因此最高分比较存在选点影响;实验也只覆盖一个主模型与数学任务。定理针对理想的轨迹目标,实际实现用了近似,不能因此宣称在一般神经网络训练中保证收敛到同一个最优策略。
评测数据集与环境。 AIME24、AIME25、AIME26:每题生成 32 次,以 Avg@32 估计平均单次正确率,三者平均用于 checkpoint 选择;不是 32 次中只要一次成功。DAPO-Math-17k 英文子集是训练数据;正文未单列实际每套题数,按 §4、Table 1 保留协议。
[!abstract]- Abstract 完整中文翻译 具有可验证奖励的强化学习能够改善大语言模型的推理能力。我们提出 Bellman Policy Optimization(BPO),一种从策略镜像下降推导出的无 critic 方法。针对具有终局奖励的自回归生成,BPO 利用 Bellman 方程把策略镜像下降改写为轨迹级目标,从而避免估计中间状态的状态价值。我们证明,该改写与原始策略镜像下降目标具有相同的唯一最优解。通过近似此目标,我们得到实际的 BPO 损失;它的不匹配校正权重是互补 token 概率之比的平滑形式。数学推理基准上的实验验证了 BPO 的有效性。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15987 v1。首次提交 2026-09-14 17:59:47 UTC,即北京时间 2026-09-15 01:59:47;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§2–4、§3.2 的四步近似、Table 1 和固定末步结果;准确区分 ideal objective 与 practical loss。 原文:v1 PDF。
CCL:让学生参与校准老师,再用校准后的老师继续学
作者:Haichen Hu、Yuheng Zhang、David Simchi-Levi。 机构:MIT;UIUC(v1 首页)。
任务背景。 假设有一批能检查答案的源领域题目,以及另一批拿不到正确奖励的目标领域题目。老师在源领域很强,但到了目标领域可能带着系统性偏差;学生如果只模仿它,错误也会一起迁移。本文研究的是:能否只借助源领域的奖励,把目标领域上的学生训练得比直接模仿更合理?
核心方案。 在源题上,固定老师先生成回答。系统选一个 token 位置,保留此前的上下文,同时让当前学生提出另一个 token;这样得到两个在相同前缀下的分支。算法按参考策略选择其中一个并继续生成,用源题的真实奖励及规定的随机接受规则构造校准信号,更新老师外面的校准参数。它不是把学生的意见直接认作正确,也不是每次都把两个分支全部评一遍。
随后用校准后的教师分布在目标题上训练学生。学生更新包含一个投影梯度候选和一个随机候选,借助新的目标题采样比较它们的蒸馏目标,再选择下一轮学生。新的学生又会提出不同的源题 token 替代项,影响后续校准。持续继承的是校准参数和学生参数;原始老师、参考策略及这套更新规则保持固定。
方案图。 原文以 Algorithm 1 和理论推导说明流程,没有独立方案原图。
这不就是先纠正老师,再让学生参与下一轮纠错吗? 更准确地说,学生提供探索用的替代分支,真正的校准依据仍来自源领域奖励。目标题没有奖励,不表示算法完全没有外部正确性信号。
贡献与边界。 论文证明在其模型假设下,学生在固定目标题上的平均 KL 距离,会以多项式速率趋近“学生模型类内、参考策略正则化后的最优学生”。这个参照不是无限能力的最优模型,也不是任意目标分布上的保证。
迁移成立依赖源、目标共享一套最优校准系数,源题的分支比较还能识别所有校准方向,并假定最优学生唯一。若目标错误需要一种源题从未暴露的校准方向,结论不能直接套用。随机参数候选、有限采样选择和理论常数在大型 LLM 中是否可行,作者明确留给未来实验;本次没有把收敛定理当作现成训练收益。
评测数据集与环境。 不适用:本文给出有限自回归策略模型、算法与理论反例,没有使用真实 LLM 数据集开展计算实验;§7 明确把数学和代码任务实证列为未来工作。
[!abstract]- Abstract 完整中文翻译 大语言模型蒸馏旨在把强教师的能力迁移给更小的学生,但直接模仿也可能传递教师的系统性偏差和错误。存在协变量偏移、无法获得目标领域奖励反馈时,这一问题尤其突出。我们提出 CCL,通过 token 级分支把教师校准与学生更新耦合起来,仅使用源题的奖励反馈。每一轮先用源反馈校准教师,再用校准后的教师在目标题上训练学生;更新后的学生又影响后续校准。在自回归策略框架下,我们证明输出学生相对最优参照学生的期望平均 KL 距离,会随迭代次数以多项式速率趋于零。参照学生在给定学生类内最大化真实的、相对参考策略正则化的目标奖励,不必能表示不受限制的最优策略。分析量化了投影学生梯度更新的进展,并控制教师校准误差。我们还证明它与正则化直接匹配存在分离:即使教师取得的正则化目标奖励高于所有学生策略,直接匹配相对参照学生的误差仍可能不趋于零。这表明在没有目标领域奖励反馈的情况下,通过耦合校准与学习,蒸馏可以克服持续教师偏差并恢复最优学生。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.17474 v1。首次提交 2026-09-15 17:15:40 UTC,即北京时间 2026-09-16 01:15:40;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。已核对 Introduction、§3 的假设 3.2–3.4、§4 Algorithm 1、Theorem 5.1、§6 分离构造及 §7 Discussion;正文只解释理论适用边界,未重新证明全部附录。 原文:v1 PDF。
RESKILL:失败以后,先比较可能的原因,再决定怎样改技能
作者:Mengyi Deng、Xin Li、Duyi Pan、Zilin Wang、Zhiwei Li、Zhijiang Guo、Wei Wang。 机构:香港科技大学(广州)Information Hub;香港科技大学(v1 首页)。
任务背景。 图中的 Agent 接到“把杯子冷却,再放到咖啡机上”的要求。它只能根据文字观察寻找物品、拿取、冷却和放置,环境检查目标是否完成。问题是,它可能看到了杯子却没有拿起来,反而冷却了鸡蛋;这时写一句“下次更仔细”很难决定应该修改哪条操作经验。
核心方案。 失败后,模型先根据操作记录提出几种可能原因,并分别指出证据和受影响的技能范围。例如,“认错物品”和“看到杯子却没有拿取”都可能解释失败。系统接着提出若干局部修改,让模型判断每个修改能够处理哪些原因;一个固定的选择规则再比较它们覆盖了多少仍然有效的原因,选出较有针对性的修改,而不是直接接受第一段反思。
选中的内容作为局部说明写入技能文件,然后重新执行刚才失败的任务。成功就结束修复;如果仍失败,系统保留这次修改及重测结果,重新解释失败,让持续出现的原因和新发现的问题进入下一轮权重更新。下一轮因此可以知道哪些路已经试过,避免把每次重试都当成全新的猜测。执行模型的参数始终不变,继承的是技能文本与本次修复过程的状态。
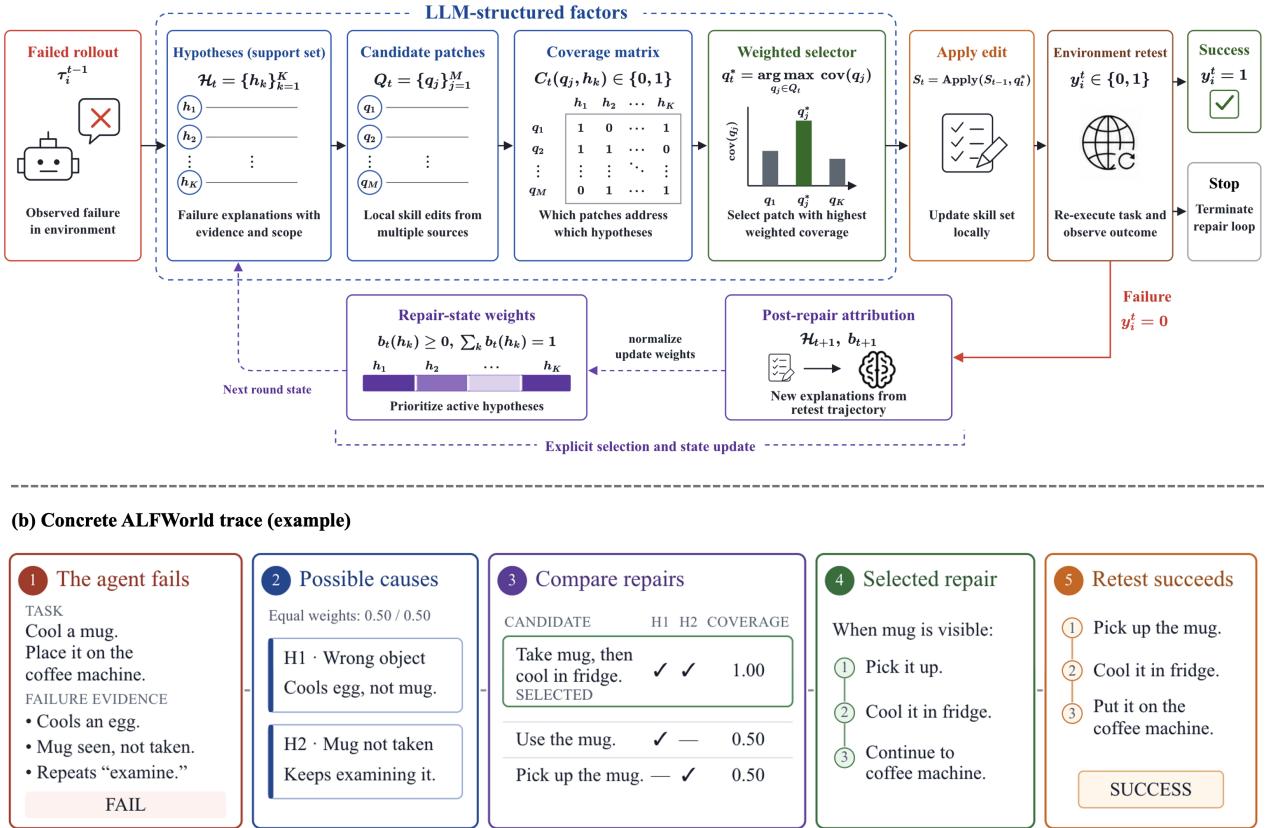
图源:v1 Figure 1,PDF p.3,MinerU 抽取原图。
读图。 从左上角的失败轨迹进入,沿横向主线依次看“可能原因、候选修改、覆盖关系、选择修改”,最后到右侧的环境重测。若成功,箭头直接结束;若失败,红色箭头转到下方,根据新轨迹重新归因,再把更新后的原因权重送回左边。下半图把这条流程落到杯子的例子:完整修订同时解决“拿错对象”和“没有拿取”,比只补一句“使用杯子”更具体。返回箭头表示同一任务的修复循环,图中没有另外画出未见任务的独立验收。
这不就是先列可能原因,再试一个更有把握的补丁吗? 是的,新增之处在于系统明确保存原因与补丁的对应关系,并让失败重测改变下一轮选择。原因仍由模型提出,覆盖分数并不是经过独立证明的因果结论。
贡献与证据。 三种模型、两个环境的六组设置中,最终累计成功率都优于对照;相对直接修复和带假设的修复,平均分别提高 3.7、3.3 个百分点。各模型内部保持失败任务池和修复轮数相同,不过候选生成与评分带来的额外模型调用,不等于已经做过总 token 成本一致的比较。TextCraft 的 4B 设置只取 D1/D2,且上下文、轨迹处理不同,不能据此推断它相对 1.7B/3B 的纯规模收益。
评测数据集与环境。 ALFWorld:274 题,140 seen+134 unseen,最多七轮修复;TextCraft:AgentGym 版本,1.7B/3B 使用完整池,4B 使用 D1/D2,最多四轮,各池题数未明确。两者报告首次与累计成功率,重试次数不计作新增独立样本;依据 §4、Appendix A、Tables 1–4。
[!abstract]- Abstract 完整中文翻译 语言 Agent 越来越依赖可复用技能,但失败后的修复往往通过不透明的一次性反思完成:模型生成技能补丁,却没有明确维护失败解释与候选修复之间的关系,也没有明确记录不成功的重测应怎样影响后续修改。我们提出 RESKILL,一个在多轮修复之间维护明确修复状态的结构化框架。面对失败轨迹,框架把失败假设与候选技能补丁关联起来,通过覆盖关系归因选择局部修复,在环境中重新测试修改后的技能集,并利用重测结果指导后续更新。语言模型提供结构化的修复要素,修复流程负责记录这些要素、按候选补丁处理当前失败解释的能力进行比较,并把失败重测的结果带入后续轮次。我们在固定修复预算下,用三种模型规模在 ALFWorld 和 TextCraft 上评估 RESKILL。它在六种基准与模型组合中都取得最高最终成功率,相比直接修复和以假设为条件的修复,平均最终成功率分别提高 3.7 和 3.3 个百分点。结果表明,明确归因本身并不足够;当归因与修复选择、持续利用重测结果的更新相结合时,才产生能够延续的改进。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15684 v1。首次提交 2026-09-14 14:55:13 UTC,即北京时间 2026-09-14 22:55:13;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对任务定义、§3–4、Appendix A–E;Figure 1 与 Tables 1–5。摘要末句的“能够延续”按作者表述翻译,正文区分其实际重试范围。 原文:v1 PDF。
ThinkFlow:用下一次用户发言,持续调整潜在记忆
作者:Cai Ke、Xin Liu、Han Zhang、Jiangyue Yan、Zike Yuan、Ling Deng、Yue Yu、Hui Wang、Ruifeng Xu。 机构:鹏城实验室;哈尔滨工业大学(深圳);中国联通大湾区创新研究院(v1 首页)。
任务背景。 假设用户先说旅行预算是 200 美元,几天后又改变了目的地和住宿偏好。对话 Agent 需要根据这些分散的历史继续回复,既不能忘记重要限制,也不能把旧偏好当成当前要求。论文研究的是多会话回复生成与个性化问答,评估历史信息能否帮助系统在后续问题中给出更合适的答案。
核心方案。 系统先把对话中的隐藏表示压缩成少量连续向量,作为潜在记忆,而不必先写成一份文字摘要。新信息到来时,一个可训练的门控模块决定怎样把它与旧记忆合并;回答当前问题前,再根据问题调整这些记忆,把它们作为模型能够读取的软提示。这样保存的是可学习表示,不能像文字笔记一样直接逐条审查。
这些模块先通过老师启动:同一底座的老师读取完整历史,学生只读取当前问题和压缩记忆,训练学生尽量接近老师的回答分布。随后移除老师。当用户下一次实际发言到达,系统把它当作监督目标,检查自己根据已有记忆和上一轮回复能否预测这次发言,并据此更新学生的 LoRA 和记忆模块,再服务后续对话。并不是先知道未来发言再回答上一轮;变化被保存在记忆状态和可训练参数里。
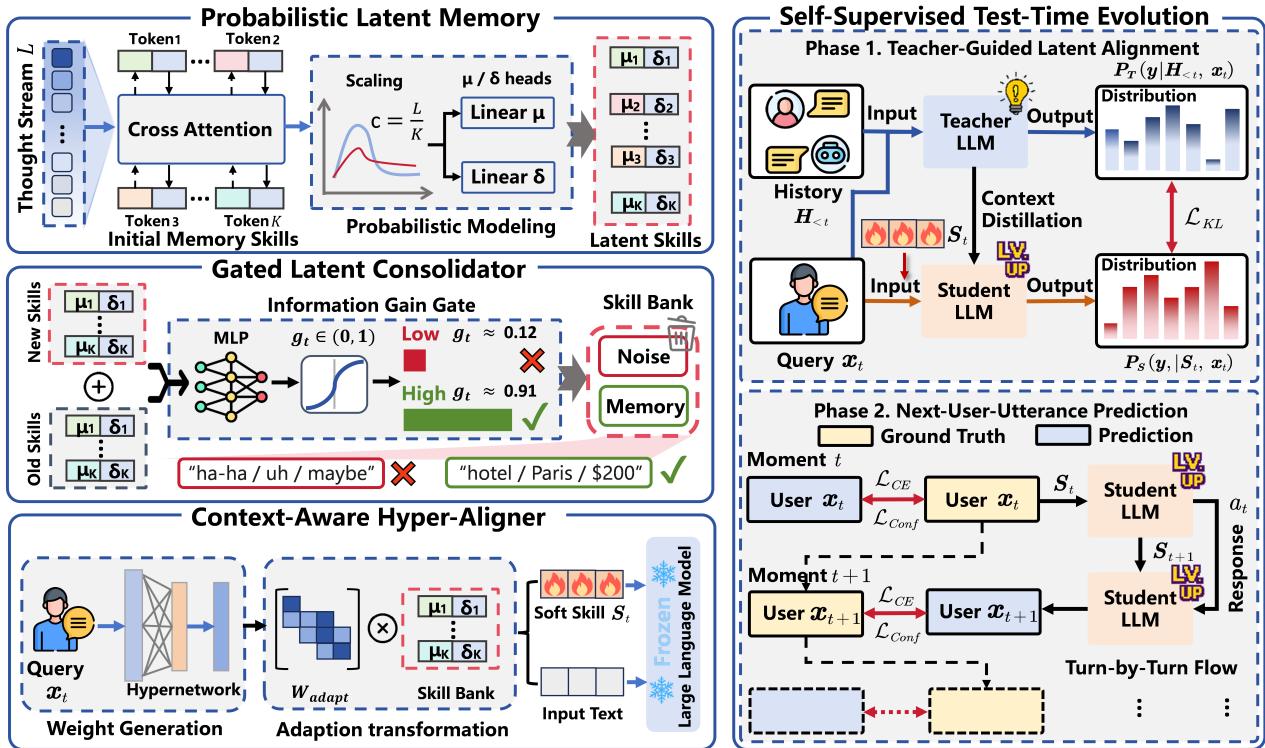
图源:v1 Figure 2,PDF p.4,MinerU 抽取原图。
读图。 先看左上:对话表示被压缩成记忆向量。往左下走,新旧记忆先经过合并,再由当前问题决定怎样送入回答模型。右侧才是这些模块怎样学会工作的两阶段过程:上半部用读过完整历史的老师指导学生;下半部沿时间从上往下,每次等用户新发言出现后,用预测误差继续更新。图左下的“Frozen”指冻结的主干,正文与算法还训练学生 LoRA;也不能把图中的低门值理解成系统有一条可靠规则,能自动拒绝所有错误记忆。
这不就是一份能学习的隐式用户笔记吗? 可以这样入手,额外机制是让这份笔记在对话继续发生时,用预测后续发言的损失不断调整。是否容易预测,与是否应该记住、是否真实,是不同问题。
贡献与证据。 在 Qwen3-8B 的 PersonaMem 1M 档,七类任务均值为 41.94,MemGen 为 38.86,但变化追踪、新想法等单类并非最好;原表给均值标出的“+2.36”也与这两个数直接相减不一致。对话实验的一项消融中,去掉第二阶段后 MAUVE 从 77.20 降至 69.02,支持在线学习组件在该设置中的作用。三份对话语料不能统称真实人类长期交互:CC 原始论文明确用大模型生成,故不沿用本文附录对此的概括。
评测数据集与环境。 MSC、Conversation Chronicles、GapChat 用于多会话生成,报告 BLEU-4、ROUGE-L、BERTScore、MAUVE,语料总规模与本次划分缺口见卡片;PersonaMem 使用 32K/128K/1M 档(589/2,727/2,674 样本),报告七类问答准确率及类别均值。依据 §4、Tables 1–3、Appendix A/C;测试期间会利用后续发言适应。
[!abstract]- Abstract 完整中文翻译 终身对话 Agent 依靠记忆系统与用户保持深入且具有上下文意识的互动。然而,现有显式文字记忆流程存在严重的信息瓶颈,常会丢失细微的行为模式与情绪变化。此外,这些系统通常在部署后保持静态,无法在没有人工反馈的情况下自主适应个人习惯和偏好。作者以认知科学中关于潜在心理模型和预测编码的观点为启发,提出 ThinkFlow,一个面向终身对话 Agent 的端到端潜在记忆框架。ThinkFlow 将对话流动态压缩成概率化的潜在记忆技能,以连续且解耦的向量整合复杂用户状态,从而绕过文字瓶颈;作者称这一过程能够避免语义干扰。为突破适应方面的障碍,框架引入测试时演化:先用老师指导的潜在表示对齐启动初始状态,再利用自监督的下一次用户发言预测持续修正,以解决冷启动并实现无需标签的长期个性化。长期对话基准上的大量实验表明,ThinkFlow 优于现有记忆系统,能够在延续多个会话的交互中提供更个性化、符合上下文的回复。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.17010 v1。首次提交 2026-09-15 11:21:39 UTC,即北京时间 2026-09-15 19:21:39;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 §3–4、Figure 2、Tables 1–6、Algorithm 1 与 Appendix A/C。摘要中“潜在心理模型”等是作者的启发性论述,不作为本文已证明的认知结论。CC 原始发布 用于核对数据来源。 原文:v1 PDF。
γOPD:让早期 token 为后面的推理结果承担一部分责任
作者:Shiqi Liu、Zeyu He、Letian Tao、Guojian Zhan、Jiaxin Gao、Feihong Zhang、Jingliang Duan、Wei Xiong、Kehua Sheng、Bo Zhang、Yang Guan、Shengbo Eben Li。 机构:清华大学车辆与运载学院、人工智能学院;滴滴自动驾驶 Didi Voyager Labs(v1 首页)。
任务背景。 让学生模型写一道数学题的完整解答,老师逐个 token 判断它写得像不像可靠解法,最终答案还可以交给校验器检查。困难在于,开头选错一种解题路线,影响往往到很后面才显现:只看当前 token 的老师反馈,可能无法把后果传回前面的选择。
核心方案。 学生先用当前策略生成整段解答,老师在相同前缀上给出 token 概率。常用的逐 token 蒸馏只用当前位置的概率差指导更新;论文从完整序列目标出发,指出前面的选择还改变了后续前缀,因此也应该考虑后面的老师反馈。可是一口气累加整条长回答,会让更新噪声随长度扩大。
γOPD 为此给未来反馈加上距离折扣:离当前 token 越远,贡献越小。折扣为零就退回局部指导,为一则保留全部未来反馈,实验默认取 0.99。它还把折扣后的蒸馏信号按回答归一化并压进有限区间,再与最终答案的正负奖励相加。这样在论文的二值奖励设置下,老师能够调整更新力度,却不能把校验器判错的轨迹整体翻成正向鼓励。真正保留下来的是更新后的学生参数;下一轮重新从学生采样,老师不随之更新。
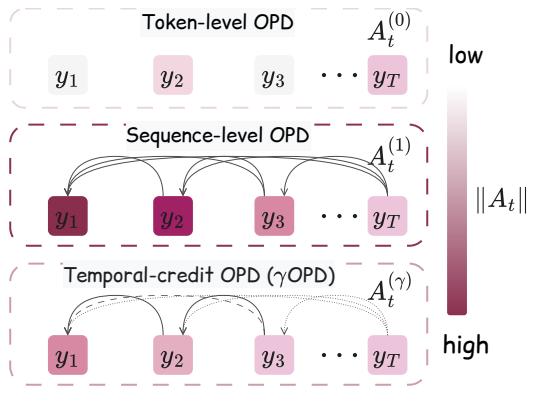
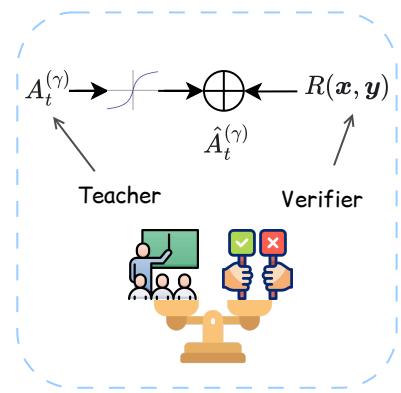
图源:v1 Figure 2a–b,PDF p.4,同一方案图的两个原始分图,MinerU 抽取。
读图。 先看 2a 的三行:第一行每个 token 只取得本地反馈;第二行的弧线把所有后续反馈送回前面;第三行仍有回传,但距离越远权重越弱。这些弧线表示训练时的归因关系,并不是生成答案时向未来偷看。再接到 2b,左侧老师信号先经过压缩,右侧校验器提供最终结果,两路合成用于学生更新的优势值;图中的天平不表示两种信号完全对等,正文的有界变换保留了二值任务奖励的符号。
这不就是把未来的老师评分打折传回来吗? 正是这个直观操作,但它处理的是从序列目标到实际梯度时丢掉的未来影响,并额外限制老师与真实奖励发生冲突时的作用范围。不是换个折扣系数就自动得到无偏且稳定的所有优点。
贡献与证据。 理论在单步信号二阶矩有界等条件下,给出固定折扣小于一时不随序列长度增长的方差上界;这不等于真实训练已获得无条件收敛保证。数学、代码及不同师生规模实验支持方法有效,多老师表中总均值为 66.00,ExOPD 为 64.36,但各单项并非都最高。本文按表格原值比较,不沿用正文与表格不完全相符的“最强基线”增幅表述。论文报告的极小额外算子开销,也不意味着老师本身的推理成本消失。
评测数据集与环境。 AIME24、AIME25、AMC23 每题 32 次采样,MATH500 每题 4 次;HumanEval+、MBPP+ 每题 1 次,LiveCodeBench v6 每题 4 次。分别核验数学答案与代码执行,报告正确率/通过率;训练使用筛选后的 DeepMath 和 Eurus-RL-Code。Plus 数据的固定版本与实际题数未明确,依据 §4、Tables 1–2、Appendix E。
[!abstract]- Abstract 完整中文翻译 在线蒸馏已经成为大语言模型后训练的一种有效方法,但现有目标面临忠实于原目标与优化稳定性之间的取舍。token 级在线蒸馏提供稳定但局部的监督,而序列级在线蒸馏能够捕捉未来贡献,代价是方差依赖于序列长度。我们建立了统一的时间信用分配视角,说明实际使用的 token 级在线蒸馏可以理解为对序列级反向 KL 梯度的一种时间近似。基于这一联系,我们提出 γOPD,通过带折扣的时间信用分配平衡长程监督和优化稳定性,同时给出不依赖序列长度的方差上界。我们进一步为 γOPD 设计与奖励兼容的有界混合机制 RBM,将可验证的结果反馈与带折扣的在线蒸馏优势相结合,使优化不再完全依赖老师。数学和代码推理实验表明,该方法在同规模、规模不匹配及多老师蒸馏设置下,相比现有在线蒸馏方法持续取得改进。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16937 v1。首次提交 2026-09-15 10:12:56 UTC,即北京时间 2026-09-15 18:12:56;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 §2–4、Figure 2、Tables 1–2、Appendix A/E/F;方差条件与二值奖励混合见定理及 RBM 定义。 原文:v1 PDF。
PROSE:多数答案一致,为什么仍可能越练越错
- Rewarding Reasoning, Not Answers: Fixing and Bounding Test-Time Reinforcement Learning on Medical QA
作者:Kailong Fan、Anqi Pu、Yichen Wu、Wanhua Li、Yicong Li、Hanspeter Pfister、Huafeng Liu、Xiang Li、Quanzheng Li、Ning Guo。 机构:Harvard Medical School/Massachusetts General Hospital;浙江大学;Harvard University(v1 首页)。
任务背景。 模型拿到一道有四个或五个选项的医学考试题,需要写出推理并选择答案。测试时没有把标准答案交给它训练,一种做法便是让它多答几次,把出现最多的选项当作临时答案,再训练它更加认同这个答案。问题在于,许多不同的错误推理也可能落到同一个错误选项上,于是“一致”逐渐增加,正确率却没有提高。
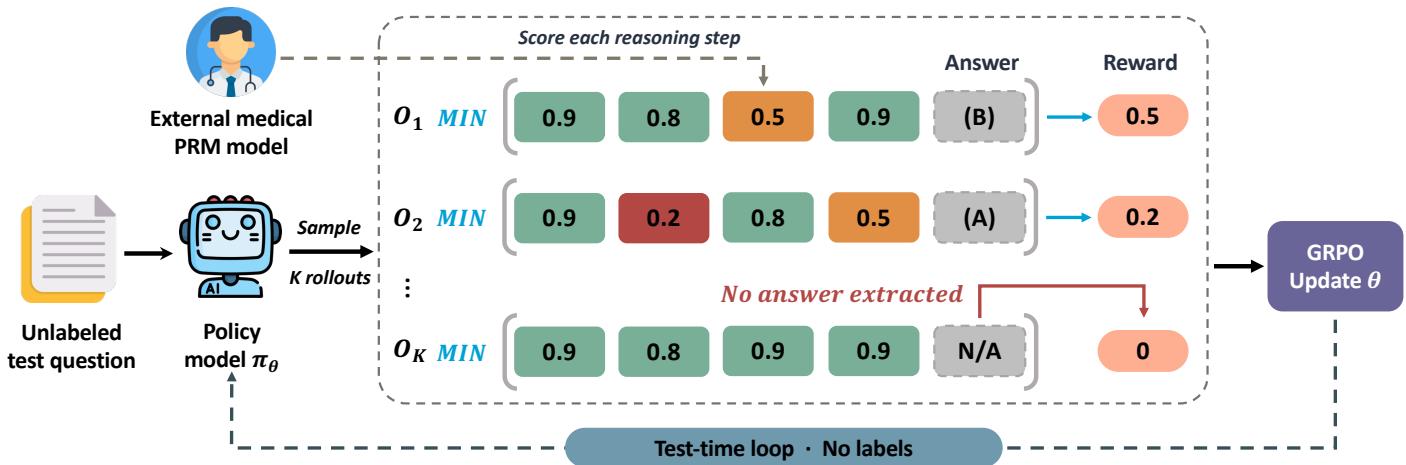
核心方案。 论文先固定题目、模型与优化器,只改变答案空间,观察错误答案是否容易互相碰撞。随后用同一个学习循环替换奖励:模型仍对每题生成多条推理,但不再按多数票奖励,而是让一个外部医学过程评分模型逐步判断推理。每条回答取其中最低的一步作为奖励;如果最终选项无法解析,奖励直接为零。这样,堆很多容易获得高分的句子,也不能稀释中间那一步的低分。
这些回答的奖励再经组内比较,交给 GRPO 更新答题模型。下一轮重新采样,继承的是答题模型的新参数,评分模型保持固定。适应完成后,答题模型可以独立作答,不再逐条调用过程评分模型。这里“没有标签”只指适应时不使用这些测试题的标准答案;外部评分模型本身已经带入医学过程监督,不能把它说成凭空产生可靠反馈。
图源:v1 Figure 3,PDF p.4,MinerU 抽取原图。
读图。 从左边未标注的题目进入,模型分出多条回答。沿第一条看,步骤分数里最低是 0.5,所以整条奖励为 0.5;第二条同理是 0.2。最下面虽然各步分数都高,却没有输出可解析答案,因此走红色分支得到零。右侧把这些奖励用于参数更新,底部虚线再返回答题模型,这是适应阶段的循环;完成适应后的独立推理流程没有画在图里。
这不就是用最差的一步给整段回答打分吗? 是这个操作,但它针对的是两层失败:多数票可能奖励共同错误,平均过程分又可能被很多高分步骤稀释。最低分仍依赖评分模型可靠,不能保证所有形式的奖励投机都被消除。
贡献与证据。 Llama-3.1-8B 在四组问答上的 avg@16 均值从 0.635 升到 0.740,采用多数票奖励的 TTRL 为 0.671;这些是分别在各自测试题上适应的传导式结果,不是四份完全未参与学习的独立测试。另一个实验只在 MedQA-5op 适应,再冻结模型迁移,提供了较有限的分布迁移证据。平均过程分的消融中,代理奖励接近 1,准确率反而低于初始模型;最低分方案避免了该实验中的退化。1.7B 模型的收益也不如 4B 稳定,方法存在能力条件。
评测数据集与环境。 MedQA-5op/4op、MedMCQA、DDXPlus;各实际题数、固定数据版本未给出。主实验在测试输入上适应,报告 avg@16;与推理重排比较时使用 maj@16,另有 MedQA-5op 适应后的冻结迁移。16 是每题采样次数,依据 §5–6、Tables 1–4、Figures 2–5。
[!abstract]- Abstract 完整中文翻译 测试时强化学习利用多数票伪标签,在模型自身未标注的测试集上进行适应,已经在数学任务中取得较好结果。我们发现,这一做法在医学多项选择问答中会崩溃:准确率停滞,而输出多样性迅速下降。通过固定题目、模型和优化器,仅改变答案空间的受控实验,我们将这种失败定位到答案空间结构,而非领域难度。在小答案空间中,错误轨迹常会碰巧落到同一个错误伪标签上,并继续强化它;在大答案空间中,错误答案更分散,获得的奖励较少。基于这一诊断,我们提出过程奖励指导的自训练 PROSE,奖励推理质量而非答案一致性。PROSE 用医学过程奖励模型为每个推理步骤打分,取所有步骤中的最低分作为轨迹奖励,同时约束答案格式。在不使用标签的情况下,它显著改善一个通用 Llama 模型,超过专门的医学模型,并接近更大的系统。过程信号被吸收到策略中,因此适应后的模型在推理时不需要奖励模型,收益也能迁移到未见数据集。我们还发现最低分聚合十分关键:平均分聚合可能被利用,使代理奖励饱和而准确率下降。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.16660 v1。首次提交 2026-09-15 05:31:55 UTC,即北京时间 2026-09-15 13:31:55;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 §3 的答案空间对照、§4 方法、§5–6 适应与迁移协议、Figure 3。摘要中的“无标签”和“未见”须结合正文实验边界理解。 原文:v1 PDF。
EvoOntology:把反复查错的数据含义,改成可查询的知识层
作者:Meiduo Chong、Shaolei Zhang、Ju Fan、Xiaoyong Du。 机构:中国人民大学(v1 首页)。
任务背景。 用户问“上个月成本为什么上涨”,数据 Agent 需要在表格、财报和数据库中找出对应数据,运行查询或分析,给出有依据的解释。即使它会写 SQL,也可能把不同币种直接相加,或者把业务里的“成本”对应到错误字段。论文希望把这些反复需要确认的数据含义保存下来,让以后做相关分析时能够直接查询。
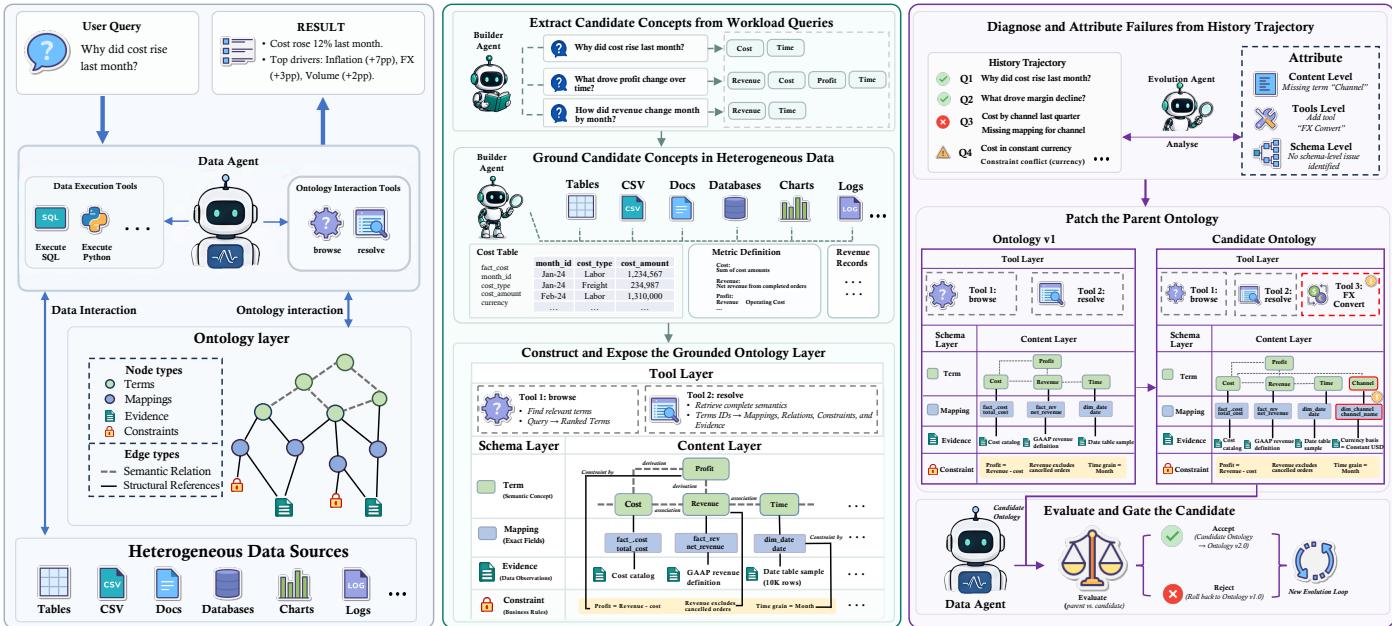
核心方案。 构建阶段先从训练工作中的常见问题提取概念,再实际探查数据,确认这些概念对应的字段、关联路径和使用条件。只有有证据支持的内容才写入知识层。运行时,Agent 先检索相关概念,再展开其字段映射、约束和证据;整份知识不必一次塞入提示词。论文将概念和记录称作内容层,规定这些记录长什么样的结构称作模式层,对外查询它们的接口称作工具层。
有了执行记录以后,另一个 Agent 判断失败来自哪一层。例如成本口径不对,可能需要修改内容中的币种约束;查询方式不合适,则可能修改工具。一次候选只改一层,接着让同一个任务模型在相同验证题、解码设置和交互预算下分别使用旧版与候选版;达到预设改善幅度才保留,否则回退并记录失败尝试。每个底座单独演化自己的版本,最后冻结知识层,再到另一份任务上测试。
图源:v1 Figure 2,PDF p.3,MinerU 抽取原图。
读图。 左栏是部署时怎样答题:问题进入数据 Agent,它既能执行 SQL/Python,也能查询下方知识层。中栏解释这份知识最初怎样建立,从工作问题提取概念,再去原始数据核对,最后形成可查询结构。右栏则是训练工作中的修订:从历史轨迹归因,产生候选,底部与旧版本配对比较;接受后进入下一轮,拒绝就保留原版。图中的多个红色修改示例展示可改内容,不表示一次实验把所有层同时改掉。
这不就是一份会根据错误修订的数据字典吗? 可以把数据字典当作入口,不过这里还保存证据与约束,并允许修订记录结构和查询接口。新增价值需要由配对验收和未参与适应的任务验证,而不是字典条目变多就算完成改进。
贡献与证据。 DDR-Bench 主表六种底座的轨迹分数都提高,平均比无知识层基线高 17.8 个百分点;静态地把知识放进提示词并不稳定。作者还比较构建后和演化后的版本,以区分初始知识与后续修改的作用。v1 摘要、若干消融仍写四种底座,主表则写六种,所以不能把各处平均增益混成同一个总体结果。实验采用互换两折验证,支持适应后迁移;不支持部署中无限递归提高,也没有把整个搜索成本与所有基线完全拉齐。
评测数据集与环境。 DDR-Bench 10-K 场景 报告逐消息与整轨迹准确率;InsightBench 报告洞察/总结评分;BIRD 在 Oracle Knowledge 条件下报告 EX/VES。均采用两折互换、适应折内 70% 构建与 30% 验收、冻结后测另一折,实际各折题数未披露;依据 Experiments、Tables 1–7。
[!abstract]- Abstract 完整中文翻译 数据 Agent 旨在执行针对表格、文件和数据库等异构数据的自然语言指令。然而,数据位于 Agent 外部,它只能通过通用工具访问列名、文件路径等信息,形成了困难的 Agent 与数据之间的鸿沟。现有方法或者让 Agent 直接探索原始数据,或者把人工构建的语义层注入提示词;这些方法既难以扩展到大规模异构数据,也难以适应不同 Agent 的行为。我们提出 EvoOntology,一个供数据 Agent 使用的自我演化本体层。它通过 MCP 服务封装模式层、内容层和工具层,使 Agent 能在运行时主动查询并与本体交互。框架引入构建 Agent 自主建立本体,并通过持续的自我演化循环进行修订:归因指导带类型的修改,只有通过针对特定底座的配对评估才予以接受。在三个常用数据 Agent 基准和四种大语言模型底座上的实验表明,EvoOntology 持续优于强基线和现有语义层方法,有效缩小 Agent 与数据之间的鸿沟,改善对异构数据的交互。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15779 v1。首次提交 2026-09-14 15:59:24 UTC,即北京时间 2026-09-14 23:59:24;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 Method、Experiments、Figure 2、Tables 1–7;摘要按 v1 原文保留“四种”,正文主表实际列六种,平均值须按各表自身范围解释。 原文:v1 PDF。
Skill Issue:技能文档变好了,怎样证明 Agent 真的受益
作者:Mykhailo Kozyrev、Andrei Kozyrev、Anton Podkopaev。 机构:Technical University of Munich;JetBrains Research;Constructor University Bremen(v1 首页)。
任务背景。 想让代码 Agent 更熟悉一个 Kotlin 仓库,可以给它一份介绍模块边界、测试方式和易错点的技能文档。Agent 接到具体修复任务后读这份文档、修改代码,最后应让目标测试通过。可文档看上去更专业,并不能说明它帮助了模型:也许任务本来就会做,也许这次只是碰巧成功。
核心方案。 作者先从真实合并过的 PR 制作任务:固定仓库版本,撤销某项实现,检查哪些原本通过的测试开始失败,再让 Agent 修复。统一版本使学到的技能描述同一套 API;否则把数月前后的仓库变化混在一起,文档可能同时学到互相冲突的结构。任务还要经过有效性检查,避免模型面对与目标无关的构建故障,或在不修改代码时就已经通过。
接着固定答题模型、工具和执行上限,只允许优化器修改技能文档。每个候选的运行结果与同一道题上预先保存的空文档运行配对,先看是否改测试或虚报成功,再看隐藏测试是否通过,最后才比较成本与补丁大小。GEPA 从轨迹和分数中提出改写,SkillOpt 提出受限编辑,分别在自己的训练与验收流程中选择文档。最终选出的文件再测试于此前没见过的任务;被继承的是文件内容,模型参数不变。
方案图与读图。 所核对 v1 以流程正文、表格和文档实例展开,没有独立的核心方案原图。流程可以沿“构造有效任务→固定空文档参照→改文档并配对验收→留出任务测试”连续理解;这里保留原文定位,不用结果表冒充方案图。
这不就是给技能文档做有无对照吗? 是的,但先要保证任务足够真实、有提升空间,且评分确实能够区分文档作用和模型随机波动。否则优化器得到的每次“进步”本身就可能是噪声。
贡献与证据。 GEPA 三仓库的配对分数为 0.525、0.554、0.567,参照是 0.5;均值差约 4.9 个百分点。这个数字不是任务解决率的直接增幅。69 道留出题中,实际解决数变化分别为 14→15、13→16、16→20;但每仓库只有 20–26 题,所有比较都未达到 p<0.05,最好为 0.29。论文的结论是当前规模分不清收益与波动,而非证明收益为零。维护者认为部分文档包含有用项目经验,但一位维护者和两个额外问题也不足以替代更大样本的验证。
评测数据集与环境。 Skill Issue Kotlin PR 评测集:koog/kotest/ktor 分别 119/100/131 个有效任务,留出测试 23/20/26 题;训练与验证用于改写和选文档,测试不参与。主要报告配对分数、解决数及符号检验;GEPA 200 个计分尝试、SkillOpt 三个 epoch,不把两者当作严格同总成本比较。依据 §3–4、Table 1、Appendix A–D。
[!abstract]- Abstract 完整中文翻译 代码 Agent 越来越多地从 SKILL 中读取仓库知识;这些纯 Markdown 文件与代码一起接受版本管理。近期研究通过针对基准优化文档来自动生成它们,但一个普通仓库没有现成基准,既有工作生成的合成任务又过于简单,以至能力较强的 Agent 在没有文档时就接近满分。我们从仓库已合并的 PR 中挖掘更难的任务,在同一个冻结基础提交上撤销这些变更,并根据同一 Agent 使用文档后是否比不用文档表现更好来评价候选。三个 Kotlin 仓库中,GEPA 找到的文档使这一分数平均提高 4.9 个百分点,SkillOpt 找到的文档则基本停留在起点,只比种子高 0.1 个百分点。GEPA 的收益与既有工作使用同一优化器时报告的结果相近,但在单个仓库能提供的数据规模下,无法将其与 Agent 的运行间波动区分;解决这一问题需要的任务数超过一个仓库历史能够提供的数量。文档本身比数字更有说服力:一位仓库维护者认为,其中包含了只有实际参与项目才会获得的知识。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.12742 v1。首次提交 2026-09-11 11:41:29 UTC,即北京时间 2026-09-11 19:41:29;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 §1–4、§6、Table 1 与任务有效性说明。4.9 pp 对应配对评分,不直接等于 pass-rate 增益。 原文:v1 PDF。
Gavel:让执行模型自己判断,此刻该加载哪项技能
作者:Ruishuo Chen、Xun Wang、Yu Chen、Zhuoran Li、Longbo Huang。 机构:清华大学交叉信息研究院(v1 首页)。
任务背景。 假设 Agent 正在修改代码,看到工具返回后才发现自己需要一项特定的数据转换技能。它应从一个很大的技能库中选出合适内容,再加载执行。把全部技能说明预先放进上下文会占用空间;只让另一个检索模型看一句短请求,又可能漏掉当前执行中刚出现的需求。
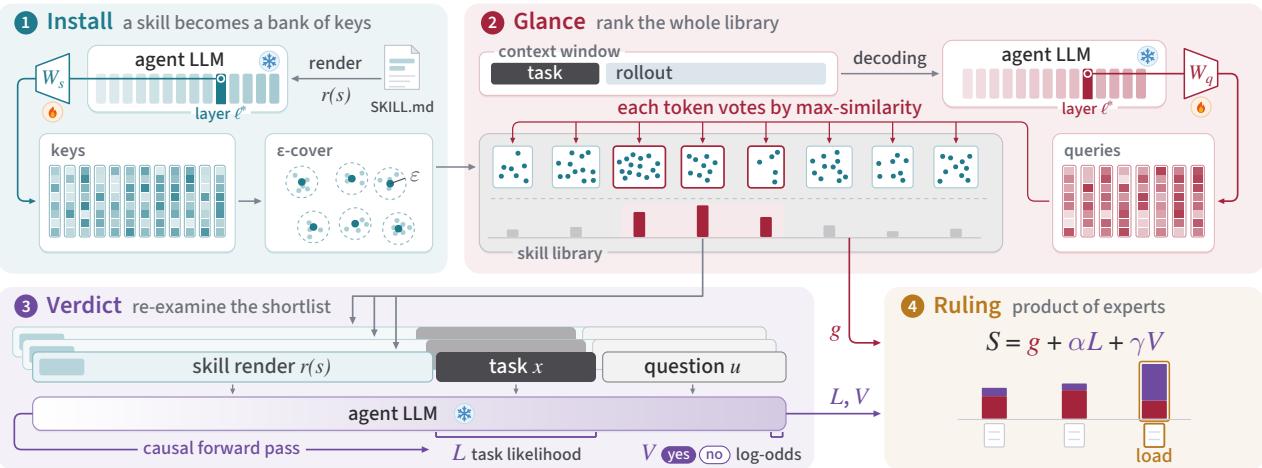
核心方案。 在训练阶段,系统冻结执行模型,只用已有的“任务—适用技能”配对训练两张线性映射。安装一项技能时,让同一个模型读过其正文,把中间层的表示转成检索键,并压缩相似的键。实际做任务时,再从正在生成的上下文提取查询表示,与全库的这些键比较;近期与技能有关的 token 可以给候选投票,先筛出很小的一组。
模型随后对每个候选作更仔细的判断:把该技能作为前缀,计算它对当前任务文字的解释能力,并回答“这个技能是否合用”。这两项信号与初筛分数合并后决定加载谁。技能库的表示和已训练映射可以复用,新技能不必重新训练主干;不过候选仍需要额外前向计算。在真正的 Agent 集成实验里,作者还训练了一个“现在是否该尝试技能”的门,未达到适用条件时可以不加载。
图源:v1 Figure 2,PDF p.5,MinerU 抽取原图。
读图。 先看左上编号 1,这是安装时建立技能检索键,不是每个任务都重复训练。右上编号 2 从当前任务轨迹读出查询,用投票筛全库;箭头向下只留下少数候选。左下编号 3 让模型结合候选全文判断任务,产生两个更细的分数,最后在右下编号 4 合并决定。图中冻结符号标在模型主干,火焰标在训练过的映射;它没有画出部署实验后来增加的触发门,也没有画出任何技能自我修订循环。
这不就是借用执行模型做两阶段检索吗? 是的,具体增量在于从模型自己的中间状态读出查询、按 token 匹配压缩技能库,再用同一模型的概率和判断复核。它减少了额外大检索模型的需要,但没有把存储、预处理和候选判断的成本变成零。
贡献与证据。 Qwen3-32B 的两张投影共 7.9M 参数,技能检索键约压缩 8.5 倍。正文报告在不同书面任务上的最佳相对增益可达 13.4 个百分点,中途需求场景可达 21.9;评价采用裁判复核后的适用率,不是纯粹与唯一金标 ID 相等。集成实验正确技能触发率为 0.909,不能写成任务完成率 90.9%。与更大模型在不同 Harness 中的对比还混有执行框架差异,也不证明一个读出层会在模型升级后无需重新训练就自动迁移。
评测数据集与环境。 SkillRet v1 测试 4,997 查询/6,660 留出技能,另有训练与校准划分;SRA-Bench 抽样 861 任务/26,262 技能;Eval-Core 75 查询/约 78K 文档;SkillTraj 372 条模拟轨迹,均考察路由适用性。Skill-Use 177 任务/79 技能,此文报告正确技能触发率,集成额外训练触发门。依据 §4、Table 1、Appendix H/I。
[!abstract]- Abstract 完整中文翻译 技能能够把大语言模型 Agent 的能力扩展到参数知识之外,但收益取决于是否选对技能。已部署框架通常把每项技能的元信息预先放入上下文来做路由,这会分散注意力并限制库规模。检索流程把选择移出上下文,却也将其移出了 Agent 自身的能力范围。我们发现,冻结的执行模型在前向计算中已经带有路由信号,只需两张线性映射,就能在不把技能文本放入执行上下文的情况下读出它。Gavel 分两步利用这一信号:先将任务和技能的中间层状态经这两张唯一需要训练的映射投影,对安装时通过一次前向建立的紧凑技能检索库进行粗筛;随后延续入围技能的前向计算,读出模型自身的似然与是/否判断,并用专家乘积与初筛结果融合。经过一次训练,Gavel 零样本迁移到三个公开基准和我们新建的 372 条模拟 Agent 轨迹基准 SkillTraj。在 Qwen3-32B 上,相比渐进披露以及额外引入 1.2B 至 16B 参数的检索重排流程,书面任务最多提高 13.4 个百分点,中途才出现技能需求时最多提高 21.9 个百分点。路由准确率随底座能力提高而改善;在 bash Agent 框架中,同一 32B 模型在 Skill-Use 上触发正确技能的频率,也高于运行于 Codex 的更大前沿模型。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.15982 v1。首次提交 2026-09-14 17:58:27 UTC,即北京时间 2026-09-15 01:58:27;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 §3–4、Figure 2、Table 1、Appendix H/I/J。摘要“两张映射”描述路由主体;§4.4 的完整 Agent 集成还训练触发门。 原文:v1 PDF。
GeoSkill:先分清经验错了,还是这次没有照经验执行
作者:Han Luo、Xu Xian、Yinhe Liu、Yanfei Zhong。 机构:武汉大学(v1 首页)。
任务背景。 假设 Agent 要分析某地区地表温度的变化,它需要选择合适的数据产品、时间范围和空间分辨率,按顺序调用处理工具,最后交出分析结果。一次失败可能是经验里选错了产品,也可能是经验写得对、Agent 却没按要求填参数。若不分来源就重写经验,反而会把原来正确的约束破坏掉。
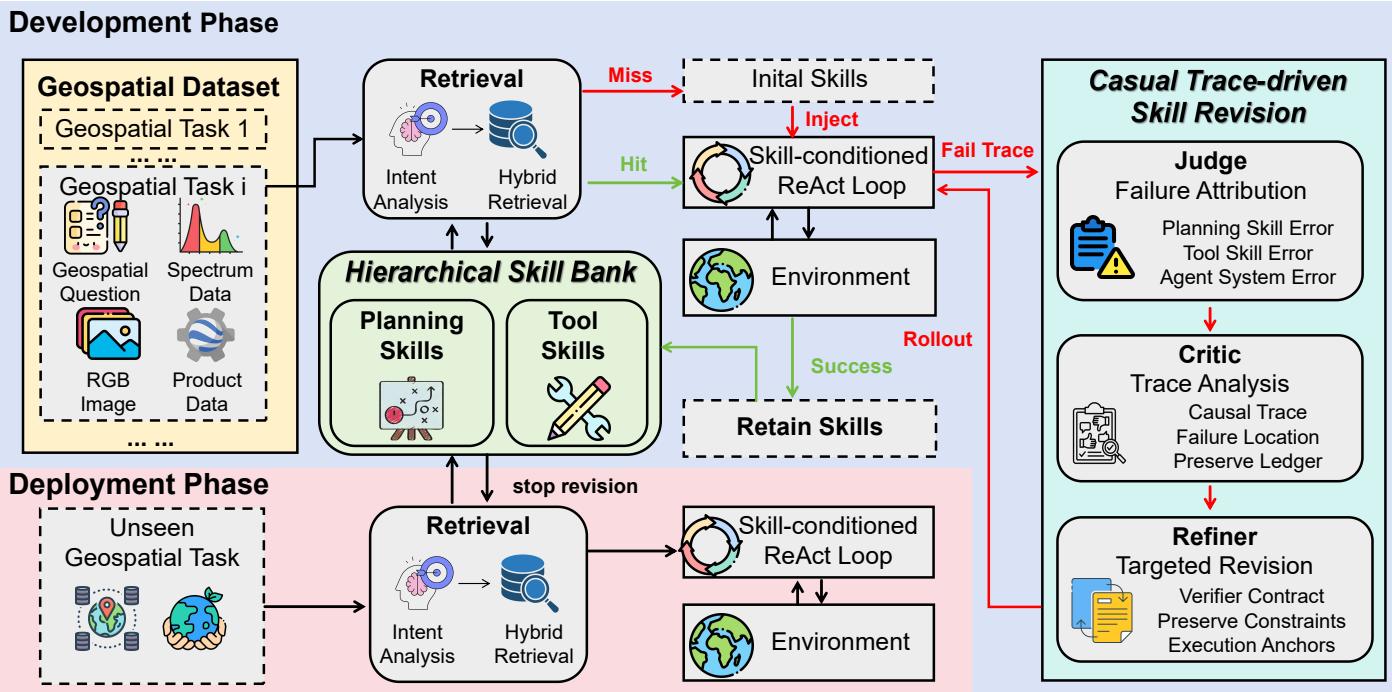
核心方案。 系统先把经验分为两层:规划技能保存“这类分析通常怎样串起步骤”,工具技能保存“这一工具需要什么输入、参数和约束”。每次执行前先选一个规划,再取它所需的工具技能,整次执行沿用这组上下文;缺失技能可以先生成临时候选,但不会立即写进公共库。
失败后,第一步判断责任是否真的在技能。若只是没有遵守正确步骤,就留下供下次尝试使用的临时反思,不改知识;若技能有缺陷,再定位受影响的字段,并列出已经被证据支持、应当保留的部分。最后只修改有依据的问题位置,让整个候选技能组合重新执行原任务。成功才整体写回;预算用完仍失败,就丢弃本任务的全部候选,恢复原库。完成开发后冻结技能,新任务只读取,不继续修订,模型参数全程不变。
图源:v1 Figure 2,PDF p.4,MinerU 抽取原图。
读图。 上半部是开发阶段:从左侧任务进入技能检索,命中就执行,缺失先建立临时候选。执行失败沿红线进入右侧,从责任判断到缺陷定位再到局部修订,然后回到执行;只有绿色成功路径把技能送回库中。再看中间“stop revision”这条边界,下半部面对未见任务,只剩检索与执行,不再返回右侧修订链。图中的三个角色承担不同检查工作,不代表三个独立学习、持续演化的模型。
这不就是给经验库增加分类、检查和回滚吗? 可以这样理解。关键在于让可迁移的步骤与不能丢失的工具约束分别保存,并且先确认知识有错,再动知识;“因果追踪”的名称本身并不保证模型诊断一定正确。
贡献与证据。 EarthBench 中,DeepSeek-V4-Pro 的准确率为 79.03%,ReAct 为 58.06%,Reflexion 为 73.98%;消融从只有层次技能的 72.58% 升至加入修订后的 79.03%。这些结果支持有限开发经验能够转移到另一个任务子集。论文也报告强模型生成的技能在 8B 执行模型上可能更差,说明经验要适配执行能力。数值仍需谨慎:ThinkGeo 的 Logic F1 在正文写 59.61,主表写 49.61;部分方法的答案分母也不同,这里保留冲突,不拿它们拼出统一提升幅度。
评测数据集与环境。 EarthBench 测任务准确率、工具/参数可靠性及执行冗余;ThinkGeo 测感知、编排、逻辑 F1 和答案。均先用一份任务构建技能,再冻结于另一份测试,精确规模与划分未明确;ThinkGeo 表内存在 185/33 与 188/30 的分母差异。依据 Experiments、Tables 1–2、Figure 3,不把离线学习成本包含在执行冗余比中。
[!abstract]- Abstract 完整中文翻译 地理空间 Agent 越来越需要支持反复出现并不断变化的分析任务,而不仅是执行孤立工作流。因此,Agent 需要把先前执行经验提炼为可复用的地理空间程序知识,指导未来规划与工具使用。现有记忆增强方法却难以同时总结长程工具链编排经验和工具调用约束,直接依赖大模型自我反思更新经验也常导致归因错误与不可靠修订。我们提出 GeoSkill,一个由经验驱动的层次技能学习框架。它包含两个核心组件:层次技能库 HSB,由规划技能库和工具技能库组成,分别提炼高层规划经验与工具使用约束,支持历史经验的结构化表达和跨任务复用;协作式轨迹驱动技能修订 CTSR,由 Judge、Critic 和 Refiner 分别完成错误识别、技能缺陷定位及针对性修改,防止错误归因和不可靠修改污染技能库。GeoSkill 在开发阶段从历史执行中学习并验证技能,在部署阶段冻结技能库,仅通过检索指导未见任务。EarthBench 和 ThinkGeo 的大量实验表明,该方法能将历史执行经验转化为可复用的层次技能,提高地理空间任务的端到端准确率与工具执行可靠性。
[!info]- 来源、版本与阅读依据 arXiv 预印本,2609.13667 v1。首次提交 2026-09-12 02:50:52 UTC,即北京时间 2026-09-12 10:50:52;2026-09-17 本轮 OAI/RSS/HF 合并或官方来源补查发现。核对 Method 全部机制、Experiments、Figures 1–3、Tables 1–2;摘要称 Collaborative、方法与图称 Causal 的 CTSR 均指同一修订组件。正文数字与表值冲突已保留。 原文:v1 PDF。