Harness 与模型共同更新:整段模仿老师为何会退步
作者: Yu, Zhou、Bi, Bin、Pentyala, Shiva Kumar、Mehrotra, Shubham、Chaudhuri, Sougata、Bhagavath, Shilpa、Chen, Zeyuan、Xu, Ran、Mui, Phil、Zhu, James、Asur, Sitaram
机构: Salesforce AI。(署名依据:v1,第 1 页)
任务背景。 例如让 Agent 检查库存并处理预警:它拿到业务要求、当前记录和可用工具,需要查询信息、判断条件,再完成规定操作,最后检查业务结果是否符合要求。模型外面负责传递工具结果、组织执行步骤的程序叫执行框架(Harness)。这篇研究如何同时改好这套程序和模型本身,让两者配合完成任务。
先把外部工具和流程调到适合小模型,再用强模型成功轨迹微调它,看似两边都增强,结果却可能相互抵消。
核心方案。 论文先保留小模型的参数,调整它周围的提示、工具和执行流程,也就是 Harness,让这套工作方式适合当前模型。接下来要训练模型时,作者让小模型继续沿自己的方式尝试任务,再从失败记录中找出一个关键的出错步骤,请专家只改正这一步。这样,训练材料既提供了正确示范,又保留了小模型实际会遇到的上下文。
修正后的记录与小模型自己成功完成的记录一起,用于 LoRA 监督微调。整套方法先改善工作流程,再针对模型在这套流程中的具体短板训练;最终留下的是更新后的 Harness 和模型参数。论文对照了直接模仿专家完整轨迹的做法,发现整段照学可能破坏小模型与既有 Harness 的配合。
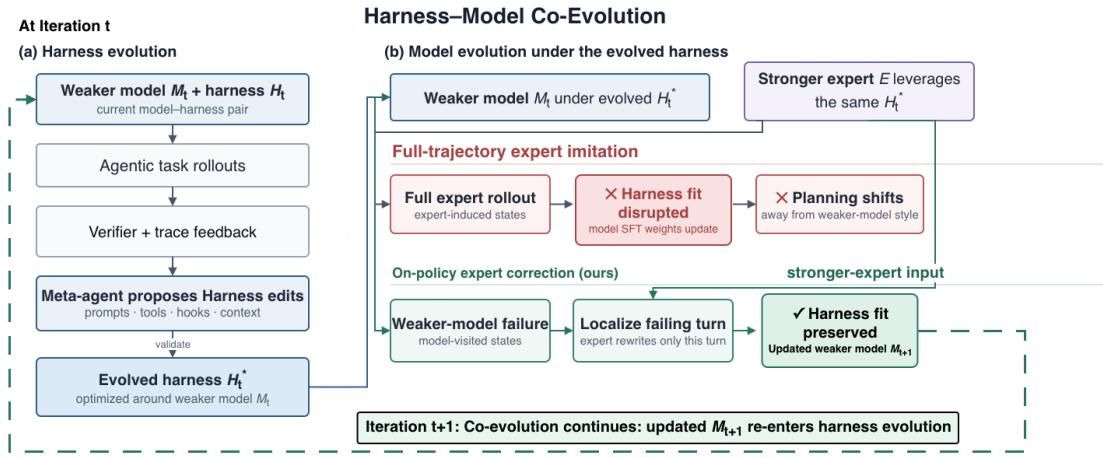
读图。 从左侧看起:小模型先在一套 Harness 中执行任务,执行表现用来指导 Harness 的修改。等这套流程适配小模型后,右侧才进入模型训练。这里上下两条分支是图的重点:上方让小模型模仿专家的完整做法,下方则从小模型自己的失败过程出发,只请专家改正出错的那一步。两条分支的差别在于,训练时是否保留了小模型原本的执行上下文。
底部返回的箭头表示,新模型可以与 Harness 一起进入下一轮调整。它画出了继续迭代的接口;本文实验主要验证的是这两类更新如何配合,以及整段模仿为什么可能造成退步。
原图:v1,Figure 1,PDF 第 3 页;原文定位。
这不就是……给员工量身改好工作台后,直接让他照搬高手整套做事节奏,反而可能用不好原来的工具;只纠正自己流程中的错步更容易保住配合。新增的是局部教师纠正与 Harness 演化的结合,而非证明所有模仿学习都会有害。
贡献与证据边界。 Table 1(第 5 页)七项企业任务中,演化 Harness 后均分 78.0%,整段模仿降至 63.1%;局部纠正为 79.7%,其中五项提高、两项略降。§3.3 的失败类型分析支持规划适配受损的解释,但不是排除全部混淆的因果证明。Appendix B 使用约 500 行数据、每个纠正点 3 个候选再由 judge 选择,包含额外专家与筛选成本。正文提出可叠加循环,尚未展示持续多代的受控共演化曲线。 原始全文。
[!abstract]- Abstract 完整中文翻译 Agent Harness,即模型周围的系统提示、工具集、执行 hook 和上下文管理结构,是 Agent 任务成功的重要决定因素。自动演化 Harness 能使小模型以较低成本完成特定领域任务。由于 Harness 和模型权重共同塑造行为,我们研究怎样结合 Harness 演化与轻量微调。在七项企业 Agent 任务上,我们先用较弱模型演化 Harness,随后发现更强专家往往更有效地使用它,说明专家监督可能缩小剩余差距。然而,用专家在演化后 Harness 下的完整轨迹训练较弱模型却适得其反:Qwen3-Coder 与 Gemma 4 的实验中,七项任务表现下降 4–30 个百分点,即使相同流程在未经演化的 Harness 下有益。分析显示,模仿转移了知识并增加了对外部结构的使用,却破坏模型与 Harness 的适配:较弱模型采纳专家的规划策略,却缺乏执行它的能力,也不再匹配围绕其原生规划方式演化的 Harness。为此,我们开发由元层 MLE Agent 自动运行的 on-policy 专家纠正流水线,在较弱模型自己的 rollout 中定位失败 turn,仅请专家重写这一 turn。这保留模型的规划方式,结合 Harness 演化与模型适应的收益。结果识别并解决了 Harness 与权重更新之间的一种冲突,为特定企业任务上的经济型共同演化提供了保持兼容性的训练方案。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.09134v1;v1 首次提交:2026-09-08 17:53:49 UTC=2026-09-09 01:53:49 北京时间。 已核对:v1 Introduction、§3、Table 1、Appendix B–C。 官方页面 · v1 PDF。
评测数据集与环境。 Enterprise Harness 七类企业任务(Co-evolving 使用协议)。七类企业任务,held-out test三次运行平均;训练与验收分开,且对原任务环境作了权限/错误可见性调整(§3、Table1、Appendix B)。 实验/附录依据。
NeoHorse-1:把路由记录变成下一轮训练材料
作者: NeoHorse Team、Cao, Guoliang、Dai, Guohao、Guo, Tianyu、Han, Kai、Hu, Hailin、Jiang, Zihan、Kuang, Xiang、Li, Boxun、Li, Yulong、Pei, Zehua、Tian, Yuchuan、Wang, Jiamin、Wang, Yu、Wang, Yunhe、Wu, Yihong、Xu, Haiyang、Zhang, Shuo、Zhou, Hang、Cheng, Siyang、Fan, Jiayu、He, Wei、Jiao, Qingrui、Li, Hongguang、Li, Zhiyuan、Liu, Runke、Liu, Xi、Liu, Xinchen、Pan, Sinno Jialin、Ren, Yi、Song, Liuyang、Wang, Chenyu、Yu, Bei、Zhang, Quanlu、Zhang, Xiangyu、Zheng, Mengyu、Zong, Yingjie
机构: TokenRhythm Technologies;Infinigence AI;Tsinghua University;Peking University;The Chinese University of Hong Kong;Visionplus Capital;WX Capital;Alibaba Group。(署名依据:v1,第 20 页)
任务背景。 用户提出一项工作要求后,Agent 需要理解请求、调用工具、读取结果,再继续操作或回答,最终看是否按要求办成了事。服务系统可以准备多个能力和成本不同的模型,为每次请求选择由谁执行,这叫模型路由。NeoHorse-1 关心的是,怎样利用这些真实办事记录训练模型,让它以后更会处理这类请求;路由记录是组织训练材料的一种线索。
线上 Agent 已经留下了大量工具调用和失败记录,但怎样把这些记录转成训练样本,而不是只当日志存起来?
核心方案。 NeoHorse-1 从日常任务的分配记录中积累训练材料。系统为每个请求选择模型时,会分别记下“预计需要多强的能力”“实际交给了哪个服务档位”,以及最终执行结果。整理数据时,它以用户的一轮请求为单位,保留此前的对话和工具返回作为上下文,只训练模型在当前轮应该怎样推理、调用工具和回答。
这些记录还用来安排学习顺序。系统重新估计任务的能力需求,据此组织三个阶段的课程;路由信息在这里决定先学什么、后学什么,不直接改变监督微调中每条样本的损失权重。随后,学生模型从这些上下文出发自行生成,固定教师根据学生已经写出的内容,给出下一步的预测分布。学生通过反向 KL 蒸馏向教师学习,这就是文中的 on-policy 蒸馏(OPD)。评估发现的能力缺口会影响下一轮的数据配比,训练后的模型则返回模型池,继续承担任务。
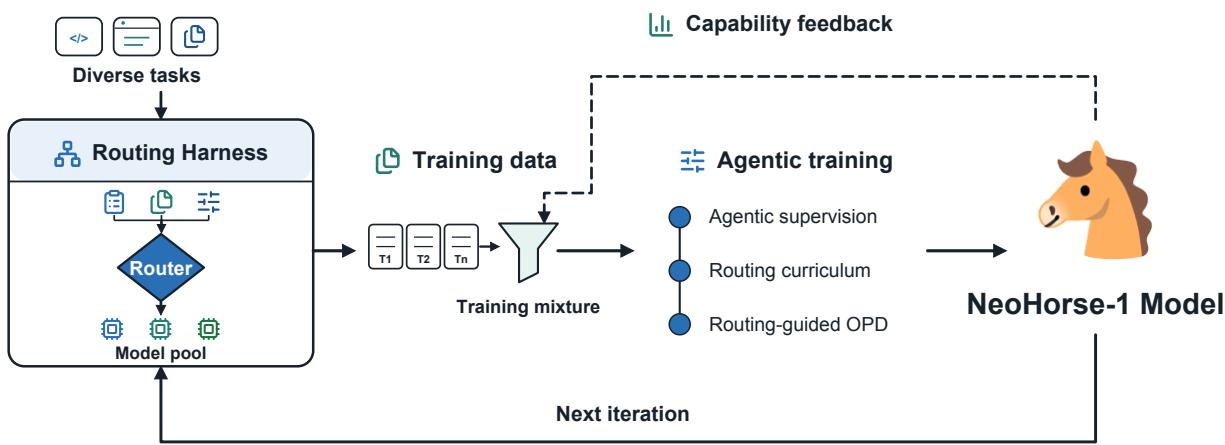
读图。 从左上方的任务进入 Routing Harness 开始看。它从模型池中选择模型来完成交互,留下的执行记录在中间被整理、混合,再送到右侧做后训练。因此,图中间的数据处理连接了两件事:系统平时怎样服务请求,以及模型之后从什么经验中学习。
再看两条返回路径:顶部虚线把能力评估结果送回数据选择,决定后续多学哪些材料;底部实线把训练后的模型送回服务系统。图中的模型参数会随训练更新,但正文只报告了一轮实测。返回箭头说明下一轮可以怎样接上,持续多轮的增益仍待验证。
原图:v1,Figure 2,PDF 第 3 页;原文定位。
这不就是……把客服系统的分流记录、处理过程和结果,整理成由浅入深的培训材料;学员自己试答,再请老师逐步纠偏。增加的是可追溯的数据组织与训练接口,路由档位只是需求代理,并非天然准确的难度标签,也不是把失败轨迹直接当正例学习。
贡献与证据边界。 Tables 1–2(PDF 第 14–15 页)中,十项评测宏平均:4B 从 58.94 到 64.87,9B 从 65.60 到 69.04;9B 的 IFEval 反而略降。作者自测模型使用各基准内一致的 Harness、工具与预算,部分外部基线标星,不能视为完全统一复测。§6(第 18 页)明确是单次 evaluation–selection–update,连续多代累积增益仍待验证;整套 recipe 的收益不能单独归因于路由课程或元改进。网页摘要写 eleven,v1 PDF 摘要和结果表为 ten;下方忠实翻译 v1 PDF 的十项口径。 原始全文。
[!abstract]- Abstract 完整中文翻译 递归自我改进(RSI)需要一个具体机制,让 AI 系统观察自身能力,并把这些证据转化为下一轮学习。我们认为,已部署的路由 Harness 已包含这样的机制:Agent 交互不仅产生任务输出,还留下执行轨迹和可观察的证据,表明模型能做什么、暂时不能做什么。我们提出 NeoHorse-1,一组通过 Agent 后训练探索这条路径的原生 Agent 模型。系统将异构模型池与智能路由结合,为每一轮记录预测的能力需求、选择的服务档位以及随后发生的交互。这些记录被转成 user-turn 训练样本,保留交错推理、工具调用和 Harness 上下文,并经过结构验证、六维语义评估和子场景标注。路由信号提供能力需求估计:它把监督微调组织成三阶段课程,并自然扩展到路由引导的 on-policy 蒸馏,由教师在相同的阶段进程下监督学生生成的回答。最后,能力引导的数据分配把评估反馈转化为下一轮训练配比,形成评估—选择—更新闭环,让系统学会什么影响它接下来从什么材料中学习。在涵盖 Harness Agent、工具使用、代码和指令遵循的十项基准上,后训练把 4B 模型的宏平均分从 58.94 提高至 64.87,把 9B 从 65.60 提高至 69.04,显著缩小后训练 4B 与 9B 基座模型的总体差距。本文提出一个初步原型,并说明如何持续迭代,使这一路径从设计走向实践。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08183v1;v1 首次提交:2026-09-08 03:14:54 UTC=2026-09-08 11:14:54 北京时间。 已核对:v1 Introduction、§3.4–4.3、§5、§6、Figures 2/4/6、Tables 1–2。 官方页面 · v1 PDF。
评测数据集与环境。 QwenClawBench、WorkBuddy Bench、PinchBench、VitaBench、BFCL V4、τ²-bench、HumanEval、LiveCodeBench v6、IFEval、IFBench。v1主表共十项,涵盖工作流、工具、代码和指令;同基准内控制Harness/工具/预算,宏平均不等于合并题目准确率,部分外部结果为引用(§5、Tables1–2)。 实验/附录依据。
EvoRS:策略变了,奖励系统也要跟着变
作者: Li, Weiyuan、Chen, Aili、Wang, Xintao、Zhang, Yikai、Dong, Qingqing、Xu, Jinghan、Hou, Hongru、Zhao, Wenxuan、Lang, Chengkun、Gao, Jun、Guo, Yuanli、Guo, Hongcheng、Xiao, Yanghua、Yang, Deqing
机构: Fudan University;Shanghai Key Laboratory of Data Science;Nankai University;Hello Group。(署名依据:v1,第 1 页)
任务背景。 以按要求写文章为例:模型收到主题、用途和写作要求,交出一篇文章,需要同时满足内容、表达等多方面标准。训练时,要把这些评价变成分数,告诉模型哪些写法值得保留。开放式写作往往没有唯一标准答案,因此“怎样打分”本身就会影响模型学到什么。本文研究模型逐渐变化后,评分办法怎样跟着修正。
写作模型逐渐学会用虚构数字换高分。只往评分标准里补一句“要真实”,可能仍抵不过其他维度的高分。
核心方案。 EvoRS 把评分过程写成一张可以执行的图:各个节点负责检查和打分,节点之间的组合规则决定哪些分数相加、哪些错误要扣分,以及什么情况需要直接否决。这张图称为 Reward-DAG。这样,面对模型用虚构数字换高分的问题,系统既能修改“检查什么”,也能修改“这些检查怎样决定最终奖励”。
每训练五步,一个负责设计奖励的 Agent 就会读取当前模型的执行记录,以及每个评分节点给出的结果,诊断评分哪里出了问题。它在允许的范围内提出几个修改版本,让这些版本对同一批案例重新评分,再决定是否替换旧图;没有合适的改进就沿用原版。修改和拒绝的经验会被保存,供下一轮设计参考。两次修改之间,选定的评分图保持固定,持续为 GRPO 训练提供奖励。
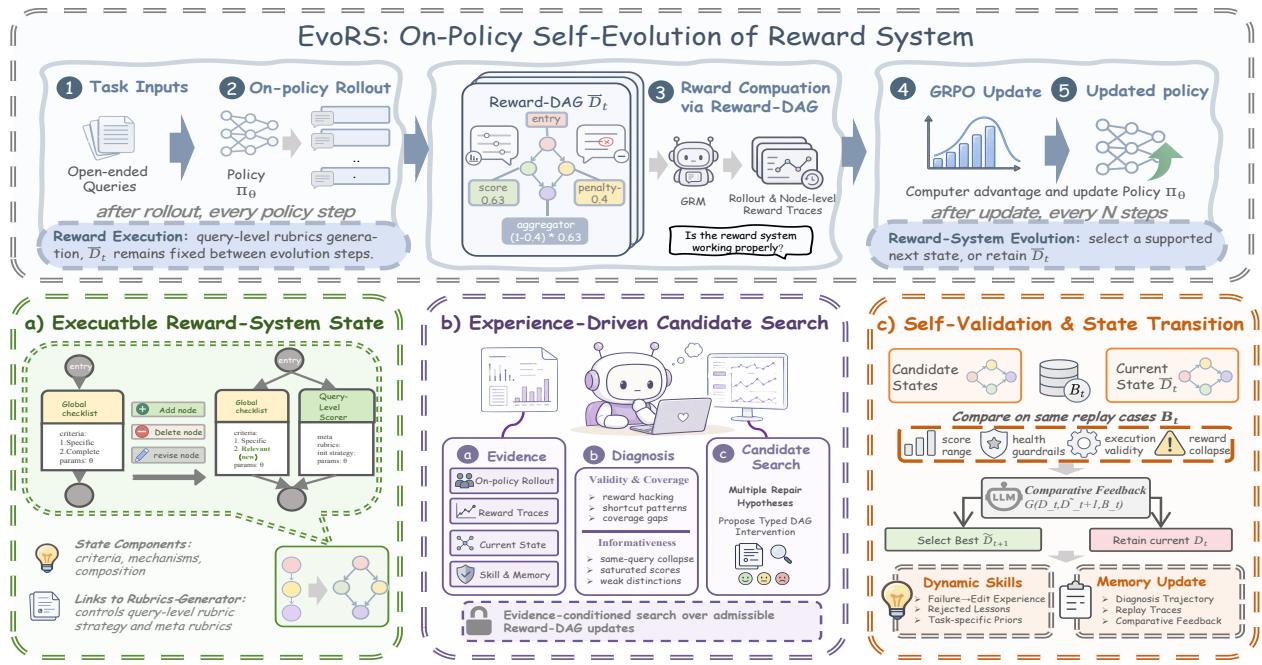
读图。 先沿顶部看一轮常规训练:当前模型生成任务结果,奖励系统为结果打分,GRPO 根据奖励更新模型。再看下方,模型的执行记录和各评分节点的结果被送入诊断与修改流程。候选评分图在同一批回放案例上比较,通过后才替换顶部正在使用的 Reward-DAG。因此,模型可以频繁训练,而评分规则只在通过检验后更新。
右侧的记忆和动态技能保存了此前怎样修改、哪些尝试失败,供下一轮设计使用。这里要区分两个角色:设计 Agent 负责改评分流程,日常训练中的逐条打分仍由选定的评分图执行。
原图:v1,Figure 4,PDF 第 5 页;原文定位。
这不就是……考生发现评分漏洞后,不只补评分条目,还调整扣分和一票否决规则,并把改过什么、为何失败记下来。贡献是让“怎样产生训练奖励”也成为可检验的修改对象;设计器的权限和外部质量评估仍由固定规则约束。
贡献与证据边界。 Table 2(第 7 页)三位 judge 均分:写作 54.894→57.001,角色扮演 60.909→65.676;这是相对基座模型,不能说相对最强基线多 2.107/4.767。Table 4 把最后发现的完整 Reward-DAG 从训练开头固定使用,角色扮演只有 60.573,支持演化路径有作用。HR/CFR 只审查预先定义的失败模式,不能证明消除全部 reward hacking;周期性设计有额外成本,写作与角色扮演之外的长程工具交互仍待验证。 原始全文。
[!abstract]- Abstract 完整中文翻译 开放式强化学习往往依赖基于评分细则的奖励,以处理没有可直接验证答案的任务。然而,策略与奖励系统构成动态反馈循环:策略不断优化当前奖励时,最初有效的奖励系统可能因奖励投机或回答区分能力下降而变得不可靠。因此,奖励系统应在训练中演化,而非保持固定。现有动态评分细则方法会调整评估标准,但奖励失败也可能来自评分机制或信号组合。我们提出 EvoRS,一个从 on-policy 经验中演化奖励系统的自我演化 RL 框架,将奖励系统表示为可执行的 Reward-DAG。具体而言,一个 Agent 设计器依据 on-policy rollout 与奖励痕迹更新该系统,以维持训练期间的可靠性。在写作与角色扮演任务中,EvoRS 在全部三位评审下取得最高质量,分别比原策略提高 2.107 和 4.767 分,同时减少奖励投机与覆盖缺失,并保持奖励的信息性。消融结果表明,在这些开放式任务中,预先设定的全面奖励系统无法持续保持可靠,需要在整个训练过程中演化。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.12459v1;v1 首次提交:2026-09-11 05:40:59 UTC=2026-09-11 13:40:59 北京时间。 已核对:v1 Introduction、§4–5、Table 2、Table 4、Limitations。 官方页面 · v1 PDF。
评测数据集与环境。 WritingBench、CoSER。WritingBench生成1,000条、共同有效994条;CoSER每方法200场;三judge聚合,训练Reward-DAG奖励与最终质量评测分开(§5、Appendix D.6)。 实验/附录依据。
Experience Funnel:先改技能,再把有效部分写回模型
作者: Gao, Wenbo、Song, Zhaomou、Ji, Zhiyuan、Liu, Renxi、Li, Xing、Yu, Xianzhi、Li, Xiaoguang、Cheung, James Chung-wai、Lin, Weizhe、Wang, Yaoyuan
机构: The Hong Kong Polytechnic University;Huawei;Renmin University of China。(署名依据:v1,第 1 页)
任务背景。 例如让 Agent 在购物网站找到满足价格和规格要求的商品:它要搜索、查看详情、作出选择,最后由任务检查判断是否符合要求。为了少犯错,可以给它一份根据过去经验整理的操作说明,这就是外部技能。本文想进一步弄清,哪些有用做法可以通过训练变成模型自己会的能力,让它以后少依赖临时放进上下文的说明。
技能文档越来越长,Agent 每次都要重新读一遍。哪些经验值得变成模型自己会的能力,哪些仍应留在可编辑的外部状态里?
核心方案。 Experience Funnel 先让 Agent 根据多次执行的经验修改技能说明等外部文本,并检验修改是否有效。接着,它让 Agent 分别在没有文本提示、使用旧版文本、使用新版文本的条件下完成同一任务。这样才能辨认:哪些行为是新版经验刚刚带来的,哪些行为一直受这些经验帮助,并从中选择值得训练的记录。
选好记录后,方法还要判断模型具体该学哪几步。它比较有、无文本提示时模型对下一 token 的预测,用两种分布的 JS 差异衡量这一步受到文本多大影响,再据此加权蒸馏损失。训练同时加入不依赖外部文本的强化学习,希望模型逐渐学会独立完成这些行为。更新后的模型和文本继续参与下一轮任务,已经不再需要的文本可以删除。经验因此先保存在容易修改的文档里,再有选择地进入模型参数。
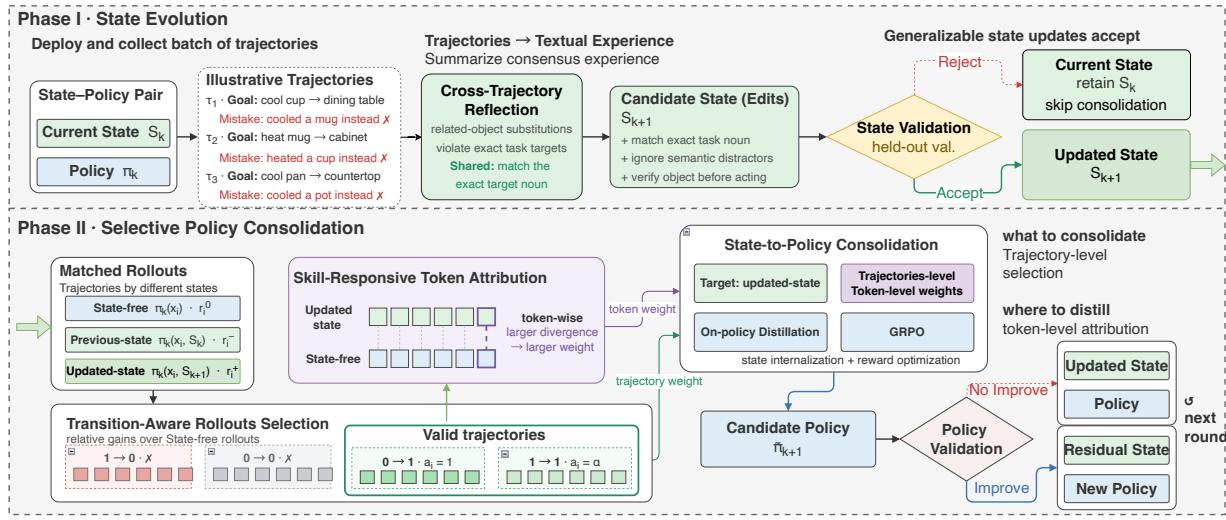
读图。 先看图中从交互记录到文本状态修订的部分:Agent 把执行经验写进外部文本,并检查新版文本是否有用。随后向下看,新版、旧版和不使用文本的执行结果被放在一起比较,筛出值得保留的行为。再往后,方法挑出其中受文本影响的生成步骤,用来训练模型,让这些经验逐渐成为模型自身的能力。
图中有两处会留下变化:一处是外部文本,另一处是模型参数。它们一起返回下一轮执行。原 PDF 右侧的循环文字本身已有裁切,这里的返回含义依据图注说明;此外,正文对教师模型的描述尚未完全一致,因此这张图应作为作者提出的流程来理解,实现细节仍需澄清。
原图:v1,Figure 1,PDF 第 4 页;原文定位。
这不就是……把试过确实有效的工作便签练成习惯,再清理已经不需要的便签。新增的是跨状态版本筛选和 token 级聚焦;分布差异是局部响应指标,并不自动等于严格的因果信用分配。
贡献与证据边界。 §3.1 明确五轮状态演化中只有第 1、4 轮通过并触发模型更新;Table 1 报告 SearchQA 62.4、ALFWorld 67.9、WebShop 42.4。不同环境 OPD 预算不同,均值不是等预算对照。关键疑点:§2.2 定义同一冻结策略的有/无状态对照,§3.1 却引入固定 Qwen3.5-27B 教师;Table 1 的 62.4 与 Table 2 的 full-loop 63.6,以及 Figure 2 图例与图注,也未清晰对齐。现阶段保留方法思路,复现前需作者澄清配置。 原始全文。
[!abstract]- Abstract 完整中文翻译 由大语言模型驱动的自主 Agent 持续通过交互积累经验,为通过自我演化改进未来行为创造了机会。核心挑战是,怎样把大量任务特定经验转成可复用的模型能力,又不失去快速适应新证据的能力。技能与 Agent Harness 等显式文本状态支持快速、可读、可编辑的适应,但会持续依赖外部上下文;参数化策略能提供紧凑、可复用的能力,却更新得慢得多。我们提出 Experience Funnel,通过交替循环结合快速状态适应与较慢的策略巩固。交互轨迹先被提炼为显式文本状态,快速吸收并验证新经验。随后,框架选择那些跨状态修订仍有价值的、由状态支持的行为,通过感知状态转变的蒸馏将其巩固到策略中。更新后的状态—策略组合继续生成 rollout,为下一轮状态适应与策略巩固提供新证据。多种 Agent 基准上的实验表明,相比只演化状态或只将经验内化到策略的方法,Experience Funnel 持续提高 Agent 能力,并逐步把有效的显式经验转成自主策略能力。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08919v1;v1 首次提交:2026-09-08 15:48:11 UTC=2026-09-08 23:48:11 北京时间。 已核对:v1 Introduction、§2–3.4、Tables 1–3、Figure 1–2、Limitations;实现口径疑点尚未解决。 官方页面 · v1 PDF。
评测数据集与环境。 SearchQA、ALFWorld、WebShop。训练收集/状态修改/OPD,validation验收与选checkpoint,test只最终报告;环境间OPD预算不同,不能当等预算平均(§3.1、Tables1–2)。 实验/附录依据。
Procedural Graphs:让执行流程从成功和失败中改写
作者: Lu, Yuxing、Chen, Yicheng、Wu, Shanchan、Arık, Sercan Ö.
机构: Google;Georgia Institute of Technology;Peking University。(署名依据:v1,第 1 页)
任务背景。 以查资料回答问题为例:Agent 拿到问题,需要找到相关材料、核对证据,再给出答案。做成这件事通常需要多个步骤配合,某一步单独做对也不代表最终答案可靠。本文希望把“该有哪些步骤、在什么情况下先做哪一步”保存成可修改的流程,利用过去任务的成败,让后续执行得到更合适的指导。
Agent 搜索了多次,却始终忘记验证答案再提交。把过去的经验写成长段提示后,下次执行仍可能漏掉关键先后关系。
核心方案。 Procedural Graphs 把办事步骤及其先后条件保存成一张有向图。例如,“提交答案”之前可以先连上“检查证据”,连接上还写明什么时候需要检查、该怎样检查,以及常见错误。Agent 执行任务时,系统根据它最近的动作定位当前步骤,只取周围两跳以内的局部流程。一个指导模型结合这部分流程和最近三步执行记录,给出下一步建议,最终动作仍由执行任务的 Agent 自己选择。
一次任务执行期间,流程图保持不变。积累一批记录后,负责修订的模型才比较成功与失败的过程,尝试增删步骤、连接或说明。修改要先通过结构检查,再在留出的验证任务上比较表现;平均分没有下降才保留,否则撤回。被拒绝的改法也会留下记录,帮助下一轮减少重复尝试。
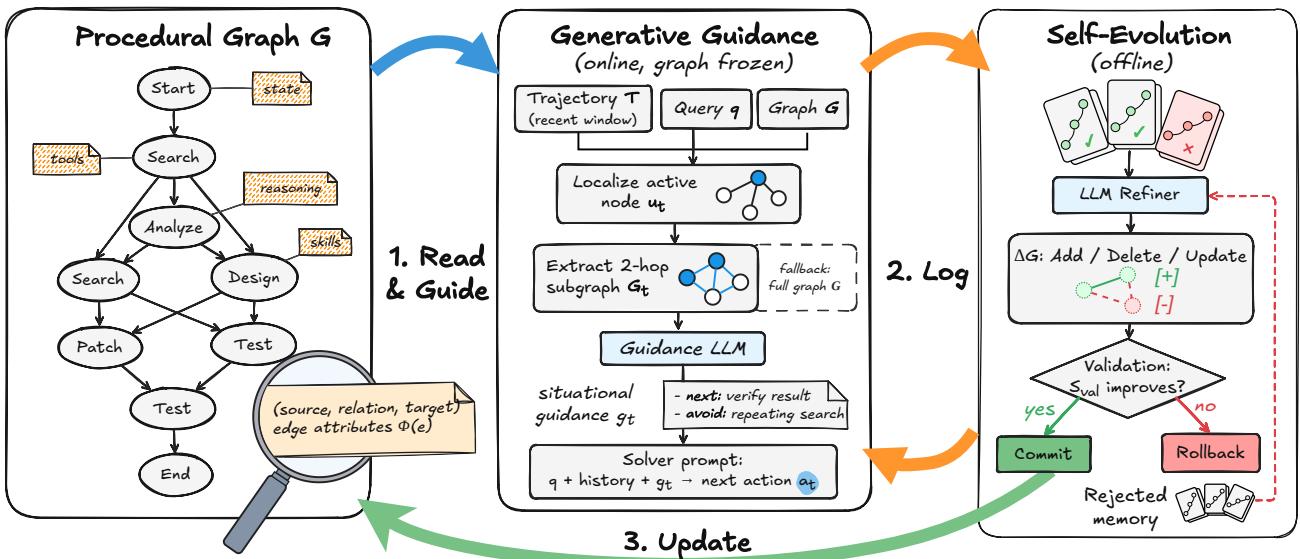
读图。 先看左侧保存的流程图,再顺着它进入中间的在线执行部分。系统找到 Agent 当前所在的步骤,取出附近的流程关系,把它们转成适合眼前情境的建议,再交给图中的 solver,也就是实际执行任务的 Agent。
橙色箭头把执行记录送到右侧,供修订器在一批任务结束后改图。修改通过检验,绿色箭头才把新版送回左侧;没有通过就恢复旧版,并记录这次被拒绝的尝试。图上用 improves 描述验收,正文公式允许验证分数持平,因此这里的接受条件应读作“表现不下降”。
原图:v1,Figure 2,PDF 第 4 页;原文定位。
这不就是……把办事流程表变成能试改的操作手册:试着加入“先验收再提交”,跑一批任务检验,退步就撤回并记住为什么失败。真正增加的是可编辑的步骤关系、局部指导和更新验收;模型权重与改图规则本身没有递归改写。
贡献与证据边界。 §5.4(第 9–10 页)报告十轮演化:中间有多轮未接受更新,最终返回图在独立测试上的生存率为 85%,无图基线为 0%;搜索中曾见 95%,作者没有拿这个测试峰值当最终结果。每个划分仅 20 个 episode,验证接受与拒绝可能被一两次随机结果影响,不构成真实期望收益单调的保证。Table 1 的 24 个模型×任务设置中,21 个第一或并列第一,但并非全胜。Table 3 表明局部指导减少部分 solver 步数,却仍比无图多用 token;跨 solver、工具接口迁移仍待进一步评估。 原始全文。
[!abstract]- Abstract 完整中文翻译 大语言模型正越来越多地被部署为能够进行长程规划、通过外部工具行动的 Agent。多数 Agent 在不断积累的历史上下文上通过不受约束的生成来选择动作,而“做什么、按什么顺序、在什么条件下做”的程序性知识仍然是隐含的。随着轨迹变长,Agent 可能忘记目标、以错误顺序调用工具,并重复无效动作。我们提出 Procedural Graph:正如知识图谱把事实知识组织为(实体、关系、实体)三元组以回答“是什么”,程序图把程序性知识组织为(步骤、关系、步骤)三元组以回答“该做什么”。每个决策步骤中,框架定位 Agent 的活动节点,由指导模型把周围子图转成当前步骤的情境化建议,影响求解器下一动作的选择,但不强制规定动作。图能够自我演化:LLM refiner 对比失败与成功轨迹,编辑图的拓扑和属性,提交那些保持或提高留出验证集表现的修改,同时保留被拒修改以减少重复尝试。从最小骨架开始,该循环能构建出达到或超过人工设计水平的图,也能修复有缺陷的专家先验。在多个数据集、任务类型和大语言模型上,Procedural Graph 相对基于记忆的基线取得一致收益,自我演化进一步提升表现,无需人工工程干预。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.09153v1;v1 首次提交:2026-09-08 17:59:41 UTC=2026-09-09 01:59:41 北京时间。 已核对:v1 Introduction、§3–5.5、Figures 2/4、Tables 1–3。 官方页面 · v1 PDF。
评测数据集与环境。 HotpotQA、MultiChallenge、GDPval、ALFWorld、τ-bench、BFCL V3 多轮函数调用、EnterpriseArena。主六项测试分别1,000/166/44/134/115/100;EnterpriseArena另测50个episode,自演化用20/20/20。HotpotQA取官方validation重划分(§5、Appendix B.1)。 实验/附录依据。
COBRA-Skills:把评估预算花在值得试的技能上
作者: Lu, Pingchen、Wang, Xiangyi、Li, Xiang、Mao, Jie、Qu, Zikun、Luo, Junfeng、Shu, Yao、Low, Bryan Kian Hsiang、Dai, Zhongxiang
机构: The Chinese University of Hong Kong, Shenzhen;Tianjin University;The Hong Kong University of Science and Technology (Guangzhou);National University of Singapore。(署名依据:v1,第 1 页)
任务背景。 以按要求修改电子表格为例:Agent 收到表格和操作要求,完成修改,交出可检查的结果。执行时,它可以参考一份文字操作说明,本文称为“技能”。同一件事可以写出多份不同说明,但究竟哪份更有用,需要让 Agent 真正做任务来判断。本文要在有限试跑预算下,找到并逐步改好这些说明。
有十份候选技能说明,每次都在一整批任务上试跑太贵;只试目前最好的,又可能错过尚未验证的新思路。
核心方案。 COBRA-Skills 每轮先决定把试跑预算给哪份技能。它根据技能文本的语义表示和过去的表现预测收益,同时给尚未充分试过的候选增加探索机会。后一个因素由 LinearUCB 的不确定性奖励实现,使系统既愿意继续验证看起来有效的技能,也有机会发现暂时缺少证据的新方案。
选中的技能会交给目标 Agent,在真实任务中执行。任务得分和执行过程随后写回历史,用来改进下一轮预测。隔一段时间,系统还会依据这些证据重写技能、局部修改技能,或组合已有技能的内容,替换优先级较低的候选。默认设置保留十份技能,运行三十轮,每轮选一份在五十个优化样本上试跑,最后将实测均分最高的技能用于未见测试任务。
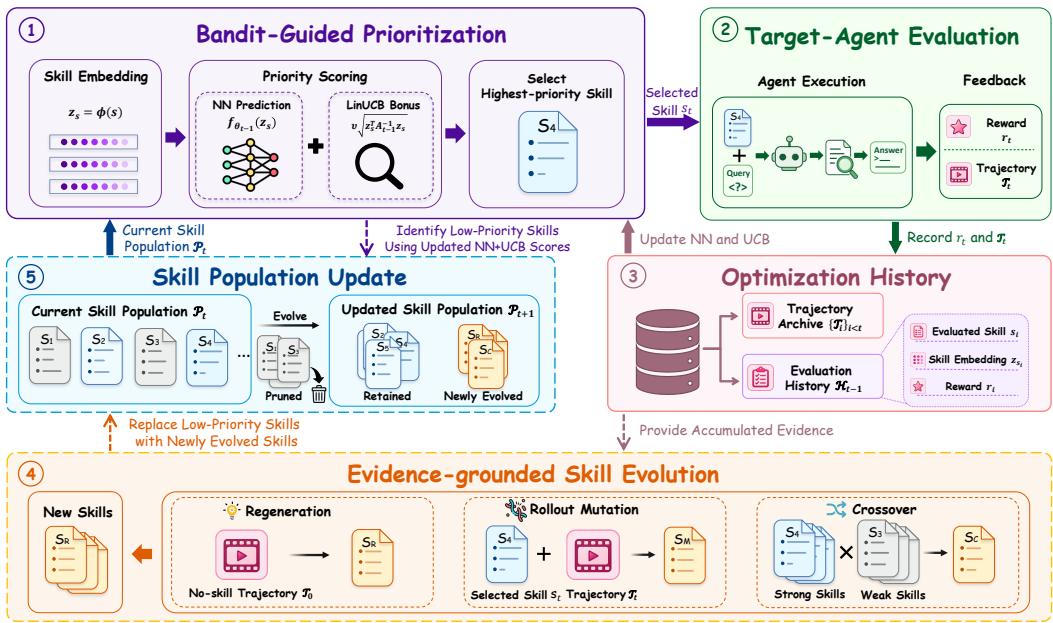
读图。 先沿图中的 ①、②、③ 看一轮评估。① 根据预计收益和当前不确定性选出一份技能,② 让目标 Agent 带着它实际执行任务,③ 再把任务奖励和执行记录写回历史。下一次选择因此能够用上这次试跑的证据。
底部的 ④ 和 ⑤ 负责更新候选集合:先依据积累的记录生成或修改技能,再替换较弱的候选。虚线表示这部分按周期发生,技能并非每轮都改。新技能的好坏仍要通过后续任务执行来判断,不能直接沿用旧技能的分数。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……让候选操作手册先竞争试用机会,再根据真正办成或办砸的过程修订。新增的是在不断变化的技能集合里兼顾有希望的候选与未探索区域;50 个独立优化样本不等于只执行 50 次。
贡献与证据边界。 Tables 1–2(第 6 页)中,六项平均分相对 SkillOpt:Qwen 69.6→73.5、Nano 53.7→56.9、Gemma 67.6→68.9,报告三次运行均值与误差。论文成本口径下降 55–58%,主要减少昂贵教师调用;Qwen 的目标模型 token 反而从 93.77M 增至 115.92M,不能称所有计算都同比减少。基线使用更大的优化样本池,因此训练数据量不是完全对齐的控制。§5.2 换目标模型自己生成和修改技能后,平均分为 72.5,接近强教师的 73.5。支持有边界的技能循环改进,尚不证明改进算法自身持续变得更好。 原始全文。
[!abstract]- Abstract 完整中文翻译 大语言模型(LLM)Agent 可以受益于从过往任务经验中提炼的可复用技能,但现有技能优化方法往往依赖昂贵的执行式评估和大量任务数据。我们提出 COBRA-Skills,一个把技能优化表述为动态演化候选空间上的预算约束序贯优化问题的高效框架。COBRA-Skills 将上下文多臂老虎机引导的优先级排序与基于证据的技能演化结合,有选择地把评估分配给有希望或有信息价值的候选,同时持续根据执行反馈修订技能种群。在六种异构 Agent 基准和三个目标模型上,COBRA-Skills 在所比较方法中始终取得最强的平均表现,相对 SkillOpt 将优化成本降低 55–58%,每个基准仅使用 50 个不同的优化样本。进一步分析表明,COBRA-Skills 对 Harness 变化保持稳健,在由目标模型自己生成和修订技能时也仍然有效。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.11682v1;v1 首次提交:2026-09-10 15:12:24 UTC=2026-09-10 23:12:24 北京时间。 已核对:v1 Introduction、§3–5.3、Figure 1、Tables 1–3。 官方页面 · v1 PDF。
评测数据集与环境。 SearchQA、SpreadsheetBench、DocVQA、LiveMathematicianBench、ALFWorld、SocialMaze — Hidden Role Deduction。每项50优化、100留出测试;SocialMaze仅HRD且为0/0.5/1软分,其余二值;部分基线优化池更大(§5、Appendix A)。 实验/附录依据。
SE-GoS:技能检索图越改越好并不成立
作者: Fu, Dawei、Jiang, Cheng、Qian, Sitian、Wang, Huainan、Hao, Zhongkai
机构: Peking University;Tencent;University of Edinburgh;Northwestern University;Tsinghua University。(署名依据:v1,第 1 页)
任务背景。 假设 Agent 收到一项技术工作,同时有一个存放操作说明的技能库。开始执行前,它要从大量文件里找出这项工作用得上的几份,读完后再操作工具、交出结果。检索到的说明是否真的有帮助,要结合实际使用情况和任务成败判断。本文改的是寻找和组合技能的关系图,让下次更容易取到需要的说明。
技能库里有上千份文件,问题可能不是技能写得差,而是检索没有找齐完成任务所需的技能。
核心方案。 SE-GoS 从技能之间的关系入手改进检索。最初,系统只根据文本中的词元相似度,把技能连接成图;这样的连接未必反映任务实际需要的配合关系。Agent 执行任务后,系统会检查哪些技能被找到了、哪些真正用上了、使用顺序如何,以及任务最终是否成功,再据此调整图中哪些技能相连、连接有多强,以及检索时使用的技能描述。
后续任务仍由原来的 GoS 检索器处理,但它读到的图已经改变,因此有机会找到更合适的技能组合。更新会保存在图及其描述信息中,技能正文、检索代码和模型参数都保持原样。论文也继续尝试了多轮更新,结果表明,积累更多执行记录并不保证检索效果一直提高。
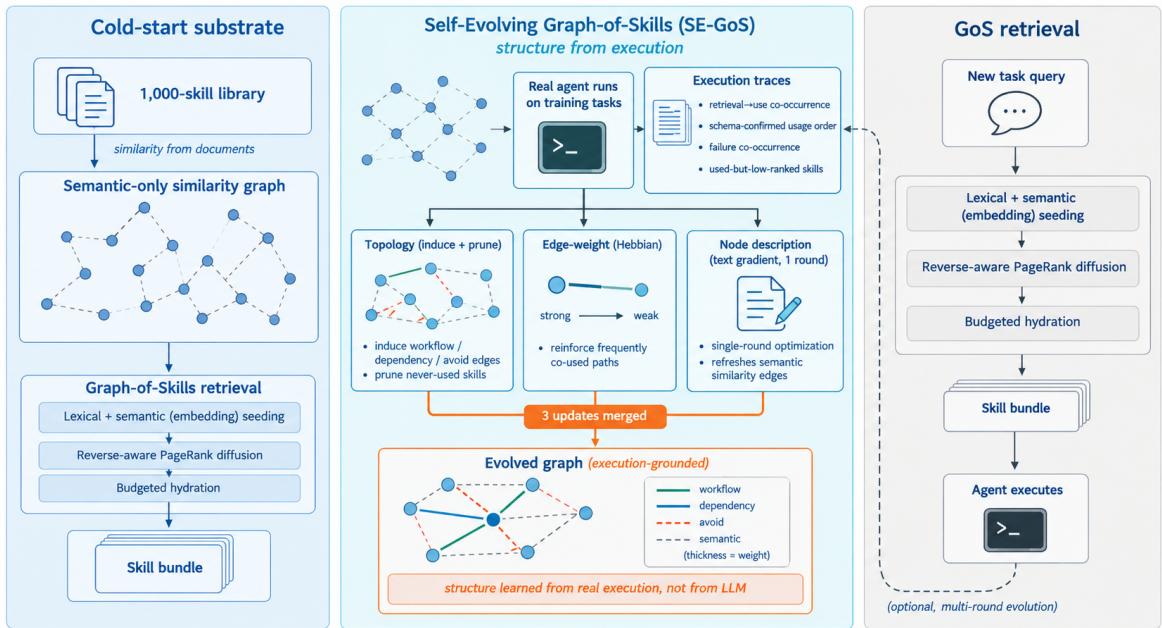
读图。 从左侧的初始技能图看起,它主要反映技能文本是否相似。中间的演化过程引入实际执行证据,分别调整连接关系、连接权重和检索用的描述。沿着这些修改走到右侧,可以看到检索流程仍然相同,只是开始使用更新后的图来为 Agent 组合技能。
图中主流程展示一次离线修改后如何投入使用,返回路径允许继续收集经验、再次修改。是否值得再改一轮,要看正文的迭代实验;其中已经出现后续轮次退步,循环箭头本身不代表能力会持续增长。
原图:v1,Figure 1,PDF 第 1 页;原文定位。
这不就是……不重写操作手册,先重排索引与关联,让系统能找到应该一起看的几本;改多了也可能把无用关联加回来。贡献在经验驱动的检索载体更新,不能把共现证据直接当因果依赖。
贡献与证据边界。 Table 3(第 10 页)50 个训练任务外的 37 个测试任务上,静态 GoS 52.9%→58.3%,作者注明仍处于噪声带内。Table 4 同一 87 题反复演化:52.4→59.4→59.8→54.0,边数不断增长但第三轮回落;这是同任务部署实用性曲线,不是每轮独立泛化曲线。avoid 边在报告实验中并未真正启用,不能将其说成已验证的收益来源。 原始全文。
[!abstract]- Abstract 完整中文翻译 现代 LLM Agent 越来越依赖可复用技能,但当技能库扩展到数千条时,有效检索成为瓶颈。Graph-of-Skills(GoS)通过考虑依赖关系的图结构进行可扩展检索,SkillDAG 进一步表明技能图可以在线积累有执行证据支持的结构。但历史执行轨迹能否系统地提炼成更好的检索图,并泛化到未见任务,仍未解决。我们提出 Self-Evolving Graph-of-Skills(SE-GoS),一个无需训练的框架,在保留原检索流水线的同时,依据执行轨迹演化已有 GoS 图。它包含三类互补更新:拓扑演化依据执行证据发现和剪除技能关系;边权演化按历史效果强化有助检索的关系;描述演化利用执行反馈优化面向检索的技能描述。在 SkillsBench 上的三个 LLM 中,SE-GoS 均改善任务回报,并相对加载全部技能减少输入 token,收益因模型家族而异。在一个代表性设置中,一轮演化把回报从 52.4% 提高至 59.4%,相对全部加载减少约三分之一输入 token;所得图在不相交的留出划分上,比静态 GoS 提高 5.4 个百分点。结果表明,无需训练模型、更改检索算法或修改技能内容,技能图也能从执行经验中改善,将静态检索图变成可演化的检索基础设施。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08228v1;v1 首次提交:2026-09-08 04:20:11 UTC=2026-09-08 12:20:11 北京时间。 已核对:v1 Introduction、§4、§5.3–5.4、Tables 3–4、Limitations。 官方页面 · v1 PDF。
评测数据集与环境。 SkillsBench、ALFWorld。SkillsBench全87题两次尝试用于部署再测,另做50/37留出;ALFWorld dev作跨域检查。87题循环演化不是每轮独立测试(§5.1–5.4)。 实验/附录依据。
Safe Harness Self-Evolution:停滞可能卡在验收而非生成
作者: Cai, Qianshu、Zhang, Yonggang、Nie, Jun、Ran, Maohao、Zheng, Huajiang、Song, Jun、Tian, Xinmei、Guo, Yike、Xue, Wei
机构: University of Science and Technology of China;Hong Kong Generative AI Research & Development Center;The Hong Kong University of Science and Technology;Hong Kong Baptist University。(署名依据:v1,第 1 页)
任务背景。 例如一个 Agent 已经能完成部分代码任务,现在想修改它外面的执行程序,让原先失败的题也能做好,同时保住已有能力。需要交出的不只是新版程序,还要有足够的测试证据,说明它值得替换旧版。这篇重点分析这个“能不能放心采用更新”的问题,区分修改实际有效与有限测试能够确认它有效。
Agent 每轮都能写出新补丁,却长期没有补丁被接受。是没有好方案,还是有限评测根本证明不了它足够好?
核心方案。 这篇论文分析一个容易被混为一谈的问题:系统没有采用新版本,究竟是没有找到好改法,还是现有测试不足以证明它更好?作者固定任务分布和模型参数,要求 Harness 的修改既改善原先失败的任务,也保住已有表现。在这个前提下,论文分别研究生成合格修改的可能性,以及用有限测试确认它合格、允许它上线的可能性。
这一区分也影响怎样理解连续改进。一个修改即使实际有效,也可能因为证据不足而一直无法被采用;一次更新成功,也不保证下一版仍有容易发现、容易验证的改进机会。论文进一步分析,在回报有上界的条件下,系统还能改进多远,以及接近性能边界时验证成本会怎样变化。它提供的是分析这些限制的理论框架。
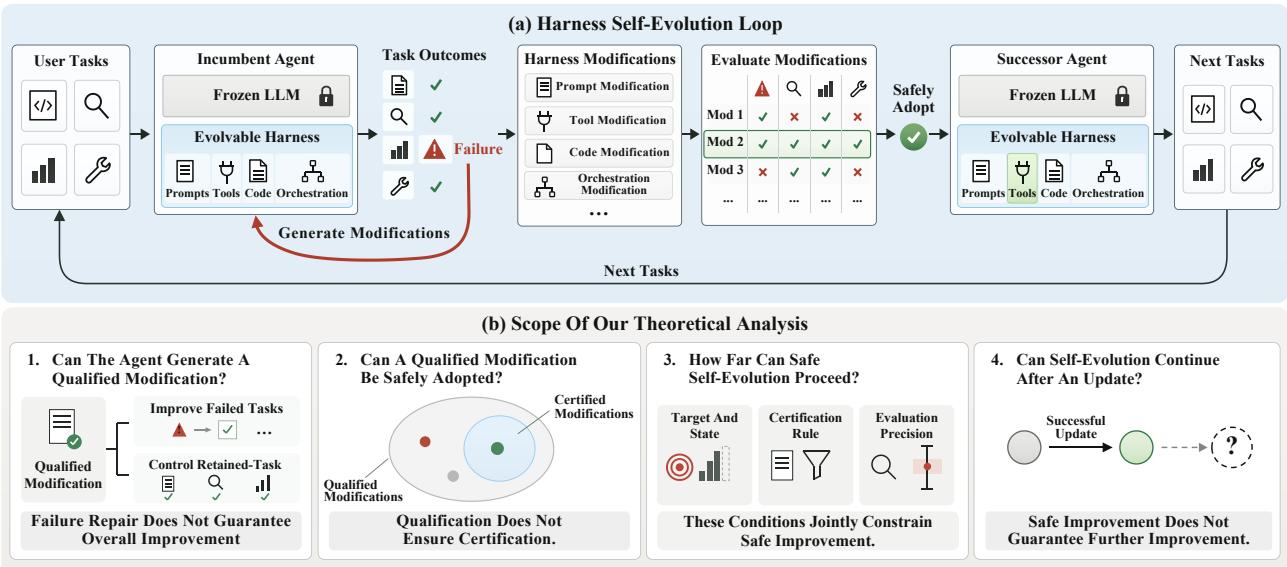
读图。 先沿图的上半部分看一次更新:当前 Agent 提出 Harness 修改,评估后决定是否采用,采用后的版本再去面对后续任务。这条流程对应一个直观的问题:从当前版本走到下一版,哪些环节可能让更新停下来?
下半部分把这些环节展开。首先要有符合要求的修改,其次要有足够证据确认并采用它,之后才谈得上还能改进多少、是否保留下一轮机会。读图时尤其留意“实际合格的修改”和“有限测试能够确认合格的修改”这两个集合:两者之间的差距,解释了为什么没有新版本上线,也可能仍然存在改进机会。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……有好药方不等于小样本试验能证明它有效;把药方写得更多,也未必解除验证瓶颈。贡献是为这些瓶颈给出条件和界,而不是一个保证 Agent 无限变强的新优化器。
贡献与证据边界。 §3–5 的保证依赖固定任务分布、规定的目标与评估条件;接近回报上界时,识别真实改善的最坏情况评估成本可发散,但不是每个真实系统都会以同样速度变慢。§6.3 提供 DS-1000 等有限实验审查,理论边界不能直接外推为开放环境中的安全保证。有限轮已认证收益可累加,单次改善仍不保证还有下一次可达的改善。 原始全文。
[!abstract]- Abstract 完整中文翻译 Harness 自我演化指 Agent 在冻结底层语言模型的同时,依据任务反馈修改提示、工具、代码或编排,并让修改持续作用于后续任务。我们对安全 Harness 自我演化的可行性与局限进行系统理论分析,将修改生成、有限数据认证与选择、安全采用,以及更新后的行为连接起来。在固定用户任务分布下,我们给出保证总体期望回报改善、同时控制保留任务变化的条件,刻画生成合格修改的概率,并推导安全选择与采用的有限数据界。分析显示,生成和认证受到不同约束:当前任务表现不能决定生成合格修改的概率;评估受限时,生成更多候选未必提高成功更新的保证。因此,即使仍有改善机会,过程也可能停滞。我们进一步表明,当期望回报接近上界时,识别真实改善所需的最坏情况评估成本会发散。在连续更新中,已认证的改进保证能够在有限运行内累加,但一次成功更新本身不保证仍能继续改善。这些结果为诊断瓶颈与设计更安全的自我演化机制提供了基础。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08175v1;v1 首次提交:2026-09-08 03:04:39 UTC=2026-09-08 11:04:39 北京时间。 已核对:v1 Introduction、§2–3.1、§6.3 与主要结论;摘要按 arXiv 官方页面口径,未逐条复核附录证明。 官方页面 · v1 PDF。
评测数据集与环境。 DS-1000、WorkBuddy–DSH 验收审计协议。DS-1000先排pilot再取480题,生成/低高预算认证/独立审计隔离;WorkBuddy–DSH gate20题、audit40题,每题每Agent取3个有效尝试(§6.3、Appendix I.3.4–I.3.5)。 实验/附录依据。
When Validation Stops Learning:零退化也可能来自什么都不学
作者: Ma, Qinzhen、Wu, Ruihai
机构: Rice University;University of California, Berkeley。(署名依据:v1,第 1 页)
任务背景。 论文用一个简单的推物模拟来研究更新验收:系统看到物体需要移动多远,选择一次推力,最后检查物体是否到达允许误差内。训练会提出新的控制办法,验收程序决定是否用新版替换旧版。好的验收既要拦住会使旧任务退步的改法,也要给有效改法通过的机会,研究者因此要同时检查这两种结果。
一个更新门禁从不放行,当然也从不放进坏更新。只看“没有退化”会把完全停止学习误判为可靠。
核心方案。 作者先将候选生成、开发筛选和正式验收分开。候选更新经过开发阶段的代理模型筛选后,就固定下来,同时固定用于比较的历史版本和任务条件。正式验收使用新收集的环境试验结果,让候选与参考版本在配对条件下运行,直接观察哪些试验变好、哪些变差。
有了这些胜负记录,方法可以构造二项统计区间,判断现有证据是否足以放行。如果两个版本在旧任务上几乎做得一样,配对结果就能利用这一点,比只依据回报取值范围给出的统计界节省验证样本。论文还检查验收是否错失改进机会:以一整轮候选池为单位,只有池中存在合格更新、却一个也没有采用,才算漏掉机会。这样,正常地从多个好候选中择一,就不会被误算成失败。
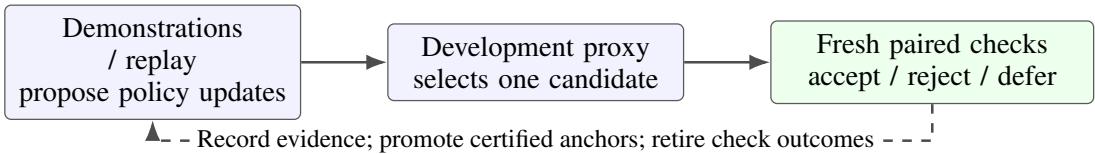
读图。 从左向右看,系统先依据示范和历史回放提出更新,再用开发阶段的代理模型筛选,最后进入需要新鲜环境试验的验收阶段。候选与参考版本的配对结果会支持三种决定:接受、拒绝,或者暂时证据不足,延后决定。图中这三段分工,是理解“提出了好修改”和“证明了可以采用”为什么不同的关键。
底部保存验收证据,以及已经通过认证、可供以后比较的历史版本。用于事后检查整个候选池的审计结果不返回学习流程,因此下一轮改进不能提前利用这份评估答案。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……质检既要查有没有放过次品,也要查是不是把合格品全挡在门外。新增的是可运行的门禁诊断与机会审计,不是发明置信区间,也没有证明比直接 replay 更会学习。
贡献与证据边界。 Figure 2(第 3 页)同一候选流、每阶段 2,000 episode 下,新鲜成对检查接受 81/256=31.6%,Hoeffding 门禁为零。Table 1 的闭环实验却显示成对门禁最终成功率 59.6%,无条件 replay 为 100%,仍错失 60.4% 可用机会。32 seeds 的一步推物模拟专门构造低分歧情形;没有实体机器人或 VLA 验证。给代理模型换随机种子仍不能消除世界模型偏差。 原始全文。
[!abstract]- Abstract 完整中文翻译 独立评估可以拒绝有害策略更新,却也可能阻止有益的持续学习。我们主张,必须在明确的交互预算下,同时从错误控制和保留下来的学习机会评估更新准入。我们指出一种具体失败:基于取值范围的置信门禁,即使有看似充足的预算,也无法认证旧任务行为保持不变。在结果分歧很少时,标准的成对二项构造能降低这一负担。我们还规定了经认证的历史参考提升方式和轮次级机会漏失指标。在一个包含 32 个随机种子的构造性一步推物诊断中,每阶段 2,000 个 episode 时,新鲜成对检查接受共同更新流的 31.6%,基于范围的门禁为零;但无条件 replay 在闭环运行中仍学得更好。另一项学习动力学压力测试区分模型偏差与反馈选择错误。本文贡献是一个具有分析与合成实验证据的准入审计协议,实体机器人和 VLA 验证仍待完成。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.10873v1;v1 首次提交:2026-09-09 22:25:16 UTC=2026-09-10 06:25:16 北京时间。 已核对:v1 §1–4、Algorithm 1、Figures 1–2、Table 1。 官方页面 · v1 PDF。
评测数据集与环境。 When Validation Stops Learning — 一步推物模拟。论文自建一步模拟,10顺序任务、32seeds;2,000 episode是阶段重采样预算,非独立题库规模;测接受率与闭环成功/机会漏失(§3)。 实验/附录依据。
FEEs:先给行动提示,再让环境提供更完整的观察
- Environments as Scaffold: Enriching Feedback to Bootstrap Self-Evolving Agents in Long-Horizon Tasks
作者: Yuan, Hongbang、Jin, Zhuoran、Cao, Yixin
机构: Fudan University;CASIA;Shanghai Innovation Institute。(署名依据:v1,第 1 页)
任务背景。 例如让 Agent 在模拟实验室完成一项实验:它收到目标,查看所在位置和物品,移动、取用器材并执行操作,直到达到任务要求。训练靠实际执行结果提供反馈,但新手可能一直找不到正确路径,连一次成功都遇不到。本文研究训练环境可以怎样提供临时帮助,让模型先有机会学起来,再检查撤掉帮助后能否独立完成任务。
Agent 总在实验室任务中走错房间,直到预算耗尽都拿不到奖励。怎样帮助它探索,又不让测试时必须继续依赖提示?
核心方案。 FEEs 在训练环境中提供两种帮助,让 Agent 更容易走出能够获得反馈的执行过程。第一种是在行动前给方向,帮助它缩小下一步的搜索范围;第二种是在工具返回后补充环境状态,让它更清楚当前进展。前者适合 Agent 还不知道怎么开始的时候,后者则帮助已经开始行动的 Agent 判断接下来该怎么做。
论文在两个时间尺度上安排这些帮助。一次任务执行内部,要决定提示出现在较早还是较晚的步骤;整个训练进程中,也要逐渐改变帮助方式。主实验前一百个训练步骤侧重任务早期的行动提示,后一百步转向任务较晚阶段的观察增强。由这些交互产生的奖励用于更新模型,方法分别结合了 GRPO、GSPO 和 DAPO。最终评估撤掉额外帮助,并使用与训练不相交的任务,检查模型独立执行时的表现。
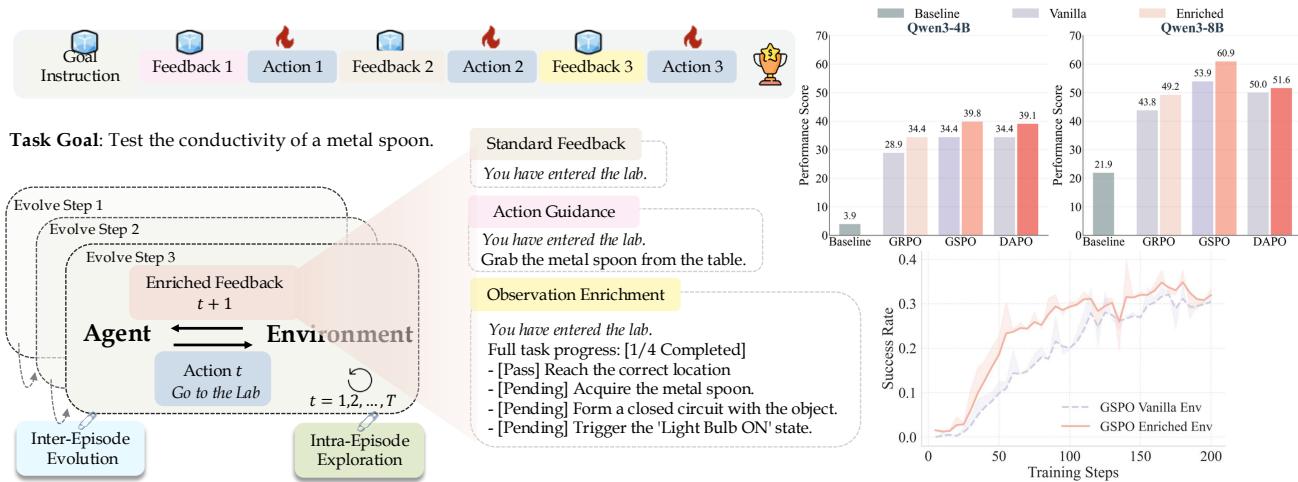
读图。 先看 Agent 与环境之间的往返:Agent 选择动作,环境返回结果,这些信息又影响下一步决策。图中的两类帮助插在不同位置。行动提示在决策前提供方向,观察增强则让执行后的返回信息更完整;可以结合中间的任务例子,分别看它们改变了 Agent 当时能得到什么信息。
再把这段交互放回训练过程:额外帮助使 Agent 更容易产生有反馈的执行记录,训练算法再据此更新模型。最终标准环境测试会撤掉这些帮助,因此图中“训练时借助环境获得的信息”与“训练后模型能够独立完成的行为”需要分开理解。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……先告诉学生去对的实验室,再把仪器状态显示清楚,最后撤掉帮助看能否独立做。贡献是把辅助放到环境反馈及课程里,并检查组内反馈一致性;不是环境能自主设计下一代训练。
贡献与证据边界。 Table 1(第 6 页)有平均收益,也有缺参、缺工具任务退步;报告每五步评估后的峰值,不能称固定最终 checkpoint 的无偏泛化分数。§5.4 中同一 rollout 组对同一状态保持反馈一致,比组内随机混用稳定。Limitations 明确 AppWorld 仍卡在零奖励;提示设计与阶段划分依赖人工,效果不是普遍成立。 原始全文。
[!abstract]- Abstract 完整中文翻译 大语言模型在静态推理上表现出色,但通过强化学习将其训练成自主 Agent 时,长程任务往往受到严重奖励稀疏的阻碍。传统通过监督微调进行 Agent 侧预热虽能缓解问题,却常受数据稀缺和探索受限影响。为此,我们转向环境侧适应,构建反馈增强环境(FEEs)。通过先导研究,我们确立了一种反馈设计策略:在单个 episode 的探索后期与跨 episode 的演化后期,逐步从行动指导转向观察增强。利用不同规模 Qwen3 模型,以及 GRPO、GSPO、DAPO 等 RL 算法,在 SciWorld 与 BFCL 基准上的大规模实验表明,FEEs 相对标准设置持续带来性能改善。进一步分析显示,FEEs 训练能够:(1)减少熵波动,使训练更稳定;(2)促进困难任务中的主动状态空间探索;(3)使环境指导被内化到策略权重,而非仅作为推理时先验;(4)揭示组内反馈一致性是稳定优化的重要边界。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08404v1;v1 首次提交:2026-09-08 08:14:25 UTC=2026-09-08 16:14:25 北京时间。 已核对:v1 Introduction、§3–5、Table 1、Figures 1/5/6、Limitations。 官方页面 · v1 PDF。
评测数据集与环境。 ScienceWorld / SciWorld、BFCL V3 多轮函数调用、AppWorld。主实验ScienceWorld与BFCL-V3,后者训练Gorilla File System/Vehicle Control,留出Trading Bots/Travel Booking;测试撤辅助。AppWorld另报告零奖励失败(§5、Limitations、Appendix A)。 实验/附录依据。
ExecCritic:先学会生成好测试,再学会利用测试修复
作者: Tao, Leitian、Peng, Baolin、Wang, Haorui、Wang, Hang、Cheng, Hao、Yao, Wenlin、Wu, Qianhui、Ge, Tao、Li, Sharon、Gao, Jianfeng
机构: University of Wisconsin–Madison;Microsoft Research;Georgia Tech。(署名依据:v1,第 1 页)
任务背景。 修复代码仓库时,Agent 拿到问题描述和源码,要提交真正解决故障的补丁。它还需要测试来发现问题、检查修复,但测试本身也可能写错。这里把工作拆成两件事:一个角色写出能发现故障的测试,另一个角色依据反馈修代码。本文分别训练这两个角色,最后检查生成的测试有没有帮助,以及补丁是否真正解决了任务。
Agent 写的补丁与自己写的测试可能恰好犯同一个错误,于是本地全绿,真实问题却没解决。
核心方案。 ExecCritic 将写测试和修代码交给两个分别训练的 Agent。测试 Agent 提交测试内容、执行命令和需要检查的行为要求,系统核验后把测试固定下来;修复 Agent 随后只能修改源码,根据测试执行结果继续修复。这样,修复过程中使用的反馈有一个稳定的来源。
测试 Agent 先做监督微调,再用 GRPO 学习怎样写出有区分力的测试:测试应该在原始错误代码上失败,在正确修复上通过,还要能够区分其他候选补丁的好坏。修复 Agent 则学习两种行为,一种是首次就把问题解决,另一种是在收到固定测试反馈后改正错误。两种角色都更新模型参数,但分别训练;其中修复器的主要训练设置使用已知的失败转通过测试作为反馈,评测时再检验它能否利用测试 Agent 生成的测试。
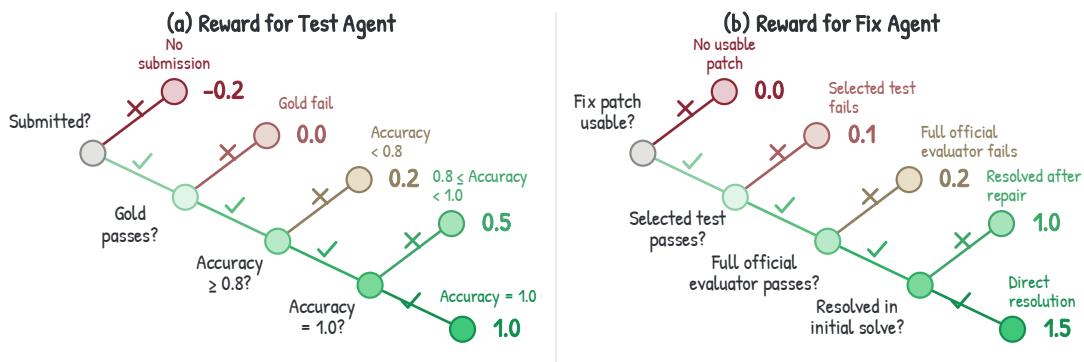
读图。 图左侧讲的是怎样给测试 Agent 奖励。这里已经默认测试在原始错误代码 Base 上正常运行并检出失败,接着检查它能否让正确修复 Gold 通过,再看它区分其他补丁好坏的能力。因此,一个把所有补丁都判错的测试,不能仅凭检出原始错误就获得高评价。
右侧讲修复 Agent 的训练:先判断补丁是否可用,再检查选定测试和完整官方测试的结果,并区分首次直接解决与根据反馈修正后的成功。两侧奖励分别用于训练两个角色。Gold 和官方测试标签属于离线评分依据,测试 Agent 生成测试时看不到这些答案;图中的训练反馈也需与评测时实际生成的测试区分。
原图:v1,Figure 4,PDF 第 6 页;原文定位。
这不就是……先训练一个不受当前补丁影响的出题人,再训练维修员听懂测试失败。新增的是测试行为有效性与修复目标分别训练;测试能运行、能让旧代码失败,仍不足以保证测试本身正确。
贡献与证据边界。 Table 2(第 11 页)固定基座修复器时,基座测试使解决率 61.2%→57.3%,RL 测试为 64.1%;两个训练后角色组合为 72.6%。训练后修复器不加测试已达 68.3%,因此 11.4 个百分点总增益不是全部来自反馈使用。§4.2 主训练使用 Oracle F2P 测试,评测才换生成测试;不能写成训练与测试都不使用特权反馈。修复可多次尝试,测试生成成本也需单独计入。 原始全文。
[!abstract]- Abstract 完整中文翻译 执行反馈能够引导代码 Agent 正确修复仓库,但前提是测试捕捉了 issue 要求的行为。Agent 生成的测试可能包含不完整或错误目标;同一轨迹同时编写补丁和测试时,两者错误可能互相吻合,造成虚假信心。我们提出 ExecCritic,结合测试—验证—修订结构与按角色设计的强化学习训练方案。该结构分离测试构建与源码修复:Test Agent 独立生成仓库原生测试,由默认拒绝不合格结果的 Harness 核验并冻结;Repair Agent 根据其执行反馈修订源码,不能修改测试。两种角色都使用 Qwen-3.5-35B-A3B,并分别训练。在 Learn to Test 中,测试器学习生成行为有效且能区分正确与错误补丁的测试;在 Test to Improve 中,修复器同时学习直接解题与反馈引导修订。在 SWE-bench Verified 上,测试质量决定反馈有益还是有害:固定基座修复器时,基座测试器使解决率从无测试的 61.2% 降至 57.3%,GPT-5.6-sol 测试则提高至 65.3%。角色专用后训练使 Qwen 测试器 Base-to-Gold 成功率从 22.2% 提高至 62.2%;组合两个后训练 Qwen Agent 达到 72.6%,比初始无测试基线高 11.4 个百分点,评测时无需更强模型或 Oracle 反馈。代码已公开于 代码仓库。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.09133v1;v1 首次提交:2026-09-08 17:53:37 UTC=2026-09-09 01:53:37 北京时间。 已核对:v1 Introduction、§3–5.3、Figure 4、Tables 1–3。 官方页面 · v1 PDF。
评测数据集与环境。 SWE-bench Verified、SWE-bench Pro — Public。测试生成与修复的执行评测;同一生成测试包被三个Repair运行复用,报告全分母resolved rate;训练Oracle F2P与评测生成测试分开(§4–5、Appendix A.3)。 实验/附录依据。
SkillAdam:记住修订历史,并控制每轮改动大小
作者: Li, Gaoyuan、Fan, Meihao、Liu, Yizhe、Zhang, Shaolei、Fan, Ju、Wang, Siyi、Hou, Jiaheng、Weng, Xudong、Tian, Honghan、Li, Zang
机构: Renmin University of China;Tencent。(署名依据:v1,第 1 页)
任务背景。 例如让 Agent 根据文档回答问题,可以给它一份说明,提醒它怎样查找信息、核对答案。这里的“技能”就是这样的文字做法;改好技能,应该让后续任务更容易做对。每次遇到新错误都可能需要修订说明,但还要保住之前有效的内容。本文关心怎样记住修订经验,并控制一次改动的范围。
上轮才修好的技能规则,这轮又被新案例覆盖;一次改太多还让原本能做的任务失败。
核心方案。 SkillAdam 为技能修订保留一份持续更新的问题记录:出了什么错、目前是否解决、试过哪些改法、结果怎样。后续修改先参考这份记录,使尚未解决的问题能够被继续跟进,也让已经失败的尝试留下依据。
每次提出新版技能后,系统让新旧版本在同一小批任务上运行,检查改善是否稳定。如果有的案例明显变好、有的却变差,就缩小下一轮允许修改的范围,让后续调整更谨慎。候选还要通过该任务规定的接受条件才会保留。这里借用了 Adam 根据历史调整更新的思路,但实际被修改的是技能文本,问题记录和结果波动分别影响改什么、一次改多少。
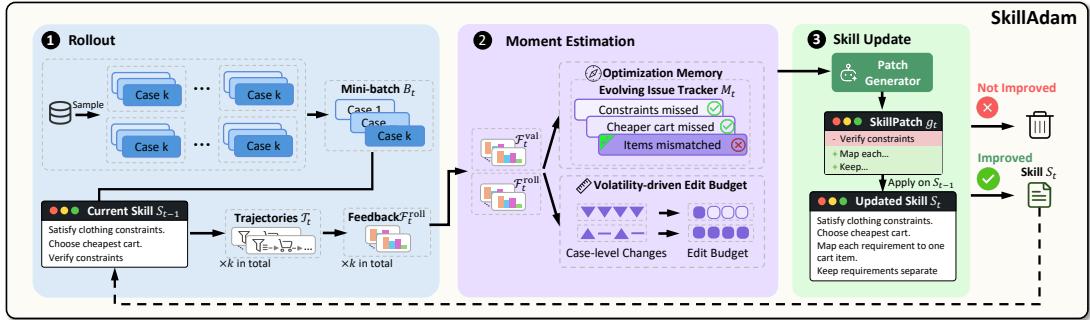
读图。 这张图截取了 Figure 2(b) 中的 SkillAdam 流程。先从执行记录看起:问题追踪器保存错误和修订历史,帮助确定后续要处理的问题;另一部分比较各案例的改善情况,估计结果有多不稳定,再据此控制下一次技能编辑的范围。提出的新技能还要接受评估,决定留下还是撤回。
图中的模块表示各自承担的功能,阅读时要把前后两轮接起来:本轮试跑得到的改善情况,主要用于调整下一轮的修改预算。系统在尚未评估本轮候选时,并不知道它会带来多大的波动。
原图:v1,Figure 2(b),PDF 第 3 页;原文定位。
这不就是……用维修工单记住哪些办法试过,再根据最近修补是否牵一发动全身决定下次改多大。新增的是跨轮优化状态;问题列表不是 Adam 的一阶矩,波动预算也不具有原算法的数学等价性。
贡献与证据边界。 Tables 2–3(第 10 页)多数短任务增量较小,DeepPlanning 平均约从 21.7 到 28.3。§5.3:作者合并原 train 与 selection 池,而 SkillOpt 保持原划分;候选接受用当前同一批优化样本,没有额外独立验证集。测试样本每题一次,较小提升需谨慎;增加修订记忆并不证明优化器自身递归改进。 原始全文。
[!abstract]- Abstract 完整中文翻译 Agent 技能为冻结的语言模型提供领域知识与程序指导,是一种轻量方式,但高质量技能仍昂贵且难以规模化。专家编写技能需要大量人工。近期技能自我演化方法自动使用执行反馈迭代修订技能,却因启发式更新而经常优化不稳定、迭代效率低。我们识别出两个挑战:方向稳定性要求有效纠正能够累积,而不被当前轮反馈覆盖;更新适应性要求每次修订范围反映近期逐案例改善的一致程度。我们提出受 Adam 启发的 SkillAdam,用于优化离散、不可微的技能文档。作为 Adam 一阶矩的功能类比,优化记忆保存已识别问题和先前解决尝试的结果,使更新方向稳定;作为二阶矩的功能类比,由波动驱动的编辑预算跟踪近期案例改善的历史加权变化,自适应控制更新幅度。在七项涵盖短程与长程任务的基准上,SkillAdam 取得先进表现和更稳定的优化动态,并以显著更少的优化轮次和更低成本得到更强技能。代码仓库:代码仓库。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08944v1;v1 首次提交:2026-09-08 16:04:45 UTC=2026-09-09 00:04:45 北京时间。 已核对:v1 Introduction、§4、§5.3–5.5、Algorithm 1、Tables 2–4。 官方页面 · v1 PDF。
评测数据集与环境。 SearchQA、SpreadsheetBench、OfficeQA、DocVQA、LiveMathematicianBench、ALFWorld、DeepPlanning。七基准十切片;DeepPlanning Shopping25/25/10、Travel60,按论文定义聚合;其余保留原生EM/ANLS-hard/任务完成率(§5.1–5.3)。 实验/附录依据。
RobustSGPO:控制改哪里,也保留暂时落后的搜索分支
作者: Zhao, Zibo、Shi, Jijun、Zhou, Mo、Wang, Zhongyuan、Bie, Shifu、Zhang, Yunfei、Zhou, Xuanting、Wu, Xiangyu、Liu, Bin、Tang, Ruiming、Ou, Wenwu、Gai, Kun
机构: Wuhan University;Kuaishou Technology。(署名依据:v1,第 1 页)
任务背景。 假设一项工作由多个 Agent 接力:一个收集信息,一个处理信息,后一个再生成交付结果。系统接收用户要求,通过这些角色和工具共同完成任务,最终检查事情是否办成、产物质量如何。本文把整套工作流程当作可修改对象,寻找更好的分工和连接方式;修改还必须保持前后步骤能够正确配合。
改一个 Agent 的输出字段还不够,消费它的另一个 Agent 也要一起改;自由编辑很容易漏改或越界。
核心方案。 RobustSGPO 在生成修改内容之前,先确定要改多大范围、执行哪类操作,以及具体修改哪些对象。这样,提出方案的模型有了明确边界。生成后,系统检查实际改动是否与选定对象一致;涉及结构性增加或删除的操作,则交给固定程序完成。这些检查保证修改符合指定范围,是否有助于任务仍要通过执行来判断。
搜索过程中,一些有效版本虽然暂时没有超过当前最优版本,也会按类别保存。以后可以从这些版本继续尝试,避免搜索始终局限在同一条路径上。不过,从历史分支产生的新版本,仍须超过当前正在使用的最优版本才能被采用。任务变化后,对保留版本重新评分的开销也计入搜索成本。
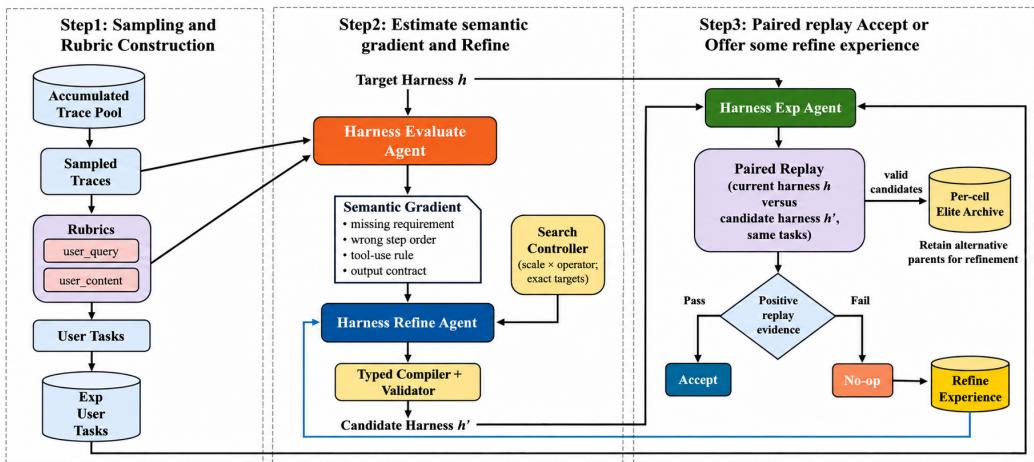
读图。 沿图中从失败诊断到生成修改的流程看,先留意新增的搜索控制器:它决定本次编辑的范围、操作和对象。接着,构造与检查模块把这份选择变成实际修改,并核对改动是否符合要求。完成修改后,系统还要通过任务回放比较表现,才能决定是否替换当前最优版本。
图中保留的历史版本为之后的搜索提供了其他起点。理解这条分支时,要把“允许留下继续探索”和“允许上线使用”分开:一个版本可以暂时落后,但从它继续修改得到的候选,仍需超过当前最优版本。这里选用 Figure 3,是因为前两张图主要介绍前作背景。
原图:v1,Figure 3,PDF 第 3 页;原文定位。
这不就是……先开清楚维修工单,再检查动了哪些零件,同时保存可能有后劲的试制版。贡献是把修改请求、实际可执行补丁和未来起点拆开控制;编译通过不等于任务语义正确。
贡献与证据边界。 §6 使用按来源分组的 60/30/30 优化、验证、测试任务,5 个配对 seeds;无效补丁、回放、judge 与存档开销计入预算。固定 20M token 下完成率 60%→80%、质量 3.77→4.14;周期权限调度另有受控比较。跨任务族时类别保留更能保护源任务,但随机保留可有更高目标终点,不能宣称所有维度都赢。只验证一个 AgentX 工作流。 原始全文。
[!abstract]- Abstract 完整中文翻译 基于语义梯度的提示优化(SGPO)利用执行反馈改善 Agent Harness,但局部更新规则没有解决编辑范围和操作选择。我们提出 RobustSGPO,明确请求的编辑、构造并检查补丁,并从当前版本或保留快照继续搜索。我们在 AgentX 头脑风暴工作流中评估权限调度、累积控制与任务族迁移,共包含 120 个任务、95 次运行和 7,350 次候选尝试。周期性 1→2→3 调度比固定最大权限高 0.28 个测试分。20M token 预算下,RobustSGPO 将 30 个留出任务的完成率从 60.0% 提高至 80.0%,测试质量从 3.77 提高至 4.14。类别保留减少任务变化后的源任务退化,随机保留则达到更高的目标任务终点。搜索空间控制通过可执行编辑与备选起点改善质量,同时带来可测量的保留开销。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.09646v1;v1 首次提交:2026-09-09 03:00:03 UTC=2026-09-09 11:00:03 北京时间。 已核对:v1 Introduction、§5–6、Figure 3、Tables 1–2;费用与效果按固定预算口径。 官方页面 · v1 PDF。
评测数据集与环境。 RobustSGPO — AgentX工作流任务集。120任务按来源分组后60/30/30优化/验证/测试,5个配对seeds;报告完成率和judge质量并计入搜索开销(§6)。 实验/附录依据。
Consistency Guidelines:从偶尔成功变成重复执行也可靠
作者: Duesterwald, Evelyn、Elder, Benjamin、Ngweta, Lilian、Ubaru, Shashanka、Zimon, Malgorzata
机构: IBM Software Innovation Lab;IBM Research。(署名依据:v1,第 1 页)
任务背景。 例如让 Agent 在应用中查记录并完成一项操作:它拿到用户要求,通过接口读取和修改数据,最后检查结果是否满足要求。即使请求相同,模型每次选择的工具和参数也可能不同。本文关心的是反复执行时的可靠性,希望从过去的执行记录中整理操作指南,让同一类任务更稳定地做成。
同一道工具任务跑五次,有一次失败。平均成功率看着不错,却不一定适合重复使用。
核心方案。 这篇论文从一次看似成功的执行中寻找不稳定因素。系统回到记录下来的决策点,重新提供当时的提示,多次采样模型会采取的动作,再比较它选择的 API 和参数。如果相同情境下的选择反复变化,这一步就可能是下次执行偏离正确路线的位置,即使本次任务已经成功,也值得检查。
分析器据此生成针对性的操作指南,写入已有的情节记忆系统。后续任务可以检索这些指南,在容易摇摆的步骤获得更明确的指导。循环积累的是外部指南,模型参数、分析器和记忆框架本身保持固定。方法希望提高重复执行的可靠性,而判断行为是否正确,仍需结合任务结果。
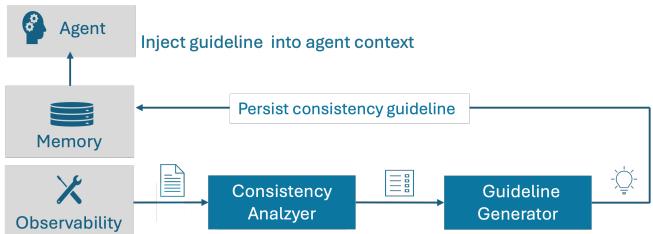
读图。 从检测环节 Detect 看起:系统利用已记录的执行过程,在各个决策点重复采样,找出动作选择容易变化的位置。随后,生成环节 Generate 根据这些位置编写指南,把“哪里不稳定”的分析转成后续执行时可以使用的建议。指南进入记忆后,Agent 在下一次相关任务中检索使用。
顺着返回路径看,可以发现这次执行提供了两类信息:任务有没有完成,以及相同情境下模型会不会反复改变选择。图中的循环据此更新指南,让经验在后续任务中保留下来;它没有训练底层模型。
原图:v1,Figure 1,PDF 第 1 页;原文定位。
这不就是……不只复盘做错的地方,也找出“这次碰巧选对”的岔路口,写成以后可复用的提醒。贡献在决定提炼哪些经验,记忆存取主要沿用既有系统。
贡献与证据边界。 AppWorld 上 GPT-4.1 五次全成功的 Pass^5 从 53% 到 69%;相似任务变体提升 13 个百分点,不是跨领域泛化。每决策点默认 30 次重采样,离线分析 token 成本约放大 30 倍。分析器衡量稳定性,稳定地答错仍可能高分;平台侧随机性也无法完全控制。 原始全文。
[!abstract]- Abstract 完整中文翻译 由大语言模型驱动的 Agent 可能平均准确,却在实际使用中不可靠,这一差异已被观察到,但仍缺乏充分解决。对同一任务运行五次时,使用 GPT-4.1 的 ReAct Agent 在 AppWorld 上五次全部成功的比例仅 53%,而单次平均成功率为 77%。我们把这 24 个百分点的差距称为一致性差距,并认为解决它是可信 Agent 部署的前提。我们提出一个自我演化 Agent 框架,通过识别轨迹中不稳定、低一致性的步骤,并将它们转成未来运行可用的情节记忆来缩小差距。核心的一致性分析器定位轨迹在重复执行中可能发生变化的位置与原因,指南生成器将诊断转为有针对性的指导,写入记忆并注入未来相似任务的执行。在 AppWorld、ReAct/GPT-4.1 设置下,该框架把五次全部成功的任务比例在同任务评测中提高 16 个百分点,在相似任务泛化中提高 13 个百分点。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.08832v1;v1 首次提交:2026-09-08 14:53:43 UTC=2026-09-08 22:53:43 北京时间。 已核对:v1 Introduction、§3–4、Figure 1、Appendix B、Limitations。 官方页面 · v1 PDF。
评测数据集与环境。 AppWorld。test_normal 168任务,每题5次;同时报告Mean@5与全部五次成功Pass^5。相似任务变体不作为跨领域迁移(§4)。 实验/附录依据。
Grounding Agent Memory:写经验前回到环境查一次
作者: Suresh, Susheel、Mak, Hazel、Bhatnagar, Sahil、Methani, Chhaya、Munoz, Alejandro Gutierrez
机构: Microsoft Corporation。(署名依据:v1,第 1 页)
任务背景。 以连续处理数据库问题为例:Agent 接收问题,查询表结构和数据,给出符合要求的结果。上一题中发现的字段含义、查询方法可以记下来,供下一题使用;但环境可能变化,一次碰巧成功的做法也未必通用。本文要让写入记忆的经验经得起核实,最终看这些记忆能否帮助后续任务做对。
一次成功轨迹里也可能夹带错误假设;数据库字段已经变了,旧记忆还在教下一次 Agent 用旧字段。
核心方案。 Grounding Agent Memory 在任务结束后增加一次事实核实。独立的整理 Agent 读取刚才的执行过程、任务结果和旧记忆,提出值得保留的经验,再回到环境中用只读工具检查:这条事实是否成立,操作是否依赖某个前提,原先的记忆是否已经过期。核实后,它可以新增经验,也可以缩小适用范围、修订或删除旧条目。
整理会在下一项任务开始前完成,而且整理器看不到未来任务。执行任务的 Agent 只读取记忆,记忆的写入由整理器负责。这样,刚才的成功与失败有机会变成经环境核实的经验,再被后续任务使用;这轮改进保存在记忆库中。
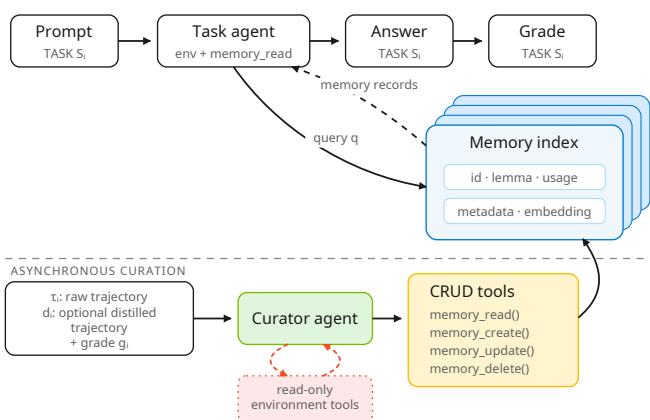
读图。 先看横向虚线以上的任务执行部分。Agent 在环境中完成任务,同时读取已有记忆,最后得到结果与反馈。再转到虚线以下,整理器接收这段执行记录,开始决定哪些经验值得写回。
图中新增加的往返路径,是整理器回到环境核实信息的过程。它只能查询,不能修改任务环境;确认后的内容才进入记忆更新,并在下一项任务中供 Agent 读取。沿这条路径看,经验经历了“从执行中提出”到“在环境中核实”这一步,而整理器始终无法提前看到下一道任务。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……写工作笔记前,先回系统查证“这个字段真存在吗、这条规则是否只适用当时那个例子”。新增的是整理阶段的有限环境探查,而不是把整段历史都塞回上下文。
贡献与证据边界。 Table 1(第 5 页)CLBench:无记忆 39%,原记忆 70%,加探查 73%;不能把全部 34 个百分点都归因于探查。五次运行误差较宽;成本表只计任务 Agent,排除蒸馏与整理,1.68 美元不是整套系统总成本。逐任务流包含 schema drift,但不足以代表任意长期部署漂移。 原始全文。
[!abstract]- Abstract 完整中文翻译 持久记忆正进入面向生产的 Agent 平台,帮助长程 Agent 跨会话积累经验。但任务后整理器如果只能读取已结束轨迹,可能保留错误、过度推广局部证据或保存过时知识。我们提出环境探查式整理,作为兼容部署的扩展,为现有异步整理 Agent 提供最小权限的只读世界工具,以检查、限定与刷新候选记忆。它无需重新训练模型,保持任务 Agent、检索器、记忆表示和生产写入权限不变。在基于 GitHub Copilot SDK 的近生产 Harness 中,我们在 CLBench 数据库探索及 90 个改编 APEX 管理咨询任务上,比较无状态执行、完整上下文学习、GHCP+Mem 与加入环境探查的版本。在 CLBench,相对无记忆基线,探查版本使通过率从 39% 提高至 73%、按通过折算的回报从 8.60 提高至 22.60,同时每题查询从 8.8 降至 4.7,任务 Agent 成本从 3.38 美元降至 1.68 美元。在六个 APEX 世界中,18 项记忆与基线的平均回报比较均为正,任务 Agent 工具调用减少 16–75%;探查在五个世界取得最佳单位任务 Agent 成本收益。在无 schema 漂移的 Sonnet 4.6 与 Opus 4.7 上,探查也比 GHCP+Mem 取得更高平均回报。因此,环境探查把已有记忆整理变成考虑环境、可审计的过程,同时保留紧凑的任务时接口。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.11060v1;v1 首次提交:2026-09-10 04:06:16 UTC=2026-09-10 12:06:16 北京时间。 已核对:v1 Introduction、§3–5.1、Figure 1、Table 1。 官方页面 · v1 PDF。
评测数据集与环境。 CLBench — 数据库探索与schema漂移、APEX — 环境探查论文适配集。CLBench为40题漂移/30题无漂移流,APEX适配90任务/6世界;测strict pass与成本折扣,task-agent账单不含整理成本(§4)。 实验/附录依据。
Ecdysis:先区分模型短板和通用 Harness 缺陷
作者: Yue, Ruiqing、Cui, Yu、Sun, Zhuoyu、Pan, Sicheng、Xue, Xianhong、Li, Tingyu、Li, Ting、Zhu, Wenzhuo、Chen, Yi、Liu, Yifei、Huang, Baohan、Cui, Zhe、Zhang, Haibin、Zuo, Cong
机构: Chengdu Institute of Computer Applications, Chinese Academy of Sciences;University of Chinese Academy of Sciences;Beijing Institute of Technology;Beijing University of Technology;Yangtze Delta Region Institute of Tsinghua University, Zhejiang;Jiaxing Key Laboratory of Artificial Intelligence and Cyber Resilience。(署名依据:v1,第 1 页)
任务背景。 以客服办理业务为例:Agent 拿到用户诉求,需要调用工具查询情况、执行操作,再确认任务完成。模型外面的执行框架(Harness)负责组织对话、工具和上下文,它的缺陷也会让任务失败。本文希望通过多次执行定位并修复这些共性问题,使同一个模型在改进后的框架里更可靠地办事。
每遇到一个失败就给 Harness 补一条规则,最终可能只是迁就某个模型,且越来越慢。
核心方案。 Ecdysis 先固定执行任务的模型和环境,让 Agent 跑一批任务,再汇总失败过程。它优先寻找至少在两项不同任务中重复出现的问题,尝试判断这些失败是否指向共同的 Harness 缺陷。这样,下一次修改有机会解决反复发生的问题,而不只针对某一道题调整流程。
随后,分析、质疑、工程设计和裁决等角色依次处理这些证据,形成具体的修改说明,再由代码 Agent 实现。新版 Harness 在训练任务上的总体分数提高后才会被采用,并进入下一轮执行和诊断。这里的验收依据是训练集表现,方法没有设置独立验证集来接受更新。
核心方案图。 v1 没有合适的独立方法图。可以顺着正文 Algorithm 1 阅读上述循环,重点看一批任务的失败怎样汇总成一次修改,以及修改后如何决定是否保留。原始 PDF。
这不就是……把同一批报修单一起看,先判断是机器共性故障还是某位操作者不会用,再开一张维修单。新增的是批次级诊断;并不是多加几个角色就获得更好的信用分配。
贡献与证据边界。 §5.2 的平均准确率:顺序演化 SE 46.67%,批次聚合 54.67%,再加协作诊断 59.33%。§5.3 完整方案在两个子集训练加速 1.30×/1.84×;收益主要来自减少重复修改调用。每子集仅 20 训练、20 测试任务,接受门禁用训练集而非独立验证集。网页摘要 18.56% 的口径与正文主比较 27.1% 不同,本页不混用。原文未找到核心方案图,方法以 Algorithm 1 为主,不拿成绩表代替。 原始全文。
[!abstract]- Abstract 完整中文翻译 自我演化的运行时 Harness 可以显著增强 LLM Agent 能力,是优化 Agent 执行的有前景范式。现有方法通常依赖迭代搜索,根据任务实例执行反馈反复评估和修订候选 Harness。该范式虽支持持续优化,却因重复 Agent 执行与代码修改产生大量时间开销,还可能过拟合已观察任务和特定失败模式,降低未见任务泛化。我们发现,缺乏有原则的失败诊断是核心瓶颈:同一失败可能反映模型特定缺陷,也可能反映系统性 Harness 缺陷,直接针对个别失败优化会造成不必要的模型特定迁就。为此提出 Ecdysis,区分模型特定适配与 Harness 层修复,并通过识别跨任务重复失败模式,使适应偏向系统性缺陷。Ecdysis 采用批次级跨实例失败聚合,联合分析多个任务的失败证据,进一步引入失败驱动协作修订,诊断原因并迭代完善 Harness 修改规范。结合跨实例分析与多角色诊断,Ecdysis 以更短训练时间实现更有效演化。实验报告相对现有方法最多 1.84 倍训练加速,并使所得 Harness 推理准确率提高 18.56%。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.11677v1;v1 首次提交:2026-09-10 15:09:08 UTC=2026-09-10 23:09:08 北京时间。 已核对:v1 Introduction、§3–5、Algorithm 1、Tables 1/4/6;摘要按官方页面,正文比较口径另列。 官方页面 · v1 PDF。
评测数据集与环境。 AgentBench、τ²-bench。AgentBench用于较简单任务(具体子环境/分母待补核);tau2 Airline/Retail各20训练+20测试,每题3次;训练集验收不能称独立验证(§5.1–5.3)。 实验/附录依据。
Synthetic Data Hurts:生成更多技能数据也可能损害检索
作者: Murtaza, Syed Shariyar、Nie, Yifan、Soni, Utkarsh、Wen, Eugene、Frydenlund, Arvid
机构: Manulife。(署名依据:v1,第 1 页)
任务背景。 假设用户交给 Agent 一项技术工作,技能库里有大量操作说明,需要先选出最有用的几份。承担这一步的检索模型收到任务描述,输出按相关程度排序的技能列表,以正确技能能否被找到、排得是否靠前来评价。本文研究用什么数据训练这个检索模型,以及增加合成的“任务—技能”配对后,它是否真的更会找技能。
合成了许多“任务—技能”配对,训练指标上升,实际任务需要的技能却更难找到了。
核心方案。 这篇论文检查一个直觉是否成立:给技能检索器增加大量合成训练数据,是否就能让它更会找技能?作者围绕 34,396 份技能准备了来自真实执行的监督和合成监督,通过 LoRA 微调检索器,用 InfoNCE 对比学习目标让相关任务与技能在表示空间中更接近,同时训练重排器来调整候选顺序。再比较不同数据来源对检索结果的影响。
问题在于,适应新训练数据时,检索器可能破坏原先已经有用的表示。因此,作者还比较了几种保留旧能力的约束:让新的向量表示靠近原表示、保留旧模型的输出行为、限制重要参数的改变,或约束参数偏离初始化的程度。它们分别对应 embedding anchor、LwF、EWC 和向初始化约束。实验关注的是这些措施能否在学习新分布的同时,减少原有检索能力的遗忘。
核心方案图。 v1 没有合适的独立方法图。理解这篇文章可以先抓住一组对照:使用真实执行数据或合成数据训练后,检索器在原有任务与新任务上分别怎样变化,再看保留旧能力的约束是否有帮助。具体实验位置见下方阅读依据。原始 PDF。
这不就是……题库越造越像自己出的题,检索器便更擅长“自家考题”,却忘了真实用户会怎么问。贡献是拆开真实、合成与域外评估,而非证明合成数据一概有害。
贡献与证据边界。 Table 2 中激进微调提高合成集 Recall@10,却使一组真实 OOD 从 0.85 降至 0.65/0.70。Table 3 的保守正则配置恢复到约 0.85;但 LoRA rank、学习率和更新层也一同改变,不能将全部恢复单独归因于正则项。真实评测组仅 21、10 题,统计功效有限。原文未找到核心流程图,本页不以表格冒充。 原始全文。
[!abstract]- Abstract 完整中文翻译 LLM Agent 越来越依赖运行时检索的外部技能,因此从大型仓库选择技能成为关键挑战。我们展示一个覆盖 34,396 个技能的生产型技能路由器,并研究在有限真实监督与合成数据下的大规模技能检索。我们发现,合成数据微调改善分布内检索,却导致真实与分布外数据上的灾难性遗忘。我们评估了受持续学习启发的多种遗忘缓解微调方法,包括 embedding anchor 正则、Learning without Forgetting(LwF)、Elastic Weight Consolidation(EWC)和 L2-initialization。结果显示,这些方法既能保持域外技能检索表现,也能使 0.6B Qwen 检索器与重排器在合成分布内技能上的检索改善 13.98%。我们的结果为稀缺、多正例监督提供了实用基准与稳健的微调方案。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.10750v1;v1 首次提交:2026-09-09 18:48:36 UTC=2026-09-10 02:48:36 北京时间。 已核对:v1 Introduction、§2.1/2.5、§4、Tables 1–3、Limitations。 官方页面 · v1 PDF。
评测数据集与环境。 Synthetic Data Hurts — 技能检索三环评测、SkillsBench、Terminal-Bench 2.0、BEIR 六集子套件(技能检索遗忘审查)。三环实际任务/query为21/2,414/10,技能库34,396;真实轨迹来自SkillsBench84任务与Terminal-Bench89任务,另用6个BEIR集查OOD遗忘,指标Recall@10/MRR@10(§3、Appendix E)。 实验/附录依据。
Code-to-Harness:把可执行搜索经验压成可迁移文字
作者: Wu, Yi、Ren, Zheng、Hu, Zhiyu、Wang, Haochen、Chang, Daryl、Wei, Li、Wang, Ting、Li, Zhen、Gupta, Pooja、Jindal, Nitin、Heldt, Lukasz
机构: Google。(署名依据:v1,第 1 页)
任务背景。 假设要调一组参数,只能提交参数组合、看到得分,看不到评分函数内部怎样计算。Agent 的工作是在有限次尝试内找到得分尽量好的组合;每次新选择都要参考先前试过什么、效果如何。这叫黑盒优化。本文让 Agent 先通过写程序练习怎样安排搜索,再把有效经验提炼成其他模型也能使用的文字说明。
Agent 能反复写优化程序、测哪个搜索策略好,但能否把学到的策略变成另一模型也会用的短说明?
核心方案。 Code-to-Harness 先让 Agent 在开发任务上练习黑盒优化:它看不到目标函数内部的规则,只能尝试输入、观察结果,因此需要学会怎样利用有限的尝试机会。开发阶段,Agent 反复编写和执行优化程序,在相同预算下比较新旧方案,保留表现更好的程序,同时记录失败尝试。
通过开发阶段的验证后,系统将这些程序实践中得到的经验一次性提炼成简短的文字 Harness。进入测试前,这段文本、解析器和推理设置都会固定下来。测试时,Agent 可以根据当前优化任务中新获得的结果调整下一次尝试,但不会再改写 Harness。因此,这里跨任务带走的是开发阶段提炼出的文字经验。
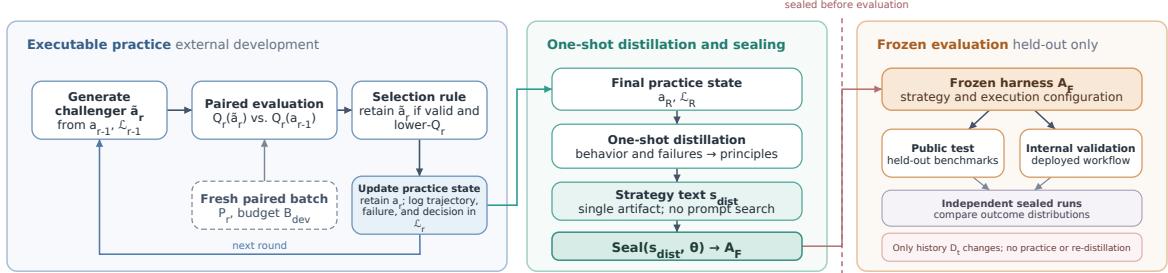
读图。 按从左到右的顺序看,左侧是开发阶段的程序练习:当前程序与新候选在同一批新目标上比较,代码和运行结果被保存下来。中间把积累的经验一次性提炼成文字,随后固定这套 Harness。走到右侧,才开始公开任务和内部任务上的评估。
图中最值得留意的是中间的阶段分隔。测试期间会继续积累当前任务的优化历史,但测试结果不返回左侧,用来反复修改已经封存的 Harness。这样,右侧检验的是开发经验能否迁移到新的优化任务。
原图:v1,Figure 1,PDF 第 2 页;原文定位。
这不就是……先亲手写程序练会找最优点,再把规律写成一张小抄给别的模型用。贡献是程序经验到文字策略的转移与封存验证,不是测试过程中持续自我修改。
贡献与证据边界。 §5.1 独立 30 样本实验中 Flash regret 69.5→36.0;三种未见 BBOB 地形均值下降,但校正后只有一种相对 Base 的差异显著,不能声称全面胜过贝叶斯优化。§5.3 同时报告独立通过的 Harness B 与未通过的 Candidate C。内部 YouTube 案例是单一历史数据上的重采样,非独立生产试验。官方页面标题为 Code-to-Harness,v1 PDF 标题为 Building the Harness Automatically,身份以同一 arXiv ID 核验。 原始全文。
[!abstract]- Abstract 完整中文翻译 Agent 能否通过可执行练习学习数值搜索策略,再以文字迁移这些策略?我们研究低预算黑盒优化,在此设置中,无辅助语言模型明显落后于强经典优化器。开发期间,Agent 反复编写并评估优化程序,随后将所得程序与练习记录一次性提炼成一份 197 词的主要 Harness A,并在评测前冻结。独立 N=30 实验中,Harness A 使 Gemini Flash 的 regret 降低 48%(p<.001),在练习函数族上进入 GP-BO 的表现区间,并在全部三种留出 BBOB 地形上降低平均 regret。同一文本改善全部受测 Gemini 执行器,并迁移到 Claude Sonnet,使 regret 降低 43% 和 49%(p≤.005)。独立端到端复现生成了不同程序与文本的 Harness B,达到相同表现层级。该框架还在封存的 YouTube 奖励调参生产基准上取得最低 regret。可执行练习因而是发现搜索策略的可行方式,语言则是部署策略的可迁移载体。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.09468v1;v1 首次提交:2026-09-08 21:33:55 UTC=2026-09-09 05:33:55 北京时间。 已核对:v1 Introduction、§3–5、Figures 1、Tables 1–3。 官方页面 · v1 PDF。
评测数据集与环境。 Code-to-Harness — 开发与独立重测函数族、BBOB — 黑盒优化函数套件、Code-to-Harness — 内部YouTube调参案例。实践族冻结后独立N=30重测、3种BBOB留出地形;内部YouTube仅一份历史数据的30次bootstrap。报告regret,重采样不是独立生产试验(§5)。 实验/附录依据。
BlueLM-GUI:把真实设备失败送回训练与评测
作者: Ye, Tong、Han, Kunyang、Wang, Guozhi、Luo, Longqiang、Ding, Zhifeng、Zhang, Yongxiang、Shen, Xiaolei、Zhang, Yuxuan、Zhang, Zhuping、Xu, Tao、Pan, Yue、Zhao, Yucheng、Hu, Yupei、Ouyang, Yuanjiang、Shen, Danfeng、Lin, Runqi、Cai, Hongda、Wang, Zhaoxiong、Yan, Mengjia、Zhong, Yingjie、Zhou, Chen、Zhang, Zeyu、Zhu, Xuwen、Shi, Penggang、Luo, Mingcheng、Wu, Ziyang、Jin, Min、Shen, Mingfu、Xu, Zairong、Zhang, Fan、Wang, Hao、Liu, Liang、Xie, Zhulin、Yao, Lijun、Liang, Xiao、Wen, Liangmin、Feng, Liqiang、Wu, Feilong、Hu, Min、Chen, Min、Xiong, Guanjing、Ruan, Xiaohu、Chen, Xiaoxin(作者名单:v1,第 40 页)
机构: vivo AI Lab。(署名依据:v1,第 1 页)
任务背景。 例如用户让手机助手在某个应用里完成一项操作:Agent 收到指令和当前屏幕,选择点击、输入或滑动,再看更新后的界面,直到办成目标。是否成功要看设备上的实际结果。本文研究如何把这些操作过程,尤其是失败后的纠正,变成训练材料,让模型之后更能应对真实设备上的变化。
手机弹窗、延迟和多条可行操作路线,让离线演示很难覆盖真实任务;失败轨迹也不应全被丢掉。
核心方案。 BlueLM-GUI 将设备上的执行结果重新用于训练。系统筛选执行数据,分析失败发生在哪里,并生成纠正示范;模型随后经历继续预训练(CPT)、监督微调(SFT)和在线 GRPO 训练。在线训练同时关注整段任务和单个动作:前者奖励目标推进和执行效率,后者区分哪些动作有必要、哪些没有帮助、哪些偏离了目标。
两类奖励先分别归一化,再合成用于策略更新的优势信号,使最终成败与中间步骤都能影响学习。新的成功和失败记录又返回数据池,继续供筛选与纠正使用。评测任务也会按能力维度和难度配额更新,使下一轮评估能覆盖相应问题。报告围绕真实设备组织这条链路,具体训练同时使用了真机和 Android 模拟器。
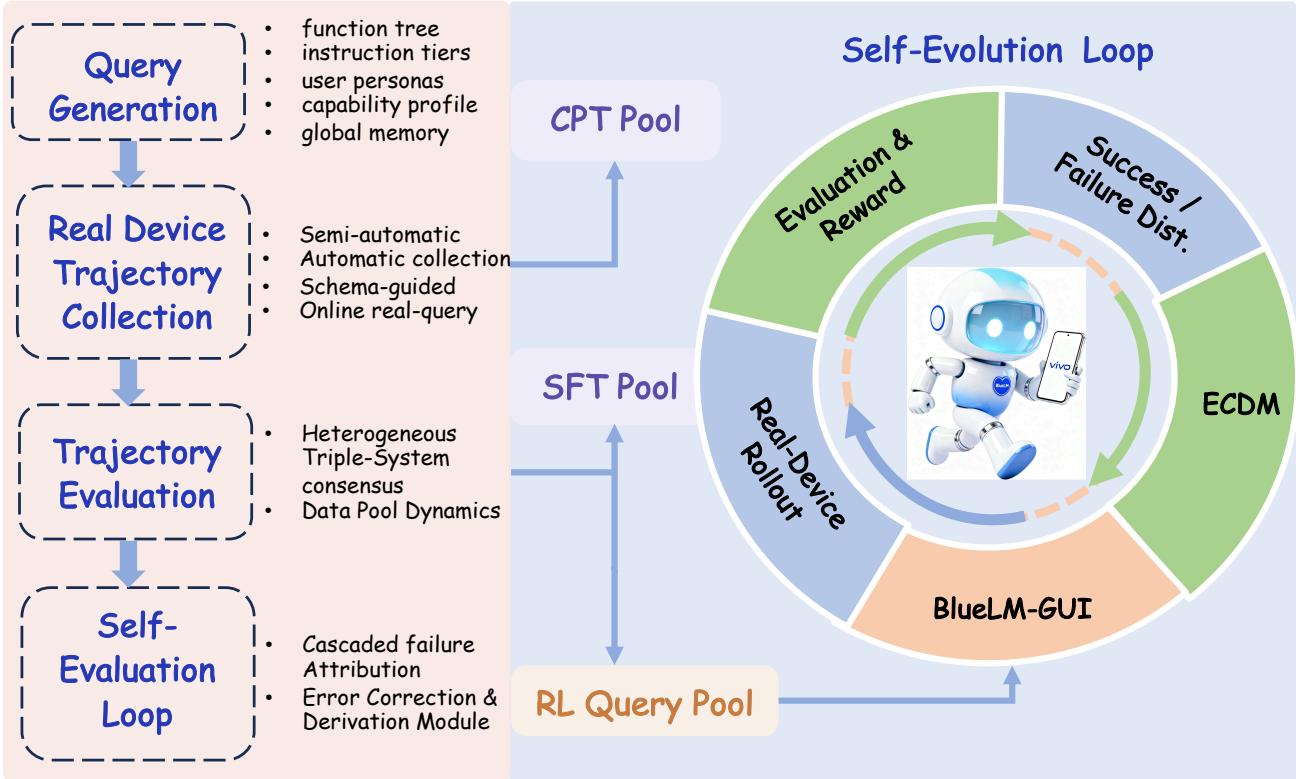
读图。 从左上方看起,系统生成任务,在设备上采集执行记录,再评估结果。沿着记录往中间看,它们被整理成不同用途的数据,分别支持继续预训练、监督微调和强化学习。这里连接了设备端的实际表现与模型的训练材料。
右侧循环进一步展开经验怎样回来:执行中的成功与失败被汇总,送入纠正与衍生模块 ECDM,再用于模型和后续任务。图重点展示数据如何收集和复用;具体参数更新方式由正文 §3.3 补充。它说明了继续迭代的流程,连续多代都能获得增益仍需要额外实验证据。
原图:v1,Figure 2,PDF 第 6 页;原文定位。
这不就是……把真机上的事故记录变成下次训练素材,同时拆细验收条件,避免凭一张看似完成的截图给错分。新增的是数据、训练和评测之间的工程闭环;并未证明系统能自主改写整个学习算法。
贡献与证据边界。 Table 8(PDF 第 36 页)同一 SFT 起点下,Basic 分数 74.9,离线回放 RL 73.9,真机在线 RL 82.0;Table 9(PDF 第 37 页)检查条件与重复评审改善后 72.52→77.42。§5.1 明确训练环境含真机和 Android 模拟器,因此摘要“Every Rollout Is Real”不能逐字当所有 rollout 都来自物理手机。总榜包含自测与引用结果,自建 VBench 与公开 AndroidWorld 应分开看;持续多代增益未给出受控曲线。 原始全文。
[!abstract]- Abstract 完整中文翻译 移动 GUI Agent 正从多模块框架转向端到端训练的原生模型,但工业部署仍存在三项差距:沙箱训练与生产环境分布不匹配;昂贵的真机失败未充分利用;固定基准逐渐饱和,失去指导迭代的能力。我们提出 BlueLM-GUI,一个 35B-A3B 移动 GUI Agent,以真实设备为中心构建闭环,并遵循三项原则。Every Sample Matters:双轨流水线通过异构三系统一致性评估和错误纠正与衍生模块,将每条轨迹回收为可用监督。Every Rollout Is Real:持续预训练、监督微调与在数百台真机上的 Agent 强化学习三阶段方案,使 rollout 扎根真实生产环境,让模型学到的能力直接迁移到部署。Every Query Evolves:基于配额、包含三个正交维度的基准方法支持精确归因,并能随模型改善系统升级。BlueLM-GUI 在 MobileGUI-VBench 达到 87.4,比最佳闭源模型高 5.1 分;在 AndroidWorld 达到 84.9,作者报告其为开源模型最佳,并与闭源模型具有竞争力。这些结果表明,将训练与迭代改善建立在真机和三项 Every 原则上,可获得强健、可迁移的移动 GUI 能力。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.12394v1;v1 首次提交:2026-09-11 03:36:35 UTC=2026-09-11 11:36:35 北京时间。 已核对:v1 Introduction、§3.3、§5.1–5.3、Figures 2/6、Tables 5/8/9。 官方页面 · v1 PDF。
评测数据集与环境。 MobileGUI-VBench-Basic、MobileGUI-VBench、AndroidWorld。自建Basic与150-query/39-App困难版分开,另测AndroidWorld;保留真机/模拟器、评分检查与重审版本(§4–5、Tables8–9)。 实验/附录依据。
RSI 自主性路线图:改好任务,还是改好改进过程
作者: Duan, Yi、Liu, Ying、Tang, Zirui、Chen, Haodong、Zhou, Jun、Liu, Yumou、Xu, Bangrui、Wu, Yukai、Chen, Sidi、Zhou, Yuhan、Wang, Haoyu、Yu, Xiaoyou、Han, Shaokun、Zhu, Xuzhou、Zhou, Le、Lu, Bolin、Zhou, Wei、Liu, Jiachen、Fang, Nuozhou、Tian, Jiaxin、Chen, Ruoyu、Li, Yuxuan、Zuo, Kai、Zhang, Kaiyan、Qiu, Jiantao、He, Conghui、Li, Guoliang、Zhou, Bowen、Liu, Zhiyuan、Wen, Zhoufutu、Kang, Jihua、Zhou, Xuanhe、Wu, Fan
机构: Shanghai Jiao Tong University;Theseus Labs;Tsinghua University;ByteDance;ModelBest;Xiaohongshu Inc.(Super Intelligence Team);Humanlaya;Agent-Native Research Lab;Shanghai AI Lab。(署名依据:v1,第 1 页)
任务背景。 这篇主要要澄清的是“AI 能自己负责多少改进工作”。例如一个代码 Agent 做题失败后,可以由人决定补什么训练,也可以让系统自己选练习、提修改、做验证。研究者把这些不同做法放进同一套分类,说明各自把哪些决定交给了 AI,以及声称变强还需要什么证据。阅读时先把它当作分析自主程度的框架。
两个系统都说自己会“自我改进”:一个每轮改提示,另一个会修改下一轮如何造候选、评估候选。怎样分清它们到底闭合了哪一层循环?
核心方案。 这篇文章提出的是一套判断 RSI 自主程度的框架。可以顺着一个 Agent 的改进过程理解它:起初,人规定怎样训练,AI 负责执行;进一步,AI 开始自己选择更新策略;再进一步,它能决定接下来获取什么经验,并将部署环境中的交互纳入改进。作者用前四层描述这些决策逐渐交给 AI 的过程,每一层都要检查哪些变化能够保留、哪些规则仍由外部固定。
第五层再追问:AI 能否修改负责改进自己的那套机制,并让后继系统继承?作者在这里区分两种要求。结构上的 L5 表示系统确实能够修改并继承改进器;有效的 L5 还需要在相当预算和独立评估下,证明新版改进器能够产生更好的后继系统。因此,“能改自己的改进流程”与“改完后更会改进”,需要不同强度的证据。
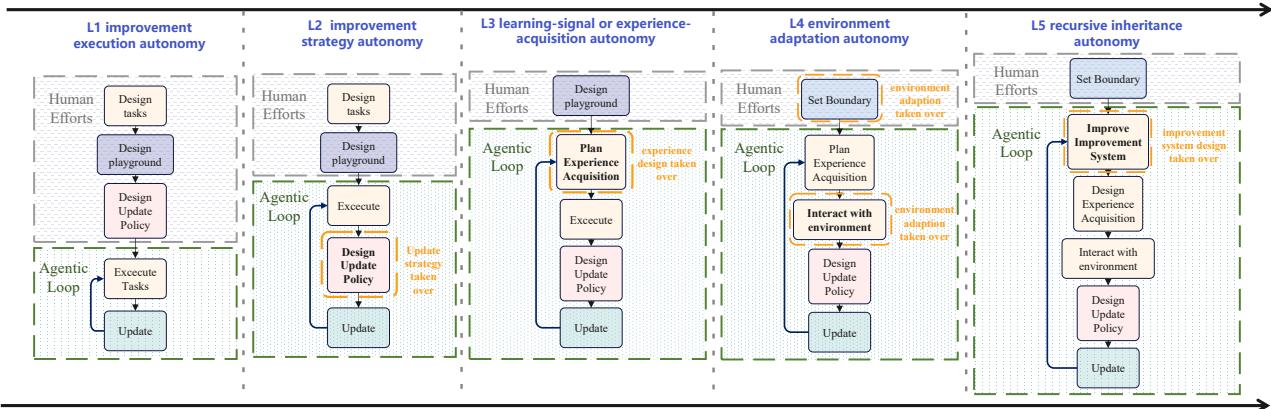
读图。 从左到右看五个阶段,重点看绿色虚线框的边界怎样扩大。最左侧先把执行更新纳入 AI 控制,后面的阶段逐步纳入策略选择、经验获取和环境交互;到最右侧,连负责改进的系统本身也进入可修改范围。可以把绿色框理解为“哪些决定已经由 AI 接手”。
灰色部分仍由人或外部系统设定,橙色部分则标出这一层新接手的组件。用这些颜色对照,就能看清层级之间增加了什么自主权。这是一张概念分类图,横向推进表达自主范围的变化,不能据此推断实验已经测得了持续的递归增长。
原图:v1,Figure 2,PDF 第 5 页;原文定位。
这不就是……从按培训计划学习,逐渐到能改培训计划,再到能改“怎样设计培训计划”。增加的是按决策权和继承关系检查系统,而非按有没有反馈箭头贴 RSI 标签;层级是本文的分析框架,不是公认成熟度标准。
贡献与证据边界。 §2.3 明确纳入论文、技术报告、官方博客、代码与公司材料,证据强度并不一致。§5.1(第 44–45 页)的 Theseus 初步结果主要证明环境整理能帮助固定模型与 Harness 完成任务;后续数据—模型—环境连续共同演化仍是待推进方向,不能据此宣称递归增益已证实。HCI 是相对基准起点与满分的缺口归一化,跨域曲线不等同统一智能量尺。本文最值得保留的是证据分类问题,而非标题对未来的暗示。 原始全文。
[!abstract]- Abstract 完整中文翻译 递归自我改进(RSI)使 AI 系统能够将经验和反馈转化为持久变化,同时改善自身能力与未来改进的过程。我们首先使用 Headroom-Closed Index(HCI,已弥合提升空间指数)揭示现有大语言模型的问题,随后介绍 RSI 的概念与发展路线:从改进执行自主性、改进策略自主性、经验获取自主性和环境适应自主性,走向递归元改进。接着,我们考察 RSI 在科学发现、具身智能、软件工程等场景中的表现,强调这些场景各自不同的需求与发展速度。结合多种行业实践和初步实验证据,我们将 RSI 研究与实际系统联系起来,并指出实现真正 RSI 的关键挑战。
[!info]- 作者、日期与阅读依据 来源:arXiv 预印本/技术报告,2609.11873v1;v1 首次提交:2026-09-10 17:44:23 UTC=2026-09-11 01:44:23 北京时间。 已核对:v1 §1、§2.1–2.3、Figure 2、§3.6、§5.1;未将行业案例逐一独立复现。 官方页面 · v1 PDF。
评测数据集与环境。 Theseus — Workspace-Bench适配研究。综述中的榜单引用不是本文逐项重跑;新增实证为§5.1的Theseus工作空间适配研究,两组30任务、1,280/547项rubric,主要支持环境改进。 实验/附录依据。
ESRL:在专家路径上增加探索
作者: Hongyi He、Zhenghao Lin、Xiao Liu、Peng Cheng、Yan Lu、Yeyun Gong
机构: Tsinghua University;Microsoft Research。(署名依据:v1,第 1 页)
任务背景。 以数学推理为例:模型收到题目,写出解题过程和答案,以答对与否评价。训练时让它多试几次,再根据结果学习,前提是这些尝试能带来有用的差别。本文使用的模型内部有多个参与计算的子网络,称为“专家”;它研究能否通过尝试不同的专家组合,找到原先不容易生成的有效解法。
给同一道数学题生成八个答案,八次都可能走近似的内部计算路径,最后一起答错。只提高 token 采样温度,会增加措辞与答案变化,却不直接控制相同前缀下 MoE 激活哪组专家。
核心方案。 ESRL 把探索放到了 MoE 模型内部:生成同一个 token 时,除了尝试不同输出,也尝试让不同的专家子网络参与计算。每次激活的专家总数保持固定,其中一部分保留路由器最有把握的选择,剩余名额则从合理的候选池中,通过给选择分数加噪声来探索。路由分布越集中,就需要较强扰动才容易换一条计算路径;本来已经很分散时,扰动则减弱。
这会带来一个训练问题:生成时试过的专家路径,更新时还会不会再次被选中?方法在生成阶段保存专家索引和当时的输出对数概率,训练时复用这组专家索引,再按当前参数重新计算专家的组合权重。这样,实际参与那次探索的专家能够接收到相应更新。后续仍使用 GRPO 的组内奖励优势来训练,奖励定义和 GRPO 目标保持原样。
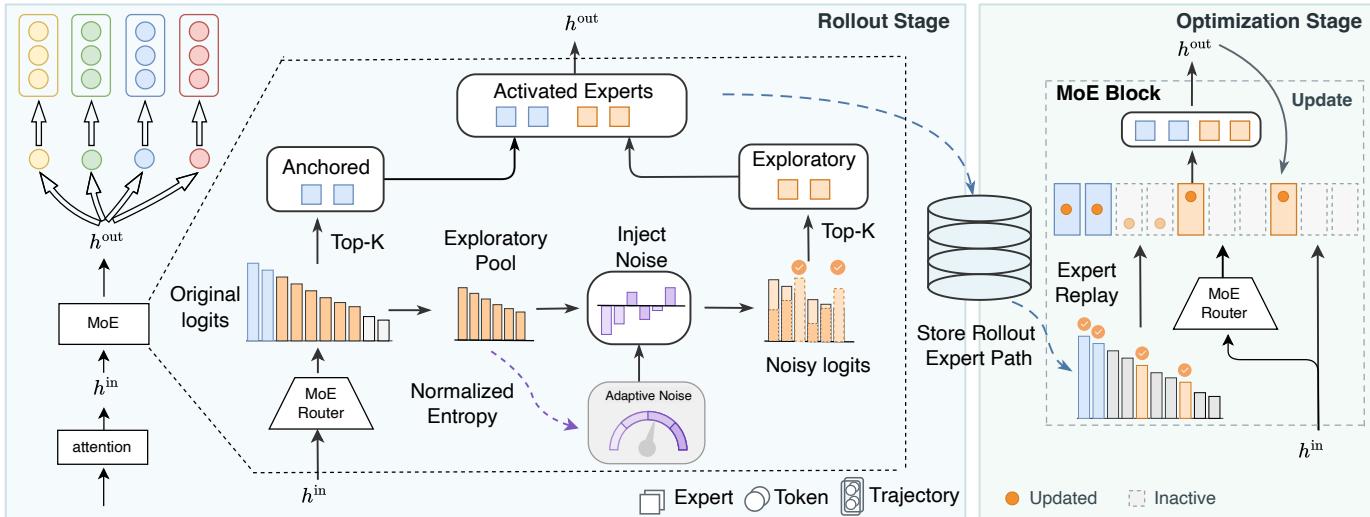
读图。 从左下角的 MoE Router 看起。蓝色部分保留路由器原本最有把握的专家,橙色部分则在候选池中加入按路由分布调整的扰动,选出参与探索的专家。两部分一起完成计算,产生 token,并逐步形成执行记录。
沿虚线走到中间的存储,再看右侧 Optimization Stage。训练时直接取回生成阶段使用过的专家索引,复用当时的路径,同时用当前参数计算组合权重。噪声影响的是专家选择,组合权重仍来自未加噪的路由分数。图主要解释这条路由与回放链路;任务奖励如何进入组内优势和 GRPO 损失,由正文 §3.4 补充。
原图:v1,Figure 5,PDF 第 6 页;原文定位。
这不就是……“保留几个靠谱的解题成员,让其余席位试试别的人;哪组人真的参与了解题,就让哪组人根据结果学习。”新增的一步是把探索从输出 token 扩展到内部专家路径,并处理生成与更新时路由不一致的问题;单纯把 router 加噪声会选中不合适的专家,论文用锚点、候选池和自适应扰动限制这个代价。
贡献与证据。 论文先分析路由扰动如何影响输出多样性,再组合受约束的专家探索与已有的 Rollout Routing Replay;回放机制本身不是本文首创。Table 1 中,Qwen3-30B-A3B 的四项数学任务平均 Pass@1 从 GRPO 的 38.9 到 42.1,Pass@8 从 59.7 到 64.2,分别增加 3.2、4.5 个百分点;强基线 GSPO 为 41.6/63.3,不能把相对 GRPO 的增量说成相对所有基线的增量。§4.1 使用相同骨干对照、每题 8 条训练 rollout,评测由每题 32 次采样计算 Pass@1/8;另有不同 MoE 结构和组件消融。这里的结果主要支持所测推理训练设置,不证明长程交互 Agent 的跨任务学习收益。摘要声称不增加采样或计算成本;本次未复现实测时延与显存,仍应计入路由记录和回放的实现开销。
[!abstract]- Abstract 完整中文翻译(作者摘要中的结论) 强化学习(RL)已成为大语言模型后训练的核心。近期针对混合专家(MoE)模型的 RL 进展,主要集中于提高优化稳定性和训练效率,同时把专家选择视为固定组件。由于路由决定产生输出分布的稀疏计算路径,专家选择能够提供额外的 rollout 多样性来源。通过实证分析,我们发现扰动专家路由可以有效改变模型输出并增加 rollout 多样性,其作用类似于提高解码温度。然而,直接扰动可能激活不合适的专家,并显著降低 rollout 质量。受这些观察启发,我们提出专家空间探索强化学习(ESRL),一种显式探索 MoE 专家路由空间、考虑架构特性的框架。ESRL 将高置信度专家保留为锚点,并把随机路由限制在合理候选池中,从而保留可靠的计算路径。扰动强度还会根据路由器熵自适应调整,以避免过度扰动。为缓解扰动引入的路由不匹配,ESRL 记录 rollout 使用的专家路径,并在策略优化时回放。实验表明,在采用 top-K、top-1 和共享专家路由的 MoE 骨干上,以及数学、科学和代码任务上,ESRL 无需额外采样或计算成本即可取得最佳表现。具体而言,在 Qwen3-30B-A3B 上,ESRL 在所有比较方法中表现最佳,相比 GRPO,平均 Pass@1 和 Pass@8 分别提升 3.2 和 4.5 个百分点。对专家利用率和训练动态的进一步分析,为利用 MoE 特有路由结构改善 RL 训练提供了认识。
来源:arXiv 预印本,2609.13058v1;v1:2026-09-11 16:58:41 UTC=2026-09-12 00:58:41 北京时间;发现于本次 9 月 14 日采集。已核对 Introduction、§3、§4.1–4.2、Table 1;全文 PDF。
评测数据集与环境。 OlympiadBench、AIME 2024、AMC 数学竞赛评测切片、MinervaMath、GPQA Diamond、MMLU-Pro、MMLU-Redux、LiveCodeBench v6。数学四项外另测知识/代码四项;32次采样估计pass@1/8,关闭路由扰动;Olympiad仅英文文本数学、Redux v1仅ok、LCB为累计v6(§4、Appendix A)。 实验/附录依据。
CanvasAnneal:逐渐撤掉老师的推理前缀
作者: Blake Olson、Yuhang Song、Emmett McQuinn、Yuan Shangguan
机构: Google DeepMind。(署名依据:v1,第 1 页)
任务背景。 以解数学题为例:使用时给模型一道题,希望它独立写出过程和正确答案。这里的扩散语言模型会从一段待填的文本位置出发,多轮补全和修正,逐渐形成回答。训练初期它可能很难自己答对,因此作者研究能否先提供一部分教师推理帮助它练习,再逐渐撤掉帮助,最终检查独立做题的能力。
模型从一整片 [MASK] 开始解题,初期经常连可用轨迹都找不到。如果老师先给一段推导,学生容易得到奖励;难点是怎样把这种有帮助的训练变成最后不依赖老师的能力。
核心方案。 CanvasAnneal 在训练扩散语言模型时,先提供一段教师推理作为起点。这里的“画布”可以理解为一段等待补全的文本位置:教师推理的前缀已经填好,其余位置被遮住,由学生通过多步去噪生成。教师内容事先离线准备,并去掉最终答案和工具命令,使学生仍需继续推理才能完成任务。
随着训练推进,方法逐渐增加遮蔽比例,减少学生能看到的教师内容;同时始终保留一部分完全没有教师前缀的问题组。为了让组内奖励有可比性,同一个问题组的所有生成都从相同画布开始。训练时,任务奖励用于计算组内优势和策略损失,损失覆盖教师前缀与学生生成的 token,因此也包含学习教师内容的成分。最终推理只提供问题,待生成部分全部遮蔽,交给学生独立完成。
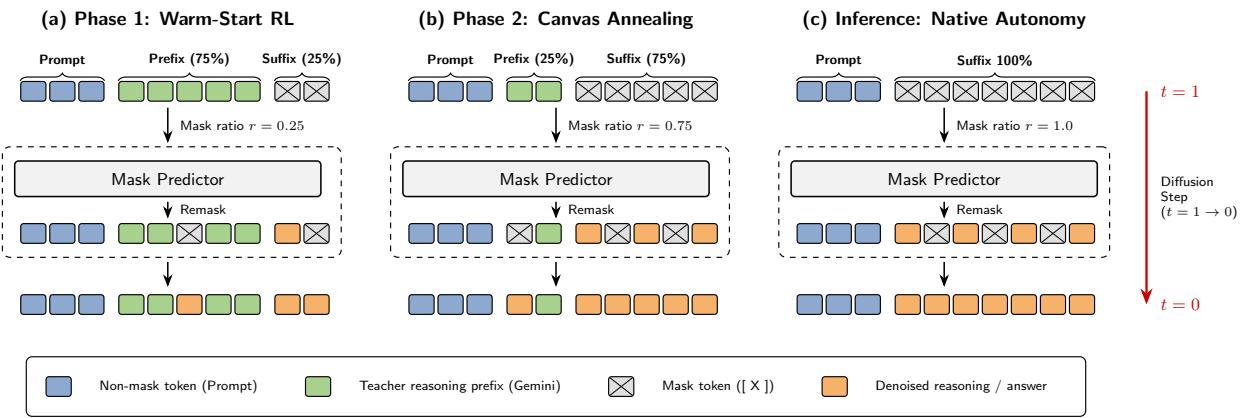
读图。 先横向看三个阶段。蓝色是问题,绿色是已填入的教师推理,带叉的位置等待补全,橙色则是学生生成的内容。左侧保留较多绿色,中间逐渐撤掉这些帮助,右侧是最终推理:只给问题,后续内容全部由学生生成。
再纵向看任意一列,它展示一次生成内部的多步去噪。因此,横向表示帮助怎样随训练减少,纵向表示一次回答怎样逐步形成。图里的 25% 和 75% 是示意;实际遮蔽比例从 Beta 分布抽样,并混入完全无教师提示的组。正文还说明,训练损失覆盖教师前缀和生成 token,作者将前者解释为带优势权重的蒸馏成分。
原图:v1,Figure 1,PDF 第 5 页;原文定位。
这不就是……“先让学生接着半份解题草稿写,随后把草稿一点点擦掉,还经常让他从白纸开始。”具体增加的是扩散画布上的连续前缀课程、组内相同起点和始终存在的无辅助 rollout。它兼有探索引导和教师内容学习,不能简单归结为“给提示后 RL 更强”,也不能把训练时能看草稿的分数当成自主能力。
贡献与证据。 在 LLaDA-7B-A1B-Instruct 上对照 diffu-GRPO、SFT 和 SFT+RL;数学训练生成长度为 256、去噪 128 步,RL 统一在第 1600 次更新评测。Table 1 中,长度 256 的 MATH500 从 39.00% 到 41.00%,但 GSM8K 从 69.98% 降至 68.54%。Table 2 中,在 xLAM 训练后,Tau2 三个领域平均从 10.15% 到 13.03%;BFCL Parallel 则从 65.00% 降到 60.50%。论文报告部分任务到达奖励阈值更快,但更新步数减少不等于包含离线教师成本后的总计算同比减少;小幅差值还需结合测试题置信区间和训练随机性理解。消融显示无提示组比例与退火课程均有任务依赖,不能宣称普遍替代 SFT。
[!abstract]- Abstract 完整中文翻译 扩散语言模型(DLM)展现出有前景的并行生成能力,但在复杂推理和工具使用任务上落后于自回归模型。尽管最近已有研究用强化学习(RL)增强 DLM,标准 RL 方法仍受到探索瓶颈限制。为解决这一问题,我们注入更强教师模型提供的推理先验,以引导 RL 探索。本文提出 CanvasAnneal,一种由课程引导的扩散 RL 框架。在 RL 初始阶段,我们将教师生成的推理轨迹注入初始扩散画布,为探索提供热启动。随着训练推进,我们逐步移除这些引导,并要求模型独立生成越来越多的推理轨迹。在数学推理和工具使用基准上,CanvasAnneal 在 MATH500、Countdown 和 Tau2 上优于标准 diffu-GRPO,并在若干任务上显著加快奖励提升,但收益取决于具体任务。结果表明,训练期间的结构化引导能够缓解扩散 RL 的探索瓶颈,并加快较难任务的收敛。
来源:arXiv 预印本,2609.13060v1;v1:2026-09-11 16:59:52 UTC=2026-09-12 00:59:52 北京时间;发现于本次 9 月 14 日采集。已核对 Introduction、§4、Algorithm 1、§5、Tables 1–4;全文 PDF。
评测数据集与环境。 GSM8K、MATH-500、BFCL 单轮调用切片(CanvasAnneal 版本待核)、τ²-bench。数学与工具两组;BFCL仅Simple/Multiple/Parallel,具体release待核;Tau2三域;xLAM属于训练来源,非测试集(§5、Tables1–2)。 实验/附录依据。
Advis:用已有轨迹估计扰动后的回报
作者: Amine Andam、Jamal Bentahar、Mustapha Hedabou
机构: Mohammed VI Polytechnic University;Khalifa University;Concordia University。(署名依据:v1,第 1 页)
任务背景。 这里研究模拟运动控制:控制模型不断读取位置、速度等观测,输出动作,让模拟身体向前运动,并按环境给出的回报评价表现。输入若被小幅篡改,模型就可能采取不合适的动作。本文希望训练出的控制办法在这种干扰下仍能工作,重点研究能否利用已有执行记录,估计并改善受干扰时的表现。
一个控制策略在干净观测下很好,但传感器输入略有偏差就连续做错动作。你想训练它抵抗扰动,又不想额外训练一个攻击者、再采一套环境轨迹。
核心方案。 Advis 希望复用已经采到的执行轨迹,估计策略在输入受到扰动时会有怎样的表现。它先根据允许的扰动范围,用神经网络凸松弛求出策略输出概率的边界,再据此构造最坏情形下的动作概率。随后,方法比较同一动作在受扰策略与原策略下的概率,沿轨迹累计这些概率比,对原有回报重新加权,估计受到扰动后的折扣回报。
得到这个估计后,训练可以选择提高最坏情形回报、缩小它与正常回报的差距,或只对性能下降施加惩罚。由于长轨迹上的概率比连乘容易变得极大或极小,方法还结合加权或逐决策的重要性采样、轨迹窗口和数值稳定处理,并在训练中逐渐增加攻击预算。这里的核心是让已有交互记录也能为鲁棒性训练提供信号。
核心方案图。 原文 Figures 1–5 展示攻击评估与消融结果,后续还有配置示例,但没有独立的算法流程图。可以从 §3 的公式 13–17 接着读:先看扰动范围怎样约束动作概率,再看这些概率怎样变成轨迹权重,最后进入鲁棒回报的训练目标。PDF 第 5 页起。
这不就是……“用已经跑过的路线,估算换成一个更容易受扰动的驾驶策略会得到多少回报,再据此改进训练。”难点在于另一个策略的轨迹分布不同,概率比连乘会变得极大或极小;加权估计、截断和短窗口能降低不稳定性,但会改变估计性质,不能把有限样本训练估计直接等同于精确的最坏回报证书。
贡献与证据。 方法复用训练轨迹、避免辅助网络,并显式考虑跨时间影响;此外提供 advrl 实现库,揭示针对一个策略调好的攻击超参数并不可靠迁移到另一个策略。§5 用三个 MuJoCo 环境、相同两层 64 单元网络和每算法 200 万环境步对照,训练三个随机种子;Table 2 的最坏攻击回报支持所测设置的收益。不同 CVaR 尾部范围下排序会变化,并非所有风险偏好下都领先。没有额外环境样本不等于没有额外计算,凸松弛与更广攻击评估都需要成本;本次未复现代码结果。
[!abstract]- Abstract 完整中文翻译 在保护深度强化学习(DRL)策略免受输入扰动影响方面,已有显著进展。鲁棒 DRL 的开发主要包含算法设计、实现和评估三个阶段。本文识别并解决了每个阶段中的一项关键局限。首先,我们提出对抗重要性采样(Advis),它对标准训练中的轨迹进行重要性采样,以估计并优化可验证的最坏情形回报。Advis 同时满足此前工作未能兼具的三个理想条件:无需额外环境交互、无需辅助网络,并能刻画长期鲁棒性。其次,我们推出模块化 PyTorch 库 advrl,为已有鲁棒方法和对抗攻击提供清晰的单文件实现,便于快速原型开发,并支持可复现、可追溯的评估。第三,我们重新审视学习型攻击者下的评估,表明最优攻击超参数无法跨智能体迁移,因此仅使用有限的攻击配置可能高估鲁棒性。为此,我们使用大规模、多样化的攻击者集合评估策略,配置数量为此前工作的 6–14 倍。最后,我们在连续控制环境中评估所提方法,展示其相对已有基线的有效性。代码见 advrl。
来源:arXiv 预印本,2609.13044v1;v1:2026-09-11 16:40:45 UTC=2026-09-12 00:40:45 北京时间;发现于本次 9 月 14 日采集。已核对 Introduction、§3、§4.2、§5、Table 2 和图题;全文 PDF。
评测数据集与环境。 MuJoCo 连续控制对抗观测评测。HalfCheetah-v5/Hopper-v5/Walker2d-v5,200万训练步、3seeds;用多类攻击的最坏回报和CVaR评估,不是题目准确率(§5、Table2)。 实验/附录依据。
RaC:让鲁棒性约束决定正则权重
作者: Amine Andam、Jamal Bentahar、Mustapha Hedabou
机构: Mohammed VI Polytechnic University;Khalifa University;Concordia University。(署名依据:v1,第 1 页)
任务背景。 在模拟运动任务中,控制模型根据身体状态选择动作,希望获得较好的运动回报。除了正常输入,研究者还会故意扰动观测,检查控制是否容易失效。训练需要兼顾正常表现与抗干扰能力,因此会对不稳定的行为增加惩罚。本文研究怎样根据希望达到的抗干扰要求,自动调整这项惩罚的力度。
在奖励目标之外加一项正则后,系数大了可能学不动,系数小了又约束不住。更清楚的问题是:你究竟允许策略在扰动后损失多少性能,再让系数随约束违反程度变化。
核心方案。 RaC 把鲁棒性训练中的惩罚力度,与一个更具体的要求联系起来:模型在正常条件下要尽量获得高回报,同时受扰动后的表现不能低于规定下限,或相对正常表现下降太多。作者先从理论上分析正常策略与最坏情形策略的性能差距,将已有的鲁棒正则方法解释为控制这个差距上界的不同项,再用它们构造训练约束。
训练时,每项约束对应一个非负的拉格朗日乘子,也就是相应惩罚的权重。约束被违反,就提高权重,让下一轮更重视鲁棒性;约束得到满足,权重可以降低。策略和这些权重交替更新,使惩罚力度随着当前表现调整。论文讨论了要求最坏回报单调改进、以及允许一定性能差距的两类约束,具体容忍多少差距仍需事先设定。
核心方案图。 原文 Figure 1 展示约束与系数的收敛曲线,没有独立的方法流程图。阅读 §4 的公式 23–31 时,可以跟着一轮训练往下看:先用采样结果估计是否违反约束,再更新策略,并据违反程度调整下一轮的惩罚权重。PDF 第 4–5 页。
这不就是……“把手调惩罚力度变成按是否超标自动调节。”新增内容是解释若干现有鲁棒正则之间的关系,并给出可估计的性能约束替代式;拉格朗日方法本身并非新发明。它把一个调参问题改成更有含义的约束设计问题,但没有消除阈值、优化步长和近似误差。
贡献与证据。 §3 的理论界主要以总变差距离写出,摘要与实现讨论中的 KL 惩罚应结合正文关系理解,不把两者当同一个量。§5 采用相同 PPO、两层 64 单元网络和 200 万环境步进行连续控制对照,评估大量分别训练的攻击者。Table 1 中 RaC-SA 在 HalfCheetah 的最坏攻击回报为 4801.8,对照 SA 为 3795.7;但 RaC-Mono 未学到鲁棒策略,RaC-Radial 也不是所有条件都胜过其基线。§5.3 报告部分方法比基线多约半小时训练开销,容忍阈值仍影响稳定性。
实现使用当前批次最大值替代全状态动作空间最大值,并对梯度尺度做平衡;这些近似意味着理论约束的严格保证不能无条件套在实际神经网络训练结果上。其证据支持鲁棒控制设置中的方法分析,不证明语言 Agent 的奖励增长或泛化改善。
[!abstract]- Abstract 完整中文翻译 基于正则化的方法已成为训练深度强化学习策略抵抗对抗输入扰动的一种标准途径。本文通过推导名义策略与最坏情形策略之间性能差距的新上界,将这些方法统一起来。每个上界都表达为一个已有正则化目标,加上名义策略与最坏策略之间的 KL 散度惩罚,这也进一步解释了为什么实践中加入 KL 惩罚能够提高鲁棒性。基于这些界,我们将鲁棒训练表述为约束优化问题,并表明现有方法对应于拉格朗日乘子固定的特殊情形。我们改为联合更新乘子与策略,以自动调节正则化权重。最后,我们在多个连续控制任务上开展广泛的对抗评估,验证理论分析。
来源:arXiv 预印本,2609.13050v1;v1:2026-09-11 16:45:36 UTC=2026-09-12 00:45:36 北京时间;发现于本次 9 月 14 日采集。PDF 有会议模板字样,本次未独立核实录用状态。已核对 Introduction、§3–4、§5.1–5.3、Tables 1–2;全文 PDF。
评测数据集与环境。 MuJoCo 连续控制对抗观测评测。HalfCheetah/Hopper/Walker2d,200万训练步;比较名义和最坏已测攻击回报,控制扰动半径与攻击者调参;具体环境版本仍需代码核对(§5)。 实验/附录依据。
TrED:评估整段适应过程
作者: Ricardo Ribeiro Pereira、Jacopo Bono、Hugo Ferreira、Pedro Ribeiro、Pedro Saleiro、Pedro Bizarro、Carlos Soares
机构: Feedzai;University of Porto。(署名依据:v1,第 1 页)
任务背景。 假设一个分类模型换到新的使用场景,每来一条输入就必须先作判断,正确标签却可能过一段时间才知道。它可以利用已经到手的数据更新自己,但不能提前看未来答案。本文要明确怎样评价这整个适应过程:不仅看最后一个模型,还要看一路上犯了多少错、用了多少标签和更新成本。
系统进入一个新场景,开始只有旧场景数据,随后收集到新输入,再过一阵才有标签。如果只比较最后一次训练出的模型,会看不见“早期是否一直犯错”和“花了多少次更新才适应”。
核心方案。 TrED 关注模型进入新环境后逐步适应的全过程。一条新样本可能已经到达,但它的正确标签要过一段时间才能获得,因此作者分别记录输入和标签的到达时间。环境决定此刻有哪些数据可用,学习方法再据此选择是否更新、使用什么损失,以及是否复用历史数据和模型。尚未到达的标签不能提前用于训练。
按照这个设定,比较对象就成为部署期间先后使用过的一串模型。评估会累计它们在整个目标域适应过程中的误差,也可以另外考察用了多少标签、付出了多少更新计算。这样,前期适应得快慢和后期表现好坏,都能进入评价。
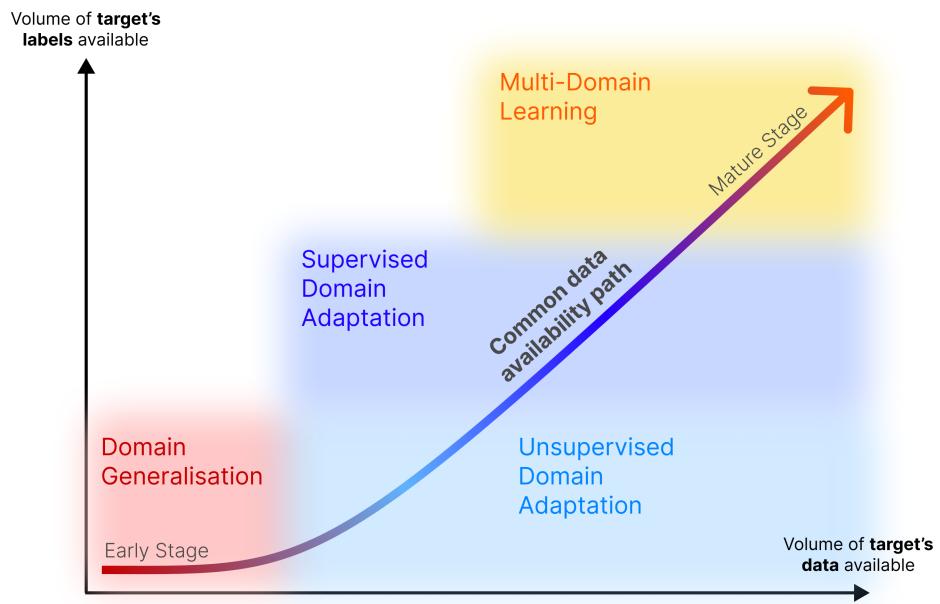
读图。 先看两条坐标轴:横轴表示已有多少目标域样本,纵轴表示其中有多少标签。再沿左下到右上的箭头移动,系统起初没有目标域数据,随后获得未标注样本,再逐渐收到少量乃至更多标签。不同颜色对应传统研究通常单独考察的设定。
论文希望把沿箭头经历的整段过程连起来评估,因此图的重点是数据和标签何时可用。它是一张问题设定图;具体什么时候更新模型、怎样构造训练损失,仍由采用的学习方法决定。
原图:v1,Figure 1,PDF 第 3 页;原文定位。
这不就是……“别只比毕业考分,也算从入学到毕业这段时间里实际表现怎样。”真正增加的是把数据何时可用、算法能作出的决策,以及评估的时间范围分开定义。标签晚到时,可以事后评估过去那版模型,但当时的训练器不能偷看这个未来反馈。
贡献与证据边界。 §3.3 给出全程累计风险,并说明按每条实例平均会自然给高流量时段更大权重;若要按真实时间等权,需要另做重加权。全文以形式化和已有机制梳理为主,没有提出一个已被新实验验证的统一最优算法。完整历史可以保留、甚至每次从头训练也是合法方案,因此不能将 TrED 自动等同于受限记忆下的抗遗忘持续学习。
[!abstract]- Abstract 完整中文翻译 迁移学习研究如何利用不同任务或领域(源)中的知识,提升相关任务或领域(目标)中的预测性能。迁移学习研究通常划分为若干相互独立的子领域,例如域泛化、域适应和多域学习,每个子领域对目标数据可用性作出不同假设,即训练时有多少数据、多少标签。然而,在许多现实应用中,数据可用性并不固定,而是随着新领域中的样本和标签逐步收集而变化。每一种经典设定因此只描述了部署系统必须完整经历的一条轨迹上的某个快照。我们将这条轨迹形式化为独立的迁移学习问题:演化领域迁移学习(TrED)。它由环境决定的数据可用过程、方法可以自由选择的学习协议,以及评价整条模型轨迹而非单个模型的评估准则共同规定。在该形式化中,经典设定是学习器可能经历的不同阶段,而不是由 TrED 拼接起来的独立问题。随后,我们审视迁移学习文献,识别有望成为解决方案构件的机制;我们发现多数方法针对单一阶段设计,即使目前最强的候选方法也尚未优化完整轨迹。我们认为,TrED 是一个定义良好且尚未解决的问题,也是未来研究的重要方向。
来源:arXiv 预印本,2609.13039v1;v1:2026-09-11 16:37:37 UTC=2026-09-12 00:37:37 北京时间;发现于本次 9 月 14 日采集。已核对 Introduction、§2、§3.1–3.4 和全文章节结构;全文 PDF。
评测数据集与环境。 不适用:本文以TrED问题形式化和既有机制梳理为主,没有新增固定数据集上的实证比较;不能把其提出的全程累计风险协议当成已经发布的数据集。 实验/附录依据。
Type Diversity:泛化失败也可能来自训练数据
作者: Anssi Moisio、Mathias Creutz、Mikko Kurimo
机构: Aalto University;University of Helsinki。(署名依据:v1,第 1 页)
任务背景。 这类语言理解任务要求模型读一句话,再输出机器能检查的含义或动作序列。例如读到一个包含多个动作的指令,就要把各动作及顺序正确表达出来。测试会把学过的词和结构换成未见过的组合,看模型还能否理解。本文研究这种泛化表现是否受到训练句子结构种类的限制。
模型见过“猫在垫子上”,换一种句法位置就不会处理。问题可能是模型缺少组合能力,也可能是训练数据只用很少几种结构构造句子,换再多名词也没增加结构经验。
核心方案。 这篇论文把训练数据的多样性具体到“模型见过哪些结构”。例如,反复把句子里的“狗”换成“猫”,增加的是词的变化;让名词能够带上形容词、关系从句或复数形式,则增加了构成同类表达的方式。作者用某类结构可由多少种构造函数生成来定义“类型多样性”,据此检查训练分布是否影响模型理解未见过的组合。
实验使用 Grammatical Framework 构造 COGS、SLOG 的变体,并研究 SCAN,通过增加不同结构来改变训练数据。为了辨认收益究竟来自哪里,作者还设置了只增加数据量的对照,并检查逻辑语义输出的格式是否影响成绩。因此,阅读这些结果时,要同时看结构是否变多、训练量是否对齐,以及输出形式是否一致。
核心方案图。 原文图片主要展示准确率、分布差异与实验结果,没有独立的训练或数据构造流程图。可以从 §7 的 Table 2 及其前面的数据量对照说明切入,比较“只增加样本”和“增加结构类型”各自带来了什么变化。PDF 第 16–18 页。
这不就是……“多做同一模板的换词题,未必等于见过更多解题结构。”新增价值是把“多样性”拆成可控制的结构构造因素,并用实验排除一部分数据量和输出格式混淆。它没有证明只要足够多样,Transformer 就一定具有完美的系统性泛化。
贡献与证据。 §7 保留已有模型超参数、用 12 个随机种子比较;把原始数据额外增加约 60% 以匹配最大变体的词数,目标结构任务准确率仍约为 1.7%,而增加多种结构后达到 73.3%(标准差 10.2);再加人工名词短语结构达到 92.4%(标准差 1.9)。这些是特定 COGS 划分的结果,不是自然语言整体准确率。论文另指出输出语义项顺序等表面属性也影响结论,且部分实验种子方差较高、每个实验只用一套超参数;“一次测试失败就是架构能力上限”的推断因此需要谨慎。
[!abstract]- Abstract 完整中文翻译 组合泛化通常被划分为词汇泛化和结构泛化。先前研究发现,对 Transformer 而言,结构泛化比词汇泛化更困难。我们提出,这种差异并非 Transformer 的固有属性,而是来自这些研究所用特定数据集中词汇类型多样性较高、结构类型多样性较低。我们所说的类型多样性,是构造该类型的不同构造函数的数量,而不是例如填入某个结构中的具体词语组合。为检验这一点,我们改变已有数据集中词汇类型和结构类型的多样性数量,并使用 Grammatical Framework 构建语言学上更多样的 COGS 和 SLOG 变体。我们发现,无论词汇还是结构测试案例,类型多样性都与组合泛化呈现相似关联,支持了我们的假设。我们指出,这与先前工作中“组合分布差异可以解释组合泛化任务难度”的论点存在矛盾。我们进一步研究其他数据集属性对组合泛化的影响,例如新测试结构之外其他类型的多样性,以及逻辑语义表示格式的表面属性。
来源:arXiv 预印本,2609.13144v1;v1:2026-09-11 17:59:07 UTC=2026-09-12 01:59:07 北京时间;发现于本次 9 月 14 日采集。已核对 Introduction、§2、§6–7、§10–12 和相关图题;全文 PDF。
评测数据集与环境。 COGS、SLOG、SCAN。COGS/SLOG的Grammatical Framework变体与SCAN;区分原版、结构扩展、只扩样本和输出格式控制,12seeds;各变体分母需按实验配置记录(§6–7、§10–12)。 实验/附录依据。